Strukturierte Datensätze aus einer wissenschaftlichen Datenbank abrufen
Praxisbeispiel Sieben geradkettige Carbonsäuren in PubChem
Beginnen Sie mit zusammengesetzten Namen und beenden Sie mit einer Tabelle mit verifizierten Identifikatoren und Eigenschaften. In diesem Beispiel wird Essigsäure durch Octansäure, eine siebengliedrige homologe Reihe mit zwei bis acht Kohlenstoffatomen, gewonnen. Die Quelldatensätze bleiben neben der Tabelle verfügbar, so dass Sie überprüfen können, wie jeder Wert erhalten wurde.
1. Definieren Sie die Verbindungen und Eigenschaften
Stellen Sie in Settings → Connectors sicher, dass Chemie verfügbar ist. Öffnen Sie ein Projekt, starten Sie ein Gespräch und wählen Sie ein verbundenes Modell aus. Dieser Versuch verwendete Open-Science 0.30.1 und die Chemie/PubChem Connector; Es war keine Input-Tabelle erforderlich.
neutrale, geradkettige, gesättigte Monocarbonsäuren angeben. Ein ähnlicher Name kann sich auf ein verzweigtes Isomer, ein Salz oder eine konjugierte Base beziehen. Eine Formel allein kann all diese Strukturen nicht unterscheiden.
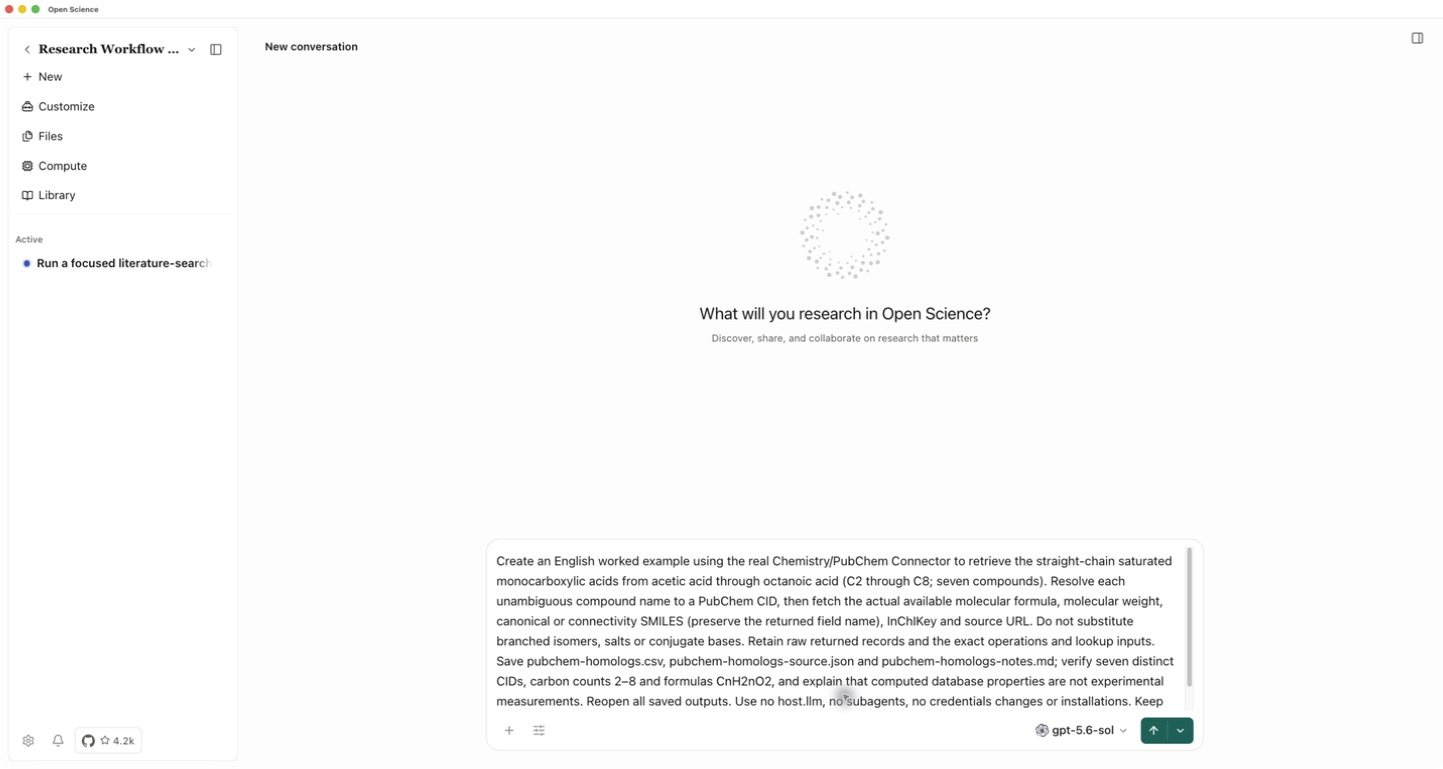
Use the Chemistry/PubChem Connector to retrieve acetic acid,
propanoic acid, butanoic acid, pentanoic acid, hexanoic acid,
heptanoic acid and octanoic acid. Resolve each name to a PubChem CID.
Retrieve molecular formula, molecular weight, the returned SMILES
and ConnectivitySMILES fields, InChIKey and the PubChem source URL.
Use neutral straight-chain acids, not branched isomers or salts.
Save pubchem-homologs.csv, pubchem-homologs-source.json and
pubchem-homologs-notes.md. Preserve exact lookup inputs and raw
responses. Check seven distinct CIDs, carbon counts 2–8, formulas
CnH2nO2, neutral charge and linear structures. Reopen the files.
Keep all outputs in English and do not delegate.
2. Überprüfen Sie die tatsächlichen Datenbankaufrufe
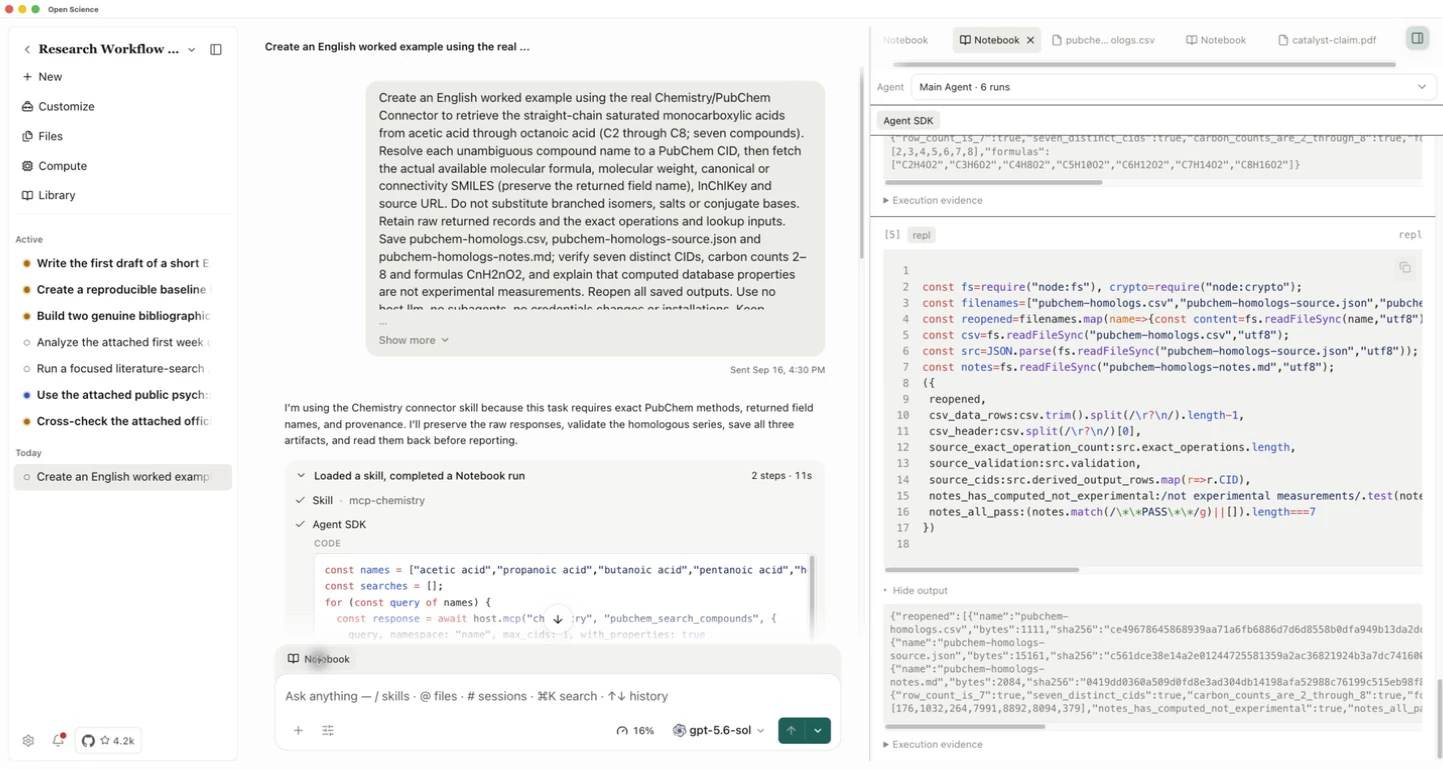
Erweitern Sie nach dem Senden die Werkzeugaktivität oder öffnen Sie Notebook. Der Lauf löste sieben Namen mit pubchem_search_compounds auf und holte dann ihre Datensätze mit pubchem_get_compounds ab. Überprüfen Sie die zurückgegebene CID und Struktur für jeden Namen, bevor Sie die Zeile akzeptieren. Wenn ein Name mehrere plausible Identitäten zurückgibt, lösen Sie diese Mehrdeutigkeit zuerst auf.
Das Beispiel verwendete genaue Säurenamen und die erste zurückgegebene CID, dann überprüfte die Batch-Eigenschaften. Dies ist für diese eindeutigen Namen geeignet; Der erste Treffer ist keine allgemeine Identifikationsregel.
3. Öffnen Sie die gespeicherte Tabelle
Warten Sie, bis die Antwort abgeschlossen ist und die Dateien unter Generated erscheinen. Öffnen Sie pubchem-homologs.csv und vergrößern Sie seine Vorschau. Dieser Lauf produzierte Zeilen 7 · Spalten 8.
| Verbindung | PubChem CID | Formel | Molekulargewicht, g/mol |
|---|---|---|---|
| Essigsäure | 176 | C2H4O2 | 60.05 |
| Propansäure | 1032 | C3H6O2 | 74.08 |
| Butansäure | 264 | C4H8O2 | 88.11 |
| Pentansäure | 7991 | C5H10O2 | 102.13 |
| Hexansäure | 8892 | C6H12O2 | 116.16 |
| Heptansäure | 8094 | C7H14O2 | 130.18 |
| Octansäure | 379 | C8H16O2 | 144.21 |
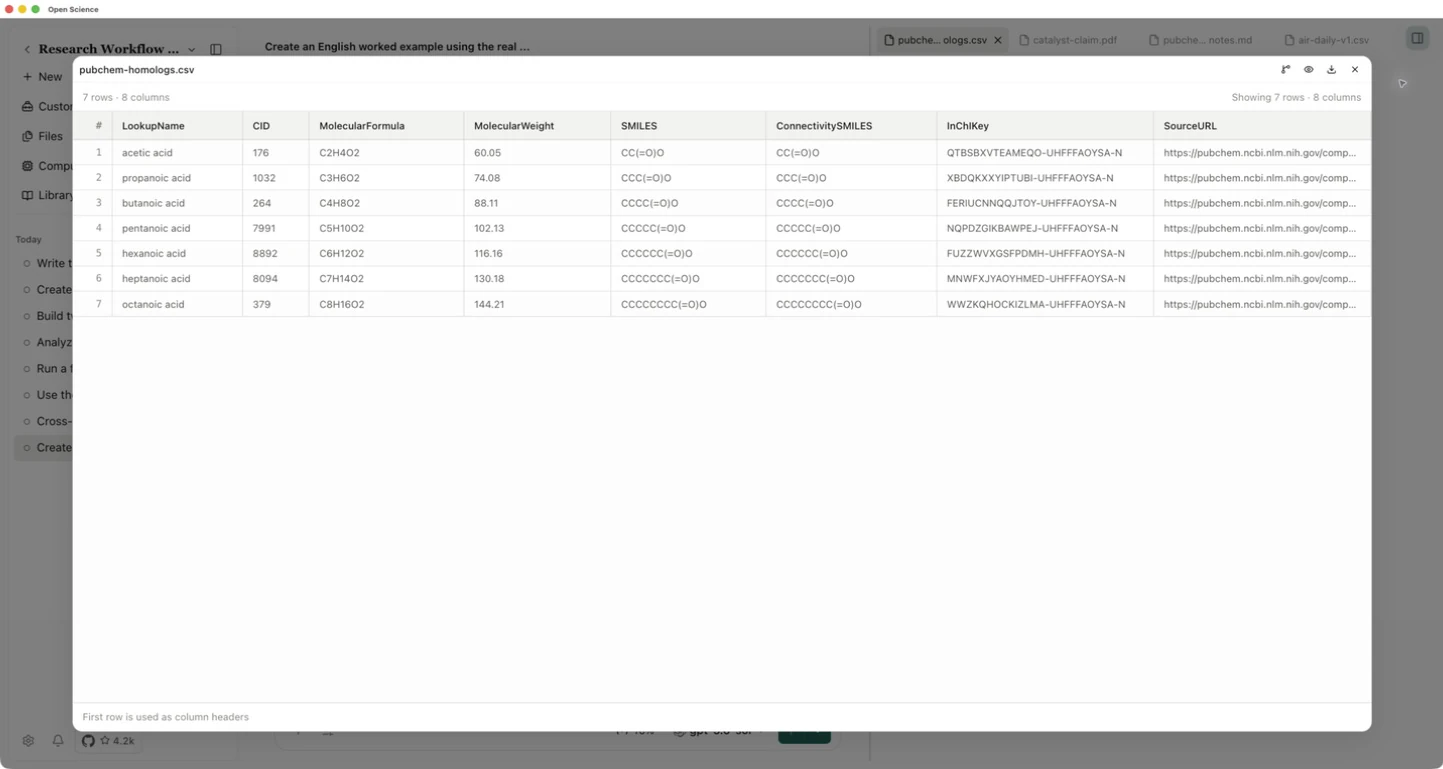
Match Zeilen von CID, nicht ihre Anzeigereihenfolge. Überprüfen Sie die Formel und lineares Lächeln zusammen. Das Beispiel behält beide zurückgegebenen Feldnamen, SMILES und ConnectivitySMILES; Ihre Strings passen zufällig zu diesen Verbindungen. Benennen Sie einen nicht als einen anderen Identifikator um oder schließen Sie daraus experimentelle Stereochemie ab.
4. Behalten Sie die Quelldatensätze mit dem Export
Öffnen Sie pubchem-homologs-source.json, um alle acht Operationen, genaue Lookup-Eingaben und Rohantworten zu überprüfen. Öffnen Sie pubchem-homologs-notes.md für die Prozedur und Prüfungen. Der gespeicherte CSV wurde mit den Rohdaten verglichen; die sieben vereinbarten Identitäten, Formeln und linearen Strukturen.
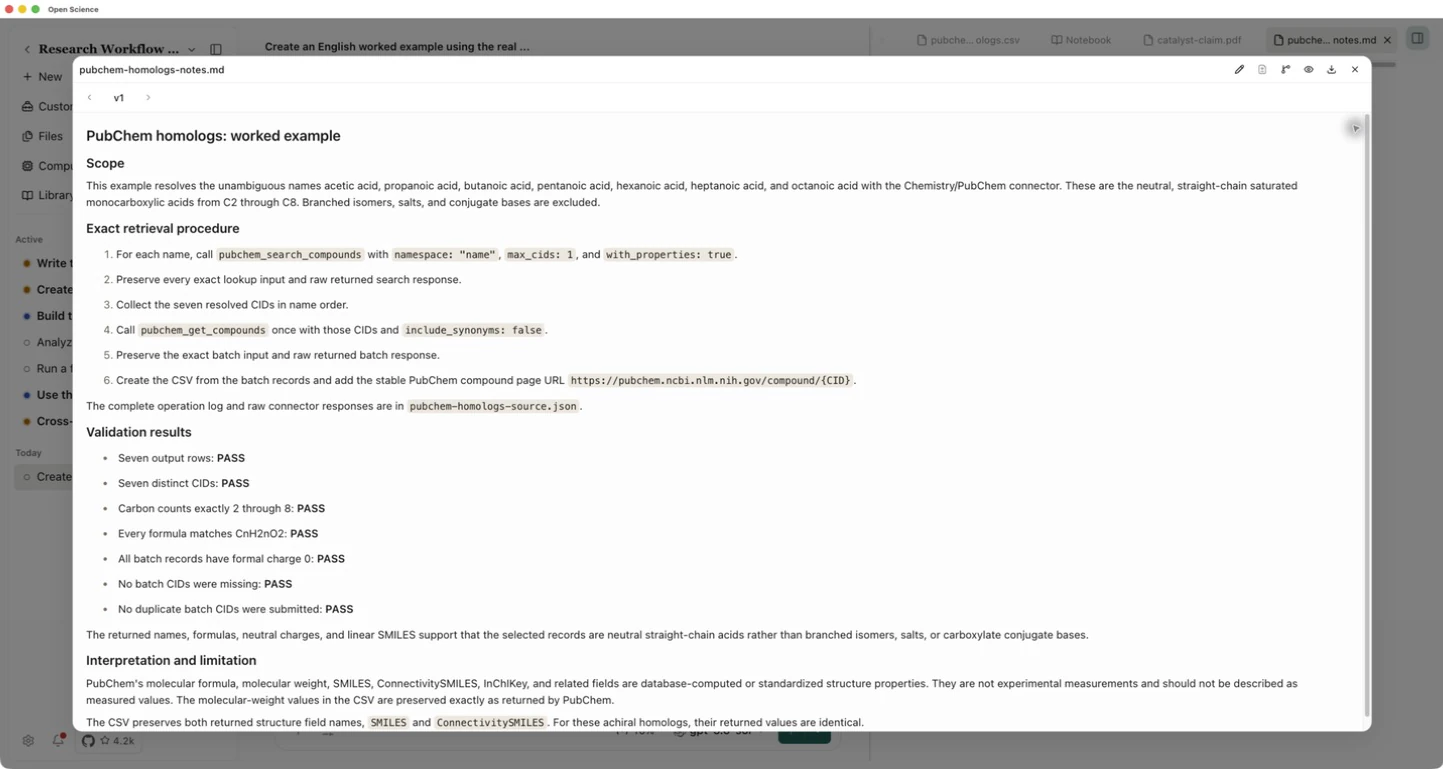
Verwenden Sie die Download-Taste der Vorschau, um eine lokale Kopie beizubehalten. Für diesen abgeschlossenen Lauf laden Sie CSV, Quelldaten und Anmerkungen herunter. PubChem-Datensätze können sich ändern; Behalten Sie den Quell-Snapshot mit Ihrer Analyse.
Dies sind datenbankberechnete oder standardisierte Eigenschaften, keine neuen experimentellen Messungen. Das Molekulargewicht ist keine exakte monoisotope Masse, und diese Tabelle stellt keine Reinheit, Toxizität oder biologische Aktivität fest. Um widersprüchliche Quelldatensätze zu vergleichen, fahren Sie mit Gegenprüfung der wissenschaftlichen Aufzeichnungen fort.