Überprüfen Sie ein Regressionsergebnis mit einem öffentlichen Datensatz
Praxisbeispiel Einnahmen nach einem Job-Training-Experiment
Sie haben einen kleinen wirtschaftlichen Datensatz und möchten wissen, ob sich ein Ergebnis ändert, wenn Basismerkmale enthalten sind. Dieses Beispiel führt einen unangepassten Vergleich und eine vorgegebene angepasste Regression durch und speichert dann die Schätzungen und deren Unsicherheit.
Lieferbar: eine Notebook-Berechnung, ein Koeffizient CSV und ein englischer Bericht. Es verwendet die experimentelle Probe 445-Beobachtung in jtrain2, die der National Supported Work-Analyse von LaLonde durch das wooldridge data dictionary zugeschrieben wird.
Vorbereiten und Anfügen der Daten
- Laden Sie jtrain2.csv aus Rdatasets herunter und lesen Sie die Variablendefinitionen im Wörterbuch.
- Erstellen Sie ein Projekt und bestätigen Sie, dass ein Python Laufzeit aktiviert ist. Dieses Beispiel verwendet
pandasundstatsmodels; bei Bedarf fehlende Pakete in der ausgewählten Umgebung installieren. - Öffnen Sie ein Gespräch, wählen Sie ein Arbeitsmodell aus, wählen Sie dann + → Attach files und wählen Sie das CSV aus. Bestätigen Sie, dass der Anhang vor dem Senden erscheint.
Das Ergebnis re78 und die Basisvariablen re74 und re75 sind reale Einnahmen in Tausende von Dollar. Sie beziehen sich auf Einnahmen in 1978, 1974 und 1975. Null Verdienste sind gültige Beobachtungen. train identifiziert die Trainingszuweisung; mostrn beschreibt Monate des Trainings und ist keine Baseline-Anpassungsvariable.
Klicken Sie auf das angehängte CSV, um eine Vorschau zu erhalten, bevor Sie die Berechnungsanforderung senden. Überprüfen Sie train, re78, re74 und re75, einschließlich Zeilen mit null Einnahmen. Die Vorschau darf nur 100-Zeilen anzeigen; Notebook muss die gesamte Datei zählen.
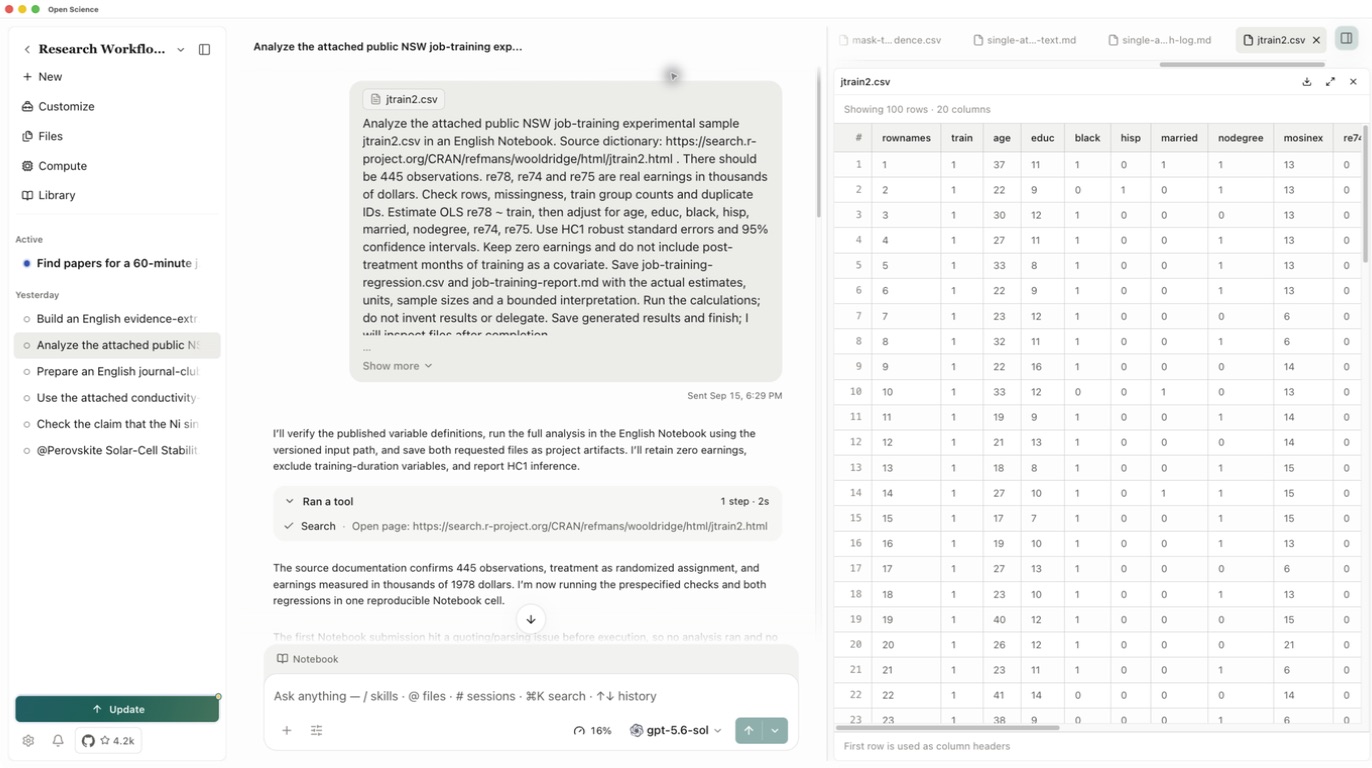
Führen Sie den vorgegebenen Vergleich aus
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
Überprüfen Sie den angeforderten Code, wenn die Genehmigung erscheint. Es sollte das angehängte CSV lesen, die beiden angegebenen Modelle anpassen und die Ausgänge speichern. Öffnen Sie Notebook, um das tatsächliche Ausführungsergebnis zu überprüfen. Wenn die Ausführung fehlschlägt, beheben Sie den angezeigten Fehler, bevor Sie eine Prosa als berechnetes Ergebnis behandeln.
Wählen Sie in der Konversation Notebook, öffnen Sie die ausgeführte Python-Zelle und überprüfen Sie deren Ausgabe. Suchen Sie nach der Zeile und Gruppenzählung vor der Regressionszusammenfassung. Wenn die angehängte Version nicht gelöst werden kann, bitten Sie den Agenten, die Datei aus dem Anhang dieser Konversation zu lesen und erneut zu versuchen; Eine ausgefallene Zelle ist kein Ergebnis. Behalten Sie die erfolgreiche Zelle und ihre Ausgabe mit den gespeicherten Dateien.
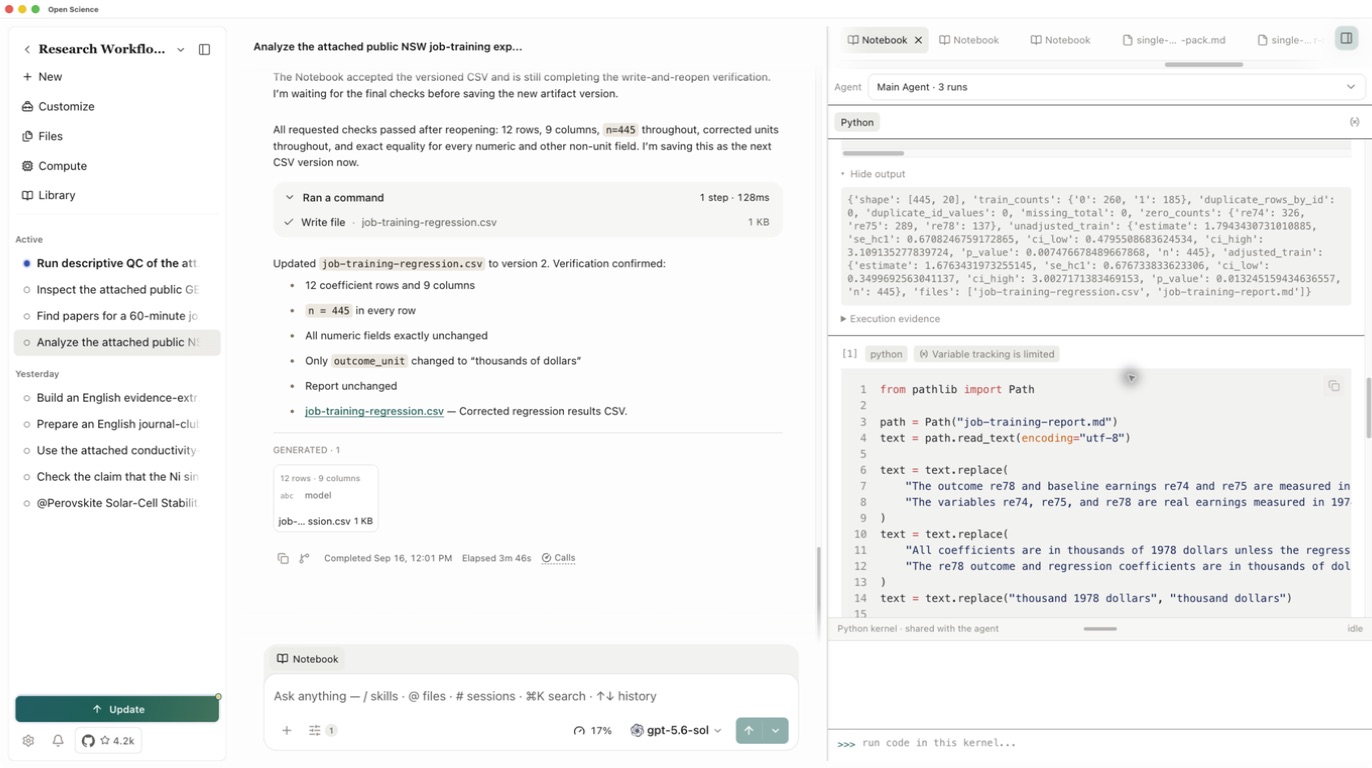
Überprüfen Sie das gespeicherte Ergebnis
Das Beispiel mit 445-Zeilen, 185 wird dem Training zugewiesen, 260-Kontrollen, keine fehlenden Werte und keine doppelten Zeilenbezeichner. Beide Regressionen behielten alle 445-Beobachtungen.
| Modell | Ausbildungskoeffizient | HC1-Standardfehler | 95% Konfidenzintervall |
|---|---|---|---|
| Nicht berichtigt | 1.794 | 0.671 | 0.480 bis 3.109 |
| Bereinigt um Basisvariablen | 1.676 | 0.677 | 0.350 bis 3.003 |
Koeffizienten und Intervalle sind in Tausende von Dollar. Dies sind Ergebnisse der Berechnung dieses Beispiels, nicht zitierte Schätzungen aus dem Originalpapier.
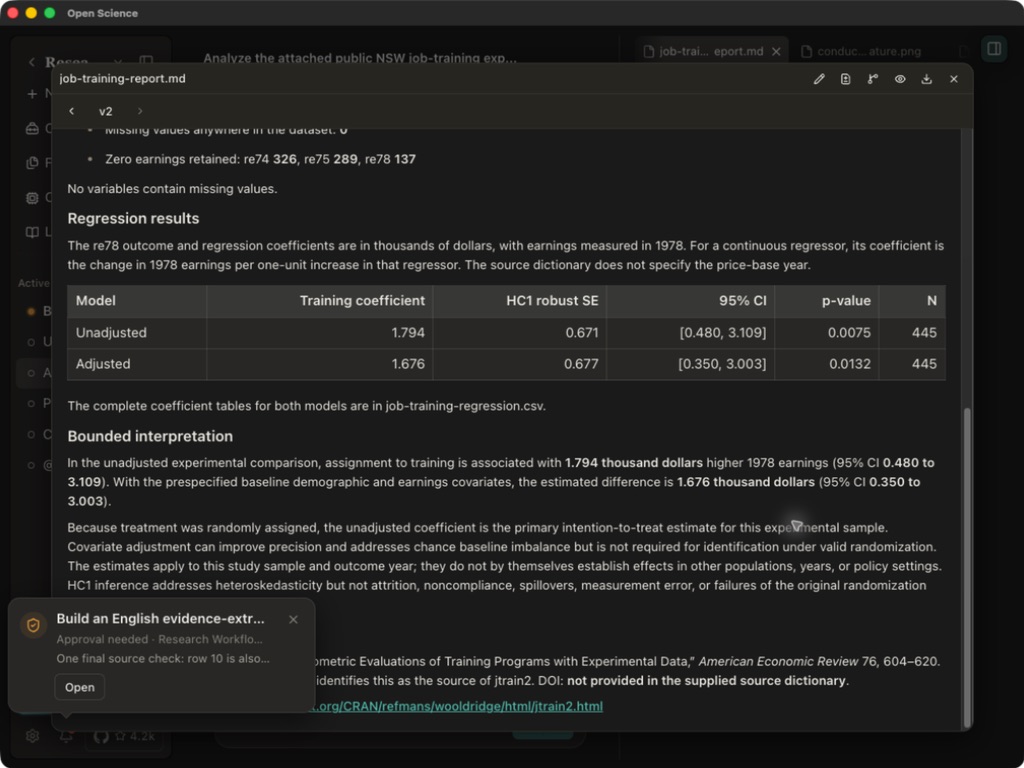
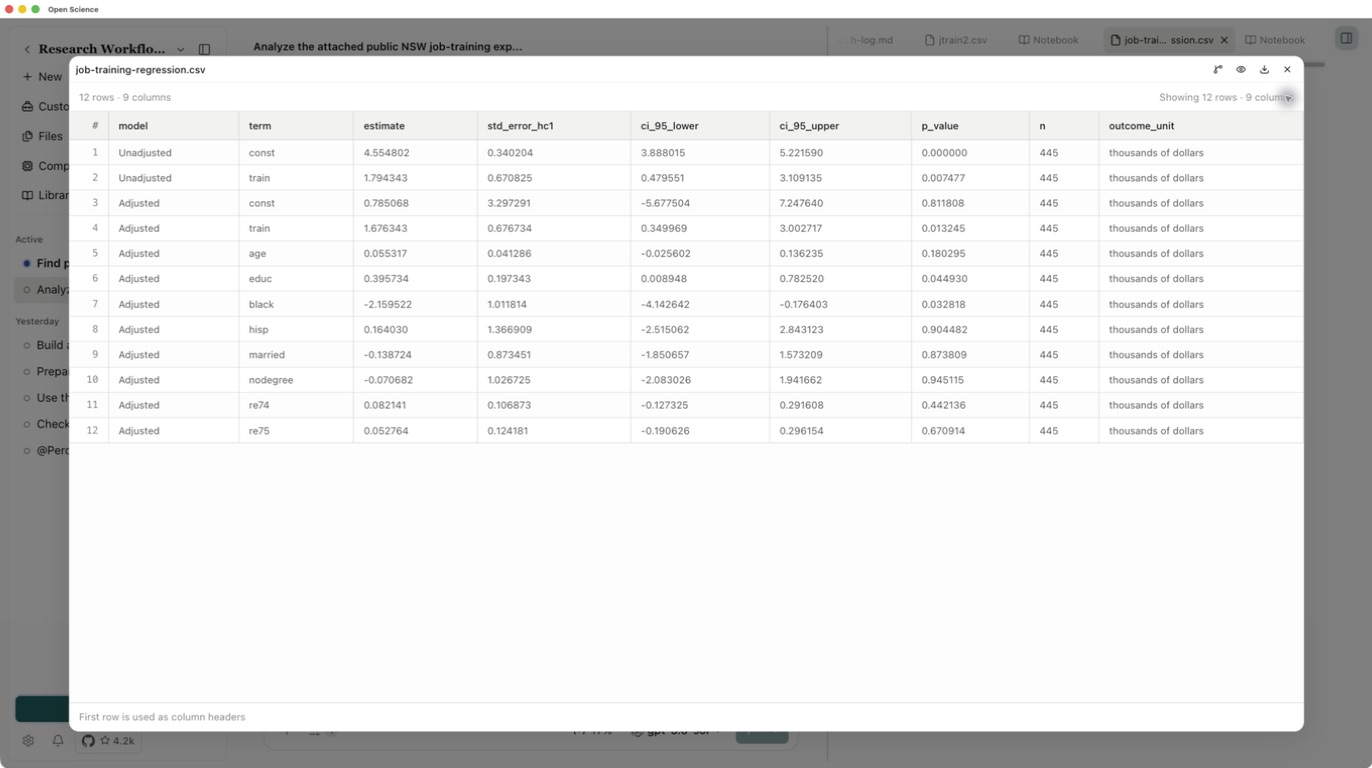
Öffnen Sie beide generierten Dateien, nachdem die Antwort abgeschlossen ist. Vergleichen Sie die train-Zeilen im CSV mit dem Bericht und Notebook. Sie können die Koeffiziententabelle und Bericht dieses Laufs herunterladen.
Öffnen Sie in Generated den CSV und erweitern Sie seine Vorschau. Die gespeicherte Koeffiziententabelle hat Zeilen 12 · Spalten 9: zwei Zeilen für das nicht angepasste Modell und zehn für das angepasste Modell. Suchen Sie die train-Zeile jedes Modells und vergleichen Sie seine Schätzung, den robusten Standardfehler, das Intervall, n und die Einheit. Fügen Sie kein Inflationsbasisjahr hinzu, das im Quellwörterbuch nicht angegeben ist. Verwenden Sie die Download-Taste der Vorschau, um die geprüfte Version beizubehalten.
Entscheiden Sie, was der Vergleich unterstützt
Die Baseline-Anpassung ändert die Schätzung von etwa 1.79 auf 1.68 Tausend Dollar. Das ist eine Sensitivitätsprüfung für diese beiden Spezifikationen. Es stellt nicht Robustheit für jede Modellierungswahl her oder verallgemeinert das Experiment auf andere Populationen und Jahre. HC1-Standardfehler betreffen Heteroskedastizität; Sie reparieren keine Probleme im ursprünglichen Studiendesign.
Um die Analyse einem Kollegen zu übergeben, behalten Sie das ursprüngliche CSV, das variable Wörterbuch, den Code und die ausgewählte Umgebung bei. Verwenden Sie Reproduzierbarkeitsprüfungen, um zu beurteilen, was für eine spätere Wiederholung verfügbar ist.