Prüfen Sie die Probenqualität in einer Genzählmatrix
Praxisbeispiel Prüfen der Probenqualität in GSE60450
Vor der Durchführung der Differentialexpressionsanalyse ist zu überprüfen, ob die Zählmatrix strukturell verwendbar ist und ob die Probenetiketten rückverfolgbar bleiben. Dieser Walkthrough verwendet die echte öffentliche GEO GSE60450 Mausmaul-RNA-seq-Matrix. Es erzeugt eine zwölf-sample-QC-Tabelle, eine rohe Bibliothek-Größe-plot und einen Methoden-Bericht in Open-Science.
Forschungsentscheidung: ist die Datei intern konsistent genug, um mit der Annotation von Beispielen und einer separat entworfenen statistischen Analyse fortzufahren? Die unten aufgeführten Prüfungen Adressdatei-Integrität und Beschreibung zählt. Sie stellen keine biologische Vergleichbarkeit, Normalisierung, Chargenkorrektur oder differentielle Expression her.
Die folgenden Dimensionen und numerischen Ergebnisse gehören zu diesem Beispieleingang. Definieren Sie mit Ihrer eigenen Matrix die Beispielspalten und berechnen Sie die Prüfungen neu.
Source-and-Input-Vertrag
Laden Sie die Originalmatrix von Beispieldaten und erwartete Ergebnisse herunter. Überprüfen Sie die Prüfsumme, Beispielspalten und Metadatenfelder, bevor Sie sie hochladen. Verwenden Sie diese Seite für die Basiswerte während dieses Workflows.
1. Definieren Sie die Arbeit, bevor Sie sie ausführen
Erstellen Sie ein Projekt und fügen Sie die ursprüngliche Matrix von der Beispielseite an. Aktivieren Sie Python mit csv, statistics und hashlib (Standardbibliothek) und installieren Sie matplotlib bis Laufzeiten, wenn es abwesend ist. Verwenden Sie ein verbundenes Modell, das Notebook-Code ausführen kann.
Senden Sie diese Anforderung oder passen Sie die Ausgabenamen an, während Sie die Spaltendefinitionen beibehalten:
Inspect the attached public GEO GSE60450 gene-count matrix in the Session
Notebook using Python csv/statistics/hashlib and matplotlib. Do not install
packages during the analysis. Preserve the input. Exclude EntrezGeneID and
Length from the 12 sample-count columns. Validate unique IDs, row widths,
nonnegative integer counts and missing entries. Save rnaseq-sample-qc.csv
with exactly six columns: compact_sample, original_column_name, total_raw_counts,
zero_count_genes, detected_genes_count_gt_0, median_count_among_detected_genes. Retain the complete original sample
identifier in original_column_name; compact_sample is only a compact display label.
For each sample compute the raw-count sum, count of zeros, count > 0,
and median of positive counts. Save rnaseq-library-sizes.png with all sample
labels and a raw-count axis, plus rnaseq-qc-report.md describing the source,
input SHA-256 before and after, method, label mapping and limitations.
Save all three outputs in English; I will reopen them to check the results.
Do not perform differential-expression testing or delegate.
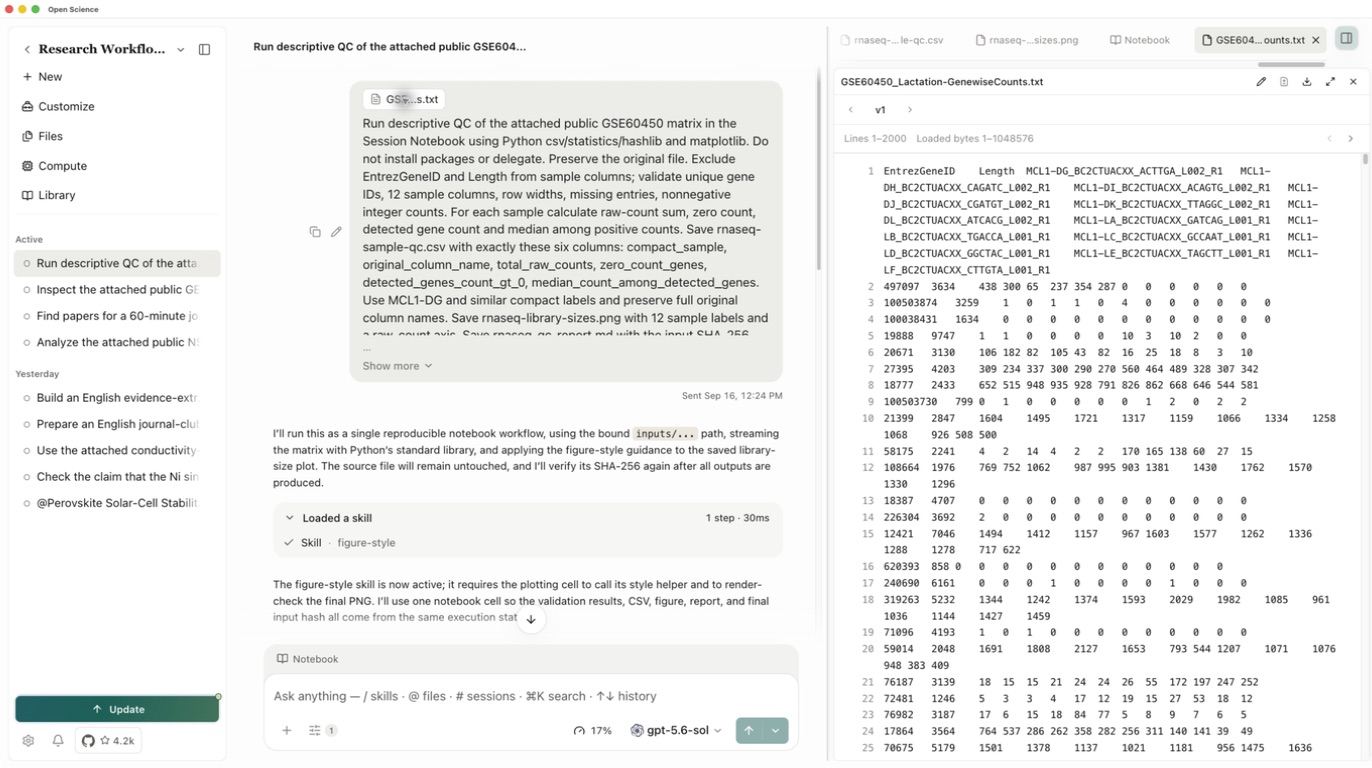
Klicken Sie vor dem Senden auf den Anhang, um die Kopfzeile zu überprüfen: zwei Metadatenspalten gefolgt von zwölf Beispielspalten. Die Textvorschau lädt nur einen Teil einer großen Datei; Der Notebook muss die gesamte Matrix lesen. Dieser Lauf schickte die Berechnung direkt. Wenn Sie sich zuerst auf einen Plan einigen möchten, verwenden Sie den separaten Planung-Flow.
2. Metadaten aus Stichprobenberechnungen heraushalten
Die Berechnung bewahrt Entrez-IDs, überprüft konsistente Zeilenbreiten und zählt als nicht negative Ganzzahlen. Length ist Genmetadaten, keine dreizehnte Probe. Eine Nullzählung ist ein gemessener Eintrag, kein fehlender Wert; Leerzeichen nicht durch Null ersetzen oder Nullzählgene stillschweigend entfernen.
Berechnen Sie für jede Probe die Gesamtrohzahl, die Anzahl der Nullzählgene, die Anzahl mit einer Anzahl größer als Null und die Medianzahl Nur unter den nachgewiesenen Genen. Notieren Sie diesen Nenner. Verwenden Sie die genauen Eingabespalten; Kompakt-Etiketten wie MCL1-DG sind Display-Etiketten mit einer expliziten Abbildung, nicht neu abgeleitete biologische Gruppen.
3. Überprüfen Sie die Ausführung und behandeln Sie einen Fehler
Lesen Sie die Python-Berechtigungsanforderung, einschließlich der Eingabedatei und der Ausgabenamen, und lassen Sie dann die Operation "Scale" zu. Öffnen Sie Notebook im Gespräch und inspizieren Sie die fertige Zelle und ihre Ausgabe. Überprüfen Sie die Dimensionen, Original-Etiketten, metrischen Arrays und Vorher / Nachher Hash; die Vervollständigungsnachricht des Modells allein ist unzureichend.
Wenn die Eingabe-Versions-ID nicht aufgelöst werden kann, bitten Sie den Agenten, die Eingabe aus der Anlage dieser Konversation zu verwenden und erneut zu versuchen. Dieser Lauf nutzte diese Erholung. Behandeln Sie den fehlgeschlagenen Versuch nicht als abgeschlossene Berechnung oder ersetzen Sie stillschweigend eine andere Datei.
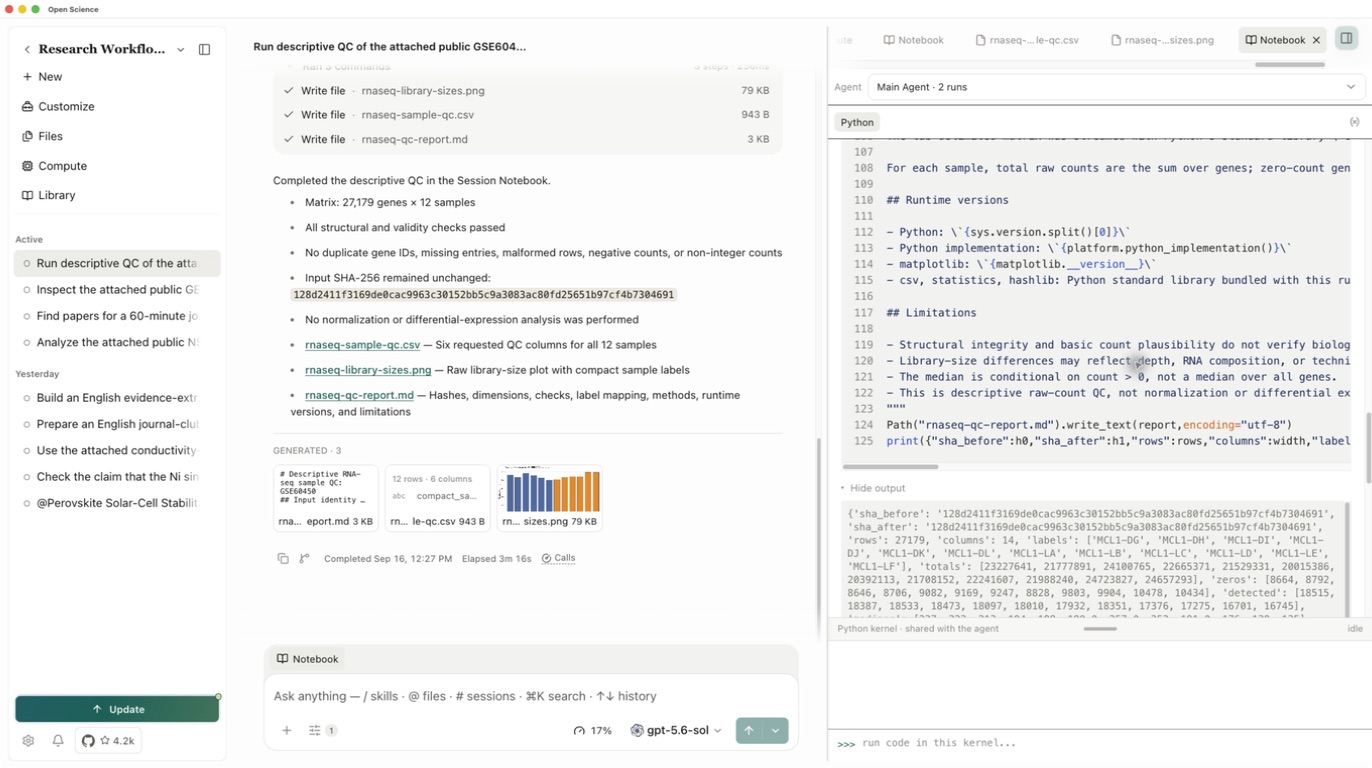
Die abgeschlossene Wiederholung validiert 27,179-Genreihen und 12-Probenspalten ohne fehlerhafte Zeilen, doppelte IDs, fehlende Einträge oder ungültige Zählungen. Alle drei angeforderten Dateien erschienen unter Generated. Öffnen Sie jede Datei dort; Eine Arbeitsdatei, die nie als Artefakt gespeichert wurde, ist noch nicht lieferbar.
4. Annahme des Mustertisches
Öffnen Sie rnaseq-sample-qc.csv und überprüfen Sie Zeilen 12 · Spalten 6. Es behält jeden vollständigen ursprünglichen spaltennamen bei. In der nachstehenden Tabelle sind alle vier Metriken aufgeführt; die herunterladbare CSV enthält die Abbildungsspalte.
Vergleichen Sie alle Sample-Metriken mit dem Basistabelle, wobei die Zeilen mit dem vollständigen Sample-Identifier übereinstimmen.
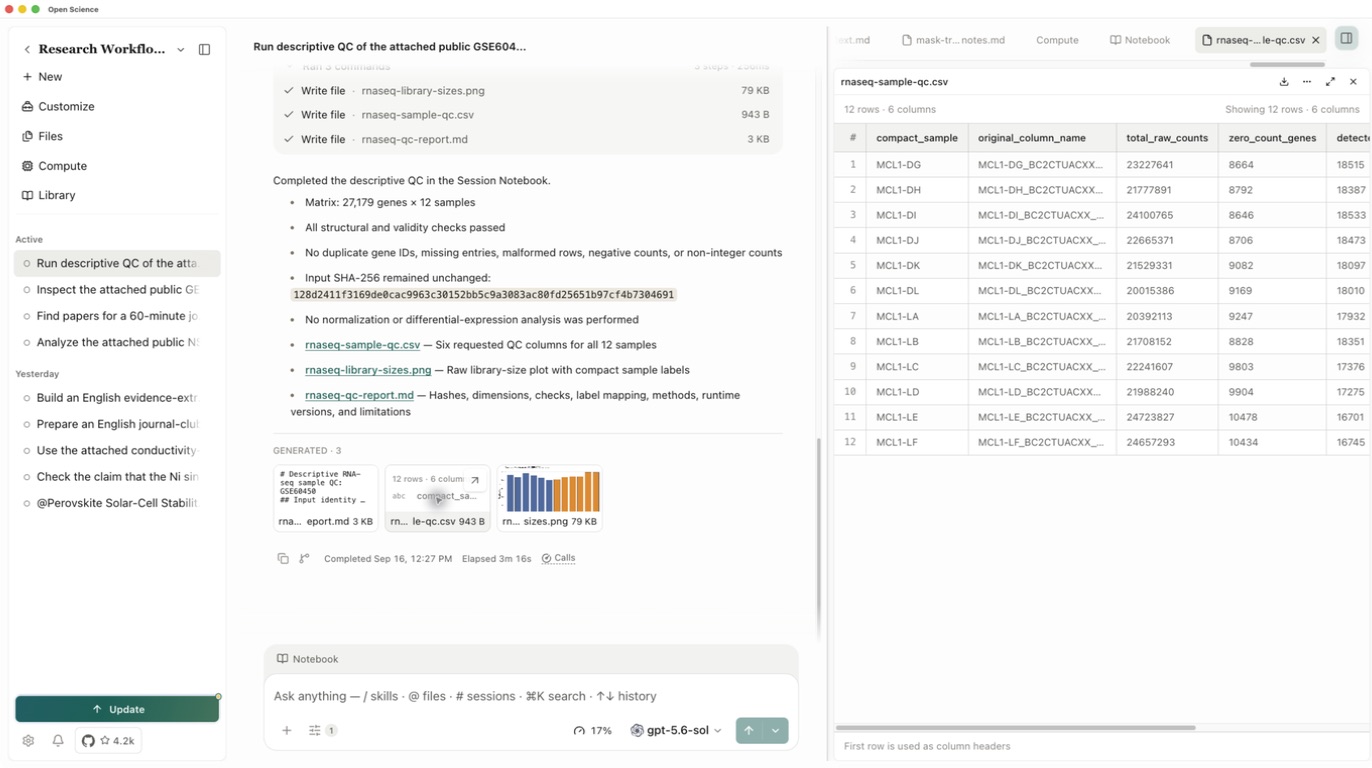
Für diesen Input sollte die Nullzählung plus nachgewiesene Gene in jeder Zeile gleich 27,179 sein. Vergleichen Sie die 48-Stichprobenmetriken mit der unabhängigen Baseline. Die Vereinbarung überprüft diese Berechnungen für die gelieferten Vorleistungen; Nachgelagerte Annahmen bedürfen noch einer eigenen Bewertung.
5. Lesen Sie den Plot, ohne ihn zu überinterpretieren
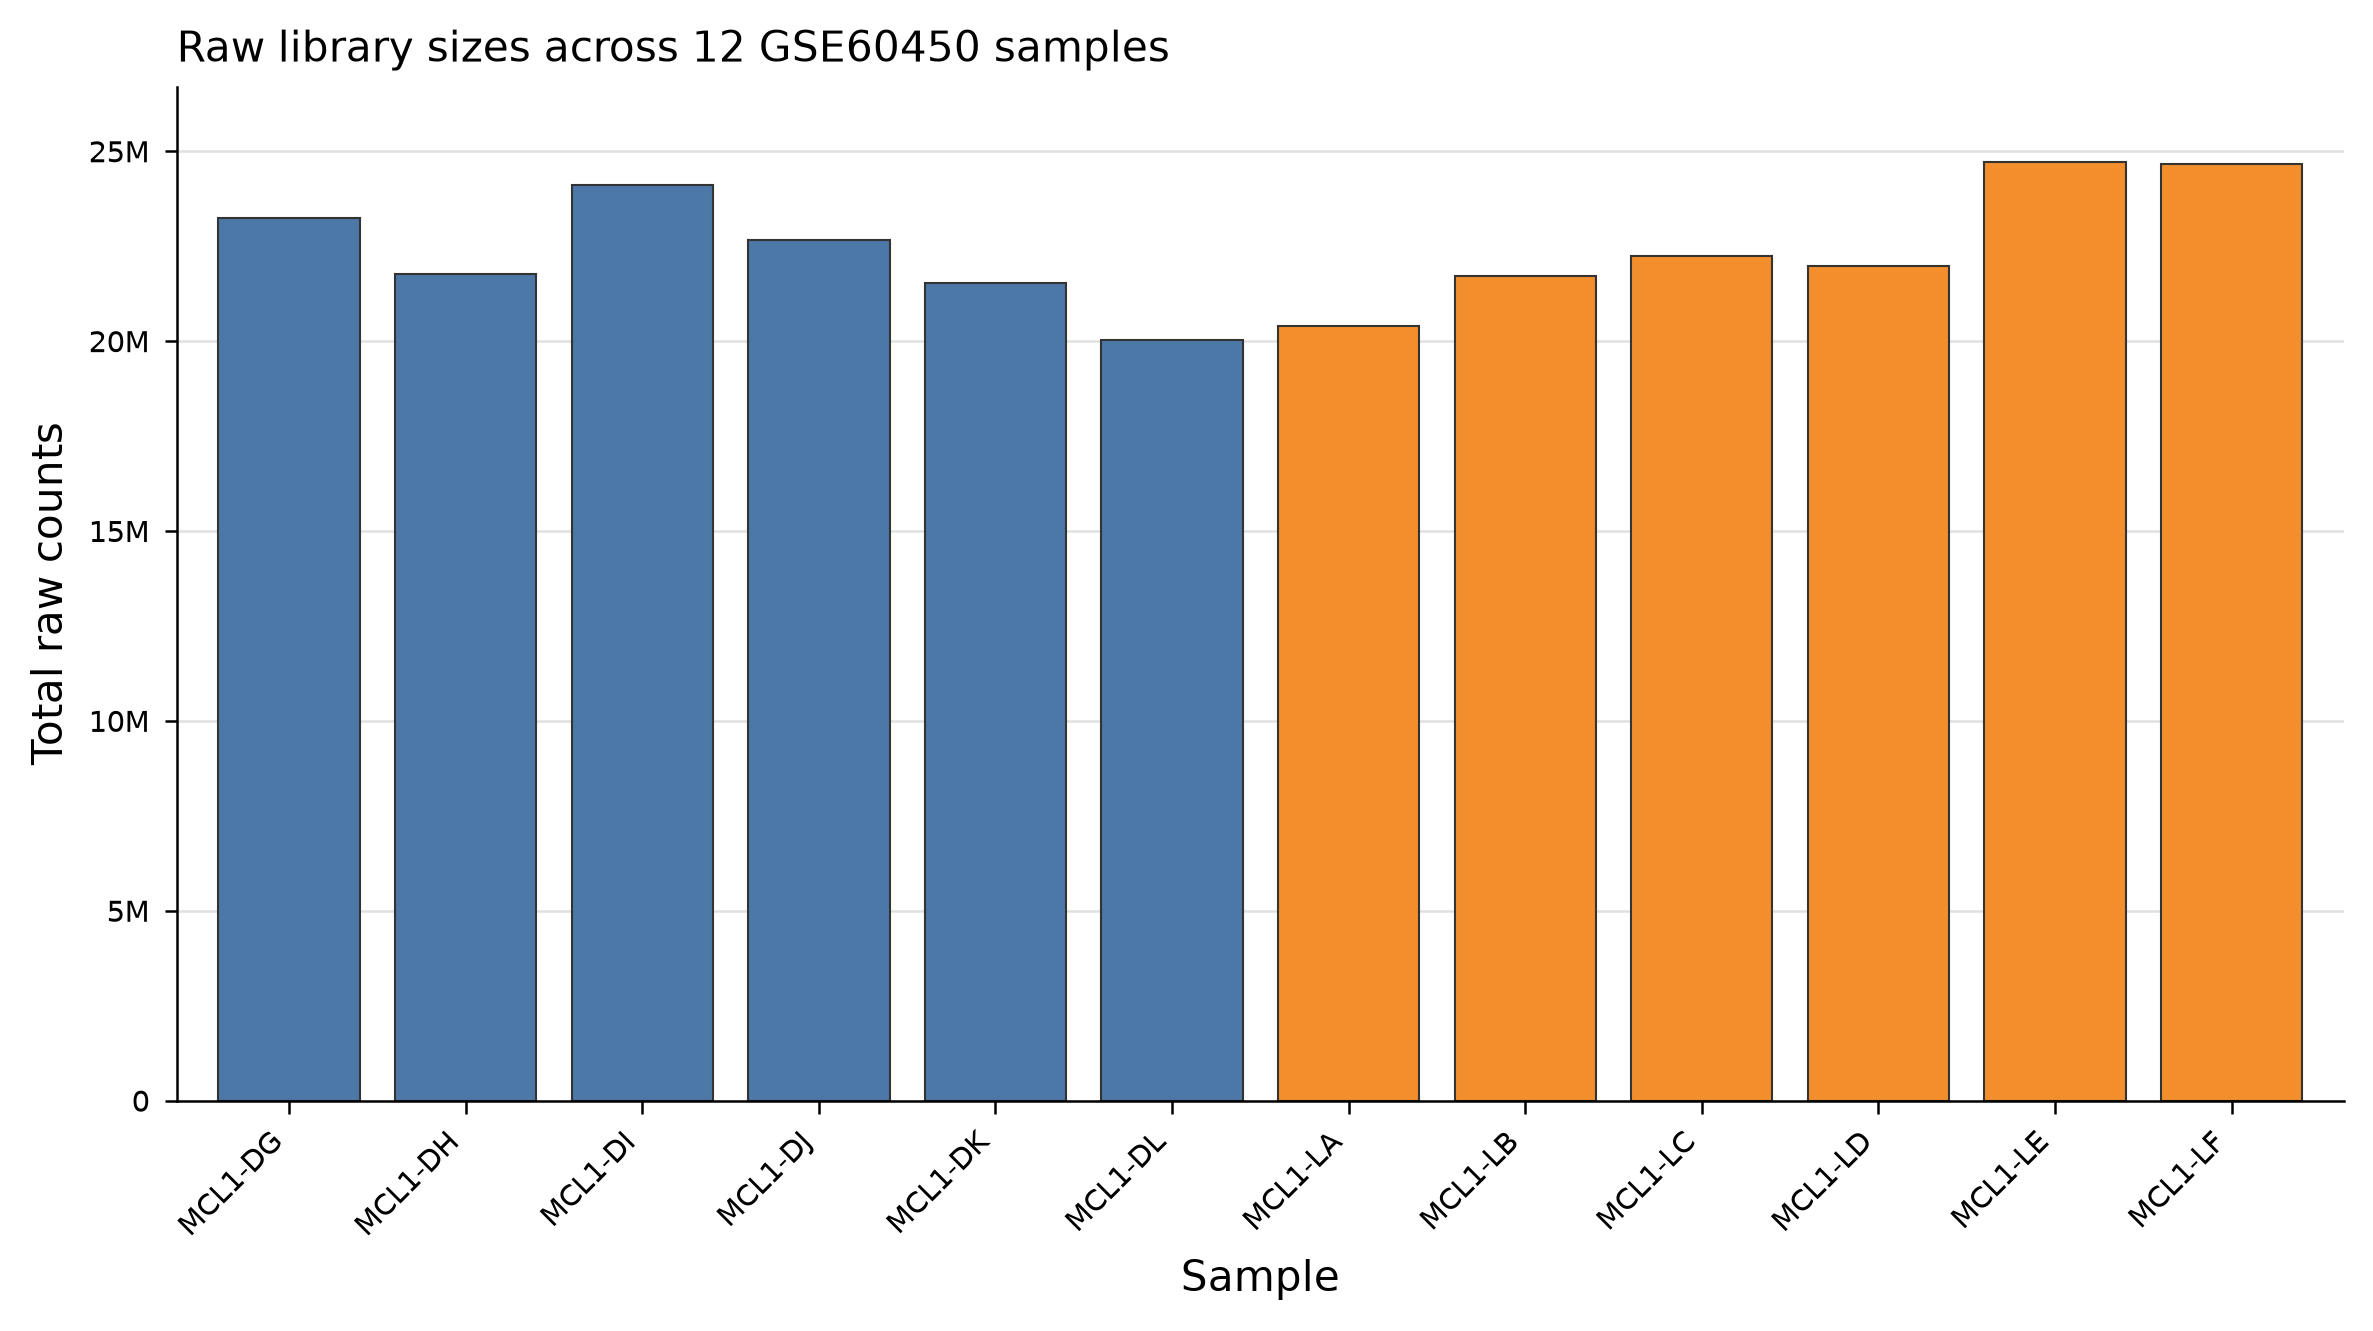
Öffnen Sie rnaseq-library-sizes.png und vergrößern Sie es. Überprüfen Sie alle zwölf Beispieletiketten, die Rohzählachse und den Hinweis, dass die Werte nicht normalisiert sind. Die Gesamtzahlen reichen von 20,015,386 bis 24,723,827 in dieser Matrix.
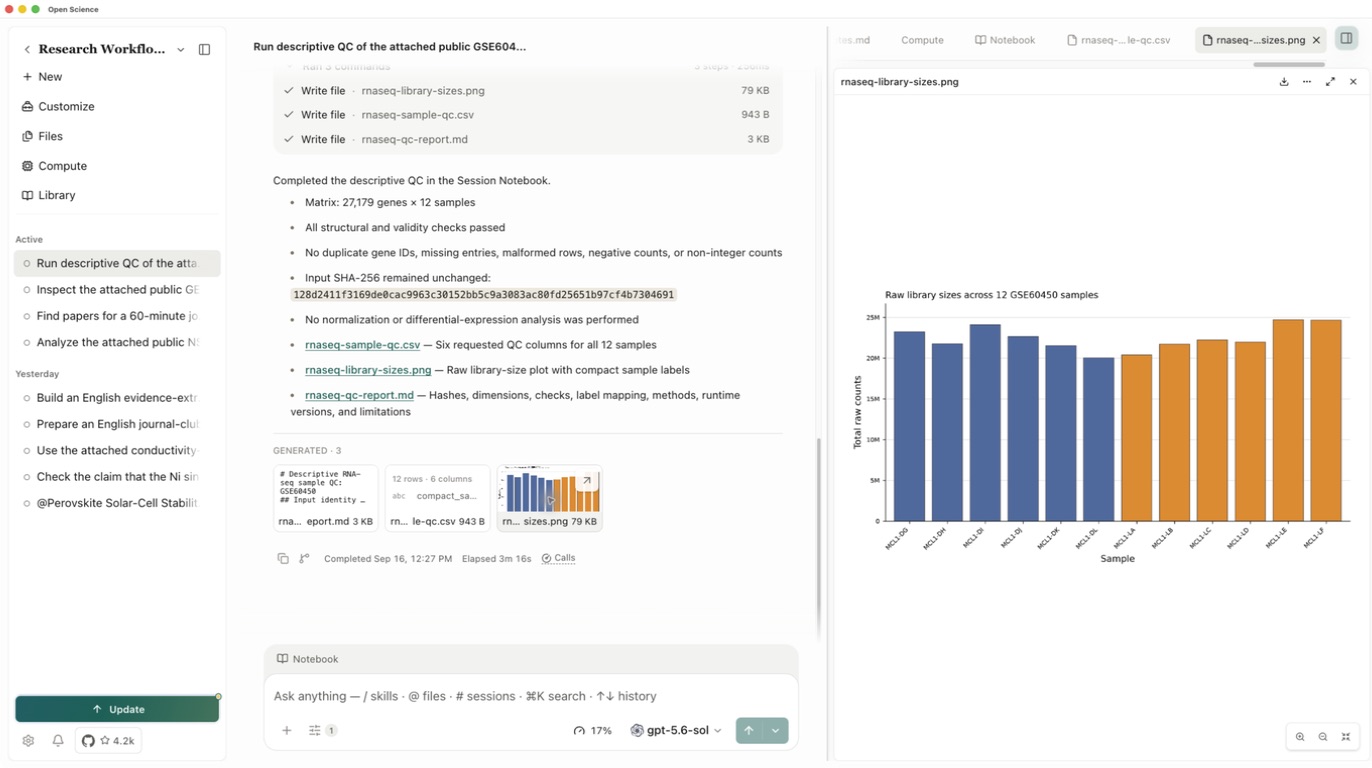
Eine größere Bibliothekssumme bedeutet an sich nicht, dass ein Gen differentiell exprimiert wird. Vor einer separaten nachgelagerten Analyse die Stichprobenmerkmale den GEO-Metadaten zuordnen und das Design, die Kontraste, die Normierung und die Filterregeln angeben. Ein separates Connector-Follow-up holte die GEO-Eigenschaften der zwölf Proben ab. die GSM-zu-Matrix-Spalten-Zuordnung, das Analysedesign und die statistischen Schritte wurden hier nicht validiert. Siehe Konnektoren.
6. Bewahren Sie die Methoden und Beweise auf
Führen Sie einen Bericht mit der Eingabeprüfsumme, den Abmessungen, den Gültigkeitsprüfungen, dem exakten Label-Mapping, den Laufzeit-/Bibliotheksversionen und den Interpretationsgrenzen. Fügen Sie erst nach dem Vergleich der Werte einen Abschnitt mit unabhängiger Überprüfung hinzu. Das Speichern einer Berichtsrevision berechnet die Tabelle oder Figur nicht neu.
Der September 16-Wiederholungstest hat alle 48-Metriken mit der unabhängig überprüften Baseline verglichen. Sein Eingang SHA-256 blieb 128d2411f3169de0cac9963c30152bb5c9a3083ac80fd25651b97cf4b7304691. Der Bericht zeichnet Python 3.12.14 und matplotlib 3.11.1 auf. Diese Kontrollen stellen die Zustimmung und die Erhaltung der Eingabedaten dieser Berechnung fest; Sie erstellen kein Reviewer-Audit oder eine genaue Umgebung für eine unabhängige Reproduktion.
Laden Sie die QC-Tisch, Grundstück und Bericht dieser Wiederholung herunter. Behalten Sie auch die ursprüngliche Eingabe und die Sitzung Notebook bei. Der Beispieldatenseite behält die frühere Baseline und Notebook exportiert separat; Diese Exporte sind nicht der Notebook aus dieser Wiederholung. Verwenden Sie Reproduzierbarkeitsprüfungen für eine separate Environment-and-Rerun-Bewertung.