Vergleichen Sie zwei Analysemethoden mit denselben Daten
Praxisbeispiel PCA und explorative Faktoranalyse der psych::bfi Items
Das Ändern von Methoden ist nur dann informativ, wenn die Eingaben und die Vorverarbeitung vergleichbar sind. Dieses Beispiel wendet standardisierte Hauptkomponentenanalyse (PCA) und Fünf-Faktor-Maximum-Likelihood-Faktor-Analyse (FA) auf den gleiche 2,436 vollständige Antworten an. Es vergleicht, was die Methoden schätzen, anstatt die größte Zahl als Gewinnmethode zu behandeln.
1. Bereiten Sie den öffentlichen Input und die R-Laufzeit vor
Laden Sie das öffentliche psych::bfi CSV herunter, speichern Sie es als bfi-original.csv und lesen Sie das Dokumentation des Datensatzes. Es enthält 2,800-Befragte, 25-Persönlichkeitselemente und demografische Spalten. Für die Analyse werden nur A1–A5, C1–C5, E1–E5, N1–N5 und O1–O5 verwendet. Es handelt sich nicht um eine individuelle psychologische Beurteilung.
In Settings → Runtimes, bestätigen R ist Ready und aktiviert. Der aufgezeichnete Durchlauf R 4.4.3, mit Base/empfohlen R Funktionen und keine zusätzliche Paketinstallation. Fügen Sie das CSV an eine Projektkonversation über + → Attach files an.
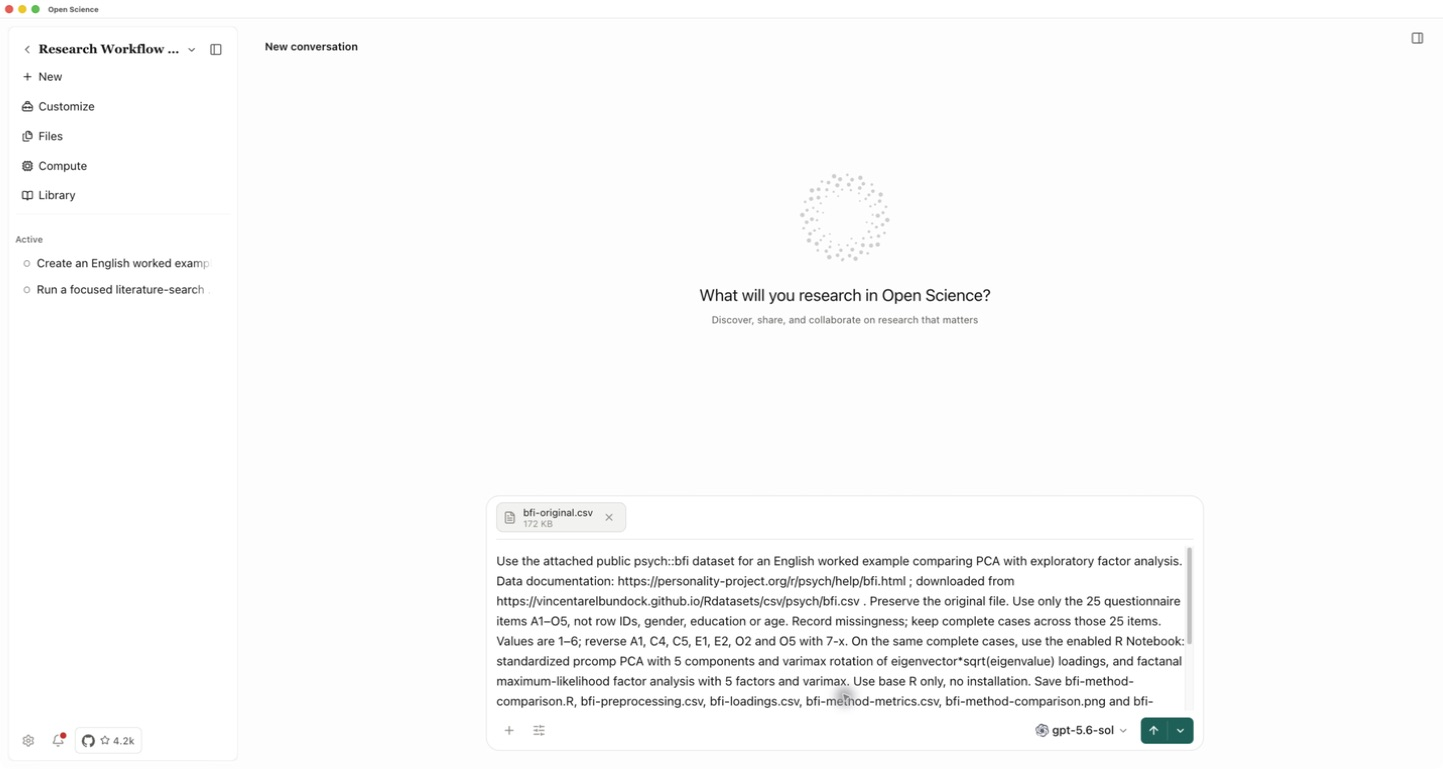
2. Beheben Sie die Vorverarbeitung, bevor Sie eine der beiden Methoden anpassen
Use the attached psych::bfi CSV in the enabled R Notebook.
Analyze only its 25 A/C/E/N/O items, scored 1–6. Validate the range.
Reverse A1, C4, C5, E1, E2, O2 and O5 as 7-x. Use the same complete
cases across all 25 items for both methods; report exclusions.
Run prcomp with centering/scaling and retain five components.
Varimax-rotate eigenvector times sqrt(eigenvalue) loading columns;
label them RotPC1–RotPC5. Report variance from unrotated PC1–PC5.
Run factanal with five factors, varimax and nstart=10; set seed 20260916.
Save bfi-method-comparison.R, bfi-preprocessing.csv, bfi-loadings.csv,
bfi-method-metrics.csv, bfi-method-comparison.png and bfi-method-report.md.
Make the script accept the input CSV as its first argument, record
runtime input identity and R version, execute it and reopen all outputs.
Explain fit, convergence, arbitrary signs/order, ordinal responses
and complete-case limitations. Do not claim that convergence is good fit.
Use English and do not install packages or delegate.
Überprüfen Sie die R-Berechnung, bevor Sie sie genehmigen. Öffnen Sie Notebook und bestätigen Sie die Ausführung. Die gespeicherte Vorverarbeitungsmatrix hat 2,436 Zeilen × 25 Positionen, außer 364 unvollständige Befragte. Dieselbe Matrix speist beide Methoden; Demografie und Zeilenkennungen sind ausgeschlossen.
Wenn eine methode stillschweigend eine andere gruppe von befragten verwendet, stoppen und versöhnen sie die eingaben, bevor sie ihr ergebnis vergleichen.
3. Prüfen Sie die numerischen Ergebnisse
Öffnen Sie bfi-method-metrics.csv von Generated oder Files. Die aufgezeichnete Datei enthält metrische Zeilen 77, einschließlich der Anzahl der Proben, des Fehlens, der PCA-Varianz, der FA-Einzigartigkeiten, der Passform, der Konvergenz, der Seed- und Eingabeidentität.
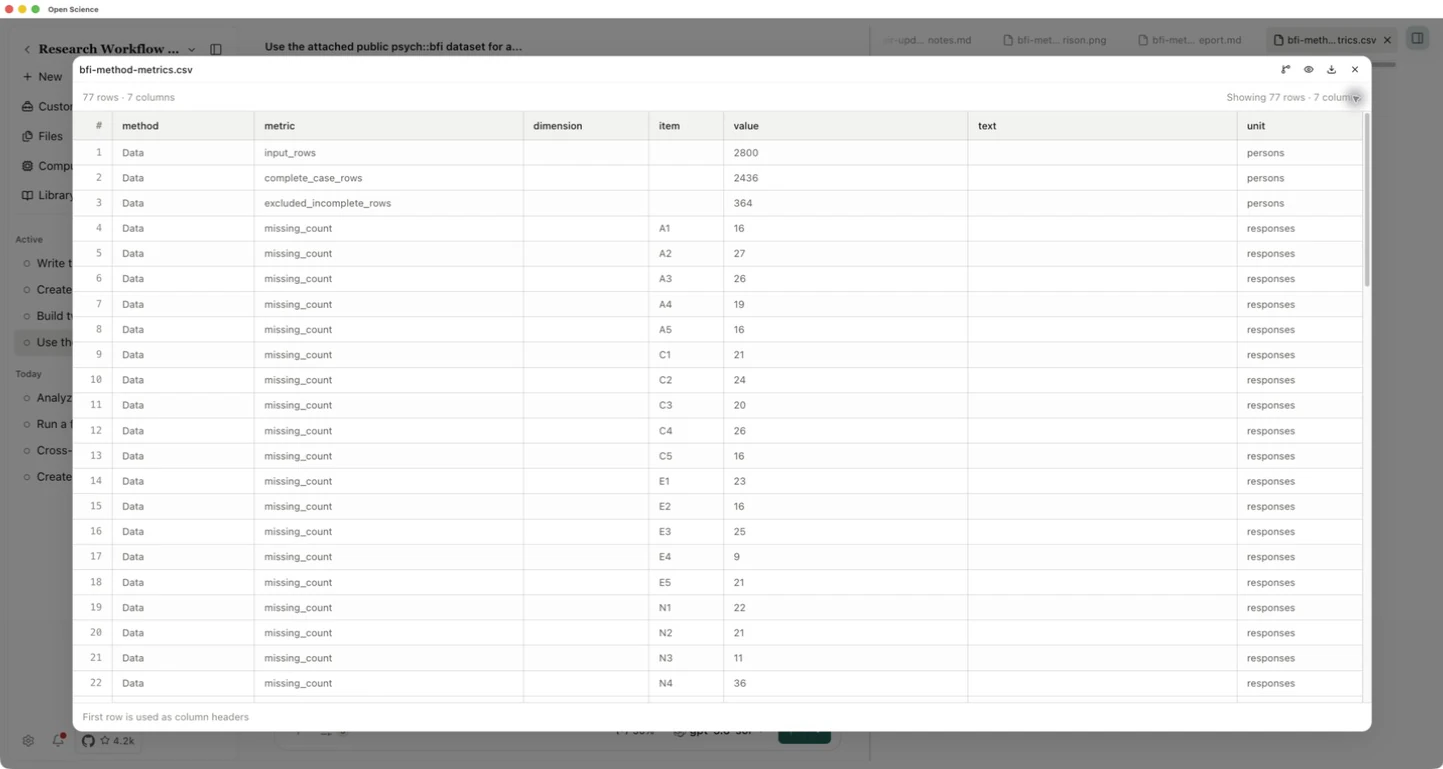
| Nicht gedrehte PCA-Komponente | Genormte Gesamtvarianz erklärt |
|---|---|
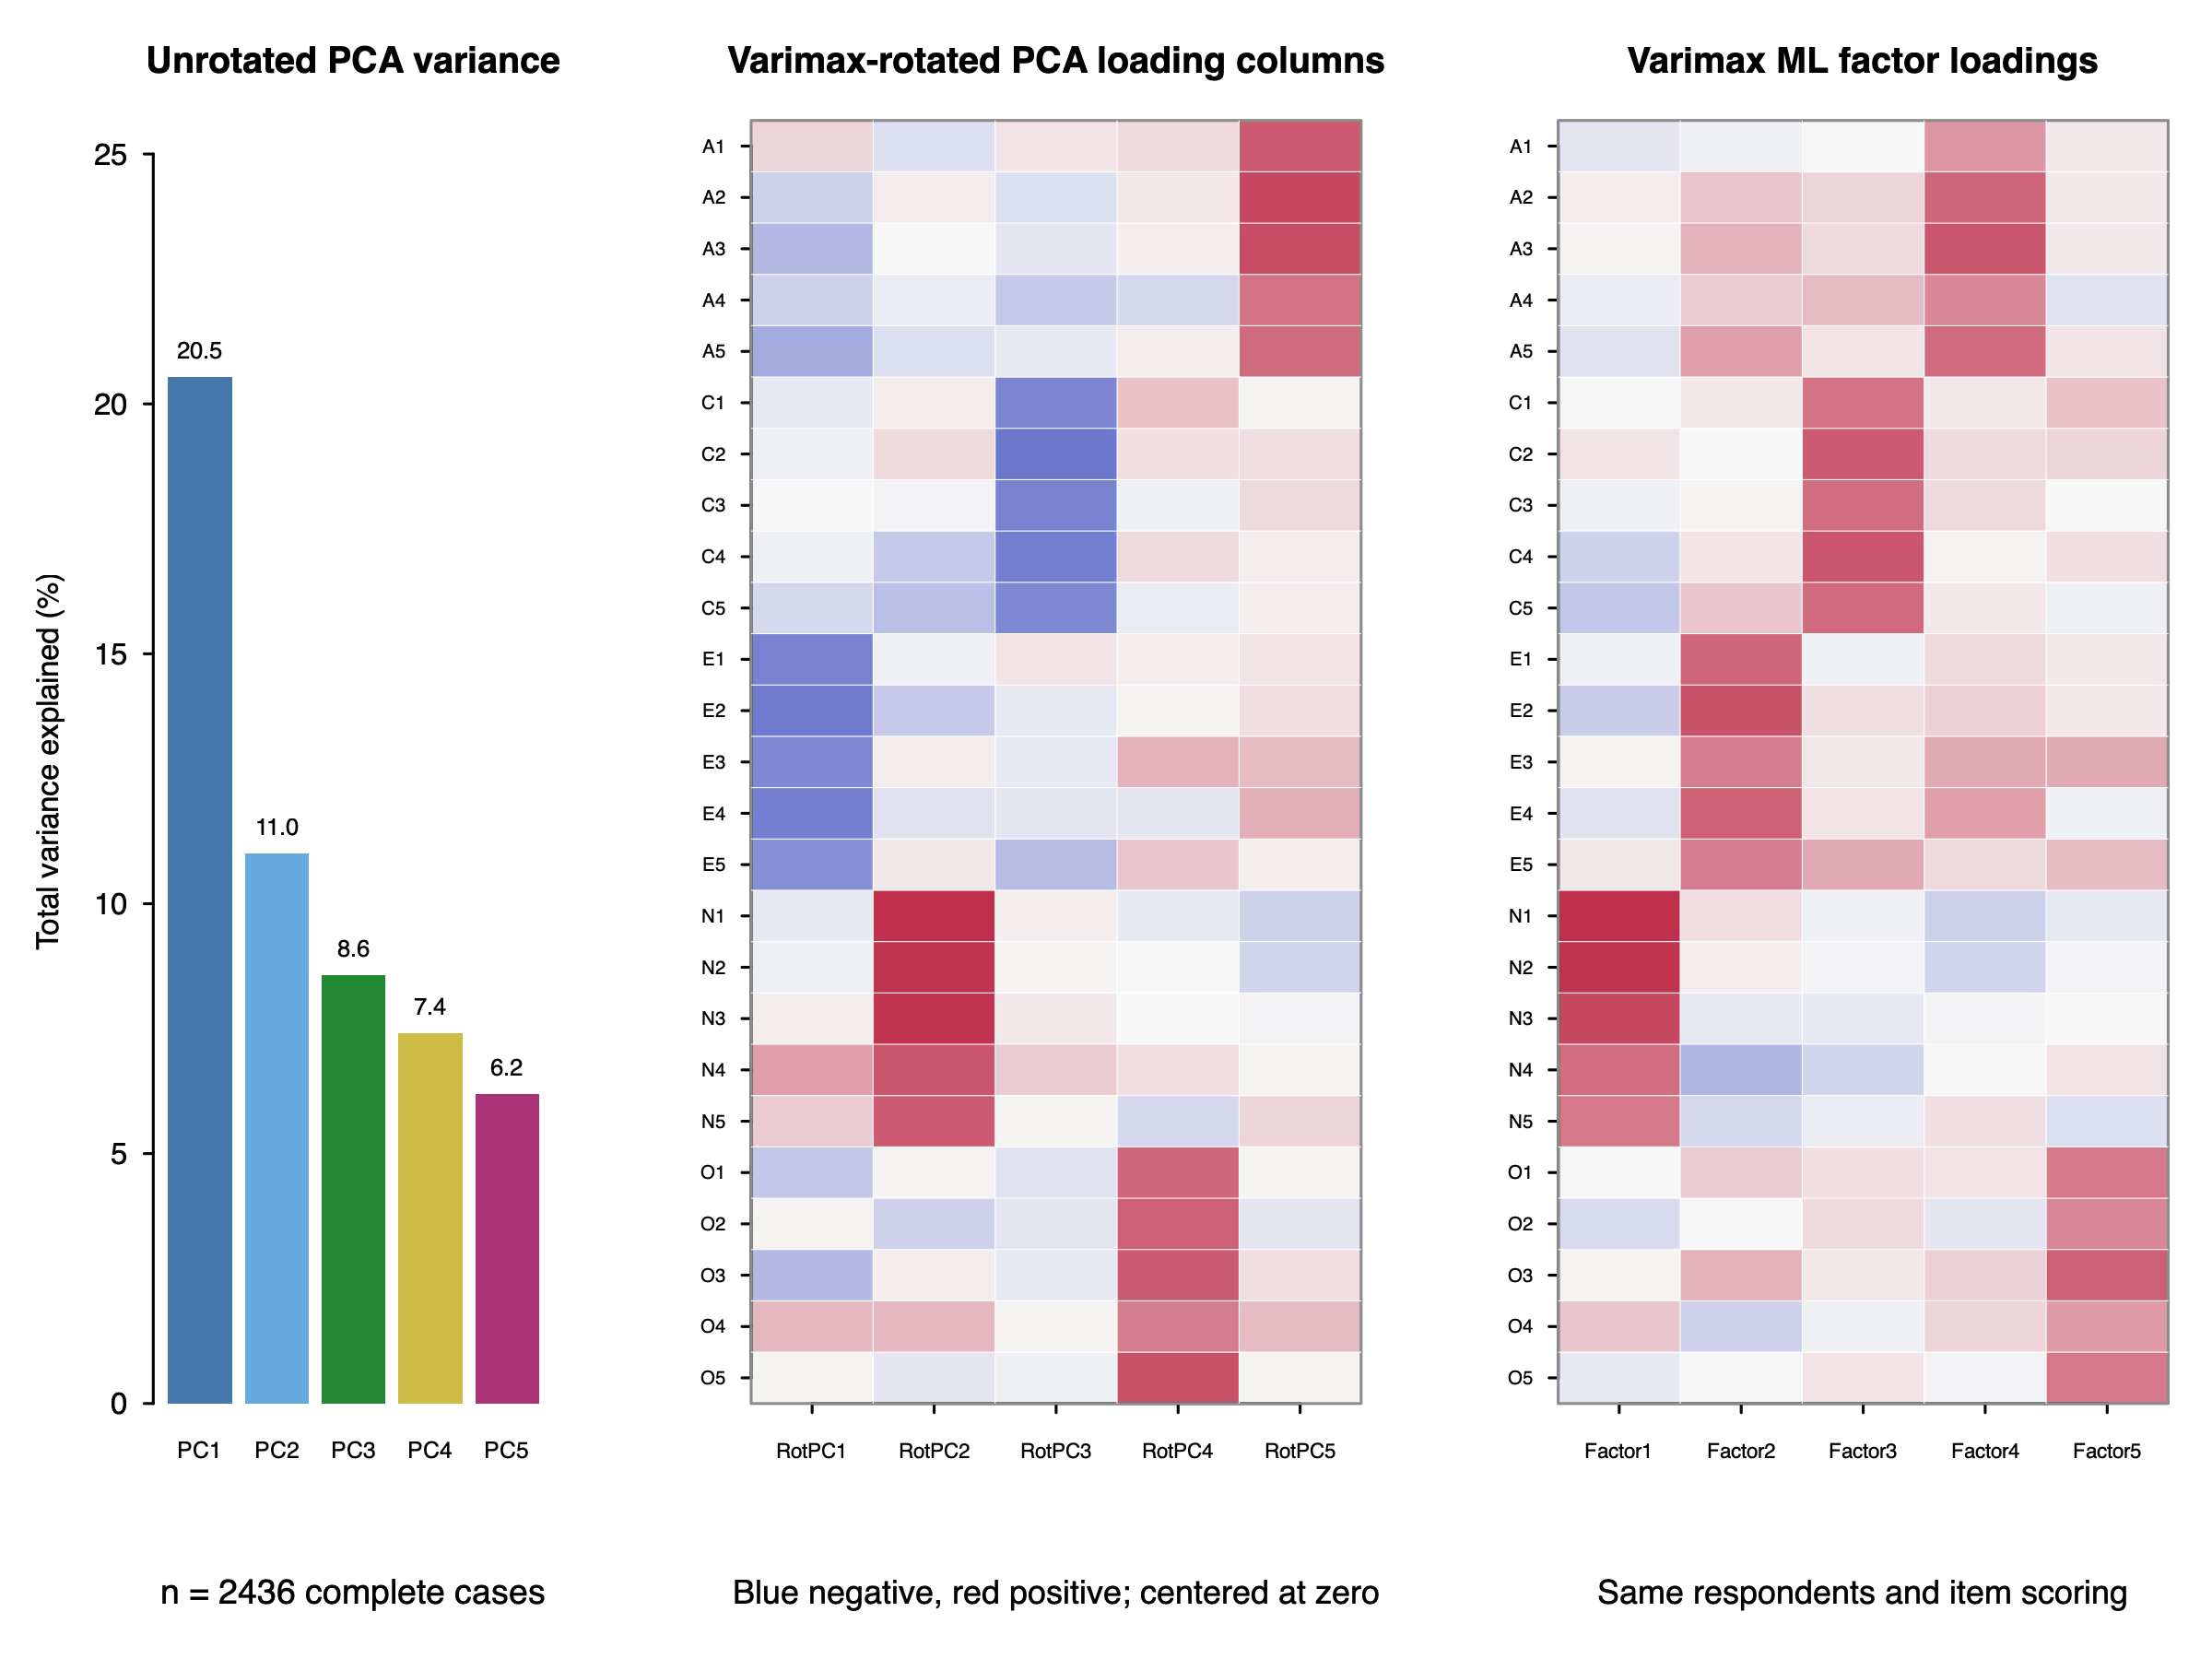
| PC1 | 20.54% |
| PC2 | 11.01% |
| PC3 | 8.57% |
| PC4 | 7.41% |
| PC5 | 6.19% |
| Die ersten fünf kombiniert | 53.72% |
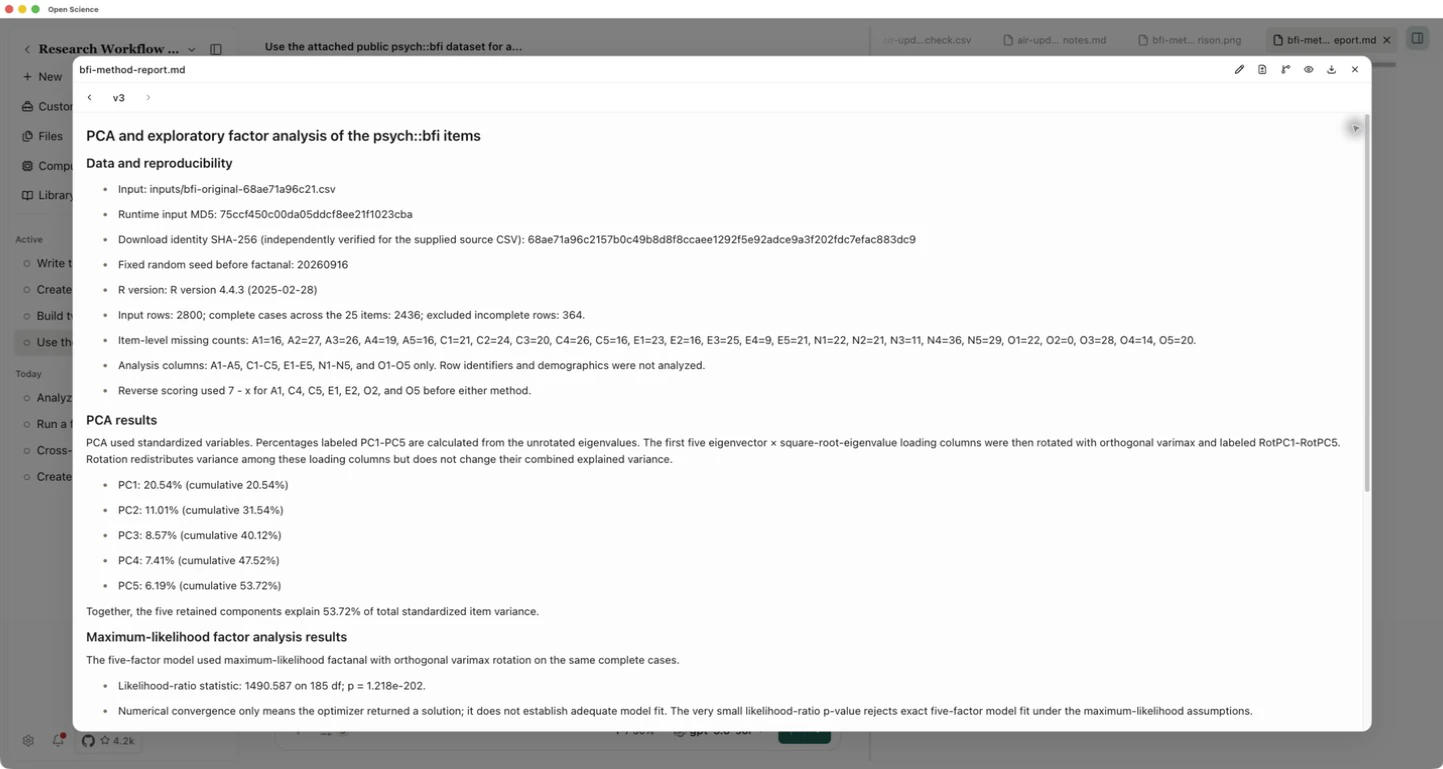
Der FA-Optimierer konvergierte, aber die Wahrscheinlichkeits-Verhältnis-Statistik war 1490.587 auf 185 Freiheitsgrade, mit p ≈ 1.218 × 10⁻²⁰². Unter den Modellannahmen lehnt dies eine exakte Fünf-Faktor-Fit ab. Erfolgreiche numerische Ausführung stellt keine ausreichende Passform her.
4. Vergleichen Sie die Beladungsmuster in der Abbildung
Öffnen Sie bfi-method-comparison.png. Seine drei Panels zeigen unrotierte PCA-Varianz, varimax-rotierte PCA-Ladungen und varimax FA-Ladungen. Die genauen Ladewerte sind in bfi-loadings.csv, mit 250-Zeilen: 25 Elemente × 5 Dimensionen × 2 Methoden.
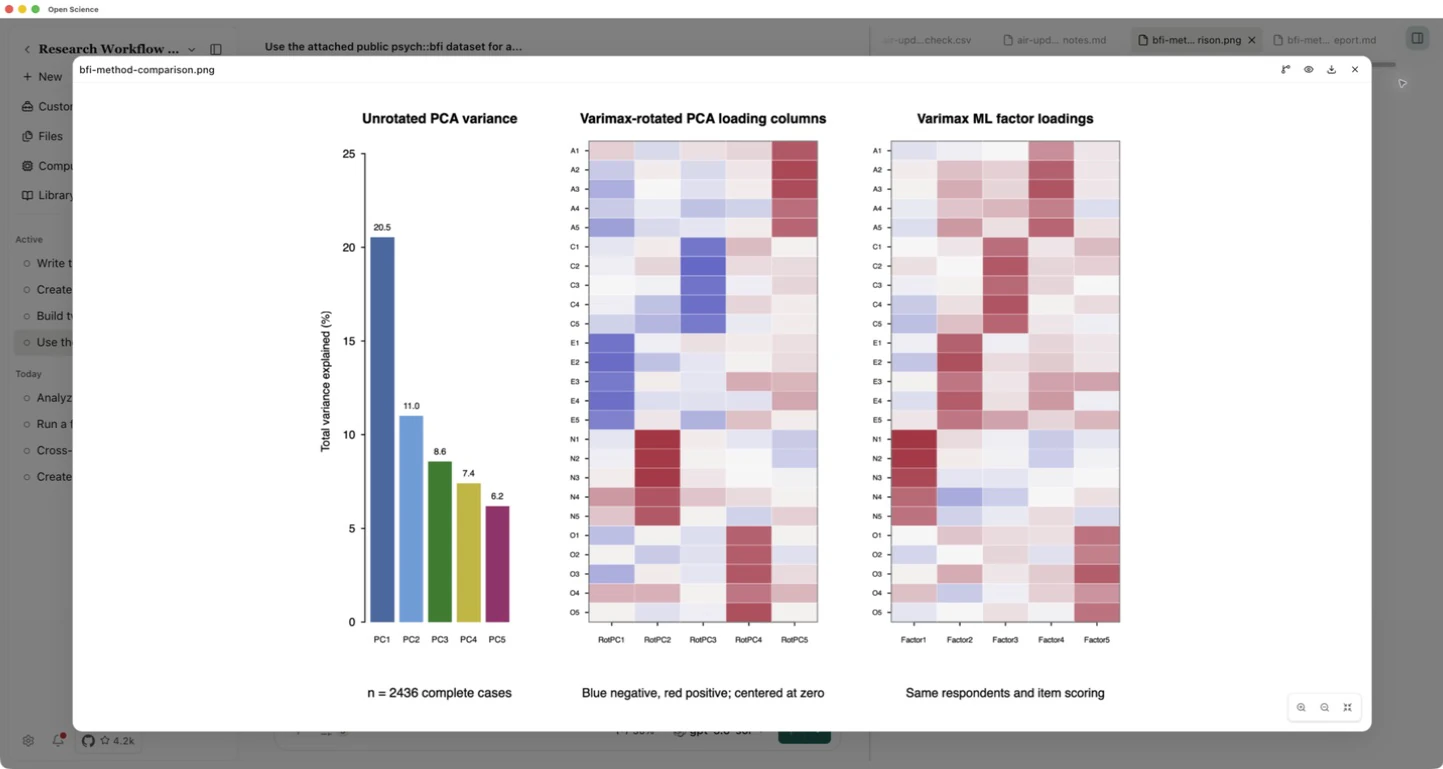
Passen Sie "Spalte 1" nicht mechanisch über die Methoden hinweg an. Faktor/Komponenten-Reihenfolge und -Zeichen können sich ändern, ohne die Lösung zu ändern. Die Heatmaps verwenden Blau für negative und Rot für positive Belastungen; Artikelmuster und numerische Werte vergleichen.
PCA-Partitionen insgesamt beobachtete Varianz; FA-Modelle teilten Kovarianz mit separaten Einzigartigkeiten. FA-Summen quadrierter Ladungen sind nicht mit der erläuterten PCA-Varianz austauschbar. Die gedrehten Etiketten RotPC1–RotPC5 werden gezielt von den unrotierten PC1–PC5-Varianzprozentsätzen unterschieden.
5. Lesen Sie die Einschränkungen und führen Sie das gespeicherte Skript erneut aus
Öffnen Sie bfi-method-report.md. Prüfen Sie, ob die gleiche Probe und Vorverarbeitung, das fixierte Saatgut und der Unterschied zwischen Konvergenz und Passform gemeldet werden. Diese 1-6-Ordinalantworten werden als annähernd kontinuierlich behandelt; Eine vollständige Löschung kann sich ergeben, wenn die fehlenden Antworten oder Teilnehmermerkmale vorliegen.
Laden Sie R Skript, Beladungen, Metriken, Abbildung und Bericht herunter. Setzen Sie das Skript und die heruntergeladene Eingabe in einen neuen Ordner, öffnen Sie dort ein Terminal und führen Sie aus:
Rscript bfi-method-comparison.R bfi-original.csv
Das Skript schreibt seine Ausgänge in den aktuellen Ordner. Das aufgezeichnete Skript wurde unabhängig voneinander mit R 4.4.3 wiederholt: Vorverarbeitung, Laden und metrische CSVs stimmten mit den gespeicherten Dateien der App überein. Alle Vorverarbeitungszellen und PCA-Eigenwerte wurden ebenfalls separat überprüft. Diese Prüfungen stellen die Reproduzierbarkeit dieser Berechnung fest; sie wählen keine allgemein überlegene Methode oder validieren keinen Diagnosetest.