更新されたデータで分析を再開
実践例 北京航空品質観測の2週目の週を追加します。
新規の観察が到着したら、ベースラインを保存し、結果を比較する前に同じ方法を再実行します。 この例では、実際の アオチズンキシン 時間 PM2.5 データを使用します。 1月 1–7、2016 は、最初に、1月 8-14 を使用します。 段階的な到着は、ライブ監視ではなく、歴史の教え再生です。
1. 最初の週に添付し、計算を定義する
入力は CC によって 4.0 の下で配られる UCI北京マルチサイトエア品質データセット の chronological のサブセットです。 週 1と週 2をダウンロードしてください。 ソースのクレジットとファイル識別はソースノートにあります。
プロジェクトの会話を開き、+ → Attach filesを介してair-week1.csv のみを添付します。 利用可能なモデルを選択し、確認 Python です。 Ready 有効にして下さい Settings → Runtimes. . . . 送信:
Analyze the attached first week of Aotizhongxin hourly PM2.5 data.
Validate station, dates, numeric PM2.5, duplicate and missing timestamps.
Preserve missing observations; never replace them with zero.
Calculate daily means in micrograms per cubic metre and valid-hour
counts. Mark a day complete when at least 18 PM2.5 hours are valid;
this is our teaching convention, not an official air-quality standard.
Save air-analysis.py, air-daily-v1.csv, air-daily-v1.png and
air-report-v1.md. The script must accept one or more CSV paths plus
--output-prefix and --report. Execute it, reopen the files and record
input/script hashes. Stop after this baseline. Use English.
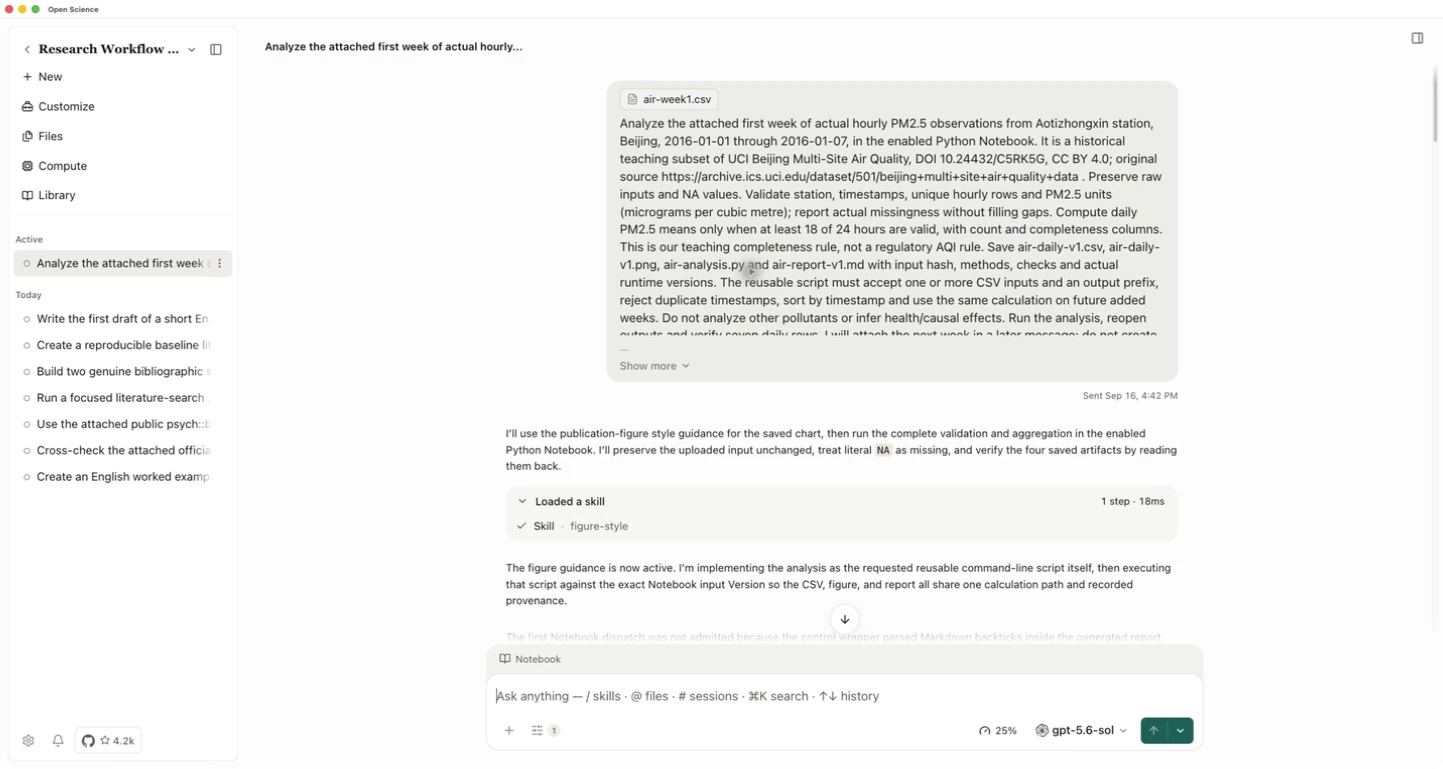
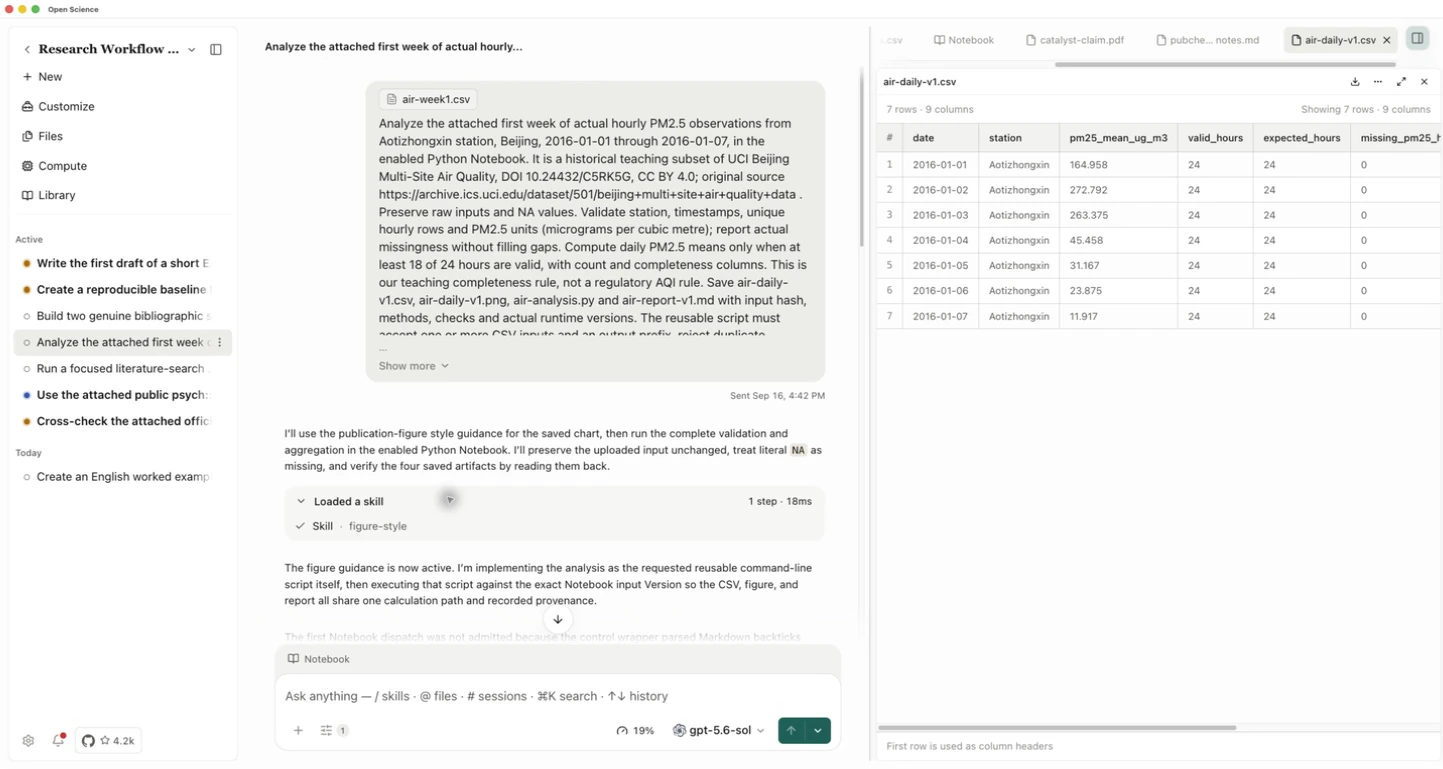
承認する前にファイルを読み、計算を見直します。 Notebook では、実行終了を確認し、air-daily-v1.csv を開きます。 ベースラインには、PM2.5値が見つからずに168 時系列列と 7 日列が含まれています。
2. 方法を変更することなく新しい観察を追加
同じ会話を続けてください。 air-week2.csv を添付し、最初の添付ファイルを取り消し、リクエスト:
Read the newly attached air-week2.csv together with the original week 1.
Run the saved air-analysis.py unchanged using a new output prefix v2.
Do not overwrite the v1 files or regenerate a different analysis method.
Save air-daily-v2.csv, air-daily-v2.png and air-report-v2.md.
Compare every shared date and output field against air-daily-v1.csv.
Save air-update-check.csv and air-update-notes.md with new dates,
changed original rows, missing values and script/input hashes.
Reopen the saved results. This is a historical replay, not live data.
Use English and do not make health or causal claims.
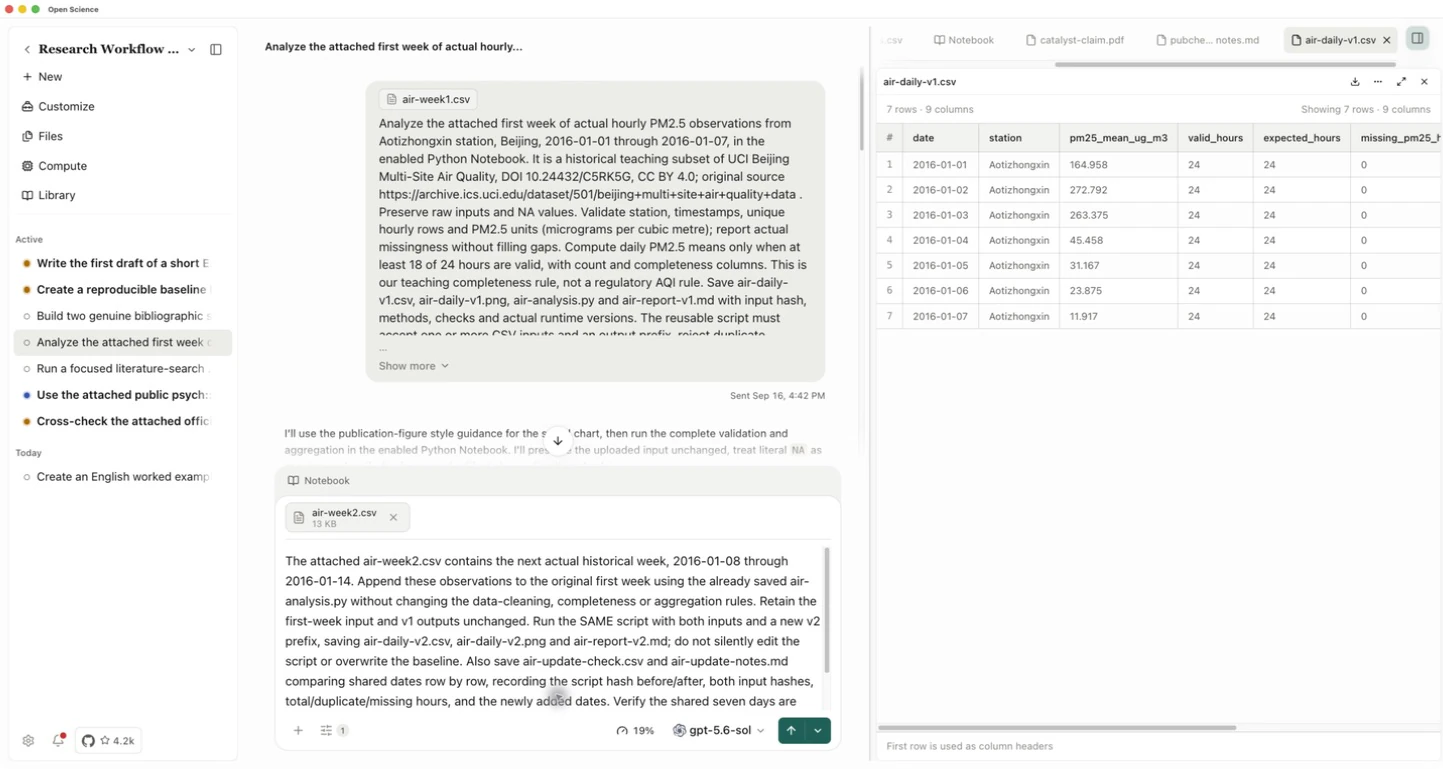
エージェントが既存のスクリプトを実行し、同じ欠落値と完全性ルールを保持していることを検証します。 結果が変更された理由を説明するために、データと方法の両方を変更することは困難になります。
3. 拡大した結果の特定
air-daily-v2.png と air-daily-v2.csv を開きます。 結合された入力は含んでいます 336 時系列と、 重複または欠落したタイムスタンプなし. . . . 1つの欠落PM2.5の観察は1月11にございます。 表には、14日 が搭載されており、例の 18-valid-hour ルールをすべて満たしています。
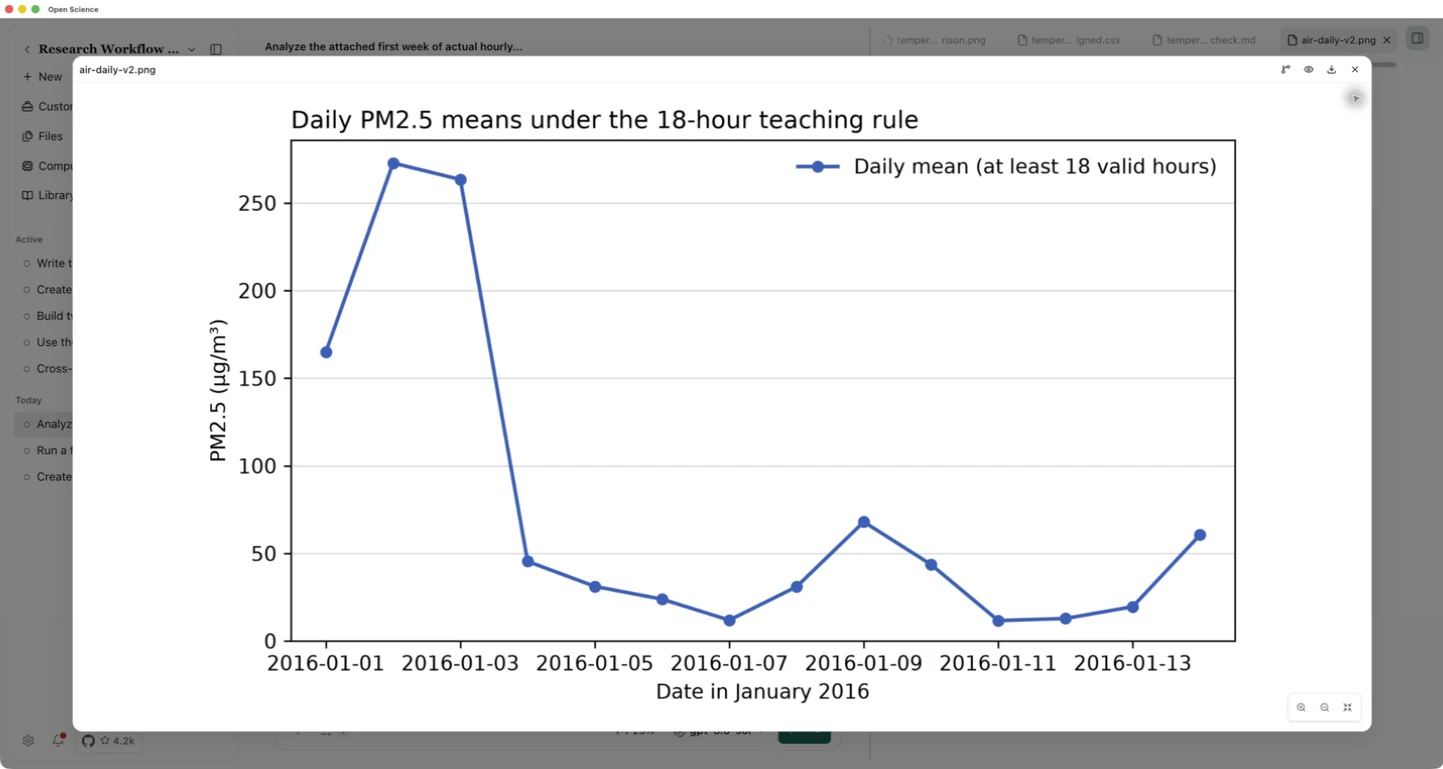
1月 11 は 11.652 μg/m3 で、23 有効な時間 から計算されます。 ゼロだったら、見落した観察を分割しないでください。 完全なタイムスタンプシーケンスは、すべての測定値が存在することを保証しません。
4. ベースラインと比較する
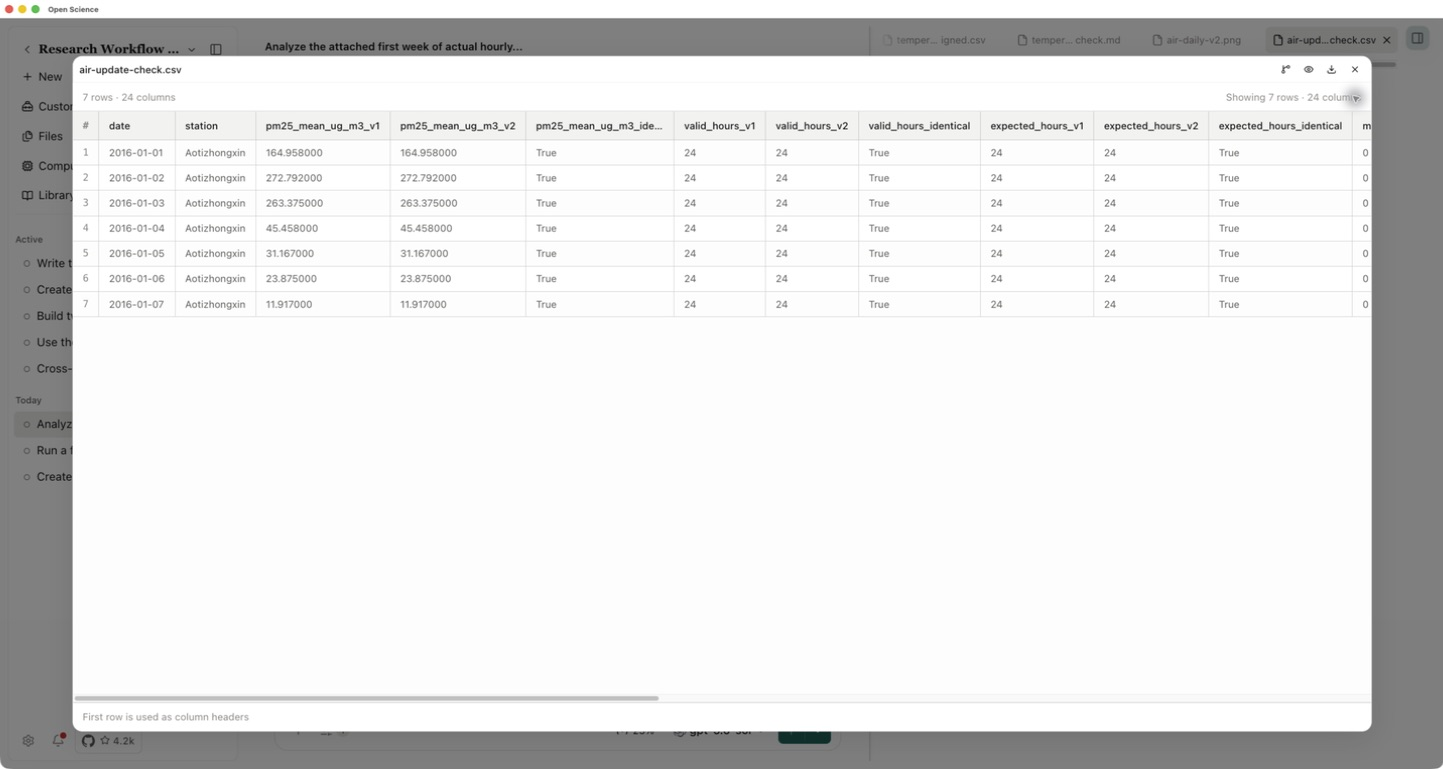
air-update-check.csv を開きます。 すべての 7つの共有日数列 は出力フィールド全体に同じです。 1月の8-14は、新しい日付のみです。 元のスクリプトの SHA-256 は、更新前後に変更されません。
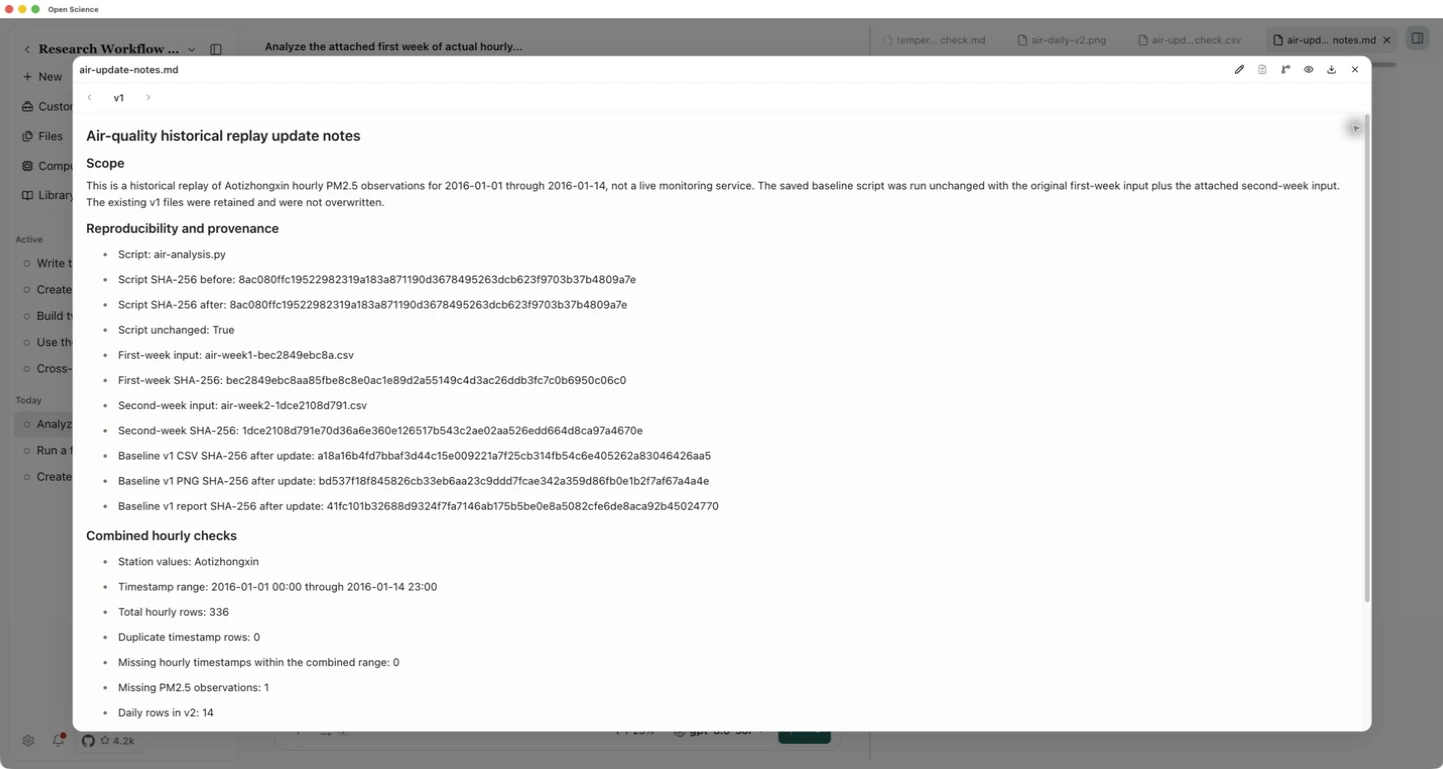
air-update-notes.md を開き、入力のアイデンティティ、欠落した観察、保持された v1 ファイルを確認します。 14の日常的な手段と、保存された出力と表示された精度に一致する有効な時間のカウントの独立した計算。
5. 退去前にレポートの日付を確認してください
実際の入力間隔でレポートヘッディングが続くことを確認します。 初期スクリプトは、2週間のレポートで最初の週のタイトルを保持しました。 air-analysis-reviewed.py で発表エラーを修正しました。 見出しテンプレートのみが変更されました。 その後、レビューされたスクリプトは、1と2週間で変更されていない実行され、すべての以前のファイルを保存します。
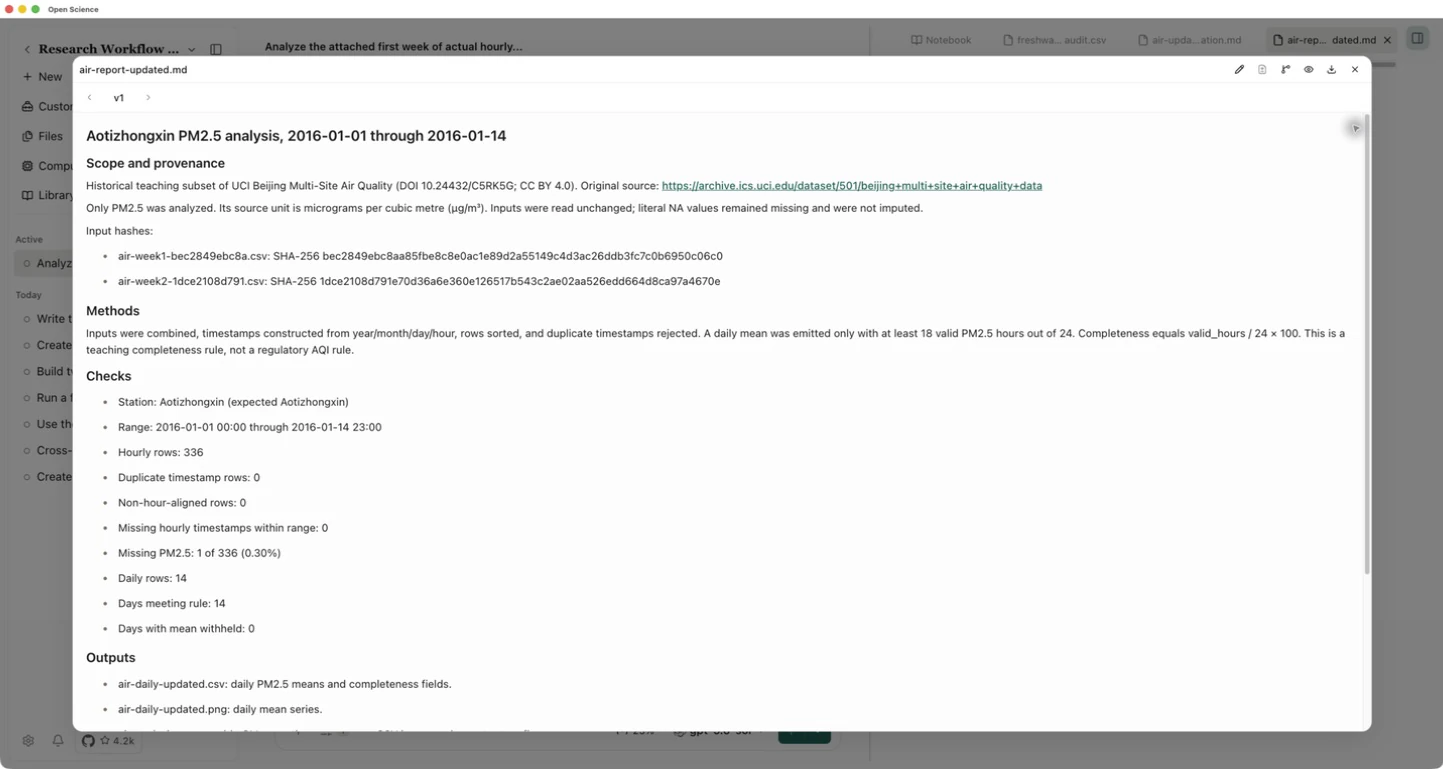
air-daily-baseline.csv と air-daily-updated.csv は、すべてのフィールドで元の v1/v2 CSV にマッチします。 air-update-verification.md は、実行前後の同じレビューされたスクリプトハッシュを記録し、2 つのレポートヘッディングをチェックします。 数値メソッドの変更から修正されたラベルを分離します。
Pythonスクリプトのレビュー、ベースライン CSV、CSVの更新、行の比較、更新レポート、検証ノートをダウンロードしてください。 パンダ、NumPy、MatplotlibでPythonを使うと、両方の入力を保持し、新しいプレフィックスに書きます。
python air-analysis-reviewed.py air-week1.csv air-week2.csv --output-prefix air-daily-rerun --report air-report-rerun.md
比較では、1つのステーションと2つの歴史の週について説明します。 AQIの分類、暴露評価、または原因介入の証拠ではありません。 同じデータを保持しながら解析方法の変更については、メソッドを比較する を参照してください。