同じデータで2つの解析方法を比較する
実践例 PCAとサイクの実験的要因解析:bfi項目
入力とプリプロセッシングが比較可能である場合にのみ、メソッドを変更できます。 この例では、標準化されたプリンシパルコンポーネント解析(PCA)と5要素最大値の因子解析(FA)を同じ 2,436 の完全な応答に応用します。 勝法としては最大数を扱い、方法の推定値を比較します。
1. パブリック入力とRランタイムの準備
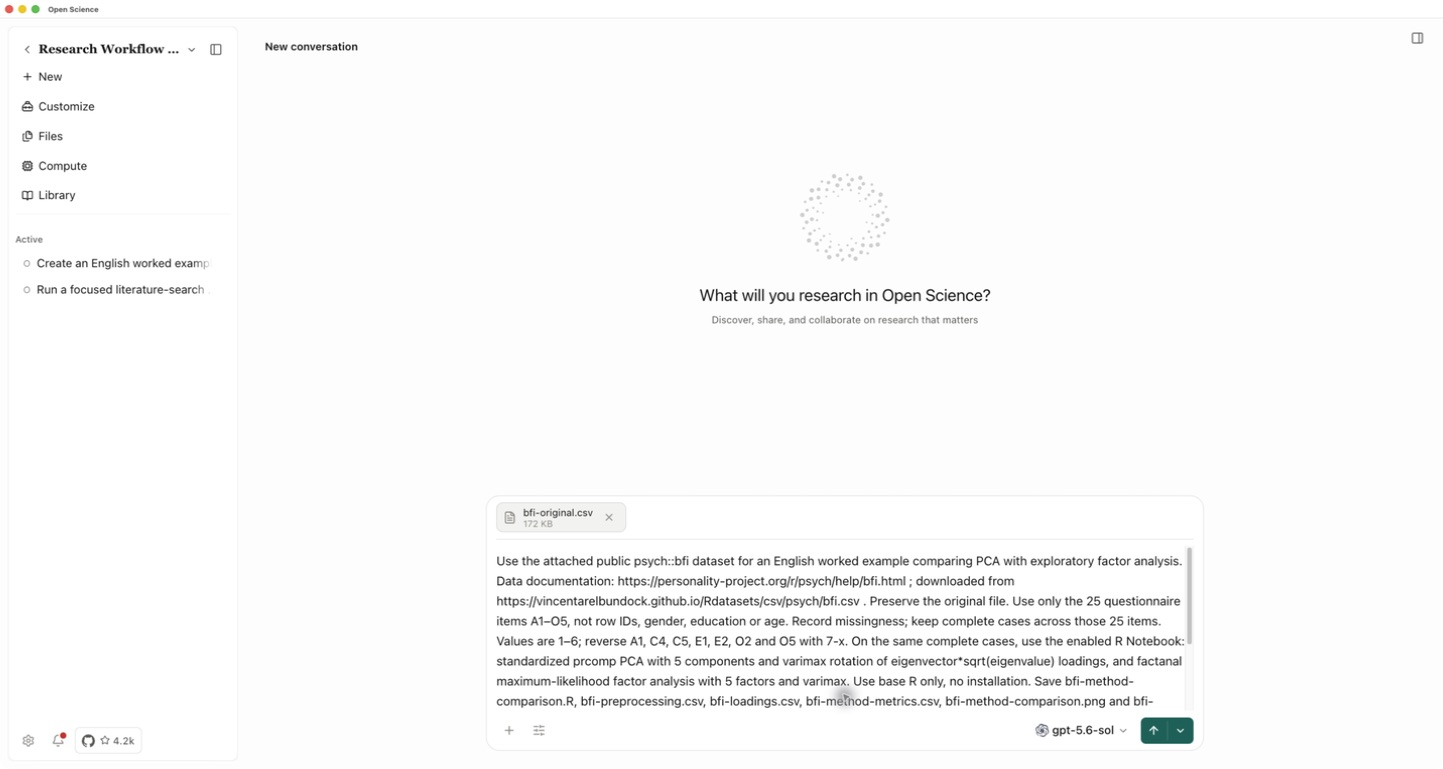
サイク::bfi CSV の公開版をダウンロードし、bfi-original.csv として保存し、データセットのドキュメント を読んでください。 2,800 回答者、25 パーソナリティアイテム、デモグラフィックカラムが含まれています。 解析は、A1-A5、C1-C5、E1-E5、N1-N5、O1-O5のみを使用します。 個人の心理的評価ではありません。
Settings → Runtimes では、R が Ready であり、有効になっていることを確認します。 記録された操業は基盤/推薦されたR機能および余分パッケージの取付けと、R 4.4.3を使用しました。 CSV を + → Attach files を通じてプロジェクト会話に添付します。
2. どちらの方法かを合わせる前に前処理を修理して下さい
Use the attached psych::bfi CSV in the enabled R Notebook.
Analyze only its 25 A/C/E/N/O items, scored 1–6. Validate the range.
Reverse A1, C4, C5, E1, E2, O2 and O5 as 7-x. Use the same complete
cases across all 25 items for both methods; report exclusions.
Run prcomp with centering/scaling and retain five components.
Varimax-rotate eigenvector times sqrt(eigenvalue) loading columns;
label them RotPC1–RotPC5. Report variance from unrotated PC1–PC5.
Run factanal with five factors, varimax and nstart=10; set seed 20260916.
Save bfi-method-comparison.R, bfi-preprocessing.csv, bfi-loadings.csv,
bfi-method-metrics.csv, bfi-method-comparison.png and bfi-method-report.md.
Make the script accept the input CSV as its first argument, record
runtime input identity and R version, execute it and reopen all outputs.
Explain fit, convergence, arbitrary signs/order, ordinal responses
and complete-case limitations. Do not claim that convergence is good fit.
Use English and do not install packages or delegate.
承認する前にRの計算を確認します。 Notebook を開き、実行完了を確認します。 保存されたプリプロセッシングマトリクスは、364 不完全な応答 を除く 2,436行×25項目 を持っています。 この同じ行列は両方のメソッドをフィードします。 人口統計と行の識別子は除外されます。
1つの方法が無声に反応の異なるセットを使用していれば、その結果を比較する前に入力を停止し、調整します。
3. 数値結果を調べる
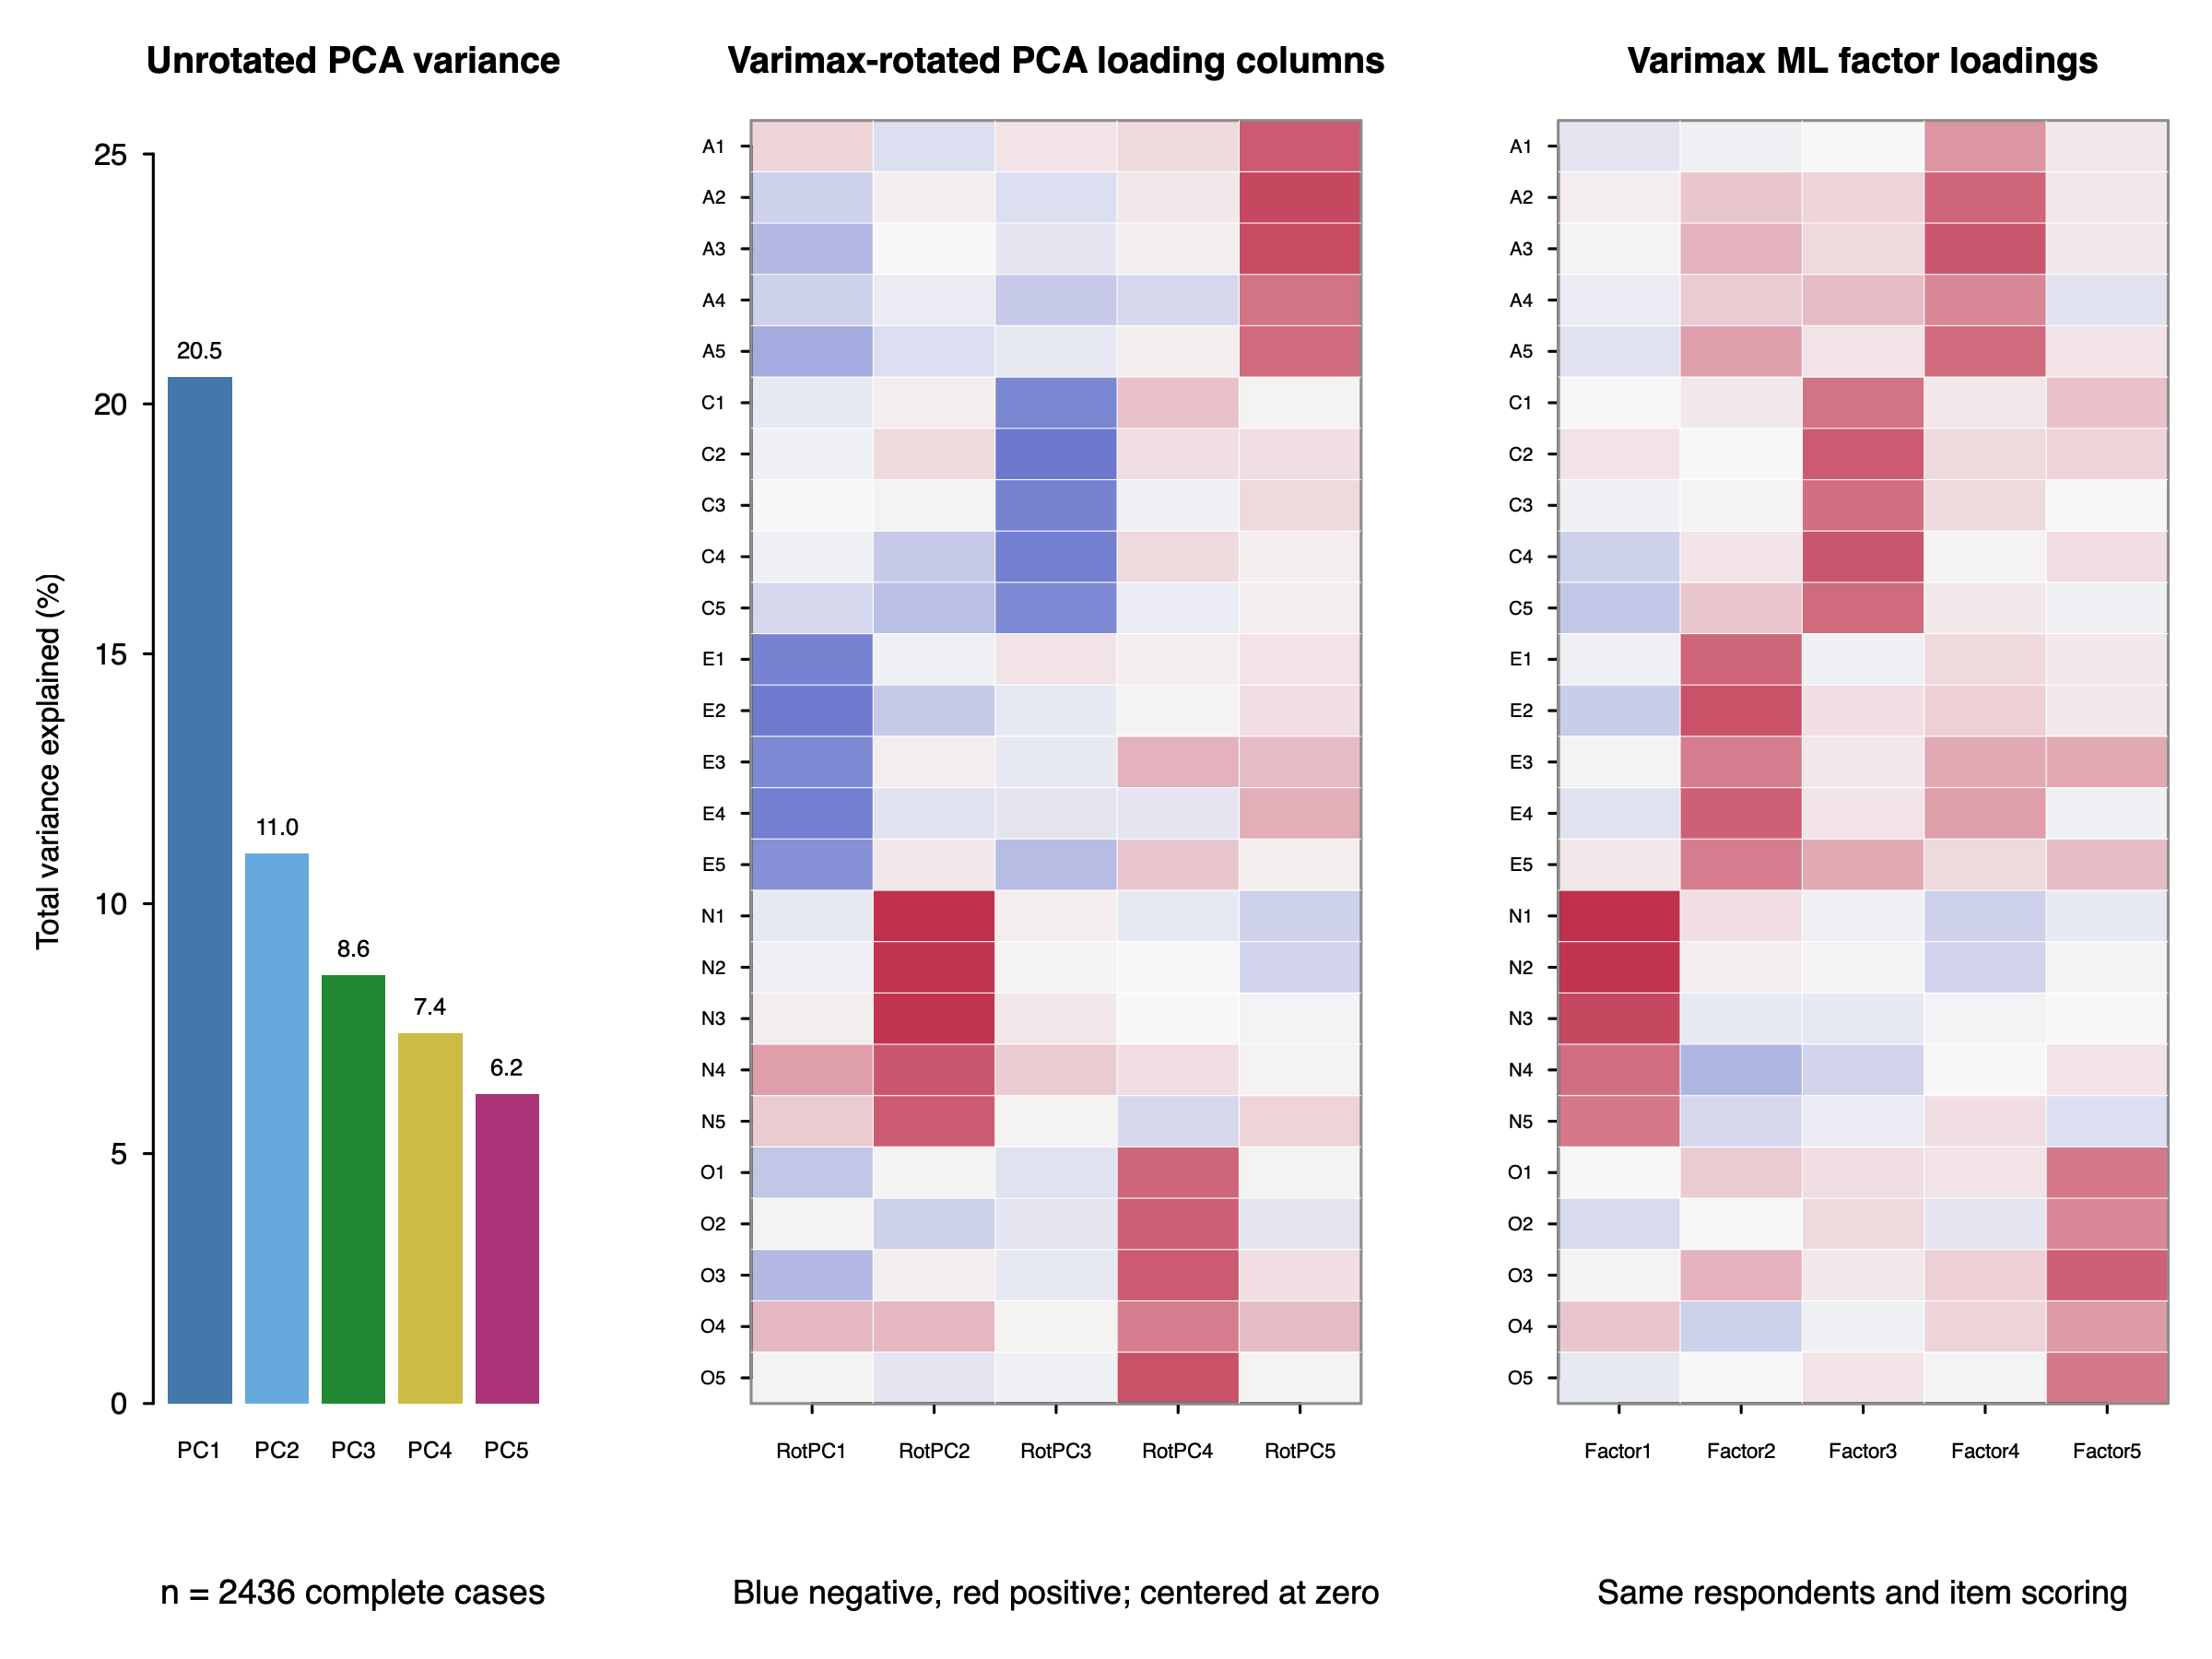
Generated または Files から bfi-method-metrics.csv を開きます。 記録されたファイルは、サンプルカウント、欠落、PCAの分散、FAの独自性、適合、収斂、種子および入力アイデンティティを含む77メトリック行が含まれています。
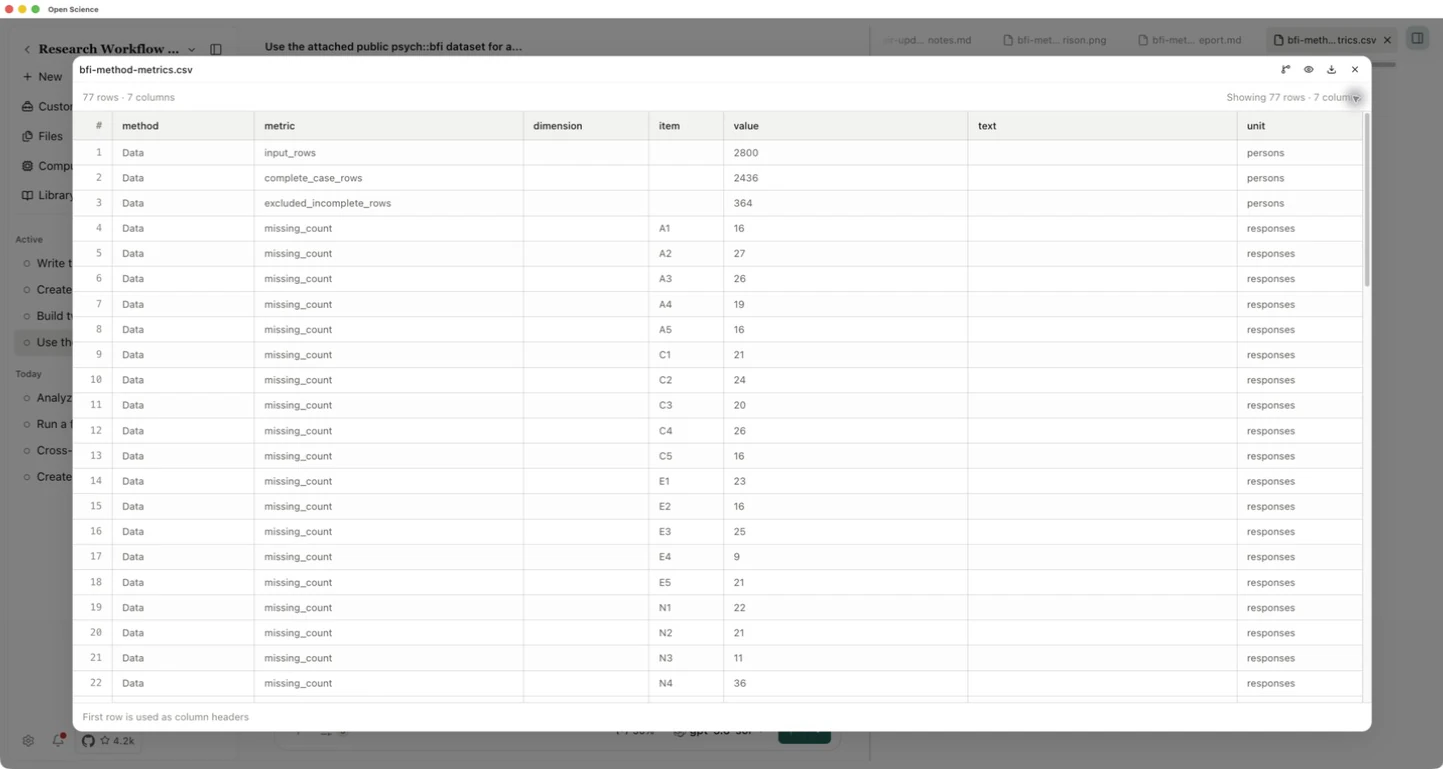
| PCAコンポーネントを非回転させる | 全規格の分散について説明 |
|---|---|
| パソコン1 | 20.54% |
| パソコン2 | 11.01% |
| パソコン3 | 8.57% |
| パソコン4 | 7.41% |
| パソコン5 | 6.19% |
| ファースト5の組み合わせ | 53.72% |
FAオプティマイザはコンバージドだが、p ≈ 1.218 × 10⁻²⁰²では同胞性ラチオ統計は1490.587は自由の185度にであった。 モデルの仮定の下で、これは正確な5要素の適合を拒否します。 数値実行の成功は十分な適合を確立しません。
4. 図内のロードパターンを比較する
bfi-method-comparison.png を開きます。 その3つのパネルは、無回転PCAの分散、varimax-rotated PCAのローディングおよびvarimax FAのローディングを示しています。 250行:25項目×5次元×2方法の正確な積載値がbfi-loadings.csvにあります。
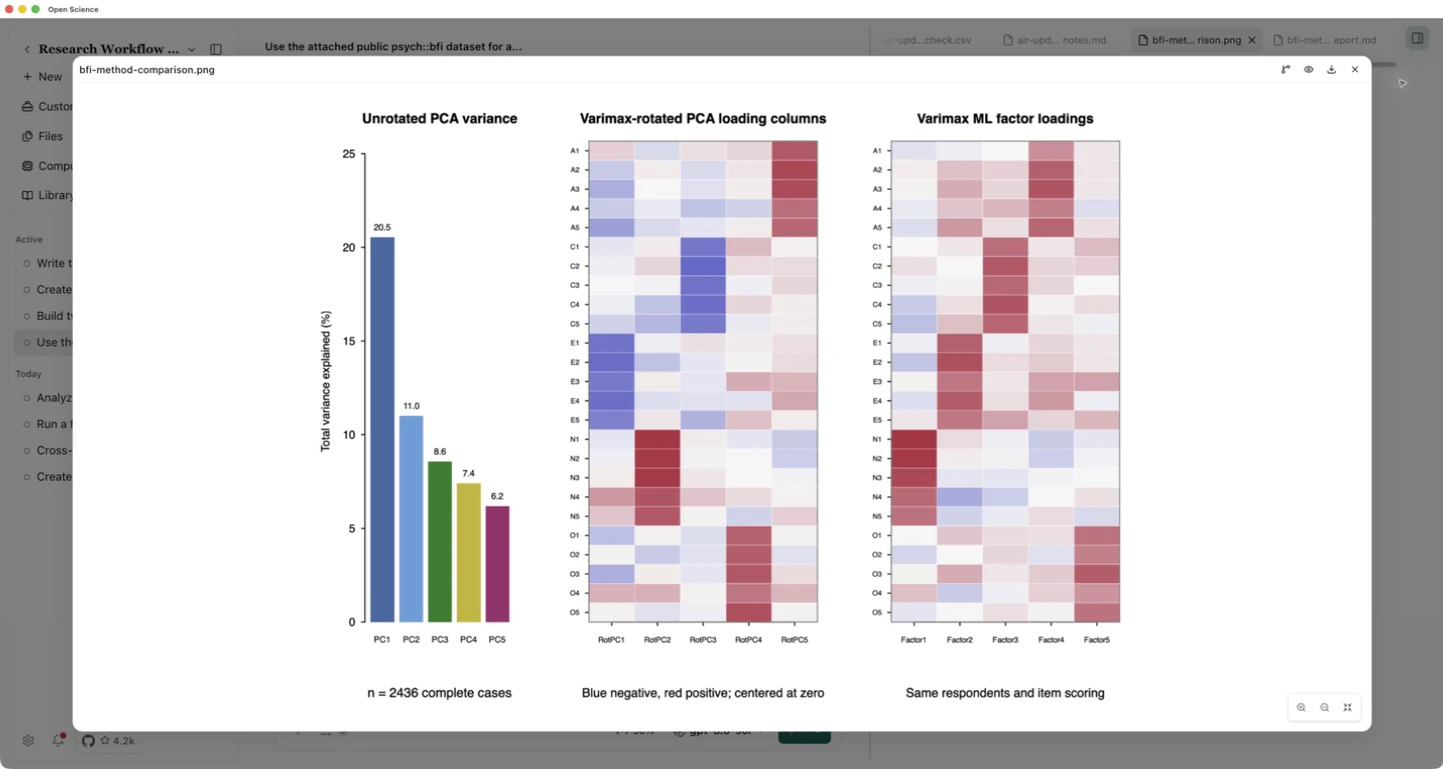
方法を渡る機械的に「コラム1」に一致しません。 工場/成分の注文と兆候は、溶液を変更することなく変更できます。 熱地図は肯定的なローディングのための否定的および赤のための青を使用します; 項目パターンと数値値を比較します。
PCA パーティションの総観察分散; FAモデルでは、独立した独自性で共和性を共有しました。 PCAの分散で、FAの一括読み込みは変更できません。 回転ラベルRotPC1–RotPC5は、意図的に非回転PC1~PC5の分散率から区別されます。
5. 制限を読み、保存されたスクリプトを再実行する
bfi-method-report.md を開きます。 同じサンプルとプリプロセッシング、固定種子とコンバージェンスとフィットの違いを報告することを確認してください。 これらの1-6の経口応答は、約連続して処理されます。 完全ケース削除は、欠損が応答や参加者特性に関連しているときに結果に偏ります。
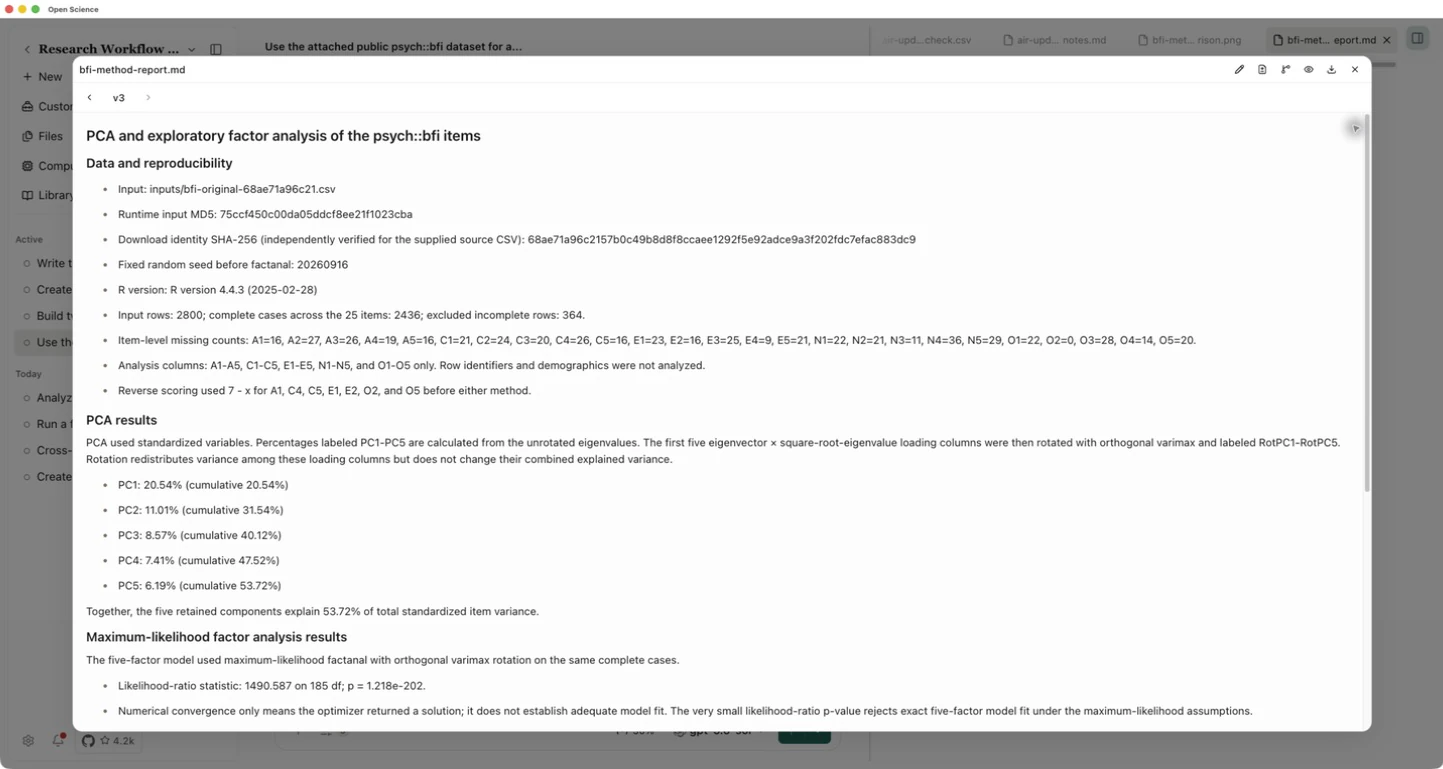
Rスクリプト、ローディング、メトリック、プロフィール、レポートをダウンロードしてください。 スクリプトを置き、新しいフォルダに入力をダウンロードし、そこにターミナルを開き、実行します。
Rscript bfi-method-comparison.R bfi-original.csv
スクリプトは、現在のフォルダーに出力を記述します。 記録されたスクリプトは、R 4.4.3 と独立して再実行されました: プリプロセッシング、ロード、メトリック CSV は、アプリの保存ファイルと正確に一致しました。 PCA eigenvalues のプリプロセッシングセルと PCA の eigenvalues も個別にチェックされていました。 これらのチェックは、この計算の再現性を確立します。 それらは普遍的な優秀な方法を選ぶか、または診断テストを検証しません。