公開データセットで回帰結果をチェックする
実践例 就職実験後の収益
小規模な経済データセットがあり、ベースライン特性が含まれているときに結果が変化するかどうかを知りたいです。 この例では、不調整された比較と事前指定調整された回帰を実行し、見積もりと不確実性を保存します。
配達可能:はNotebookの計算、係数CSVおよび英語のレポートです。 jtrain2の445-observation実験サンプルを使用しており、Londeのwooldridge data dictionaryによる国立サポートされている作業解析に匹敵します。
データの準備と添付
- Rdatasets からの jtrain2.csv をダウンロードし、辞書で変数の定義を読みます。
- プロジェクトを作成し、Pythonランタイムが有効になっていることを確認します。 この例では、
pandasとstatsmodelsを使用します。 必要に応じて、選択した環境に不足しているパッケージをインストールします。 - 会話を開き、作業モデルを選択し、 + → Attach files を選択し、CSVを選択します。 送信前に添付ファイルが表示されることを確認します。
re78 とベースライン変数 re74 と re75 は、千ドル で実際の収益です。 それぞれ1978、1974、1975で獲得している。 ゼロ収益は有効な観測です。 train はトレーニングの割り当てを識別します。 mostrnはトレーニングの月数を記述し、ベースライン調整変数ではありません。
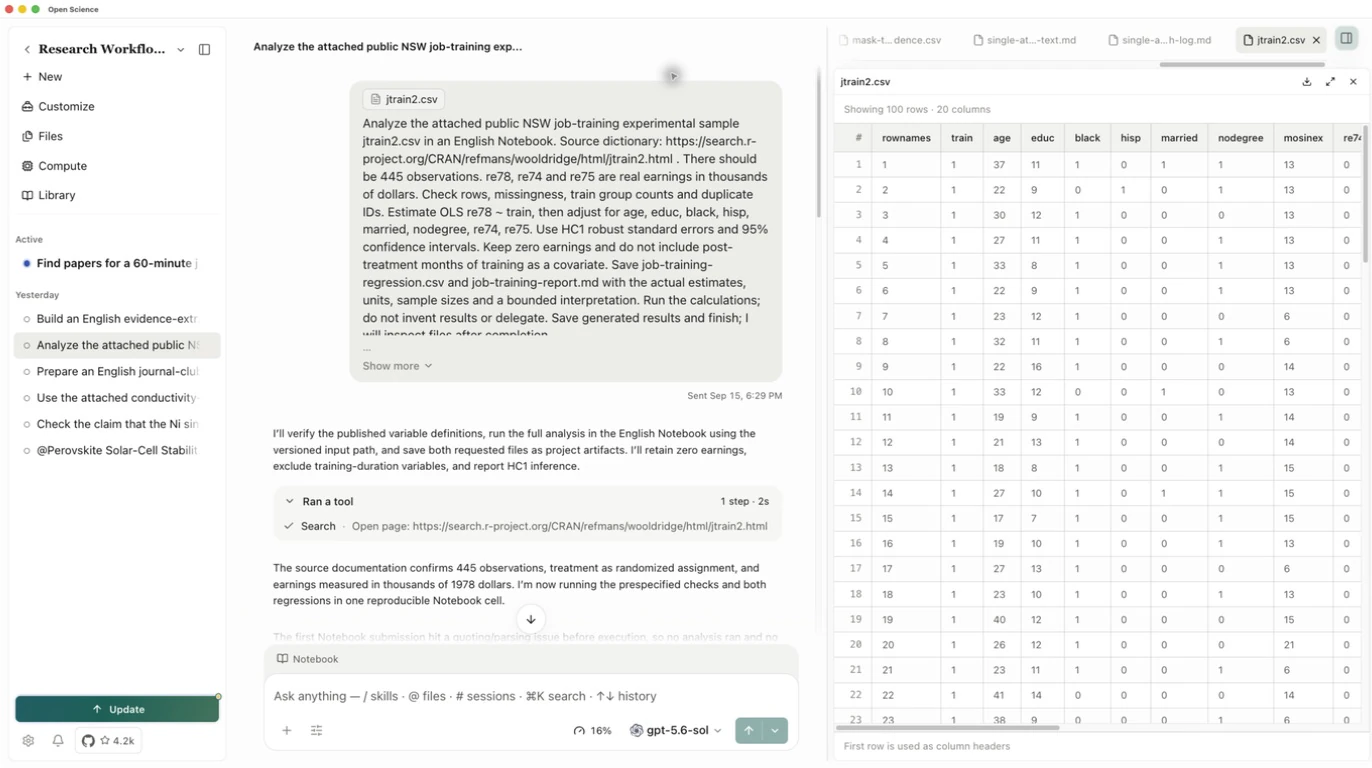
添付したCSVをクリックして、計算リクエストを送信する前にプレビューします。 train、re78、re74、re75、ゼロ収益を含む行をチェックします。 プレビューは 100 行のみを表示できます。 Notebook はファイル全体をカウントしなければなりません。
事前に指定された比較を実行します
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
承認が現れた場合に要求されたコードを見直して下さい。 付属のCSVを読み、指定した2つのモデルにフィットし、出力を保存する必要があります。 Notebook を開き、実際の実行結果を確認します。 実行が失敗した場合は、計算された結果として任意のproseを処理する前に表示されたエラーを解決します。
会話では、Notebookを選択し、実行されたPythonセルを開き、出力を検査します。 回帰の要約の前に行とグループカウントを探します。 添付されたバージョンが解決できない場合は、Agent にこの会話の添付ファイルと再試行からマウントされたファイルを読み込みます。 失敗したセルは結果ではありません。 保存されたファイルで成功したセルとその出力を保持します。
保存した結果の特定
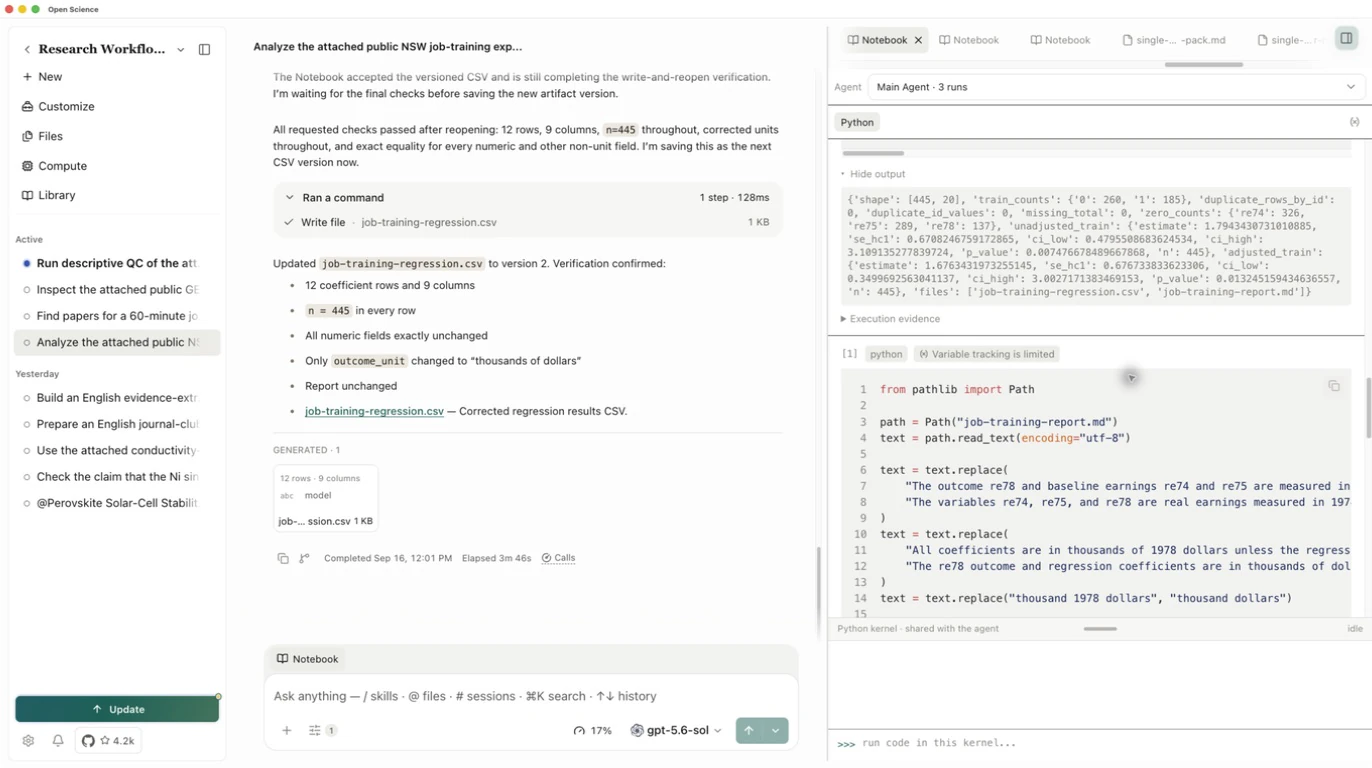
445行、訓練群 185 人、対照群 260 人、欠損値なし、重複行識別子なし。 445 の全ての観察が残された回帰は両方とも。
| モデル | 訓練係数 | HC1標準エラー | 95%の信頼間隔 |
|---|---|---|---|
| 不調整 | 1.794 | 0.671 | 0.480 から 3.109 |
| ベースライン変数の調整 | 1.676 | 0.677 | 0.350 から 3.003 |
係数と間隔は千ドルになります。 これらは、元の紙から引用された見積もりではなく、この例の計算の結果です。
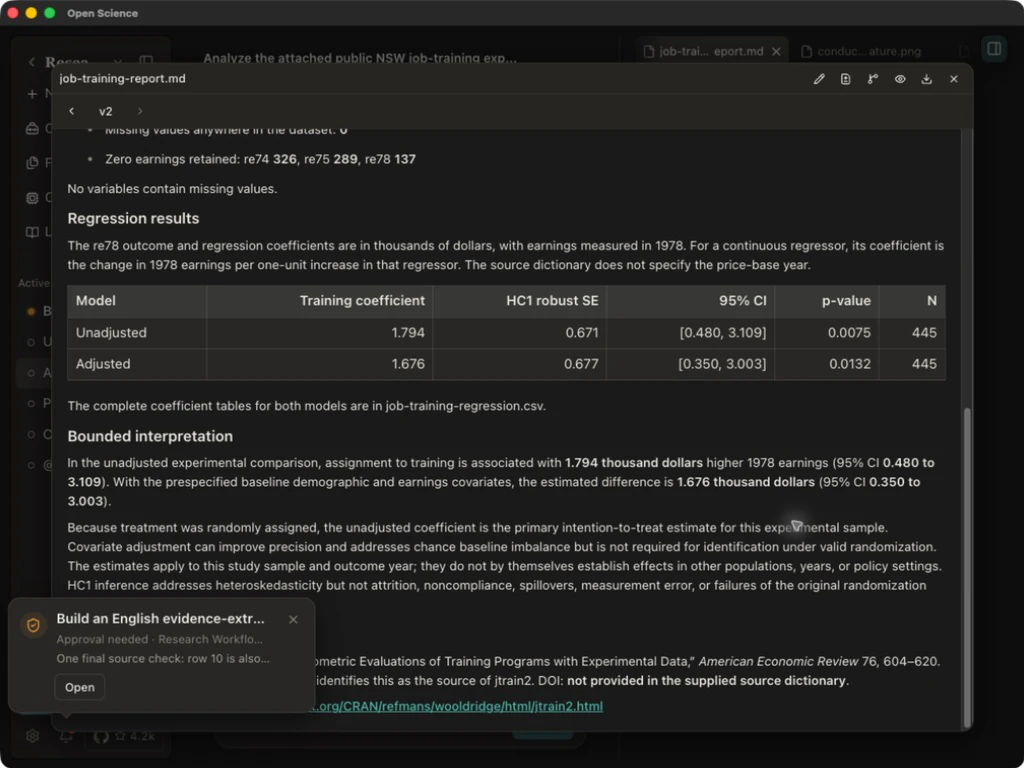
応答が完了した後に生成されたファイルの両方を開きます。 CSVのtrain行をレポートとNotebookで比較します。 係数テーブル と レポート をダウンロードできます。
Generatedでは、CSVを開き、プレビューを拡大します。 保存された係数テーブルは、12行・9列:調整されていないモデルと調整されたモデルの10行の2列を持っています。 各モデルのtrain行を探し、その推定値、堅牢な標準エラー、間隔、nとユニットを比較します。 ソース辞書が状態ではないインフレーションベース年を追加しないでください。 プレビューのDownloadボタンを使用して、チェックされたバージョンを維持します。
比較が何をサポートするかを決める
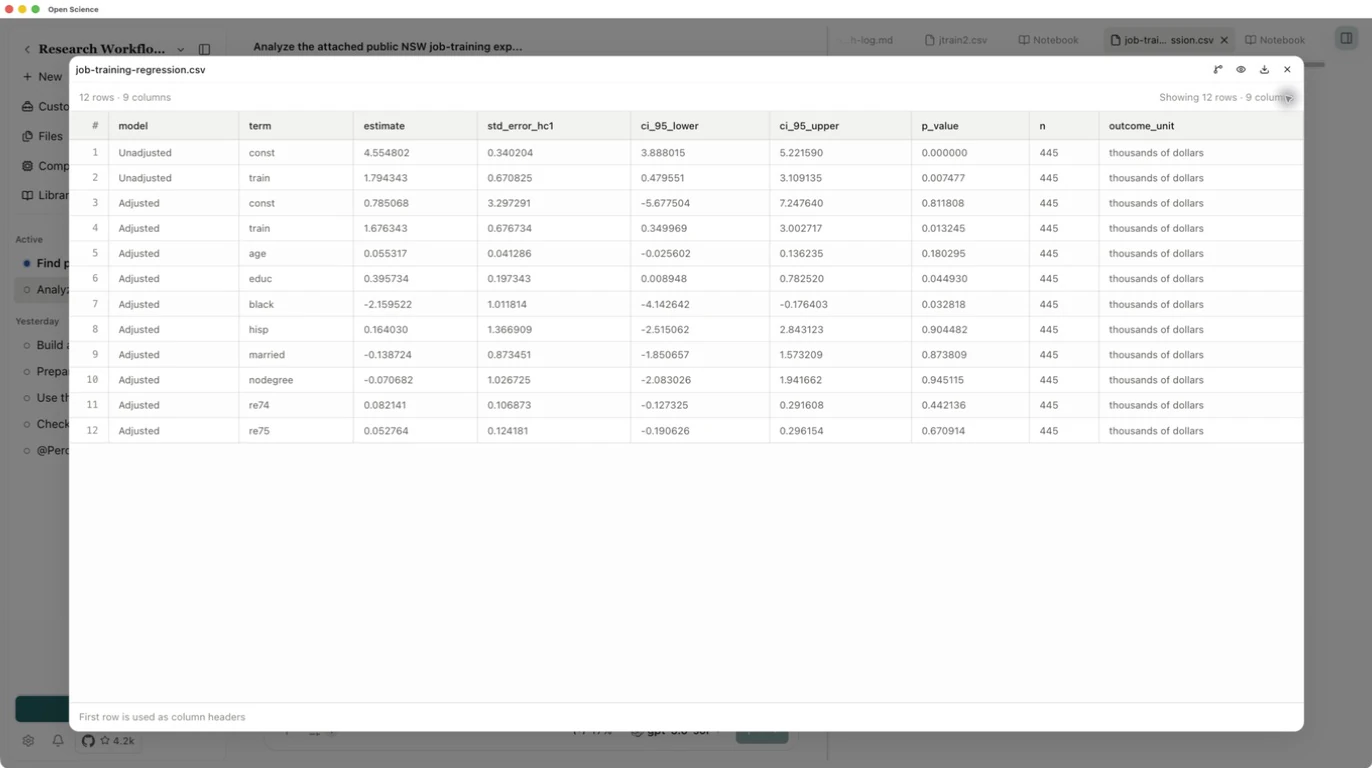
ベースライン変数で調整すると、推定値は約 1.79 千ドルから 1.68 千ドルに変わります。これは二つのモデル仕様に対する感度の確認です。あらゆるモデル選択に対する頑健性や、他の集団・年代への一般化を示すものではありません。HC1 標準誤差は不均一分散を考慮しますが、研究デザイン自体の問題を解消しません。
分析を同僚に渡すには、元のCSV、変数辞書、コードおよび選択した環境を保持します。 再現性チェック を使用して、後で再実行できるものを評価します。