遺伝子計算行列のサンプル品質をチェックする
実践例 GSE60450のサンプル品質をチェックする
差分圧縮解析を実行する前に、カウント行列が構造的に使用可能であることを確認し、サンプルラベルはトレーサビリティを維持します。 このウォークスルーは、実際のパブリックGEO GSE60450の特長マウスの哺乳動物RNA-seqマトリックスを使用します。 Open-Scienceで12サンプルQCテーブル、生ライブラリサイズのプロット、メソッドレポートを生成します。
研究の決定:は、アノテーションと別々に設計された統計解析を試行するのに十分な内部的に一貫したファイルですか? アドレスファイルの完全性および記述的な計算の下のチェック。 それらは生物学的比較性、正規化、バッチ補正、差分表現を確立しません。
下の寸法と数値の結果は、この例の入力に属します。 独自の行列で、サンプル列を定義し、チェックを再入力します。
ソースと入力契約
データと期待される結果の例から元の行列をダウンロードします。 アップロード前にチェックサム、サンプル列、メタデータフィールドをチェックします。 このワークフロー全体でベースラインの値にそのページを使用します。
1. 実行前に作業を定義する
プロジェクトを作成し、サンプルページから元の行列を添付します。 csv、statistics、hashlib(標準ライブラリ)でPythonを有効にし、ランタイムでmatplotlibをインストールします。 Notebookコードを実行できるコネクティッドモデルを使用します。
これを送るか、または列の定義を保存している間出力名を合わせて下さい:
Inspect the attached public GEO GSE60450 gene-count matrix in the Session
Notebook using Python csv/statistics/hashlib and matplotlib. Do not install
packages during the analysis. Preserve the input. Exclude EntrezGeneID and
Length from the 12 sample-count columns. Validate unique IDs, row widths,
nonnegative integer counts and missing entries. Save rnaseq-sample-qc.csv
with exactly six columns: compact_sample, original_column_name, total_raw_counts,
zero_count_genes, detected_genes_count_gt_0, median_count_among_detected_genes. Retain the complete original sample
identifier in original_column_name; compact_sample is only a compact display label.
For each sample compute the raw-count sum, count of zeros, count > 0,
and median of positive counts. Save rnaseq-library-sizes.png with all sample
labels and a raw-count axis, plus rnaseq-qc-report.md describing the source,
input SHA-256 before and after, method, label mapping and limitations.
Save all three outputs in English; I will reopen them to check the results.
Do not perform differential-expression testing or delegate.
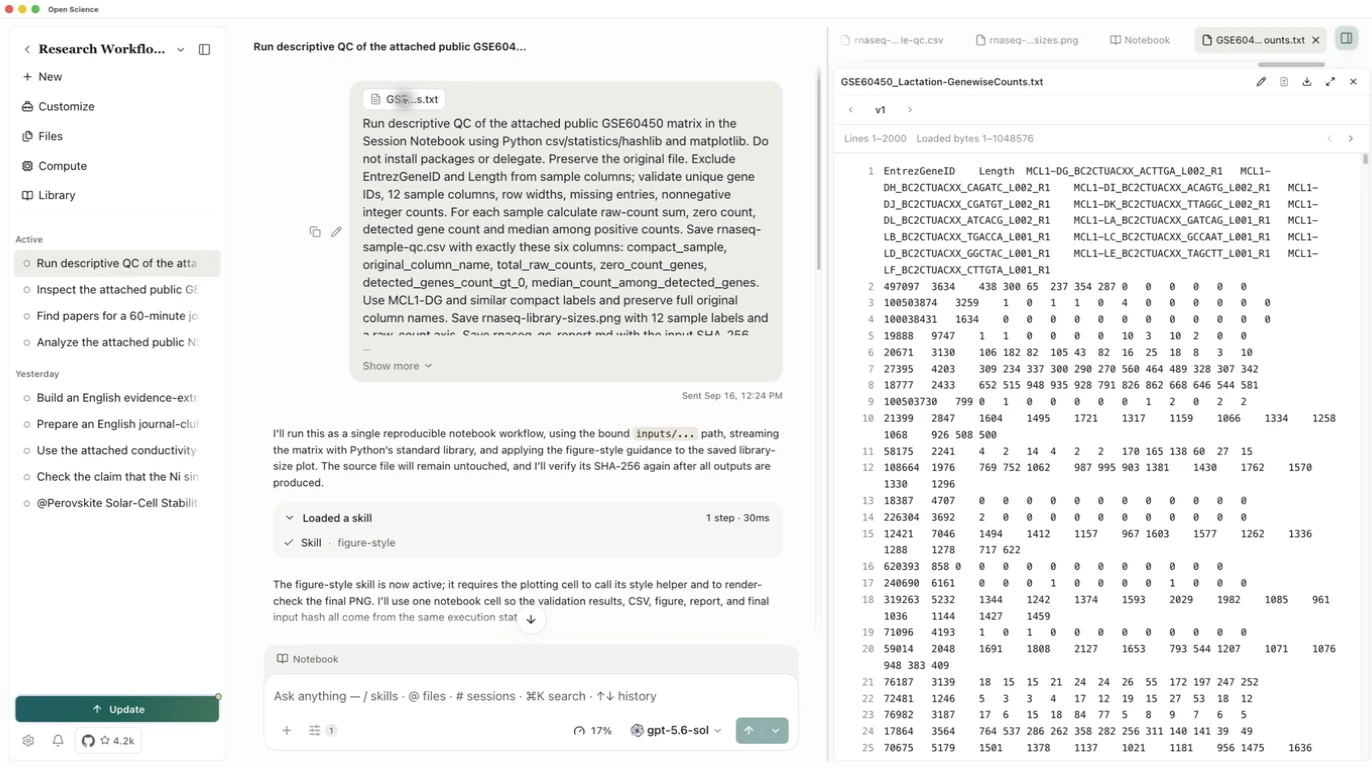
送信する前に、添付ファイルをクリックしてヘッダ:2つのメタデータ列が12個のサンプル列に続いていることを確認します。 テキストプレビューは、大きなファイルの一部だけをロードします。 Notebook は行列全体を読む必要があります。 この実行は直接計算を送信します。 プランを最初に同意したい場合は、別々のプランニングフローを使用します。
2. サンプル計算からメタデータを保存する
計算は Entrez ID を保持し、一貫した行幅を検証し、非負の整数としてカウントをチェックします。 Lengthは遺伝子メタデータであり、13番目のサンプルではありません。 ゼロカウントは、値が欠落しない、測定されたエントリです。 ブランクをゼロに置き換えたり、ゼロカウント遺伝子をサイレントに除去したりしないでください。
各サンプルでは、総生数、ゼロカウント遺伝子数、カウント数がゼロ以上の数値、および中央値は検出された遺伝子の中でのみをカウントします。 デノミネーターの記録。 正確な入力欄を使用してください。 MCL1-DGなどのコンパクトなラベルは、新しく推論した生物学グループではなく、明示的なマッピングでラベルを表示します。
3. 実行を点検し、失敗を処理します
入力ファイルと出力名を含むPythonリクエストの許可を読んで、スコープされた操作を許可します。 Notebookを会話で開き、完成したセルとその出力を検査します。 寸法、元のラベル、メトリック配列、および前後のハッシュを確認します。 モデルの完了メッセージだけでは不十分です。
入力バージョン ID が解決できない場合は、Agent にこの会話の入力と再試行をお読みください。 続行する前にファイル名とチェックサムを確認します。
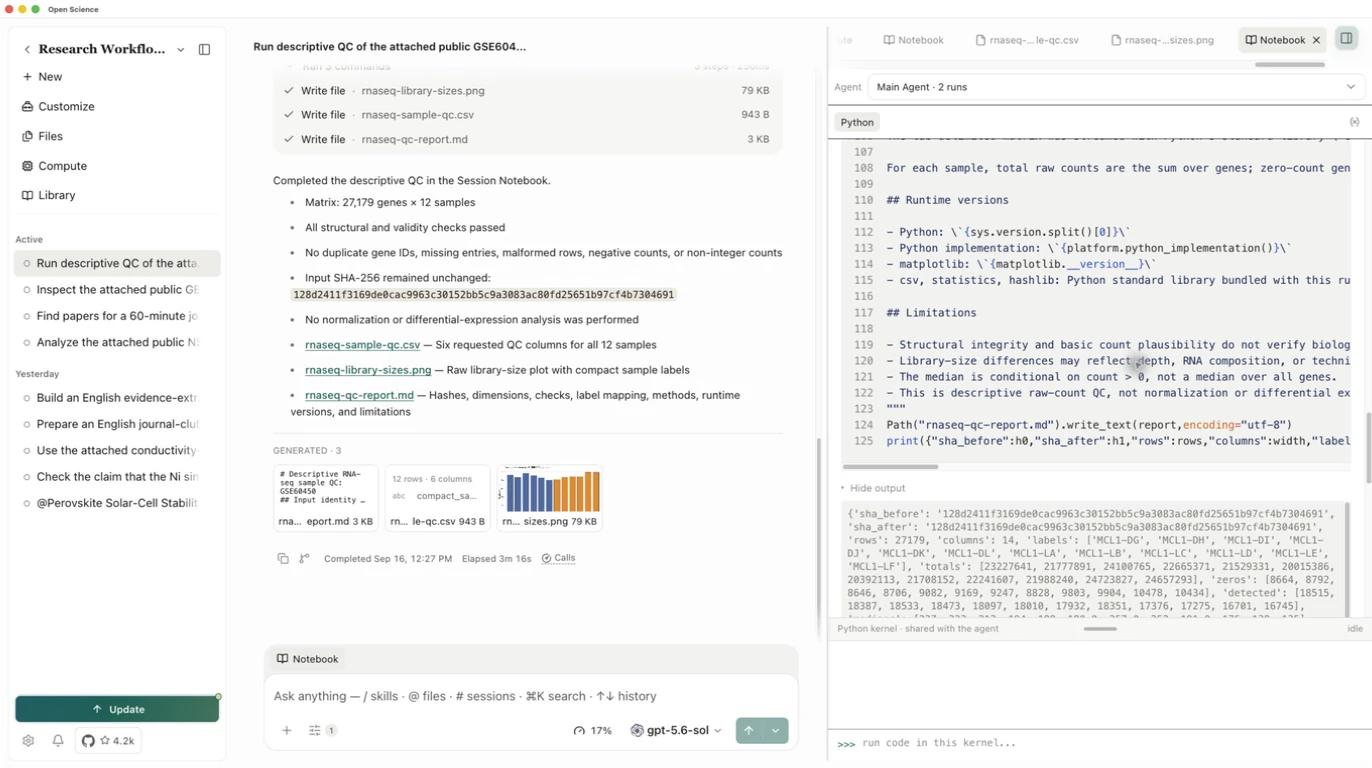
例には、誤字行、重複ID、欠落したエントリ、または無効なカウントがない 27,179遺伝子列と12サンプル列 が含まれています。 Generated の3つの出力ファイルをすべて開き、保存した結果を確認します。
4. サンプルテーブルを受け入れて下さい
rnaseq-sample-qc.csv を開き、12行・6列 を確認してください。 オリジナルのカラム名をそれぞれ保持します。 以下の表は、4つのメトリックをすべてリストします。 ダウンロード可能なCSVはマッピングカラムを含みます。
サンプルメトリックをベースラインテーブルですべて比較し、完全なサンプル識別子によって一致する行。
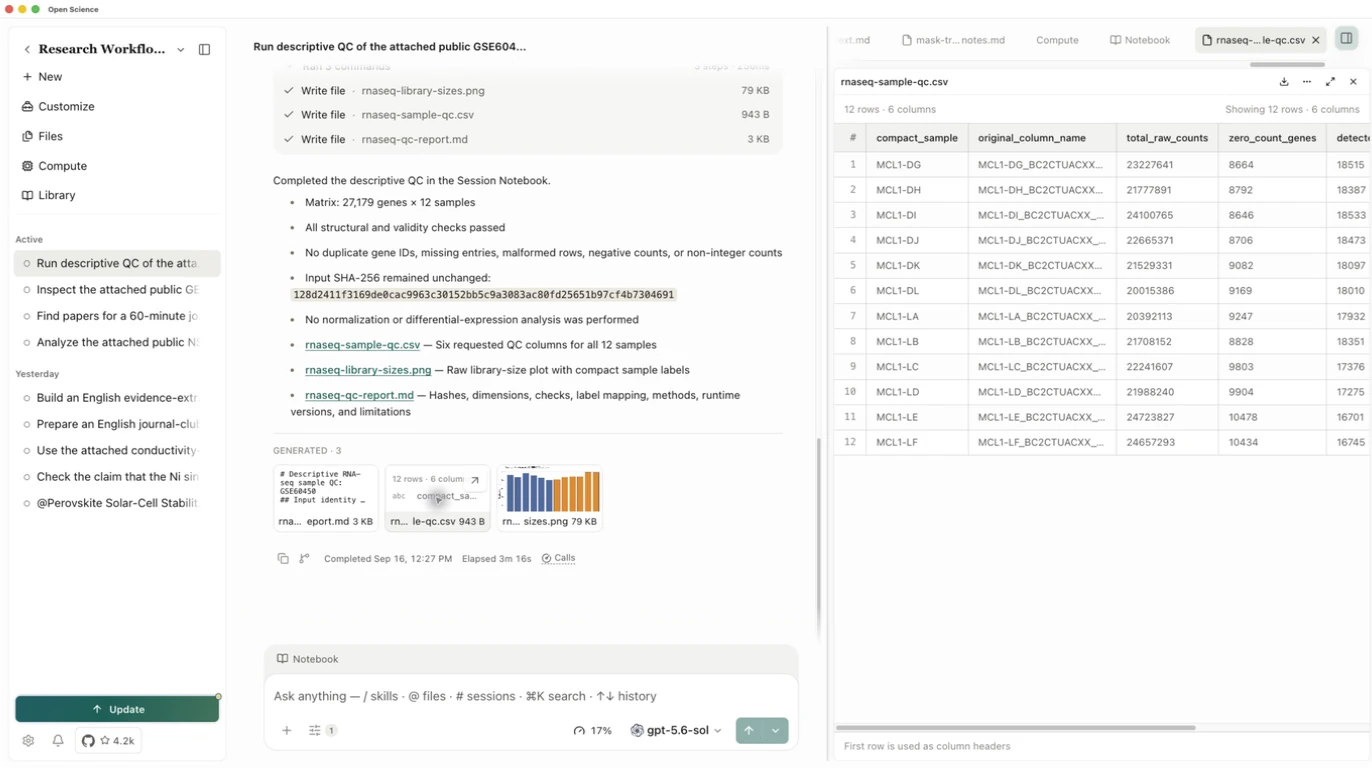
この入力では、各行のゼロカウントと検出された遺伝子は、27,179と等しいはずです。 独立したベースラインで48サンプルメトリックを比較します。 本契約は、供給された入力のこれらの計算を確認します。 ダウンストリームの仮定は、独自の評価を必要としています。
5. それを解釈しないでプロットを読んで下さい
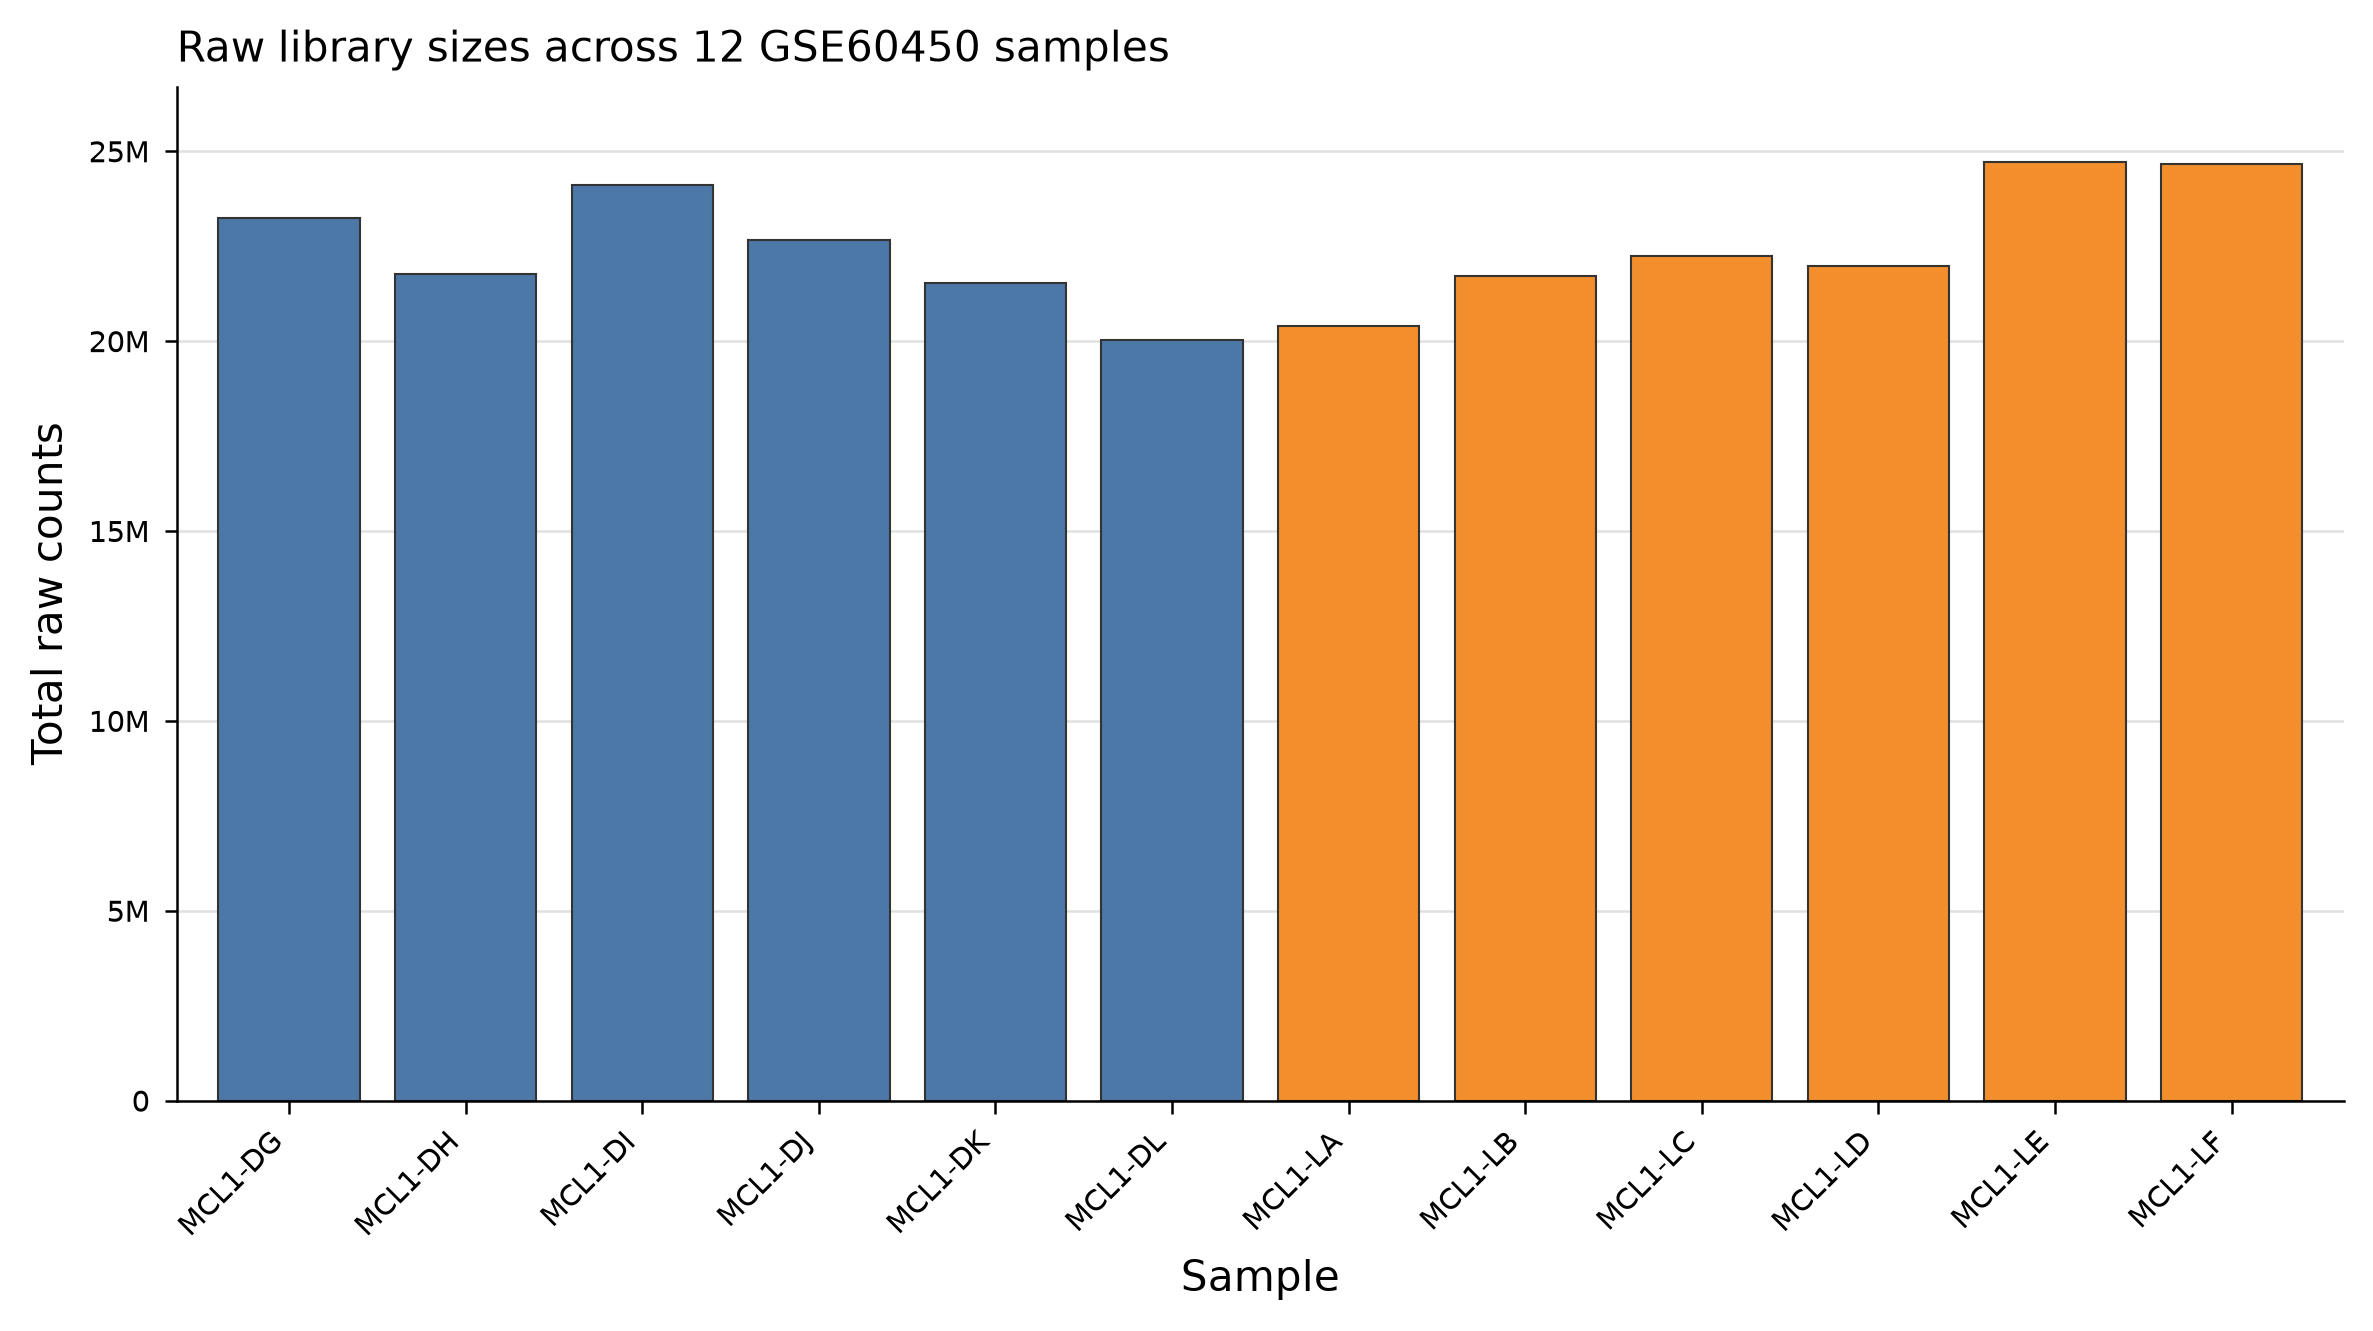
rnaseq-library-sizes.pngを開き、拡大します。 値が正規化されていないすべての12個のサンプルラベル、生カウント軸、およびノートを確認してください。 この行列の 20,015,386 から 24,723,827 までの総カウント範囲。
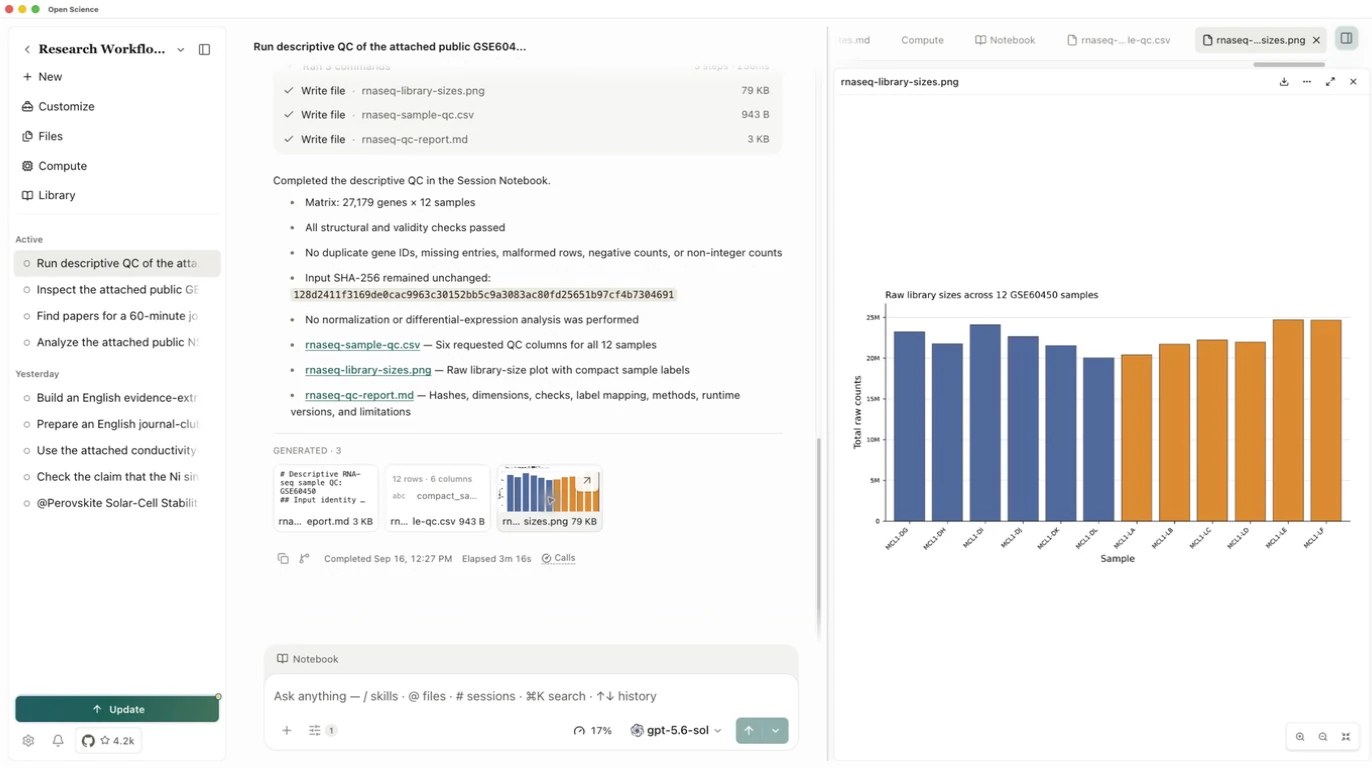
より大きなライブラリの合計は、遺伝子が異なって表現されるという意味ではありません。 下流分析の前に、サンプル特性とGSM識別子をGEOメタデータを使用して行列に合わせ、設計、コントラスト、正規化、フィルタリングルールを指定します。 メタデータを取得するには、コネクタ を参照してください。
6. 方法と証拠の保持
入力チェックサム、寸法、妥当性チェック、正確なラベルマッピング、ランタイム/ライブラリバージョン、解釈制限を含むレポートを保管してください。 値を比較した後にのみ独立したチェックセクションを追加します。 レポートのリビジョンを保存しても、テーブルや図を返さない。
ベースラインですべての48サンプルメトリックを比較し、入力SHA-256が128d2411f3169de0cac9963c30152bb5c9a3083ac80fd25651b97cf4b7304691のままであることを確認します。 例のレポートは、Python 3.12.14 と matplotlib 3.11.1 を記録します。 自分の実行で使用されるバージョンを記録します。
QCのテーブル、プロット、レポート などをダウンロードできます。 オリジナルの入力とセッション Notebook を出力とともに保持します。 再現性チェック を使用して、環境を準備し、計算を再実行します。