동일한 데이터에 대한 두 분석 방법 비교
실습 예제 PCA와 심리의 탐험 인자 분석::bfi 항목
변경 방법은 입력 및 사전 처리가 comparable일 때만 통보됩니다. 이 예제는 표준화 된 주요 구성 요소 분석 (PCA) 및 5 요소 최대 같은 요소 분석 (FA)를 동일한 2,436 완전한 응답에 적용합니다. 그것은 방법 견적을 비교, 오히려 가장 큰 숫자를 치료하는 것보다 우승 방법.
1. 공공 입력 및 R 실행 시간 준비
심령::bfi CSV을 다운로드하고 bfi-original.csv로 저장하고 Dataset 문서를 읽습니다. 그것은 2,800 응답자, 25 성격 품목 및 인구학적인 란을 포함합니다. 분석은 A1–A5, C1–C5, E1–E5, N1–N5 및 O1–O5만 사용합니다. 그것은 개인적인 심리적 평가가 아닙니다.
Settings → Runtimes에서 R은 Ready이며 활성화됩니다. 기록 된 실행은 기본 / 권장 R 기능 및 추가 패키지 설치와 함께 R 4.4.3을 사용했습니다. + → Attach files을 통해 프로젝트 대화에 CSV을 첨부합니다.
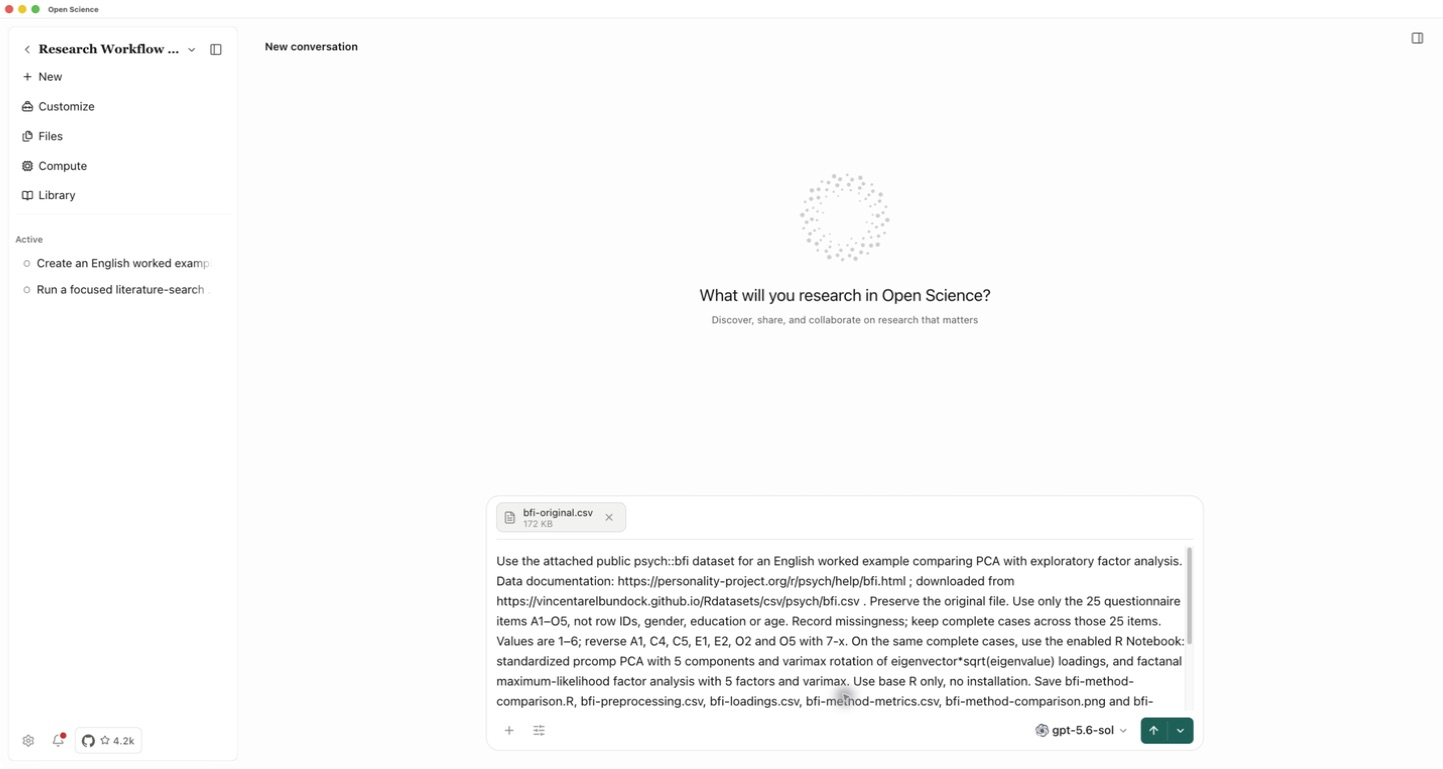
2. 모든 방법을 피팅하기 전에 사전 처리 수정
Use the attached psych::bfi CSV in the enabled R Notebook.
Analyze only its 25 A/C/E/N/O items, scored 1–6. Validate the range.
Reverse A1, C4, C5, E1, E2, O2 and O5 as 7-x. Use the same complete
cases across all 25 items for both methods; report exclusions.
Run prcomp with centering/scaling and retain five components.
Varimax-rotate eigenvector times sqrt(eigenvalue) loading columns;
label them RotPC1–RotPC5. Report variance from unrotated PC1–PC5.
Run factanal with five factors, varimax and nstart=10; set seed 20260916.
Save bfi-method-comparison.R, bfi-preprocessing.csv, bfi-loadings.csv,
bfi-method-metrics.csv, bfi-method-comparison.png and bfi-method-report.md.
Make the script accept the input CSV as its first argument, record
runtime input identity and R version, execute it and reopen all outputs.
Explain fit, convergence, arbitrary signs/order, ordinal responses
and complete-case limitations. Do not claim that convergence is good fit.
Use English and do not install packages or delegate.
그것을 찬성하기 전에 R 계산을 검토하십시오. Notebook을 열고 실행 완료를 확인합니다. 저장된 preprocessing matrix에는 2,436 행 × 25 항목, 364 불완전한 응답자를 제외하고 있습니다. 이 동일한 모체는 두 가지 방법을 공급합니다; 인구 통계 및 행 식별자는 제외됩니다.
한 가지 방법이 침묵적으로 응답자의 다른 세트를 사용한다면, 중지 및 그 결과 비교하기 전에 입력을 재구성합니다.
3. 수치 결과를 검사
Generated 또는 Files에서 bfi-method-metrics.csv을 엽니 다. 기록된 파일에는 표본 조사, 누락, PCA variance, FA uniquenesses, 적합, 융합,씨 및 입력 ID를 포함하여 77 미터 행, 포함합니다.
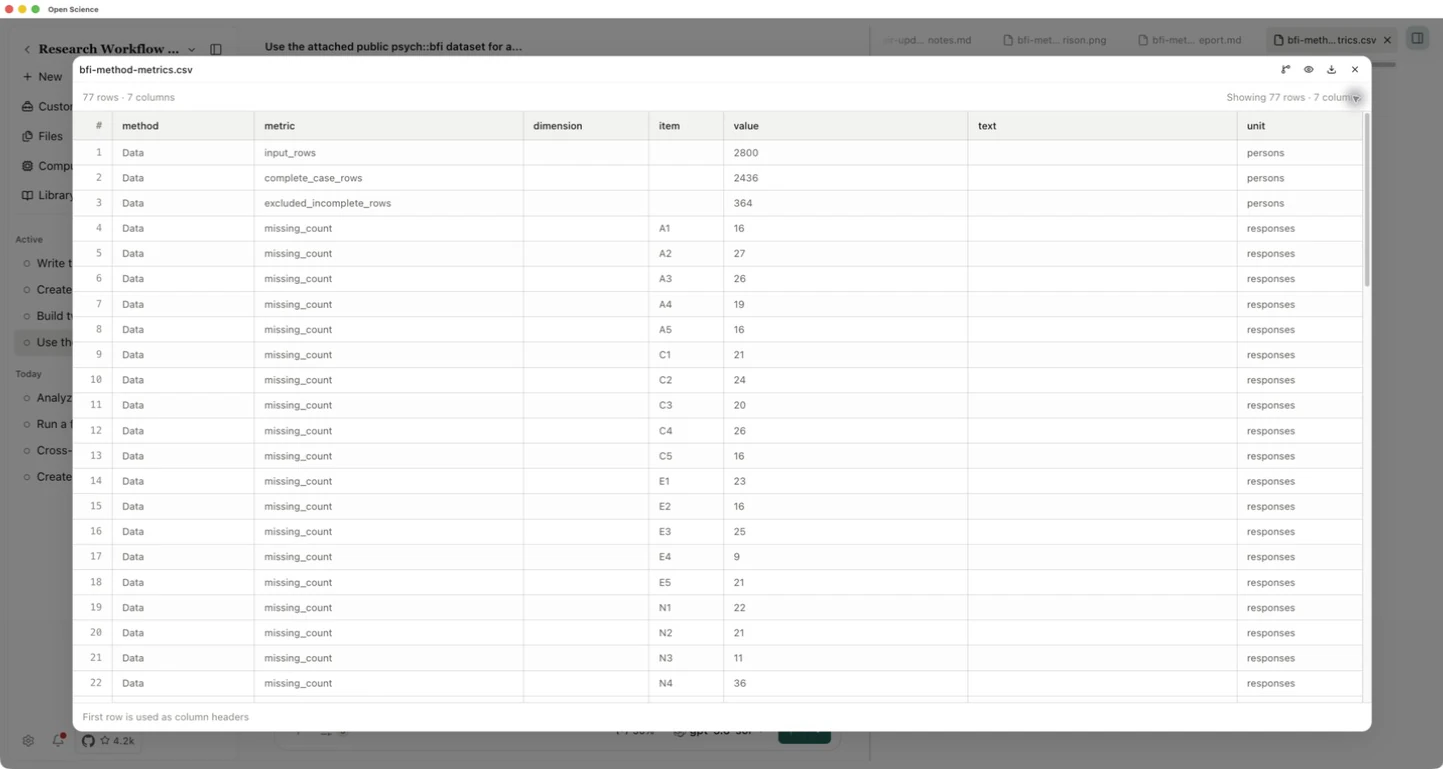
| Unrotated PCA 성분 | 총 표준화 된 variance 설명 |
|---|---|
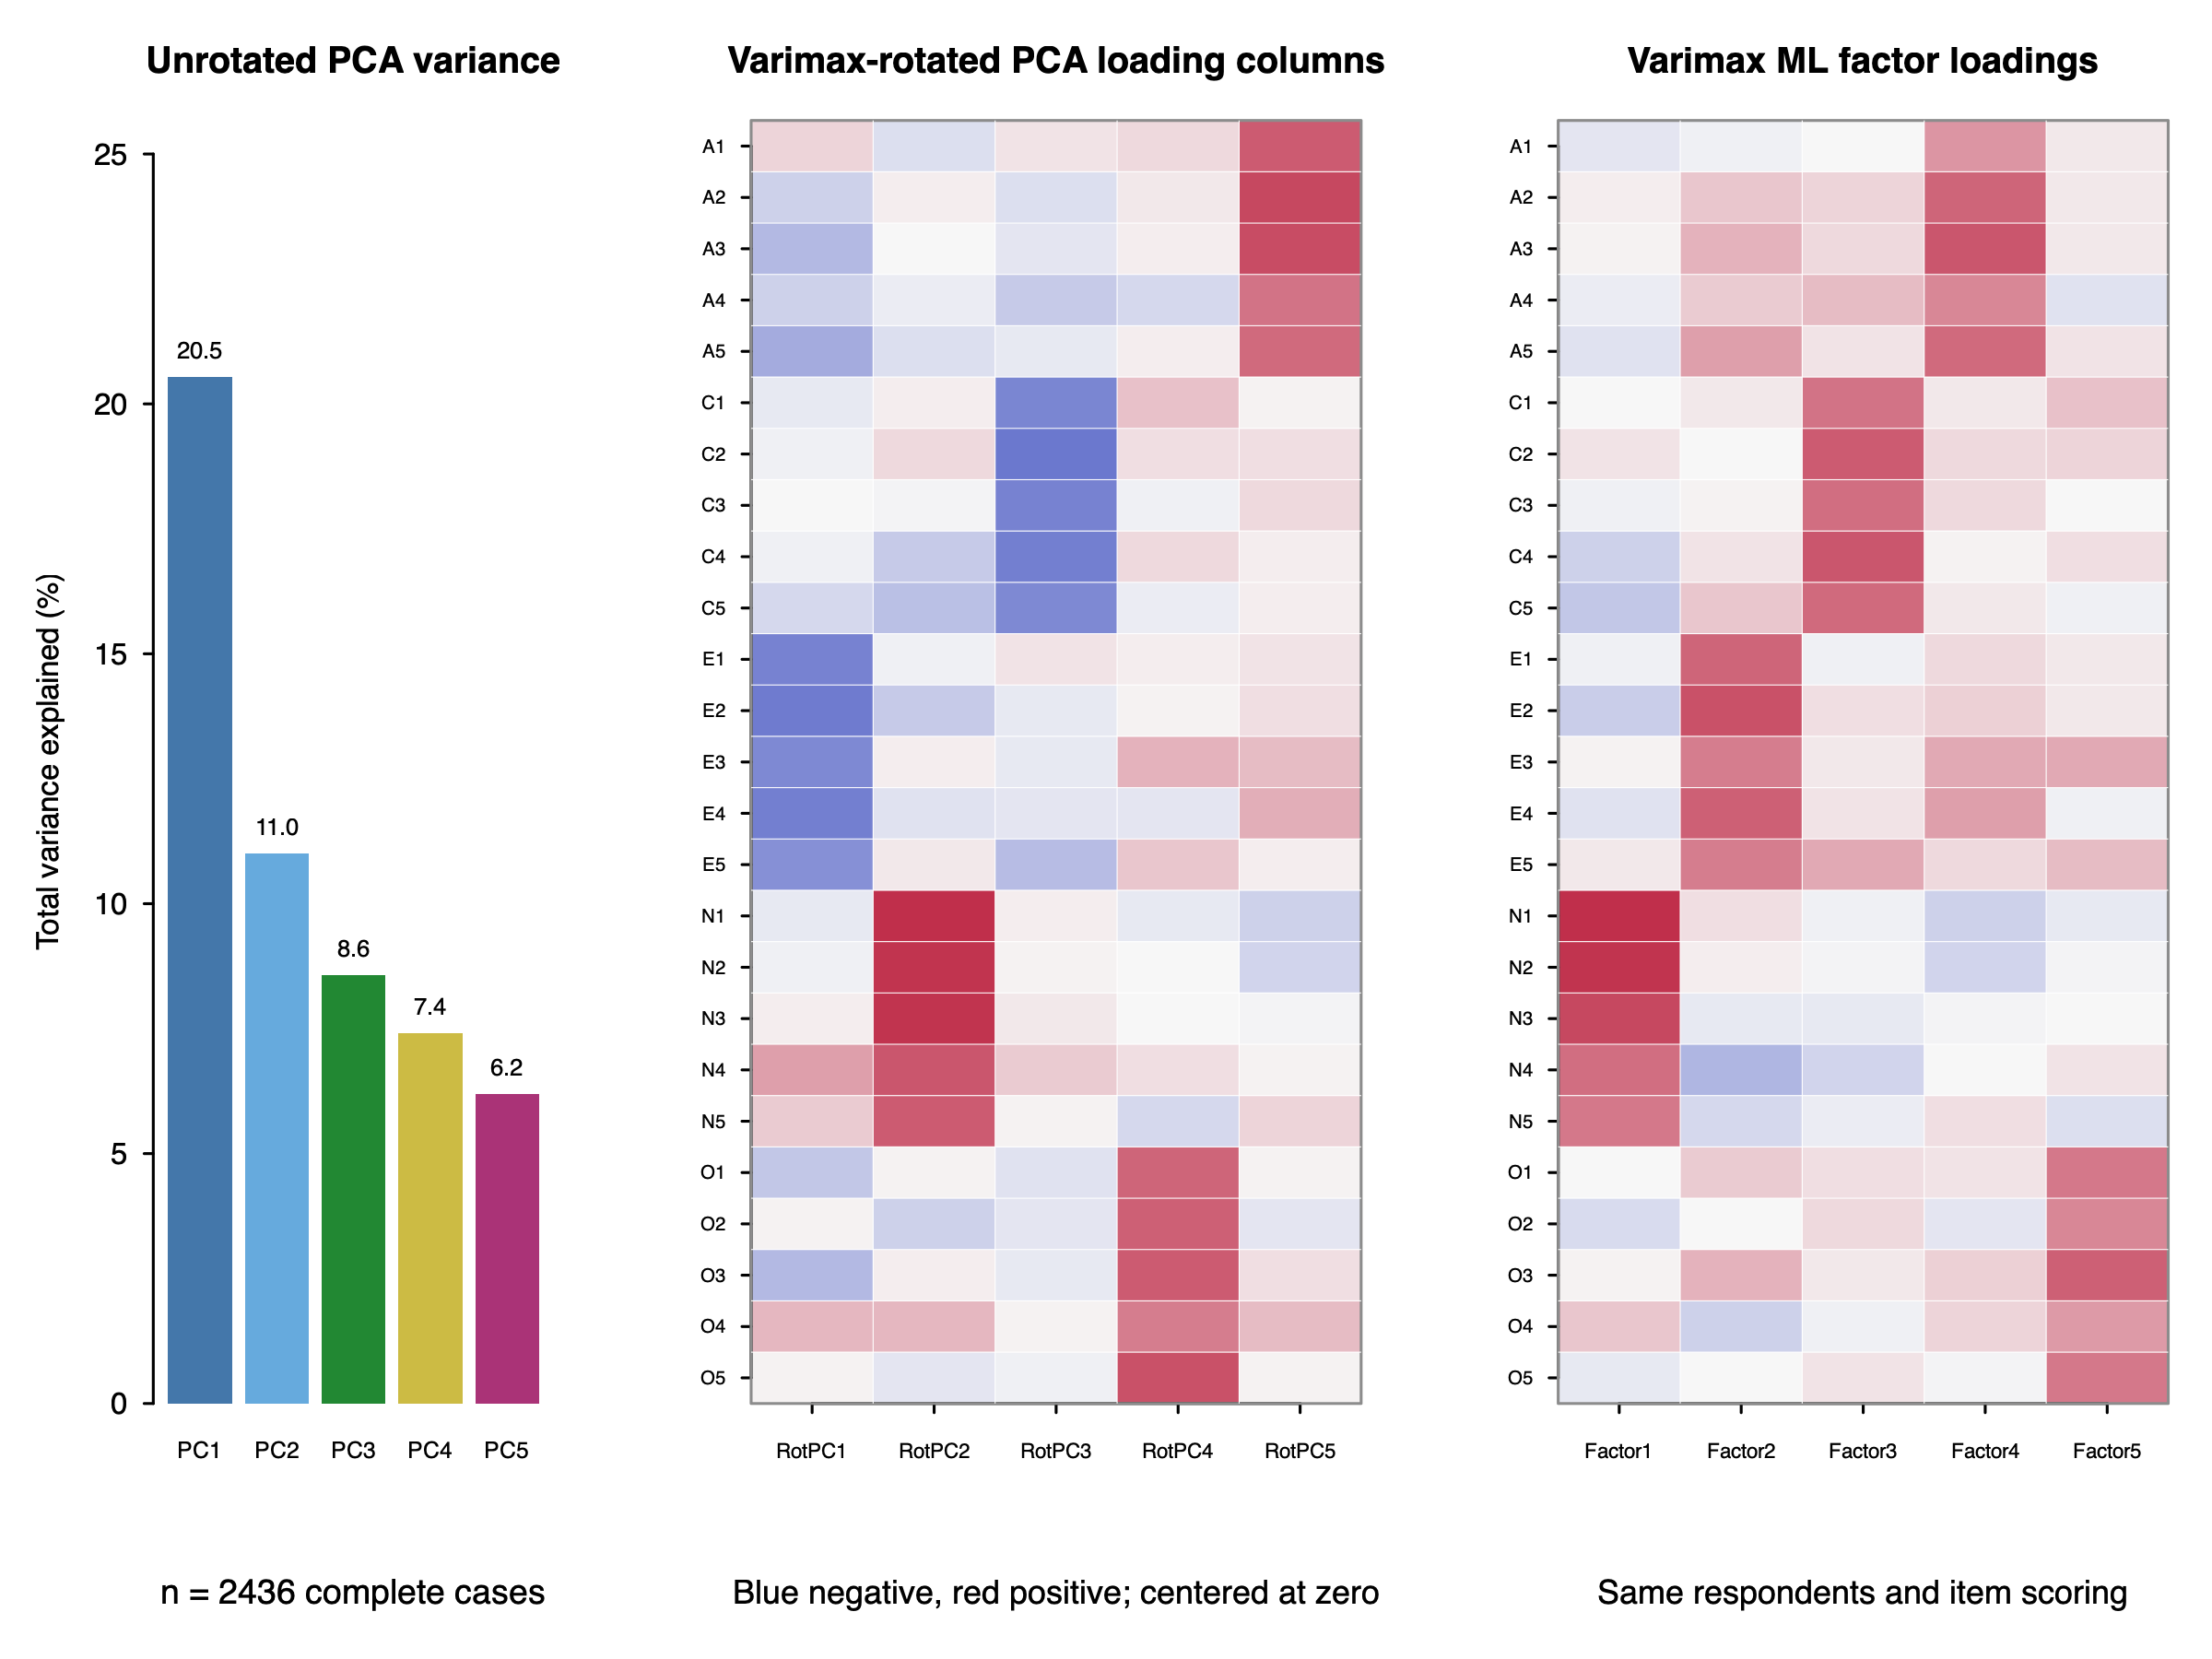
| PC1 다운로드 | 20.54% |
| PC2의 | 11.01% |
| PC3를 | 8.57% |
| PC4의 | 7.41% |
| PC5를 | 6.19% |
| 첫 번째 5 결합 | 53.72% |
FA 낙관은 융합되었지만, likelihood-ratio 통계는 1490.587 무료 185 도, 와 p ≈ 1.218 × 10⁻²⁰²... 모델의 가정에서, 이 정확한 5 요인 적합을 거부합니다. 성공적인 수치 실행은 적절한 적합을 설정하지 않습니다.
4. 그림에서 로딩 패턴 비교
bfi-method-comparison.png을 엽니다. 그것의 3개의 패널 쇼 unrotated PCA variance, varimax 자전 PCA 선적 및 varimax FA 선적. 정확한 로딩 값은 bfi-loadings.csv, 250 행 : 25 항목 × 5 치수 × 2 방법.
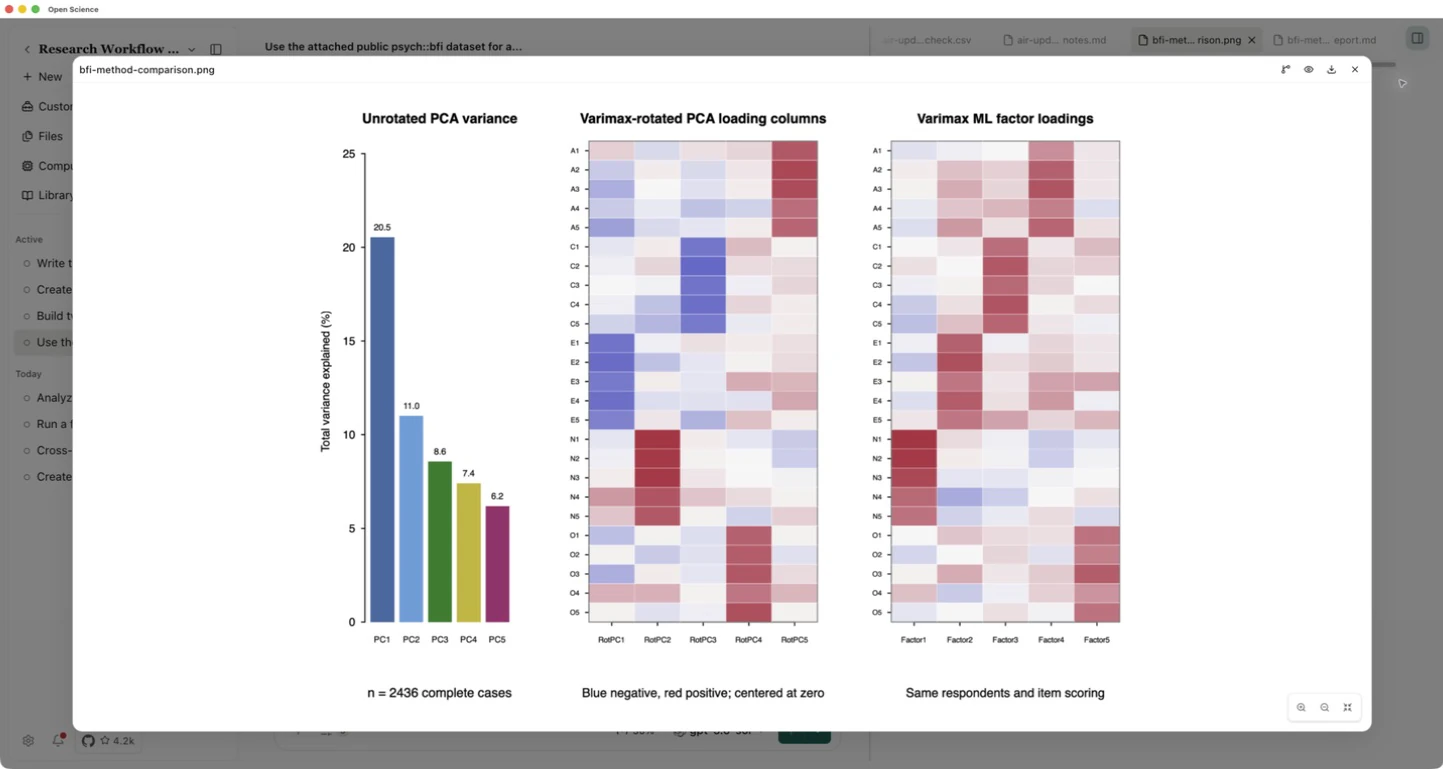
방법은 "column 1"과 기계적으로 일치하지 마십시오. Factor/component 순서와 표시는 해결책을 바꾸지 않고 변화할 수 있습니다. heatmaps는 부정적인을 위해 파랑과 긍정적인 적재를 위해 빨강을 이용합니다; 아이템 패턴과 숫자 값을 비교합니다.
PCA 파티션 총 관찰 variance; FA 모델은 별도의 고유성을 가진 공동 변수를 공유합니다. FA는 사각형로드의 합계는 PCA 가변성이 설명되지 않습니다. 회전된 상표 회전PC1–RotPC5는 의도적으로 unrotated PC1-PC5를 variance 비율에서 구별됩니다.
5. 제한을 읽고 저장된 스크립트를 다시 실행
bfi-method-report.md을 엽니다. 동일한 샘플과 사전 처리, 고정된 씨앗과 융합과 적합의 차이를 보고합니다. 이 1–6 과실 응답은 대략 연속으로 대우됩니다; 완전한 케이스 deletion는 응답 또는 participant 특성에 누락될 때 결과 할 수 있습니다.
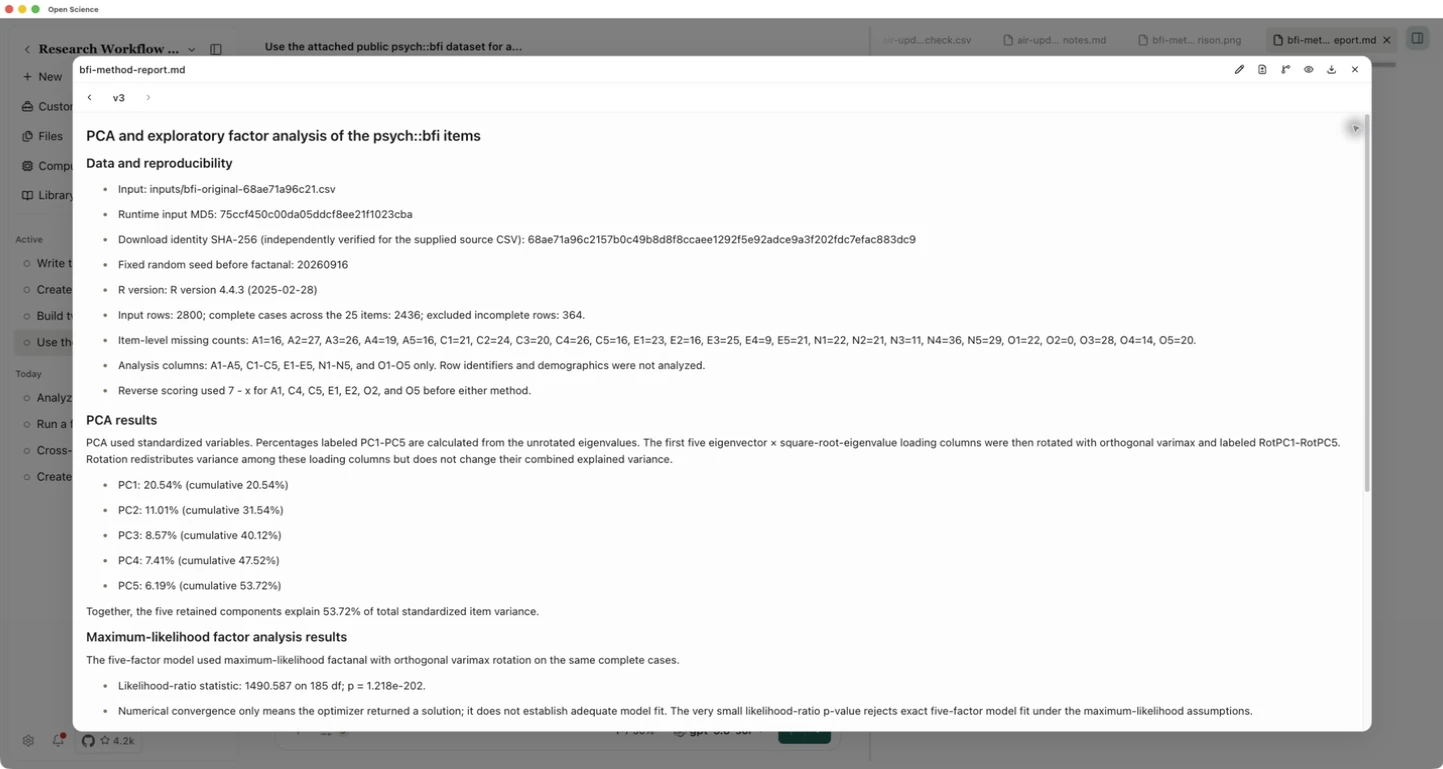
R 스크립트, 제품정보, 미터, .... 및 - 연혁를 다운로드하십시오. 스크립트를 넣어 신선한 폴더에 입력을 다운로드, 거기 터미널을 열고 실행:
Rscript bfi-method-comparison.R bfi-original.csv
스크립트는 현재 폴더에 출력을 작성합니다. 기록 된 스크립트는 독립적으로 R 4.4.3과 재 실행되었습니다 : 사전 처리, 로딩 및 미터 CSV는 앱의 저장된 파일을 정확히 일치했습니다. 모든 사전 처리 세포와 PCA eigenvalues는 또한 따로따로 검사되었습니다. 이 계산의 재현성 설정; 그들은 보편적으로 우량한 방법을 선택하거나 진단 시험을 유효하지 않습니다.