在同一資料上比較兩種分析方法
案例演示 psych::bfi 條目的 PCA 與探索性因子分析
比較方法之前,輸入與預處理必須可比。本例在同一批 2,436 個完整答卷上執行標準化主成分分析(PCA)和五因子極大似然因子分析(FA),比較各自估計的內容,而不是把數值較大的一方當成更好的方法。
1. 準備公開輸入和 R 環境
下載公開的 psych::bfi CSV,儲存為 bfi-original.csv,閱讀資料說明。資料包含 2,800 位受訪者、25 個人格條目及人口學欄位。分析只使用 A1—A5、C1—C5、E1—E5、N1—N5、O1—O5,不用於個人心理評估。
在 Settings → Runtimes 中確認 R 為 Ready 且已啟用。本次使用 R 4.4.3 的基礎及推薦函式,沒有額外安裝包。透過 + → Attach files 將 CSV 附加到專案會話。
2. 擬合前固定預處理規則
Use the attached psych::bfi CSV in the enabled R Notebook.
Analyze only its 25 A/C/E/N/O items, scored 1–6. Validate the range.
Reverse A1, C4, C5, E1, E2, O2 and O5 as 7-x. Use the same complete
cases across all 25 items for both methods; report exclusions.
Run prcomp with centering/scaling and retain five components.
Varimax-rotate eigenvector times sqrt(eigenvalue) loading columns;
label them RotPC1–RotPC5. Report variance from unrotated PC1–PC5.
Run factanal with five factors, varimax and nstart=10; set seed 20260916.
Save bfi-method-comparison.R, bfi-preprocessing.csv, bfi-loadings.csv,
bfi-method-metrics.csv, bfi-method-comparison.png and bfi-method-report.md.
Make the script accept the input CSV as its first argument, record
runtime input identity and R version, execute it and reopen all outputs.
Explain fit, convergence, arbitrary signs/order, ordinal responses
and complete-case limitations. Do not claim that convergence is good fit.
Use English and do not install packages or delegate.
檢查 R 計算再授權,開啟 Notebook 確認執行完成。儲存的預處理矩陣為 2,436 行 × 25 項,排除了 364 份不完整答卷。兩種方法共用這一矩陣,不納入人口學欄位和行標識。
如果一種方法悄悄使用了不同樣本,應先統一輸入,再比較結果。
3. 檢視數值結果
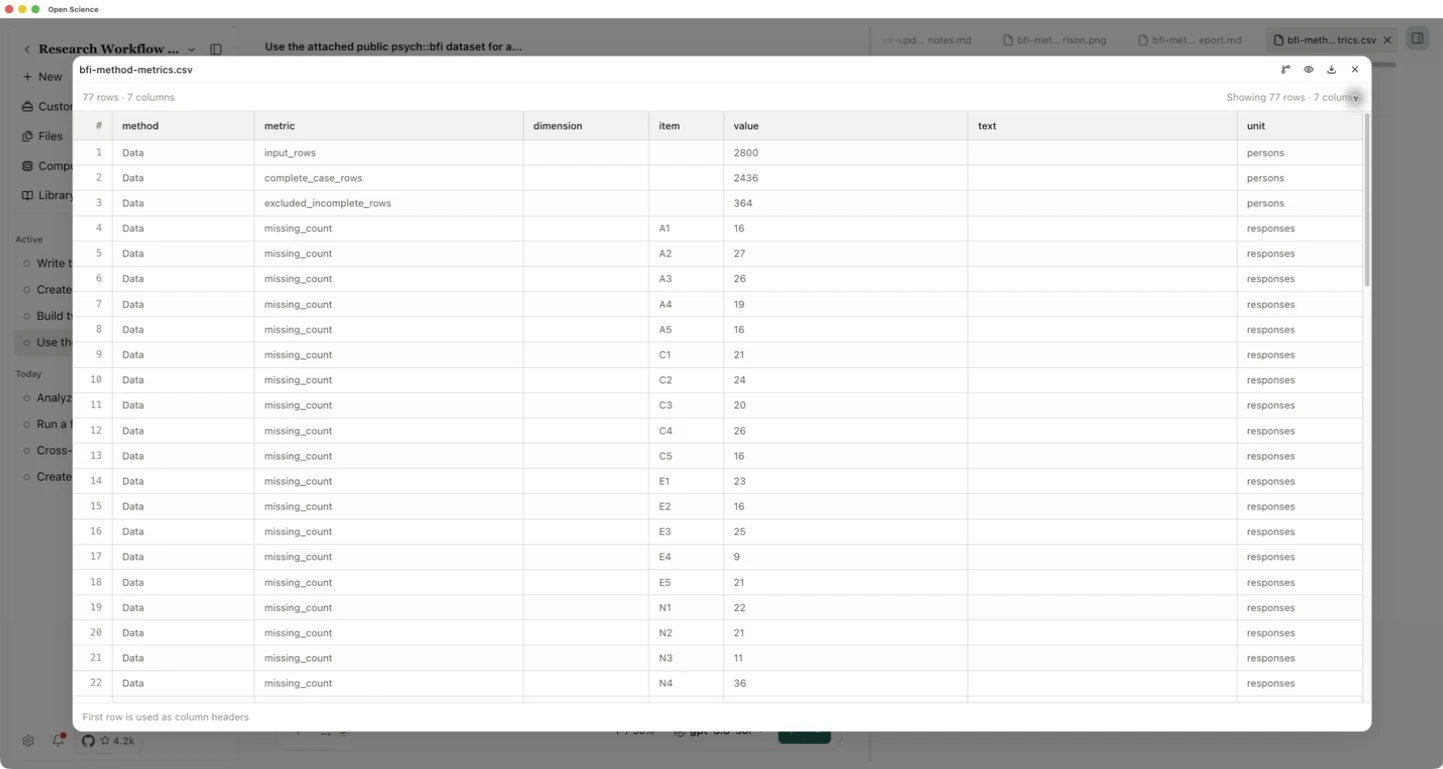
從 Generated 或 Files 開啟 bfi-method-metrics.csv。本次檔案包含 77 行指標,記錄樣本數、缺失數、PCA 方差、FA 獨特性、擬合、收斂、隨機種子與輸入身份。
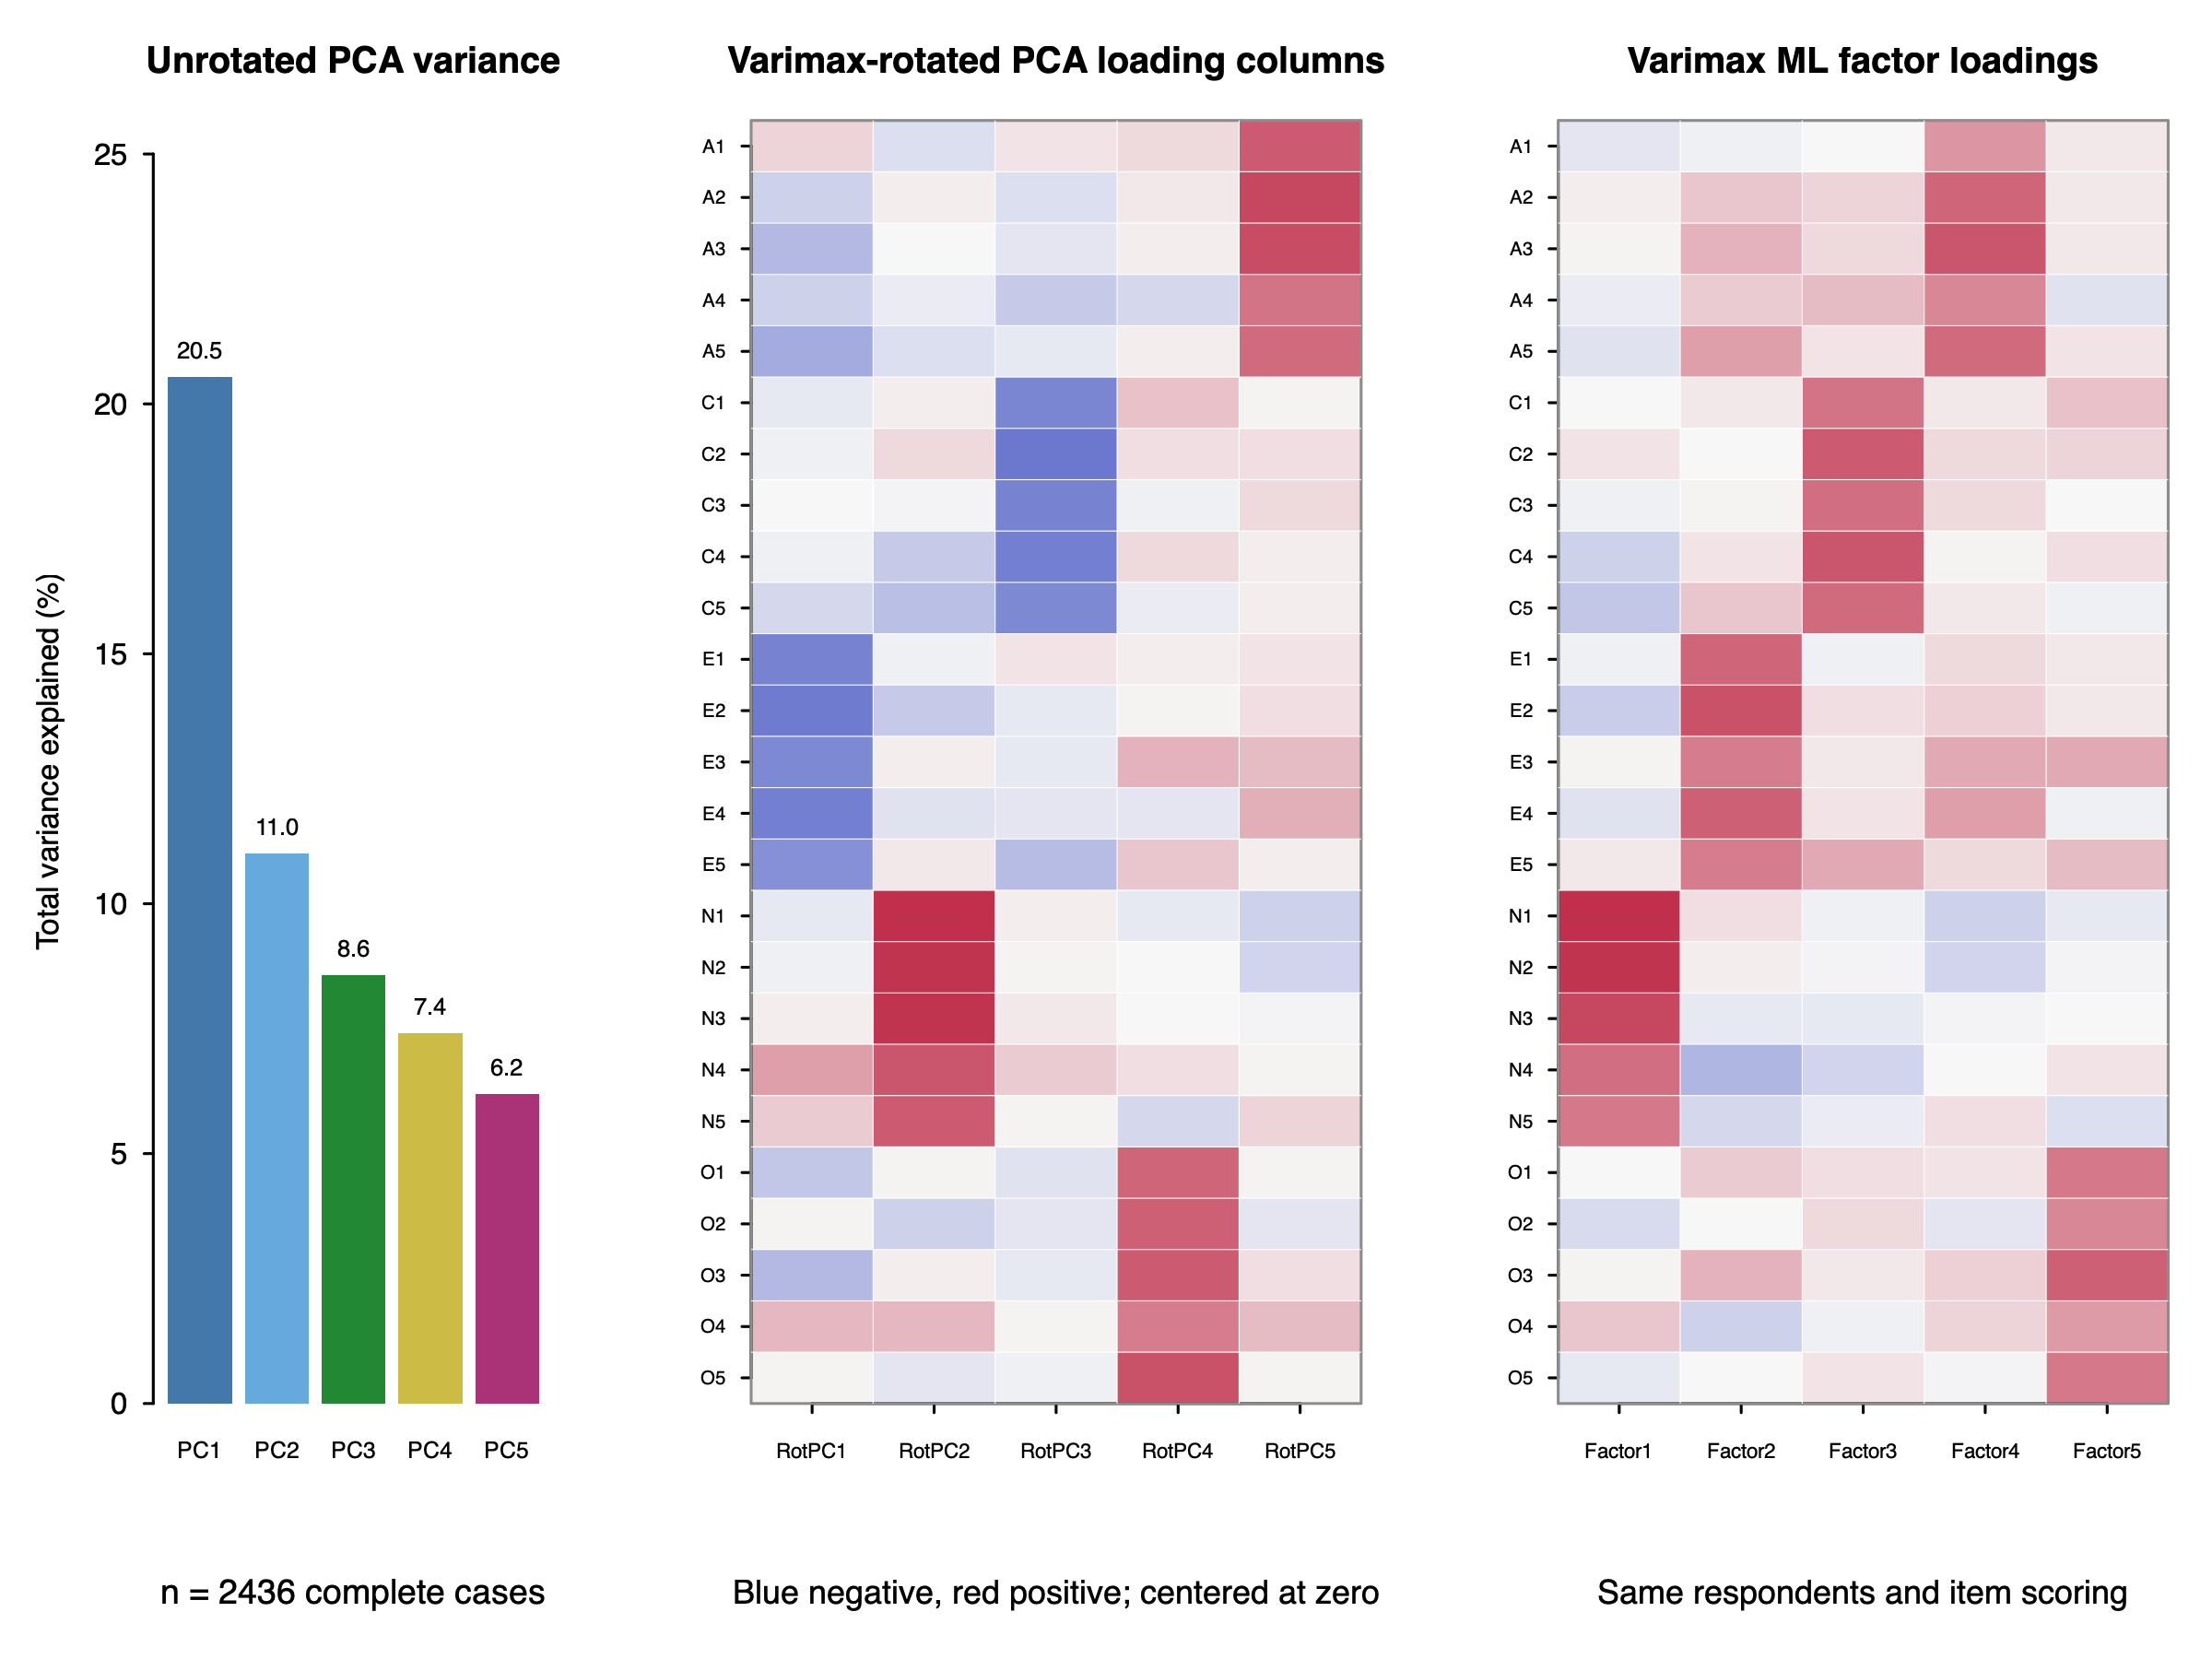
| 未旋轉的 PCA 主成分 | 解釋的標準化總方差 |
|---|---|
| PC1 | 20.54% |
| PC2 | 11.01% |
| PC3 | 8.57% |
| PC4 | 7.41% |
| PC5 | 6.19% |
| 前五個合計 | 53.72% |
FA 最佳化器收斂,但似然比統計量為 1490.587,自由度 185,p ≈ 1.218 × 10⁻²⁰²。在模型假設下,這拒絕五因子模型精確擬合。數值計算成功不代表擬合充分。
4. 在圖中比較載荷模式
開啟 bfi-method-comparison.png。三個面板分別是未旋轉 PCA 方差、varimax 旋轉後的 PCA 載荷、varimax FA 載荷。準確載荷儲存在 bfi-loadings.csv,共 250 行:25 項 × 5 個維度 × 2 種方法。
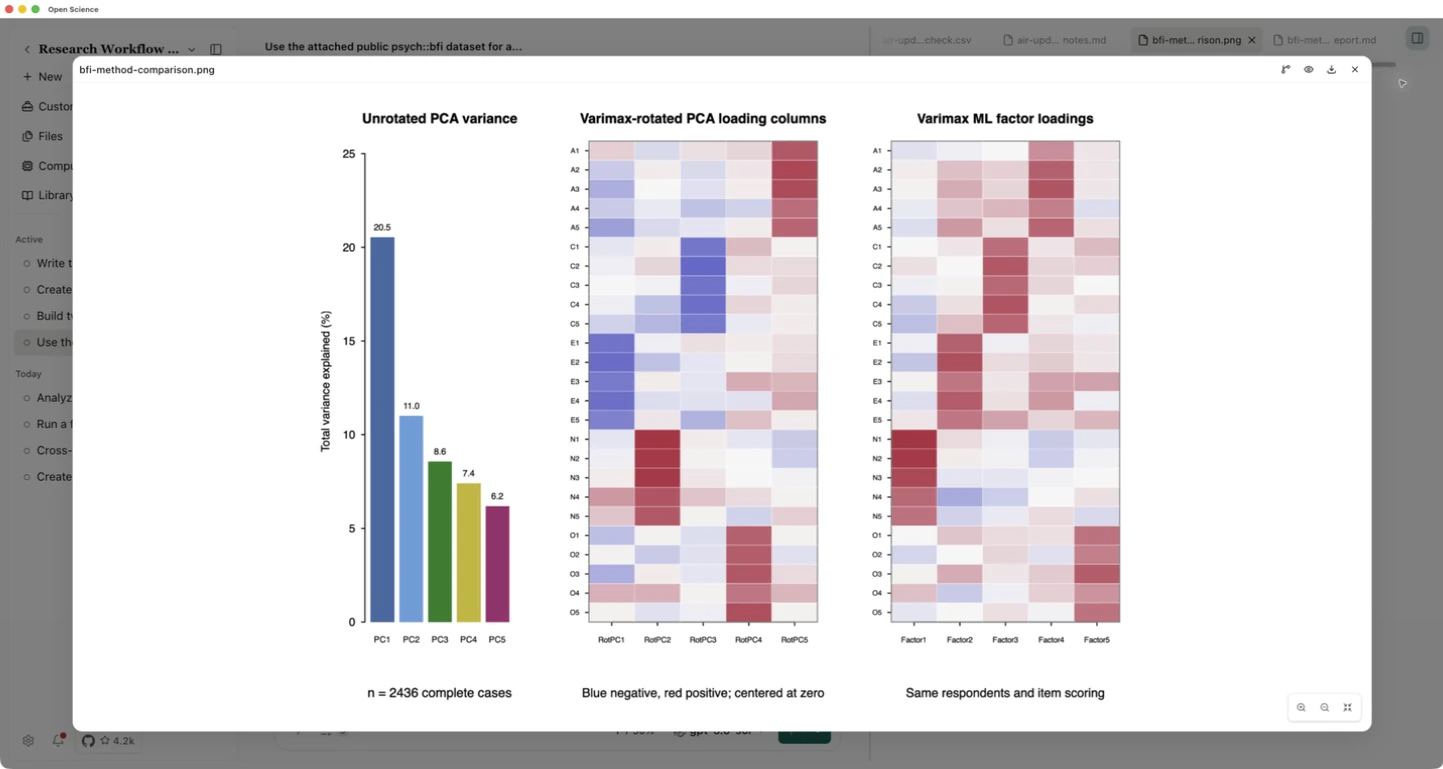
不要機械地對齊兩種方法的“第一列”。維度順序和整列符號改變,不一定改變解的含義。熱圖用藍色表示負載荷、紅色表示正載荷,應結合條目模式與具體數值閱讀。
PCA 分解觀測總方差;FA 建模共同協方差,並單獨估計獨特性。FA 載荷平方和不能與 PCA 解釋方差直接互換。旋轉載荷標為 RotPC1—RotPC5,與未旋轉 PC1—PC5 的方差百分比明確區分。
5. 閱讀邊界並重跑指令碼
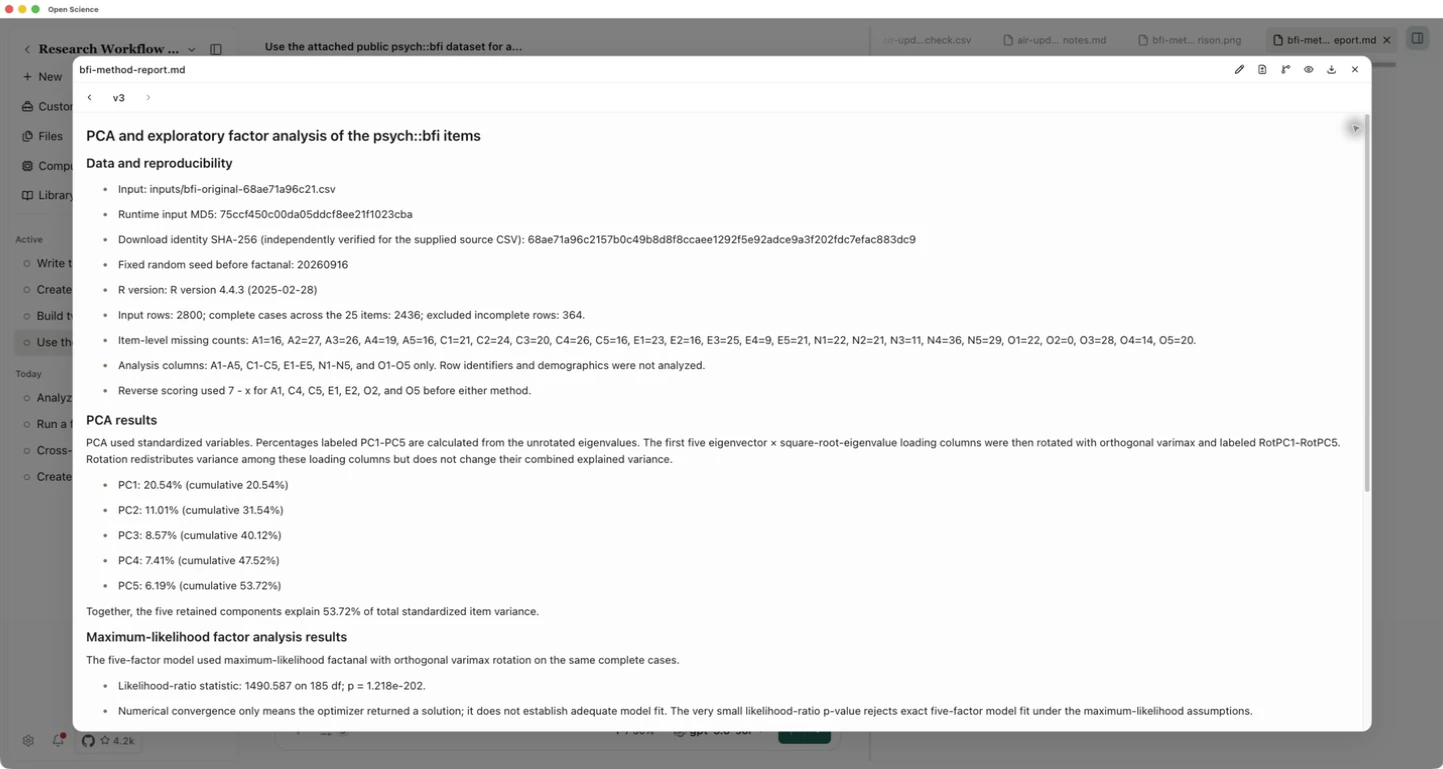
開啟 bfi-method-report.md,核對樣本和預處理是否一致,是否記錄固定隨機種子,以及收斂和擬合的區別。這裡將 1—6 分的有序回答近似當作連續值;如果缺失與回答或受訪者特徵相關,只保留完整答卷可能帶來偏差。
下載 R 指令碼、載荷表、指標表、圖形與報告。將指令碼和下載的輸入放入新資料夾,在該資料夾開啟終端執行:
Rscript bfi-method-comparison.R bfi-original.csv
指令碼把輸出寫入當前目錄。本次使用 R 4.4.3 獨立重跑後,預處理、載荷和指標 CSV 與應用儲存版本完全一致;全部預處理值和 PCA 特徵值也經過獨立核對。這驗證本次計算的可復現性,不代表選出了普遍更優的方法,也不構成診斷工具驗證。