Vérifier la qualité de l'échantillon dans une matrice de nombre de gènes
Exemple pratique Vérifier la qualité de l'échantillon en GSE60450
Avant d'effectuer l'analyse de l'expression différentielle, vérifiez que la matrice de comptage est structurellement utilisable et que les étiquettes de l'échantillon demeurent traçables. Ce parcours utilise la véritable matrice de souris GEO GSE60450 publique RNA-seq. Il produit une table QC de douze exemples, un graphique brut de taille bibliothèque et un rapport de méthodes en Open-Science.
Le fichier Décision de recherche : est-il suffisamment cohérent à l'interne pour permettre d'échantillonner l'annotation et une analyse statistique conçue séparément? Les vérifications ci-dessous portent sur l'intégrité des dossiers et les comptes descriptifs. Ils n'établissent pas la comparabilité biologique, la normalisation, la correction par lots ou l'expression différentielle.
Les dimensions et les résultats numériques ci-dessous font partie de cet exemple. Avec votre propre matrice, définissez ses colonnes d'échantillon et recalculez les vérifications.
Contrat de source et d'intrant
Téléchargez la matrice originale de Exemple de données et résultats attendus. Vérifiez son somme de contrôle, ses colonnes d'échantillon et ses champs de métadonnées avant de le télécharger. Utilisez cette page pour les valeurs de base tout au long de ce workflow.
1. Définir le travail avant de le faire fonctionner
Créez un projet et attachez la matrice originale à partir de la page d'exemple. Activez Python avec csv, statistics et hashlib (bibliothèque standard) et installez matplotlib par Environnements d'exécution s'il est absent. Utilisez un modèle connecté qui peut exécuter le code Notebook.
Envoyer cette requête, ou adapter les noms de sortie tout en préservant les définitions de colonne:
Inspect the attached public GEO GSE60450 gene-count matrix in the Session
Notebook using Python csv/statistics/hashlib and matplotlib. Do not install
packages during the analysis. Preserve the input. Exclude EntrezGeneID and
Length from the 12 sample-count columns. Validate unique IDs, row widths,
nonnegative integer counts and missing entries. Save rnaseq-sample-qc.csv
with exactly six columns: compact_sample, original_column_name, total_raw_counts,
zero_count_genes, detected_genes_count_gt_0, median_count_among_detected_genes. Retain the complete original sample
identifier in original_column_name; compact_sample is only a compact display label.
For each sample compute the raw-count sum, count of zeros, count > 0,
and median of positive counts. Save rnaseq-library-sizes.png with all sample
labels and a raw-count axis, plus rnaseq-qc-report.md describing the source,
input SHA-256 before and after, method, label mapping and limitations.
Save all three outputs in English; I will reopen them to check the results.
Do not perform differential-expression testing or delegate.
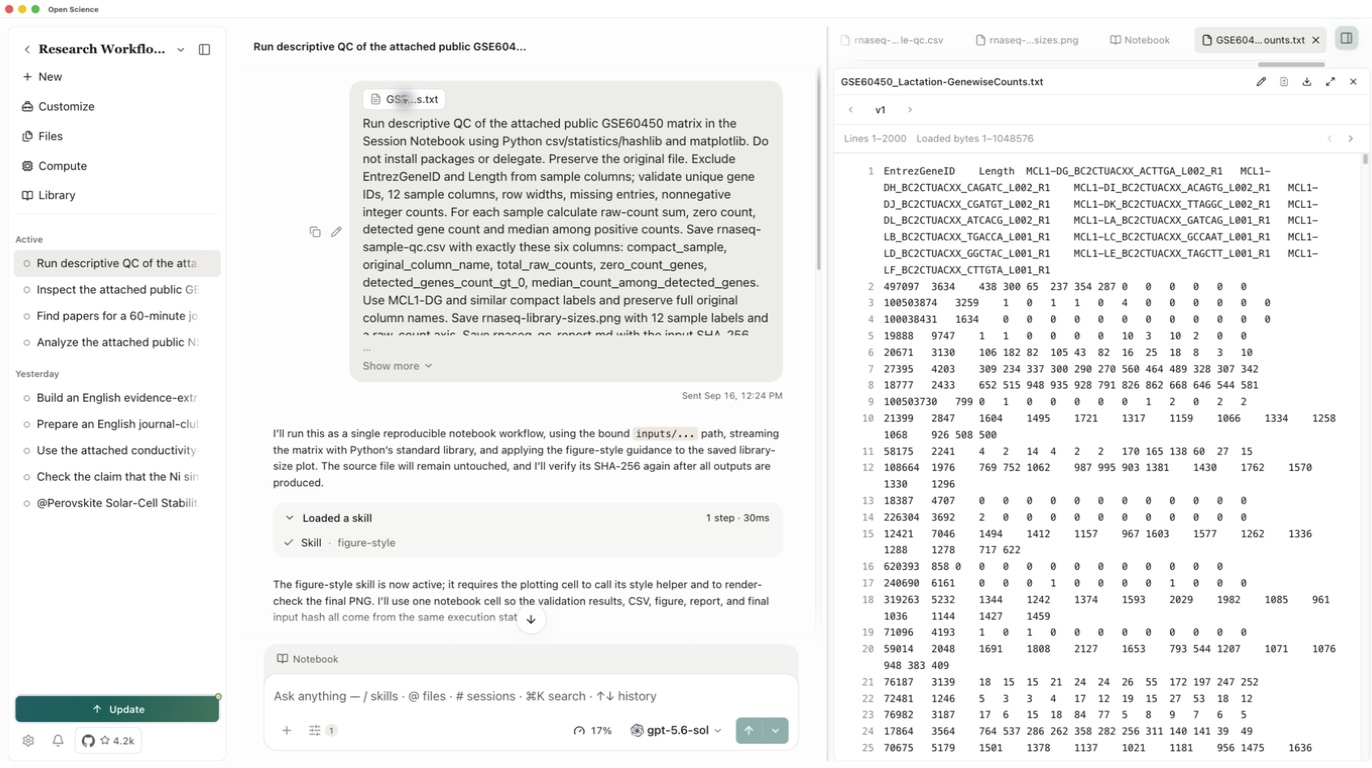
Avant d'envoyer, cliquez sur la pièce jointe pour vérifier son en-tête : deux colonnes de métadonnées suivies de douze colonnes d'exemple. L'aperçu du texte ne charge qu'une partie d'un grand fichier; le Notebook doit lire la matrice entière. Cette exécution a envoyé le calcul directement. Si vous voulez d'abord vous mettre d'accord sur un plan, utilisez le flux Planification séparé.
2. Tenir les métadonnées hors des calculs de l'échantillon
Le calcul préserve les ID d'Entrez, vérifie des largeurs de rangées cohérentes et vérifie les nombres d'entiers non négatifs. Length est une métadonnées génétique, et non un treizième échantillon. Un nombre zéro est une entrée mesurée, et non une valeur manquante; ne remplacez pas les blancs par zéro ou n'enlevez pas les gènes du nombre zéro en silence.
Pour chaque échantillon, calculer les nombres bruts totaux, le nombre de gènes zéro, le nombre avec un nombre supérieur à zéro et le nombre médian parmi les gènes détectés seulement. Enregistrez ce dénominateur. Utiliser les colonnes d'entrée exactes; Les étiquettes compactes telles que MCL1-DG sont des étiquettes d'affichage avec une cartographie explicite, et non des groupes biologiques nouvellement déduits.
3. Inspecter l'exécution et gérer une défaillance
Lire la requête d'autorisation Python, y compris les noms de fichier d'entrée et de sortie, puis permettre l'opération scoped. Ouvrez Notebook dans la conversation et inspectez la cellule complète et sa sortie. Vérifier les dimensions, les étiquettes originales, les tableaux métriques et le hachage avant/après; le seul message d'achèvement du modèle est insuffisant.
Si l'ID de version d'entrée ne peut pas être résolu, demandez à l'Agent d'utiliser l'entrée montée à partir de la pièce jointe et de la réessayer. Cette course a utilisé cette récupération. Ne traitez pas la tentative échouée comme un calcul terminé ou remplacez silencieusement un autre fichier.
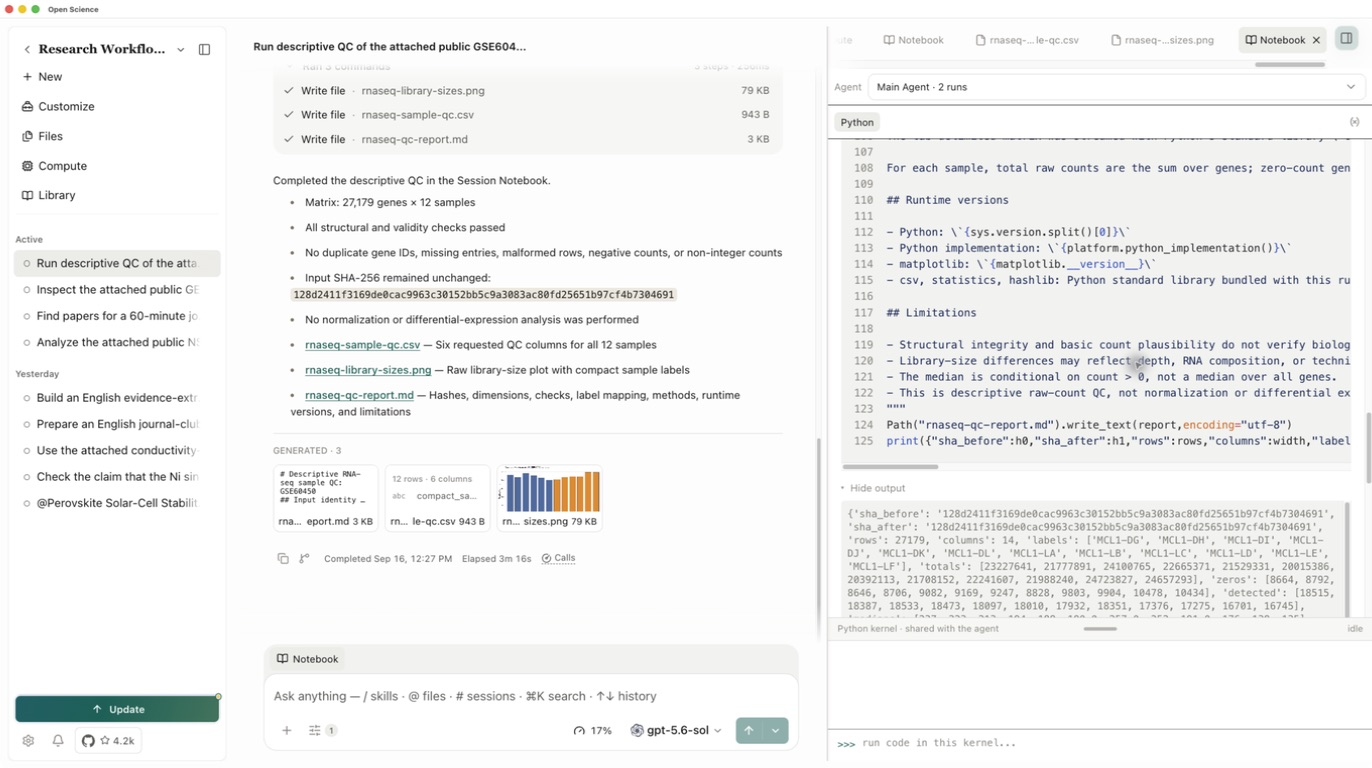
Le rediffusion complété a validé Lignes du gène 27,179 et colonnes d'échantillonnage 12 sans lignes malformées, doublons ID, entrées manquantes ou nombres invalides. Les trois fichiers demandés sont apparus sous Generated. Ouvrez chaque fichier là-bas; un fichier de travail qui n'a jamais été sauvegardé comme un artefact n'est pas encore un livrable.
4. Accepter le tableau de l'échantillon
Ouvrez rnaseq-sample-qc.csv et vérifiez Lignes 12 · Colonnes 6. Il conserve chaque nom de colonne d'origine complet. Le tableau ci-dessous énumère les quatre paramètres; le CSV téléchargeable inclut la colonne de mappage.
Comparer toutes les mesures de l'échantillon avec le Tableau de référence, en fonction des lignes par l'identificateur de l'échantillon complet.
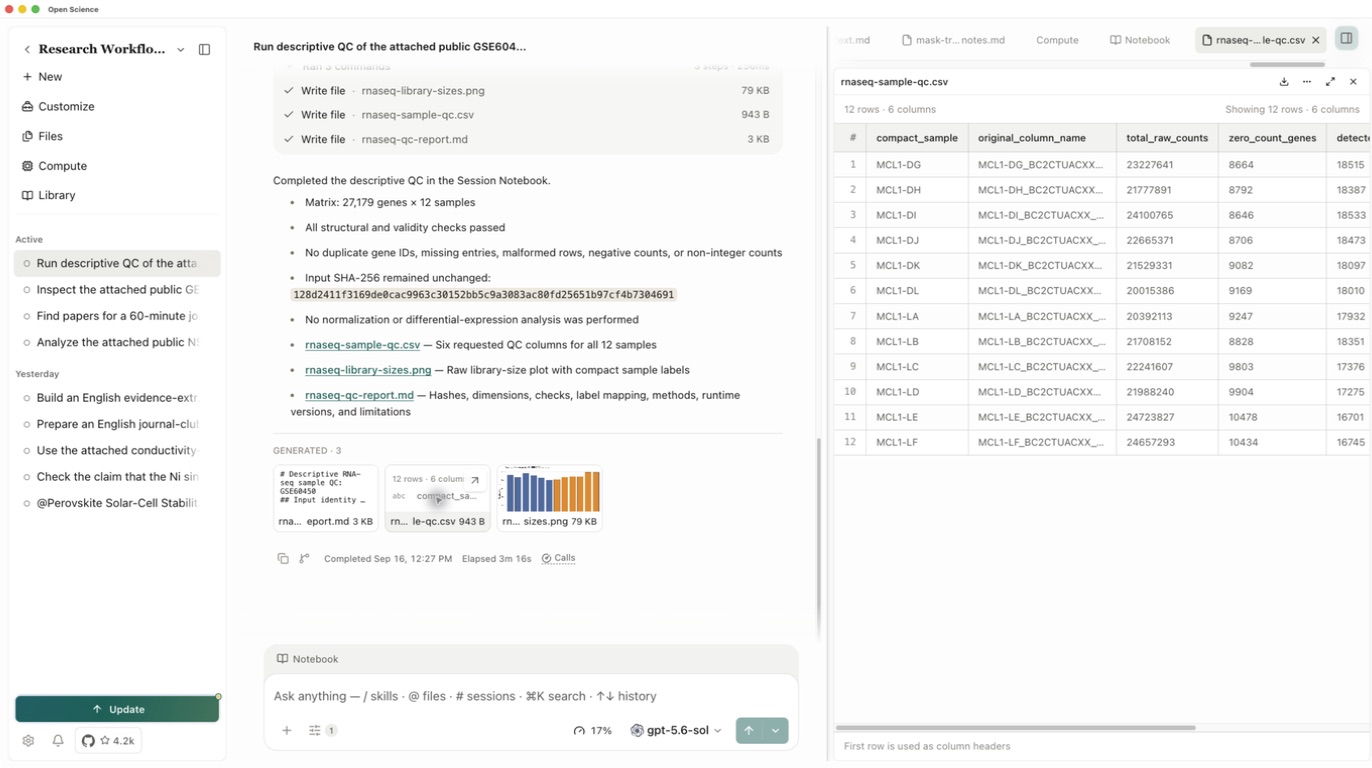
Pour cette entrée, le nombre zéro plus les gènes détectés dans chaque rangée devrait être égal à 27,179. Comparer les mesures de l'échantillon 48 avec la base de référence indépendante. L'accord vérifie ces calculs pour l'intrant fourni; Les hypothèses en aval nécessitent toujours leur propre évaluation.
5. Lire l'intrigue sans trop l'interpréter
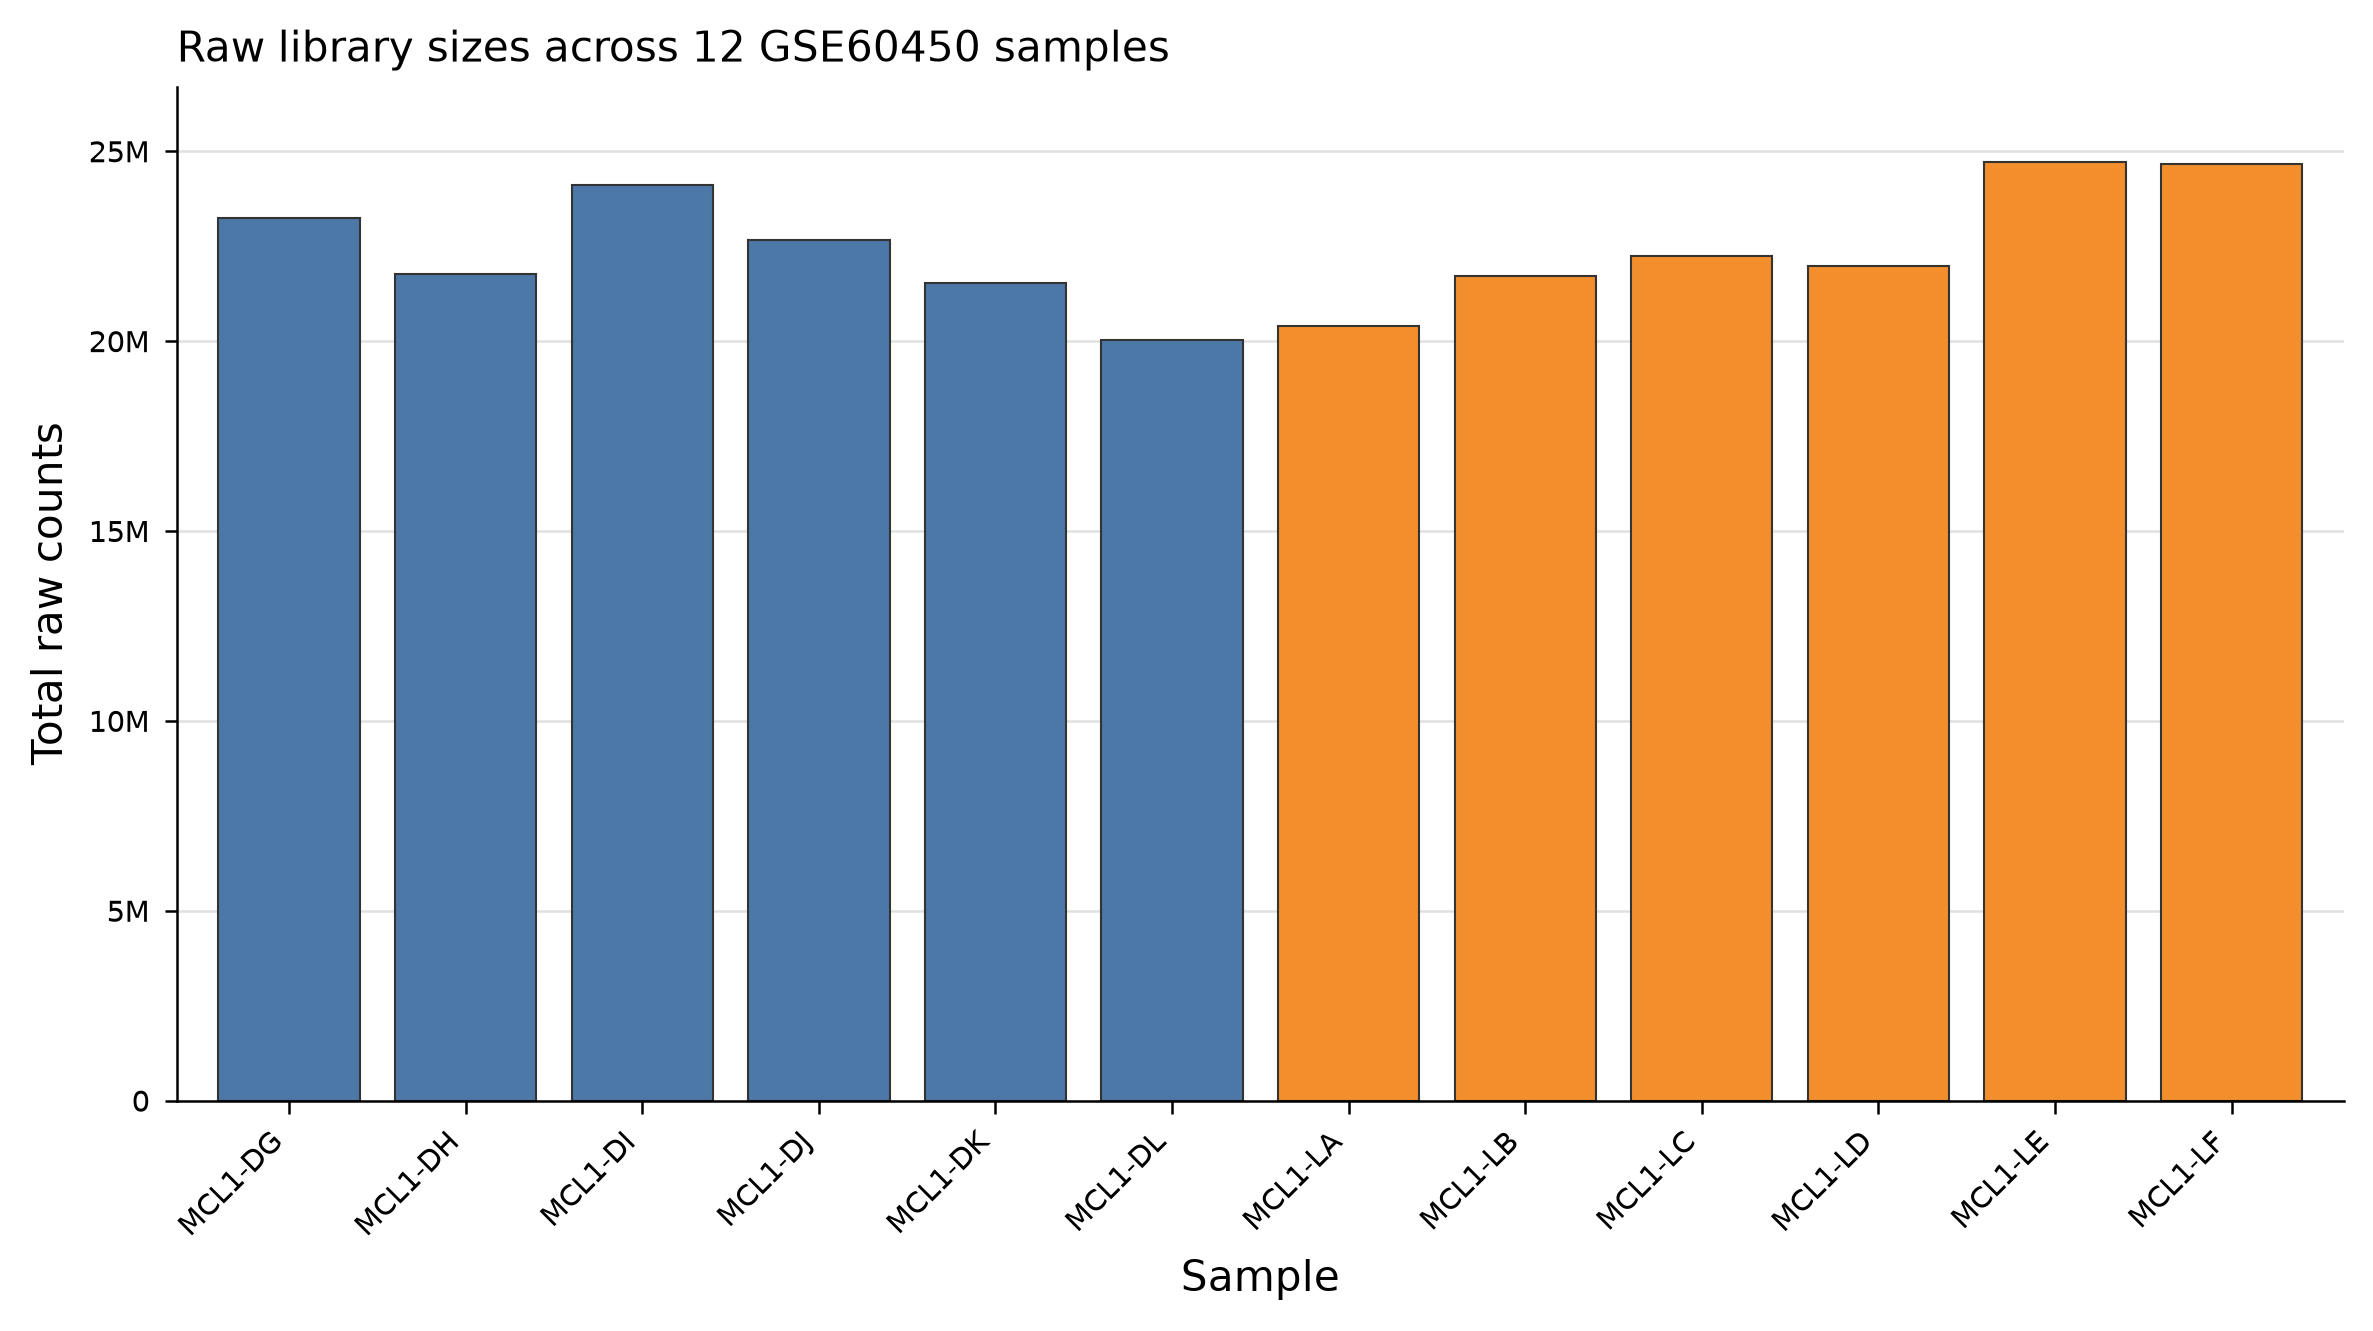
Ouvrez rnaseq-library-sizes.png et agrandissez-le. Vérifiez les douze étiquettes de l'échantillon, l'axe du compte brut et la note que les valeurs ne sont pas normalisées. Les totaux varient de 20,015,386 à 24,723,827 dans cette matrice.
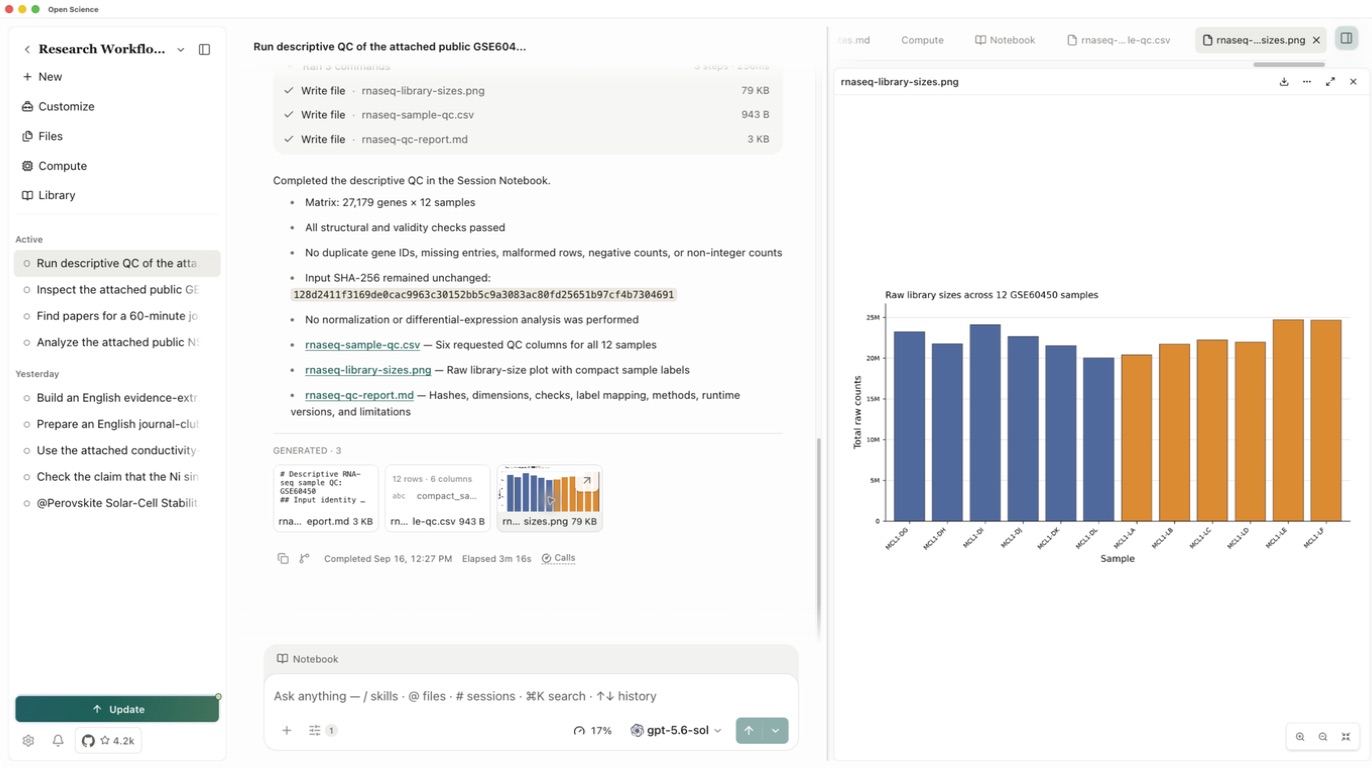
Un total plus grand de bibliothèques ne signifie pas en soi qu'un gène est exprimé différemment. Avant de procéder à une analyse séparée en aval, faire correspondre les caractéristiques de l'échantillon aux métadonnées GEO et préciser la conception, les contrastes, la normalisation et les règles de filtrage. Un suivi séparé de Connector a permis de récupérer les douze échantillons de caractéristiques GEO; La cartographie, la conception de l'analyse et les étapes statistiques du GSM à la matrice n'ont pas été validées ici. Voir Connecteurs.
6. Conserver les méthodes et les preuves
Conservez un rapport contenant le somme de contrôle d'entrée, les dimensions, les vérifications de validité, la cartographie exacte de l'étiquette, les versions d'exécution/bibliothèque et les limites d'interprétation. Ajouter une section de vérification indépendante seulement après avoir comparé les valeurs. L'enregistrement d'une révision de rapport ne permet pas de recalculer le tableau ou le chiffre.
La nouvelle version de septembre de 16 correspondait à toutes les mesures de 48 par rapport à la base de référence vérifiée de façon indépendante. Son entrée SHA-256 est restée 128d2411f3169de0cac9963c30152bb5c9a3083ac80fd25651b97cf4b7304691. Le rapport enregistre Python 3.12.14 et matplotlib 3.11.1. Ces vérifications établissent l'accord de ce calcul et la conservation des intrants; ils n'établissent pas de vérification par l'examinateur ni un environnement exact pour une reproduction indépendante.
Téléchargez les Tableau QC, parcelle et rapport de ce rediffusion. Conservez également l'entrée originale et la session Notebook. Le page exemple-données conserve séparément les exportations de référence antérieures et celles de Notebook; ces exportations ne sont pas les Notebook de cette nouvelle opération. Utilisez Contrôles de reproductibilité pour une évaluation séparée de l'environnement et de la réexécution.