檢查基因計數矩陣的樣本質量
案例演示 檢查 GSE60450 的樣本質量
差異表達分析前,先確認計數矩陣結構可用、樣本名稱可追蹤。本工作流使用真實公開 GEO GSE60450 小鼠乳腺 RNA-seq 矩陣,在 Open-Science 生成十二樣本質控表、原始計數總量圖和方法報告。
**研究決策:**檔案內部是否一致,可以繼續準備樣本註釋和另行設計的統計分析?本例只檢查完整性與描述性計數,不證明生物學可比性、歸一化、批次校正或差異表達。
下文的維度和數值結果對應本例輸入。換用自己的矩陣時,應重新確認樣本列並計算檢查結果。
來源和輸入約定
從示例資料與預期結果下載原始矩陣,上傳前核對校驗值、樣本列和後設資料欄位。下文均使用該頁的基準結果。
1. 執行前明確任務
建立專案並附加示例頁的原始矩陣。啟用 Python;csv、statistics、hashlib 屬於標準庫,若缺少 matplotlib,先透過執行環境安裝。選擇已連線、可執行 Notebook 程式碼的模型。
傳送以下請求。可以調整輸出檔名,但應保留列定義:
Inspect the attached public GEO GSE60450 gene-count matrix in the Session
Notebook using Python csv/statistics/hashlib and matplotlib. Do not install
packages during the analysis. Preserve the input. Exclude EntrezGeneID and
Length from the 12 sample-count columns. Validate unique IDs, row widths,
nonnegative integer counts and missing entries. Save rnaseq-sample-qc.csv
with exactly six columns: compact_sample, original_column_name, total_raw_counts,
zero_count_genes, detected_genes_count_gt_0, median_count_among_detected_genes. Retain the complete original sample
identifier in original_column_name; compact_sample is only a compact display label.
For each sample compute the raw-count sum, count of zeros, count > 0,
and median of positive counts. Save rnaseq-library-sizes.png with all sample
labels and a raw-count axis, plus rnaseq-qc-report.md describing the source,
input SHA-256 before and after, method, label mapping and limitations.
Save all three outputs in English; I will reopen them to check the results.
Do not perform differential-expression testing or delegate.
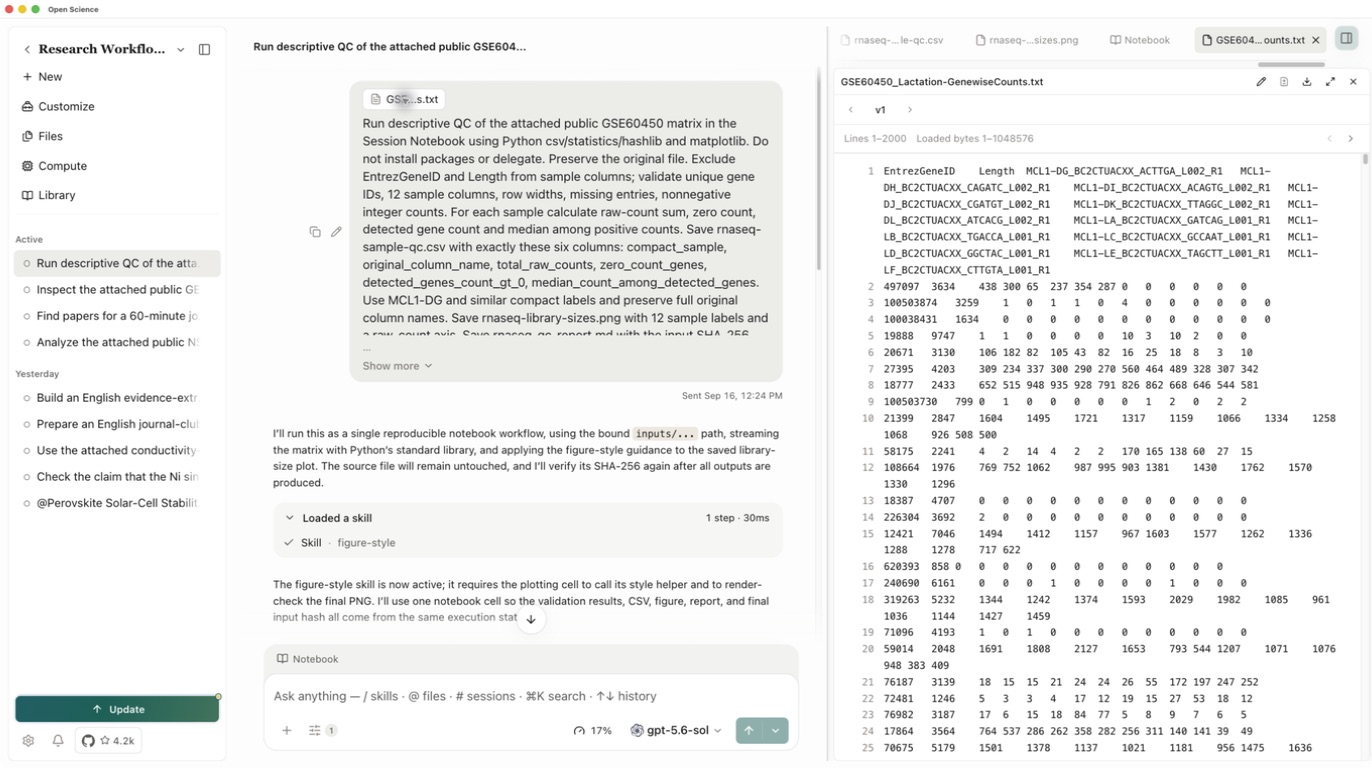
傳送前點選附件檢查表頭:兩個後設資料列,後接十二個樣本列。大檔案預覽只載入部分內容,完整矩陣必須由 Notebook 讀取。本次直接傳送計算請求;如果需要先確定計劃,可另用規劃任務流程。
2. 後設資料不參與樣本計算
保留 Entrez ID,驗證行寬和非負整數計數。Length 是基因後設資料,不是第十三個樣本。零計數是有效觀測,不是缺失;不得把空值補成零或悄悄刪除零計數基因。
每個樣本計算總原始計數、零計數基因數、計數大於零的基因數,以及僅檢出基因的計數中位數,明確分母。使用準確輸入列;MCL1-DG 等短標籤只是有對映的顯示名稱,不是推斷出的生物學分組。
3. 檢查執行並處理失敗
閱讀 Python 審批,確認輸入檔案與輸出名稱,再允許相應範圍的操作。在會話中開啟 Notebook,檢查完成後的單元及輸出,核對維度、原始標籤、指標陣列和前後校驗值;不能只看模型的完成訊息。
如果輸入 Version ID 無法解析,要求 Agent 使用本會話附件掛載的輸入重試。本次透過這一方式繼續計算。失敗的嘗試不能記為完成,也不能悄悄替換成另一個檔案。
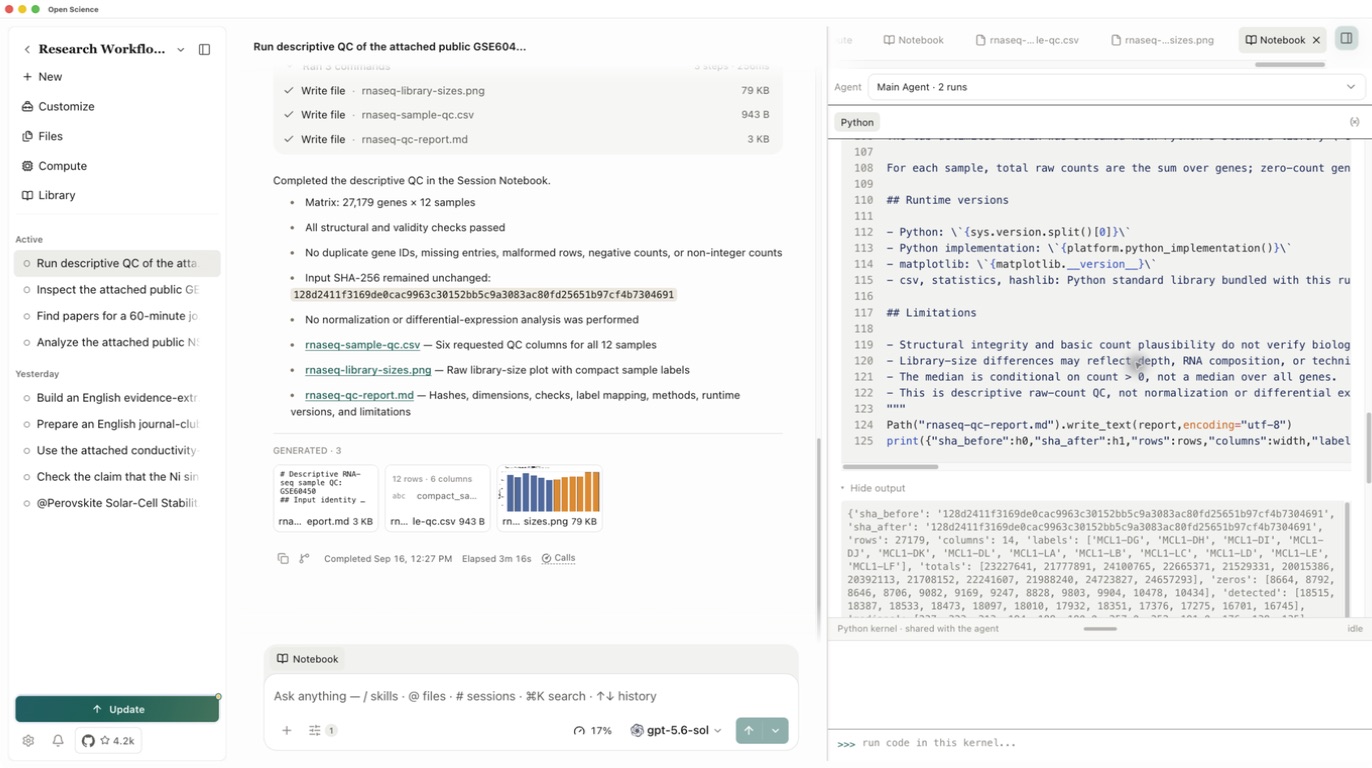
本次重跑檢查了 27,179 個基因行、12 個樣本列,沒有行寬異常、重複 ID、缺失值或無效計數。三個結果均出現在 Generated 中,應逐一開啟;只存在於工作目錄、尚未儲存為產物的檔案還不算交付結果。
4. 驗收樣本表
開啟 rnaseq-sample-qc.csv,確認 12 行、6 列,保留完整原列名。下表列出四項指標,下載 CSV 另含原列名對映。
按完整樣本標識與基準表逐行比較全部指標。
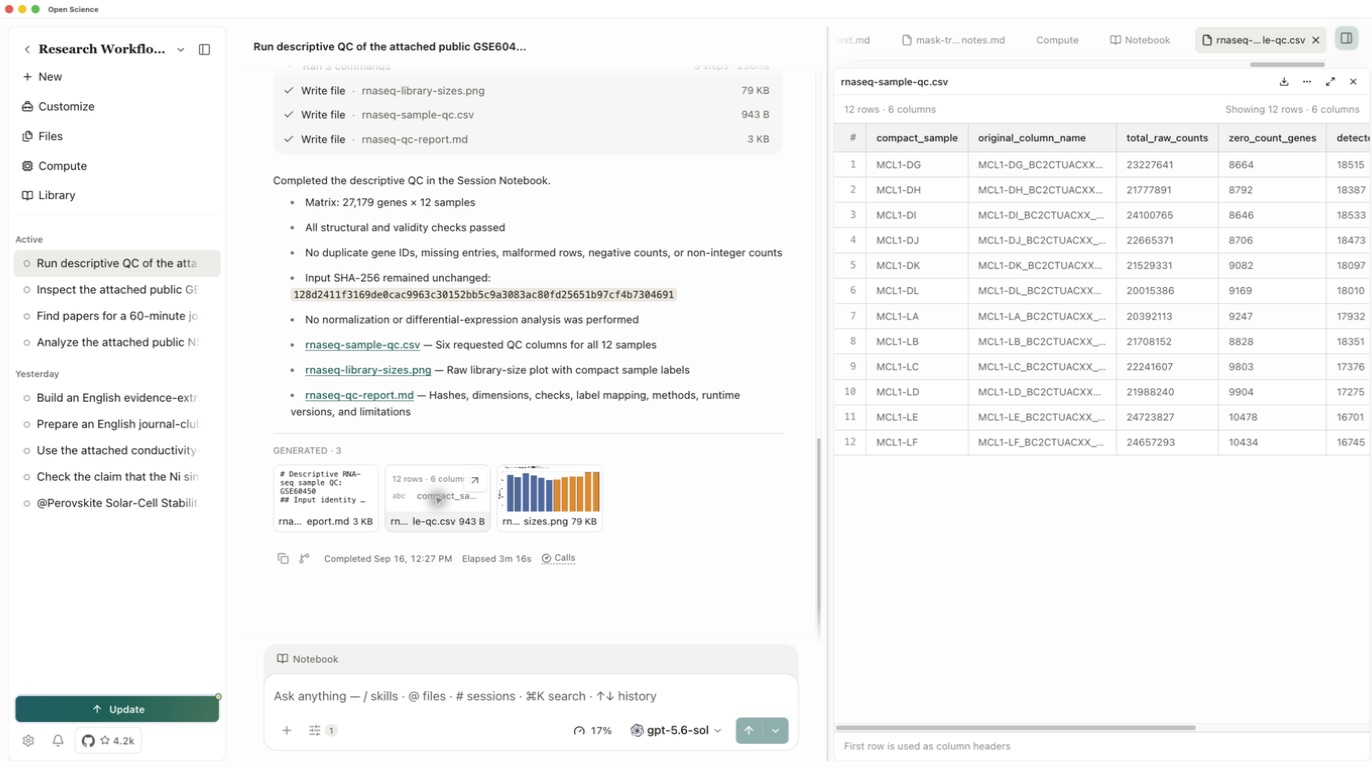
對於本例輸入,每行零計數基因數加檢出基因數應等於 27,179。將 48 項樣本指標與獨立基準對照。一致性檢查針對該輸入的這些計算;下游分析假設仍需另行評估。
5. 閱讀圖表並控制解釋範圍
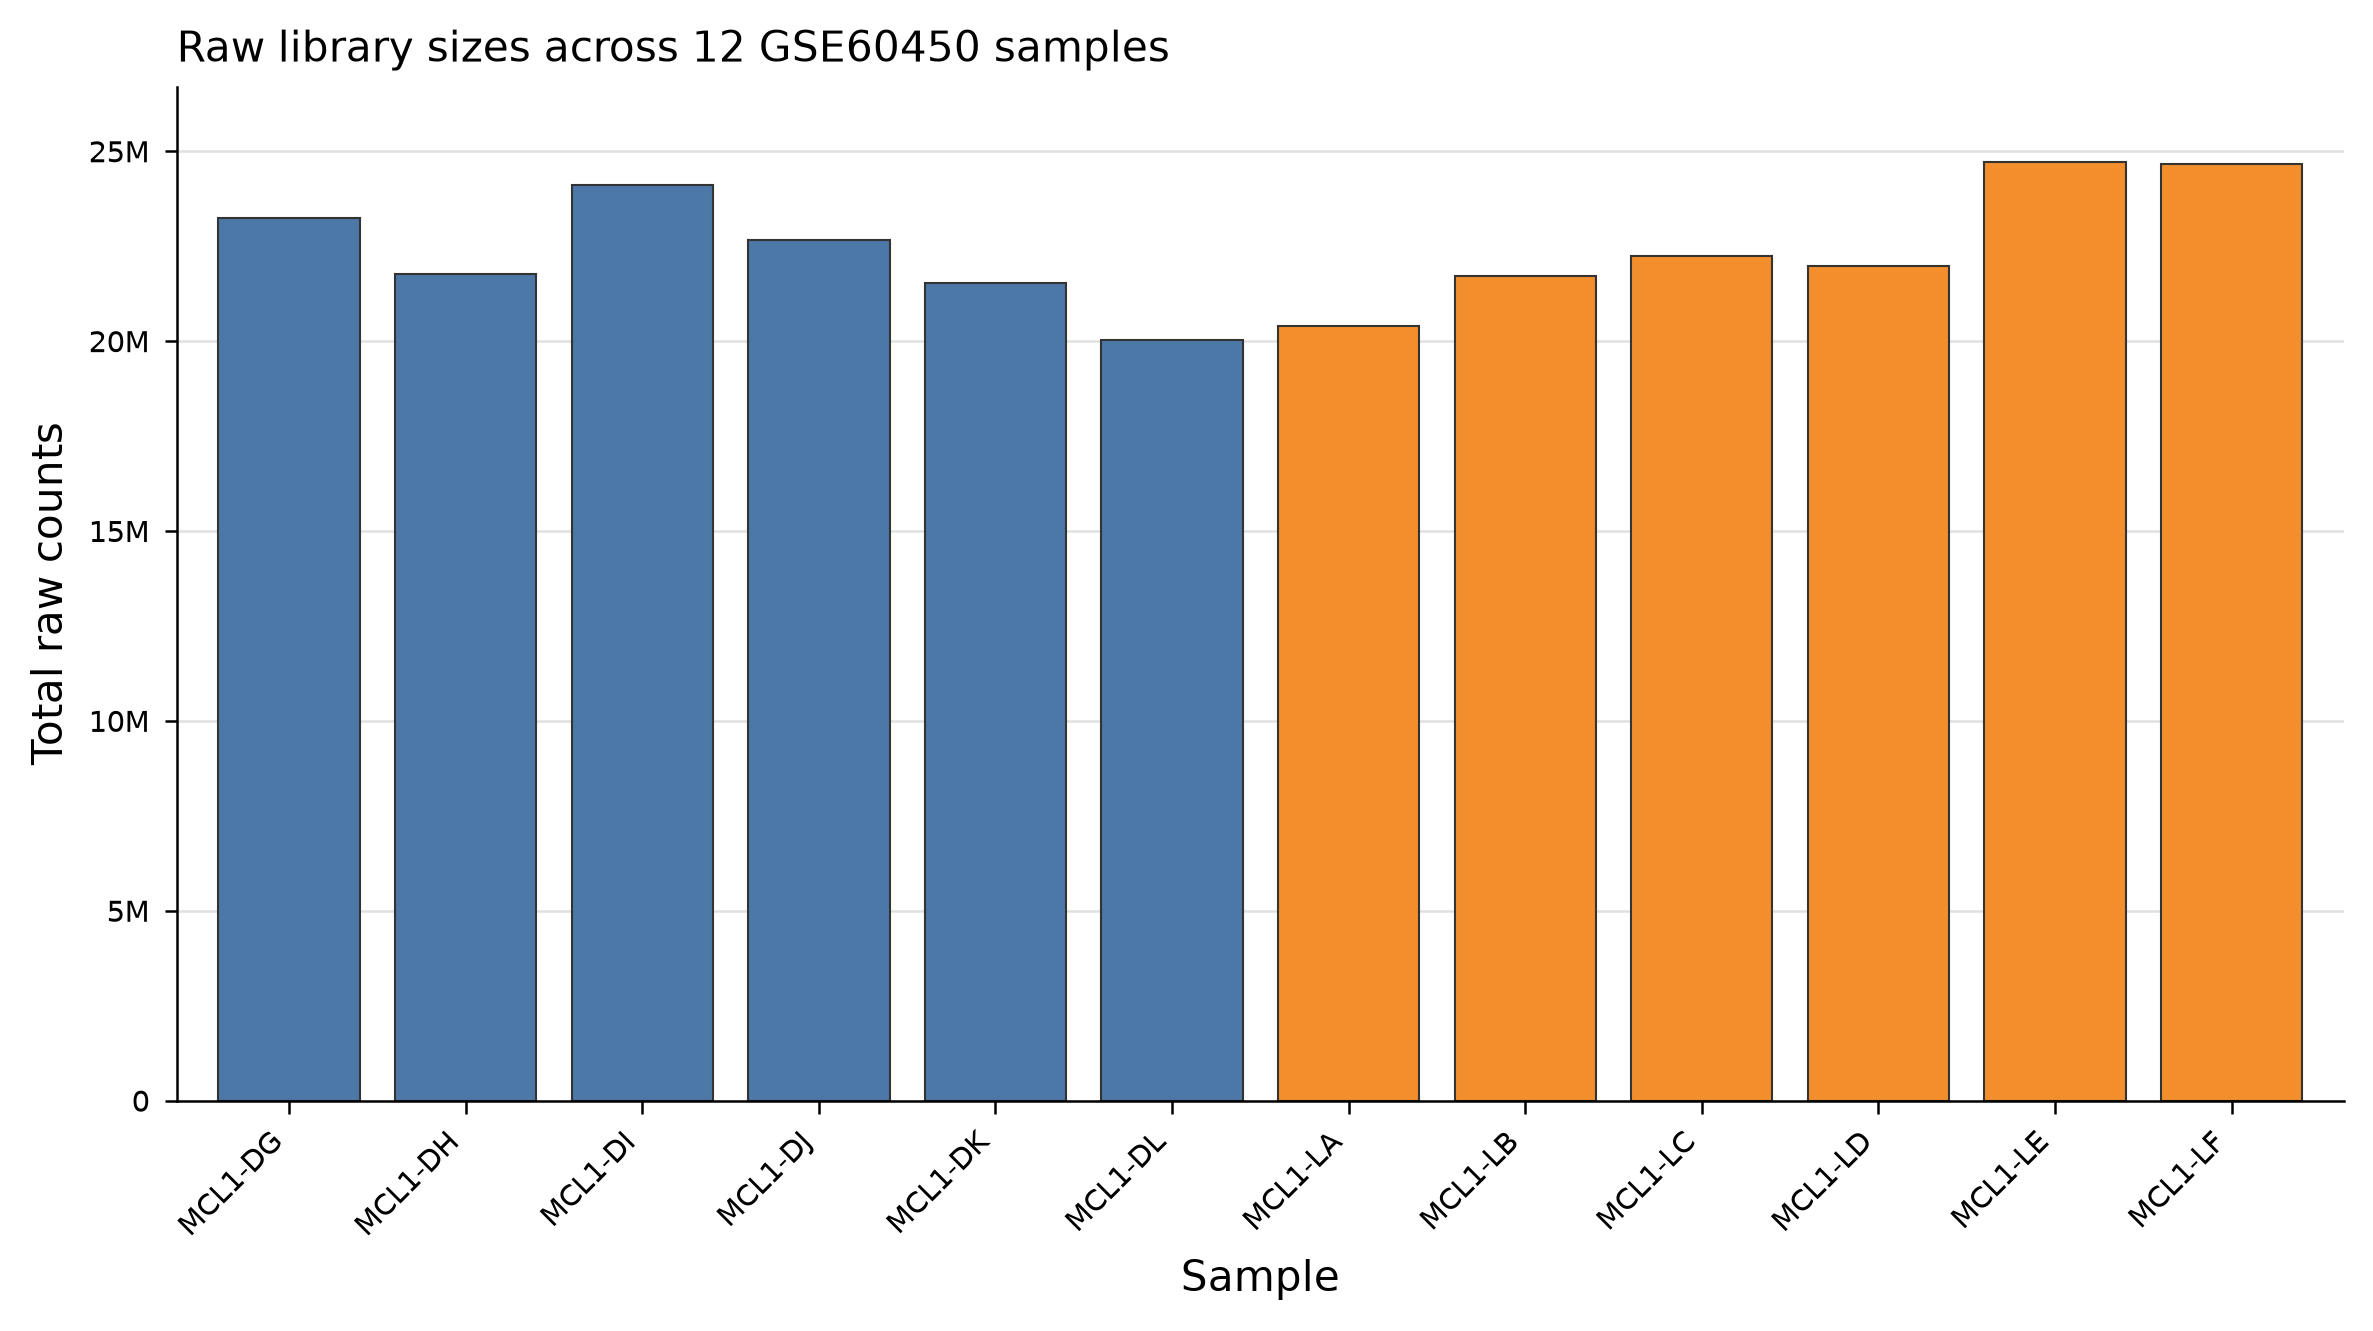
開啟並放大 rnaseq-library-sizes.png,核對十二標籤、原始計數軸與未歸一化說明。矩陣總計數範圍為 20,015,386–24,723,827。
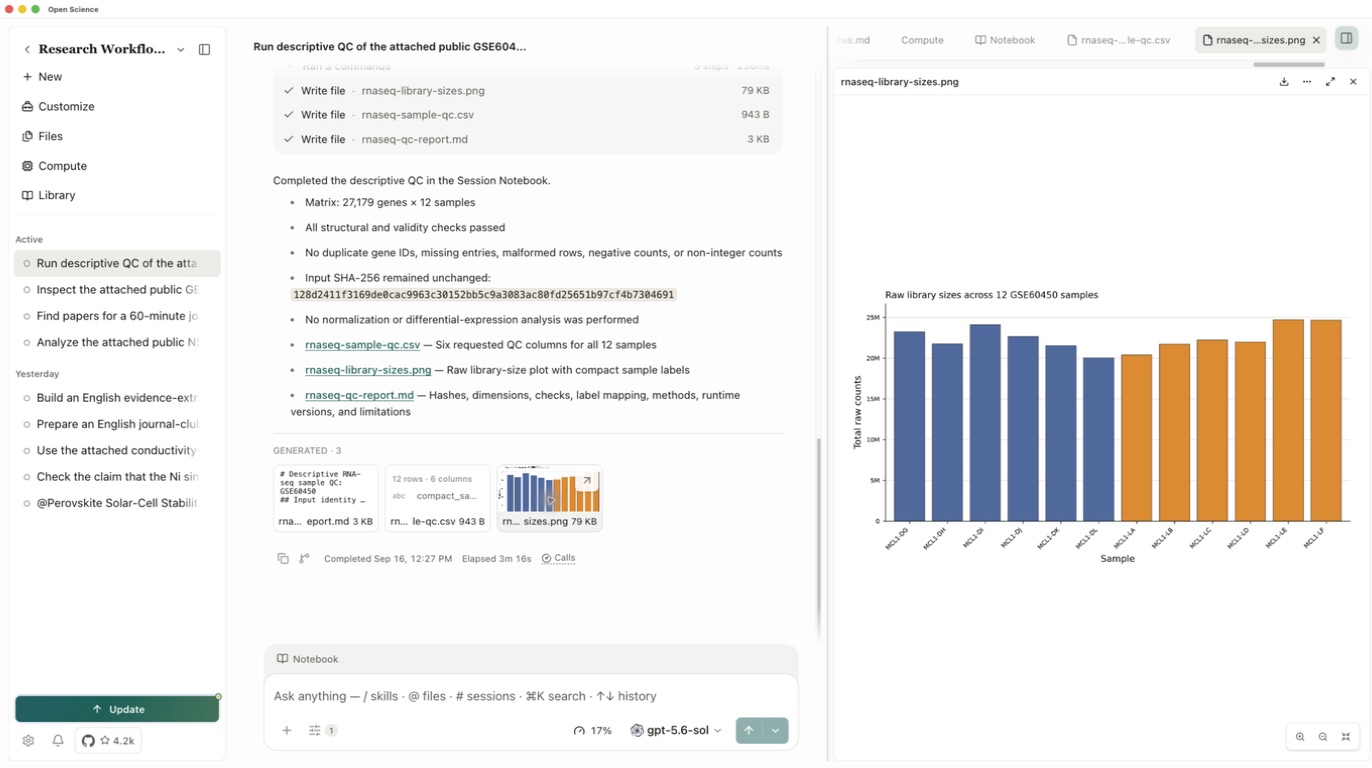
總計數較大不能證明某基因差異表達。繼續下游分析前,從 GEO 核對樣本特徵,明確 GSM 與矩陣列名對映、研究設計、對比、歸一化及過濾規則。後設資料獲取見聯結器。
6. 保留方法與證據
保留包含輸入校驗值、維度、有效性檢查、準確標籤對映、執行環境和依賴版本、解釋限制的報告。比較數值後才補充獨立檢查結論。儲存報告修訂版不會重新計算表格和圖片。
9 月 16 日的重跑與已獨立核對的基準相比,48 項指標全部一致。輸入 SHA-256 保持為 128d2411f3169de0cac9963c30152bb5c9a3083ac80fd25651b97cf4b7304691。報告記錄 Python 3.12.14 和 matplotlib 3.11.1。這些檢查證明本次數值一致、輸入未變,不代表已完成 Reviewer 審查或準備好獨立復現所需的精確環境。
下載本次重跑的質控表、圖表和報告,並保留原始輸入及本會話 Notebook。示例資料頁另外保留早期基準與 Notebook 匯出,它們不是本次重跑的 Notebook。如需獨立復現,再按可復現性檢查檢查環境與重新執行條件。