检查基因计数矩阵的样本质量
案例演示 检查 GSE60450 的样本质量
差异表达分析前,先确认计数矩阵结构可用、样本名称可追踪。本工作流使用真实公开 GEO GSE60450 小鼠乳腺 RNA-seq 矩阵,在 Open-Science 生成十二样本质控表、原始计数总量图和方法报告。
研究决策:文件内部是否一致,可以继续准备样本注释和另行设计的统计分析?本例只检查完整性与描述性计数,不证明生物学可比性、归一化、批次校正或差异表达。
下文的维度和数值结果对应本例输入。换用自己的矩阵时,应重新确认样本列并计算检查结果。
来源和输入约定
从示例数据与预期结果下载原始矩阵,上传前核对校验值、样本列和元数据字段。下文均使用该页的基准结果。
1. 运行前明确任务
创建项目并附加示例页的原始矩阵。启用 Python;csv、statistics、hashlib 属于标准库,若缺少 matplotlib,先通过运行环境安装。选择已连接、可执行 Notebook 代码的模型。
发送以下请求。可以调整输出文件名,但应保留列定义:
Inspect the attached public GEO GSE60450 gene-count matrix in the Session
Notebook using Python csv/statistics/hashlib and matplotlib. Do not install
packages during the analysis. Preserve the input. Exclude EntrezGeneID and
Length from the 12 sample-count columns. Validate unique IDs, row widths,
nonnegative integer counts and missing entries. Save rnaseq-sample-qc.csv
with exactly six columns: compact_sample, original_column_name, total_raw_counts,
zero_count_genes, detected_genes_count_gt_0, median_count_among_detected_genes. Retain the complete original sample
identifier in original_column_name; compact_sample is only a compact display label.
For each sample compute the raw-count sum, count of zeros, count > 0,
and median of positive counts. Save rnaseq-library-sizes.png with all sample
labels and a raw-count axis, plus rnaseq-qc-report.md describing the source,
input SHA-256 before and after, method, label mapping and limitations.
Save all three outputs in English; I will reopen them to check the results.
Do not perform differential-expression testing or delegate.
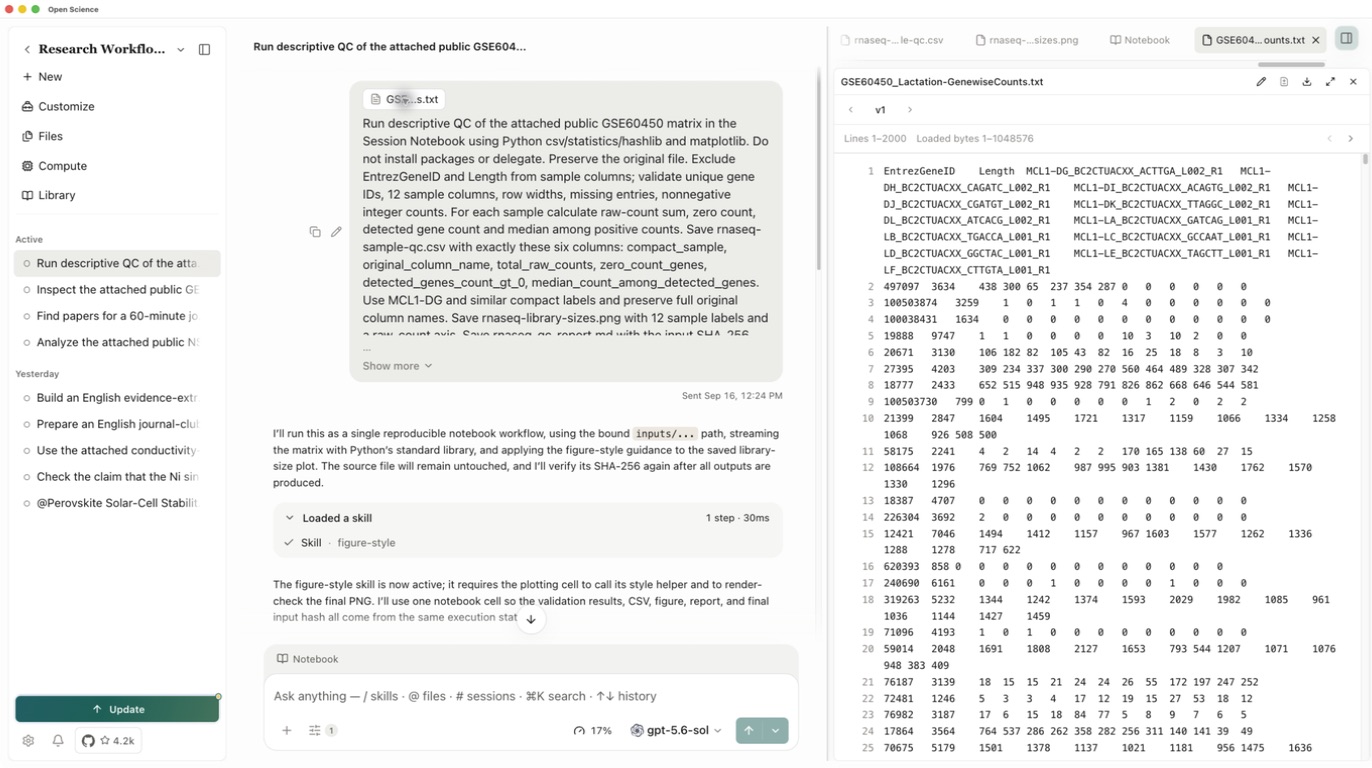
发送前点击附件检查表头:两个元数据列,后接十二个样本列。大文件预览只加载部分内容,完整矩阵必须由 Notebook 读取。本次直接发送计算请求;如果需要先确定计划,可另用规划任务流程。
2. 元数据不参与样本计算
保留 Entrez ID,验证行宽和非负整数计数。Length 是基因元数据,不是第十三个样本。零计数是有效观测,不是缺失;不得把空值补成零或悄悄删除零计数基因。
每个样本计算总原始计数、零计数基因数、计数大于零的基因数,以及仅检出基因的计数中位数,明确分母。使用准确输入列;MCL1-DG 等短标签只是有映射的显示名称,不是推断出的生物学分组。
3. 检查执行并处理失败
阅读 Python 审批,确认输入文件与输出名称,再允许相应范围的操作。在会话中打开 Notebook,检查完成后的单元及输出,核对维度、原始标签、指标数组和前后校验值;不能只看模型的完成消息。
如果输入 Version ID 无法解析,要求 Agent 使用本会话附件挂载的输入重试。本次通过这一方式继续计算。失败的尝试不能记为完成,也不能悄悄替换成另一个文件。
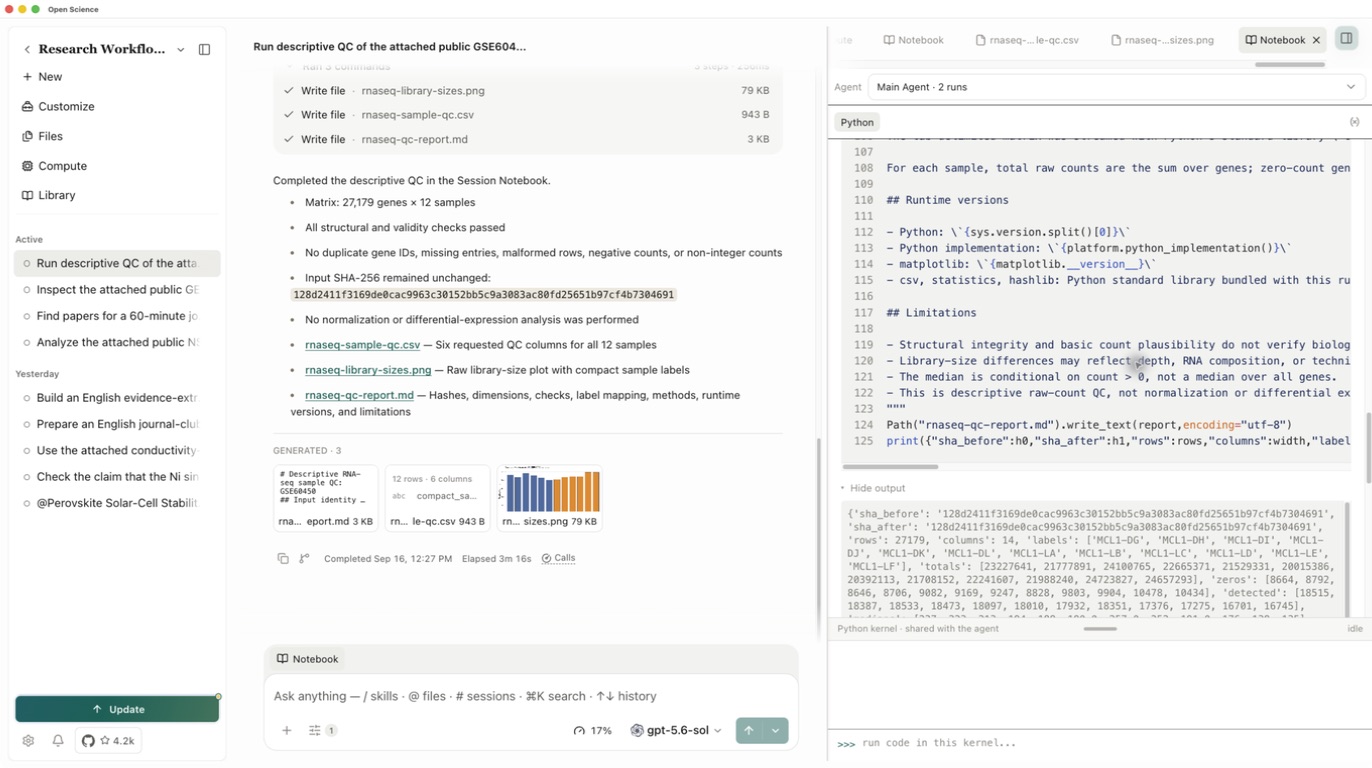
本次重跑检查了 27,179 个基因行、12 个样本列,没有行宽异常、重复 ID、缺失值或无效计数。三个结果均出现在 Generated 中,应逐一打开;只存在于工作目录、尚未保存为产物的文件还不算交付结果。
4. 验收样本表
打开 rnaseq-sample-qc.csv,确认 12 行、6 列,保留完整原列名。下表列出四项指标,下载 CSV 另含原列名映射。
按完整样本标识与基准表逐行比较全部指标。
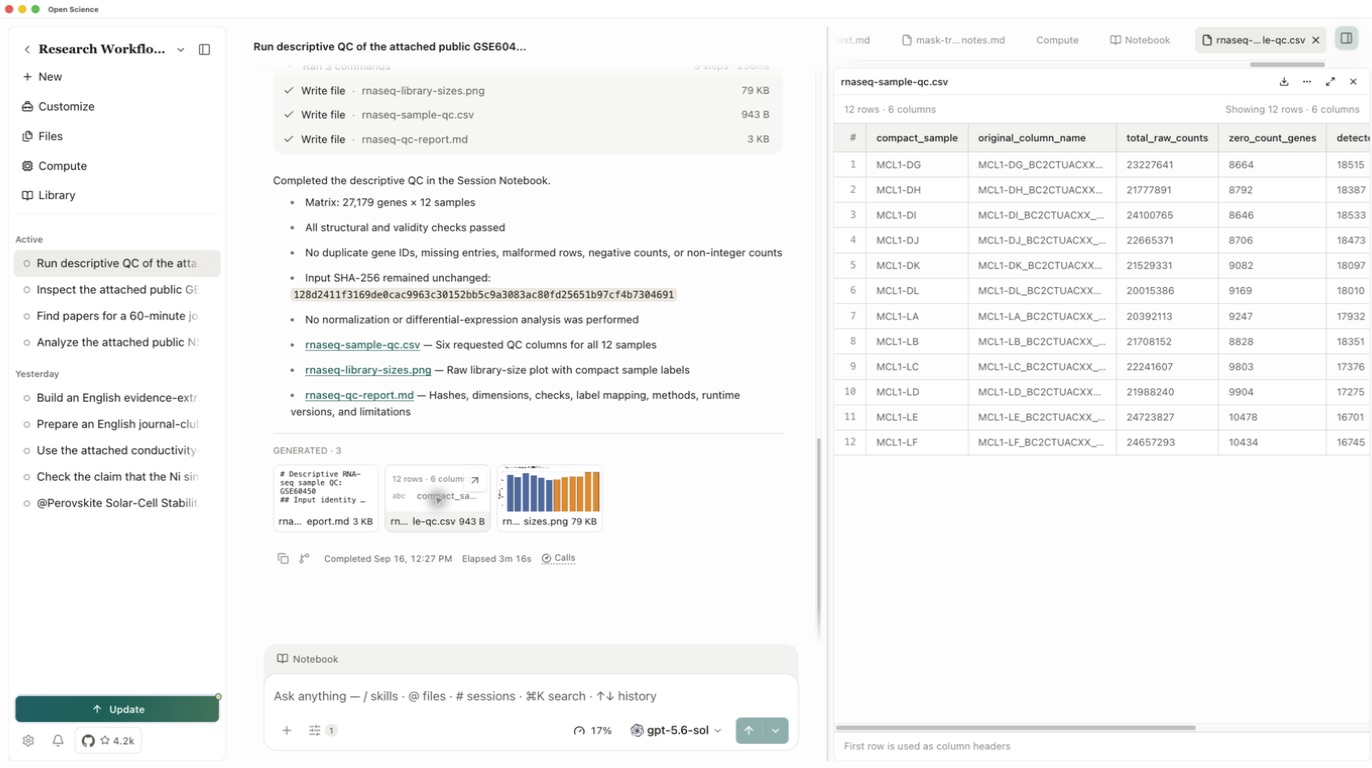
对于本例输入,每行零计数基因数加检出基因数应等于 27,179。将 48 项样本指标与独立基准对照。一致性检查针对该输入的这些计算;下游分析假设仍需另行评估。
5. 阅读图表并控制解释范围
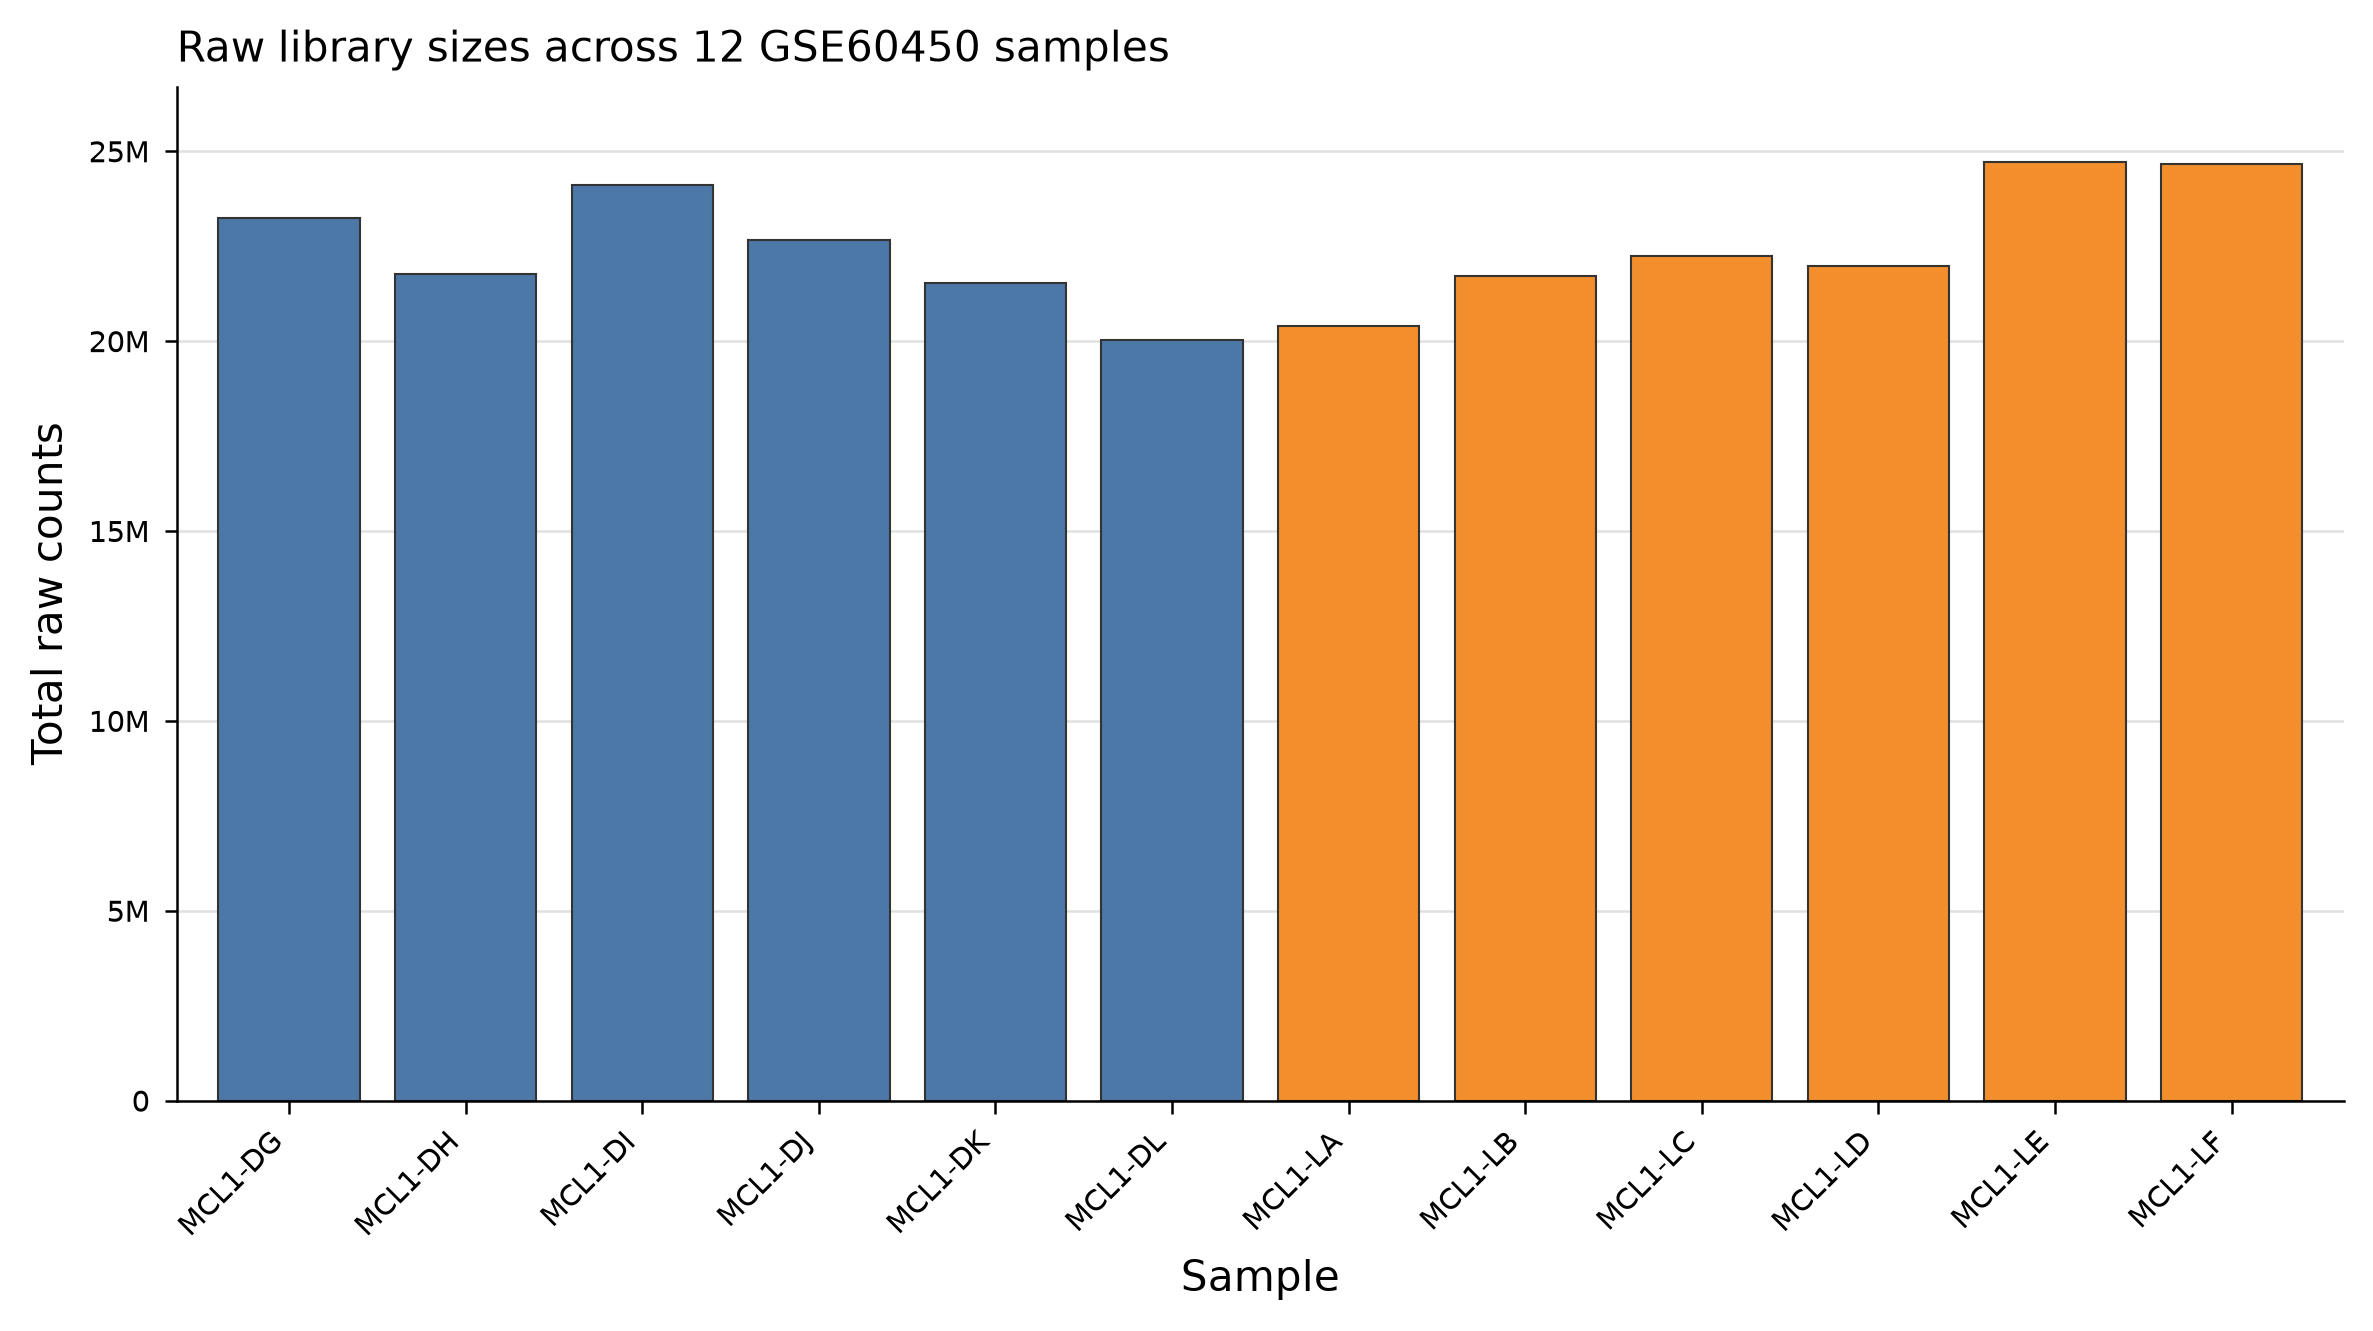
打开并放大 rnaseq-library-sizes.png,核对十二标签、原始计数轴与未归一化说明。矩阵总计数范围为 20,015,386–24,723,827。
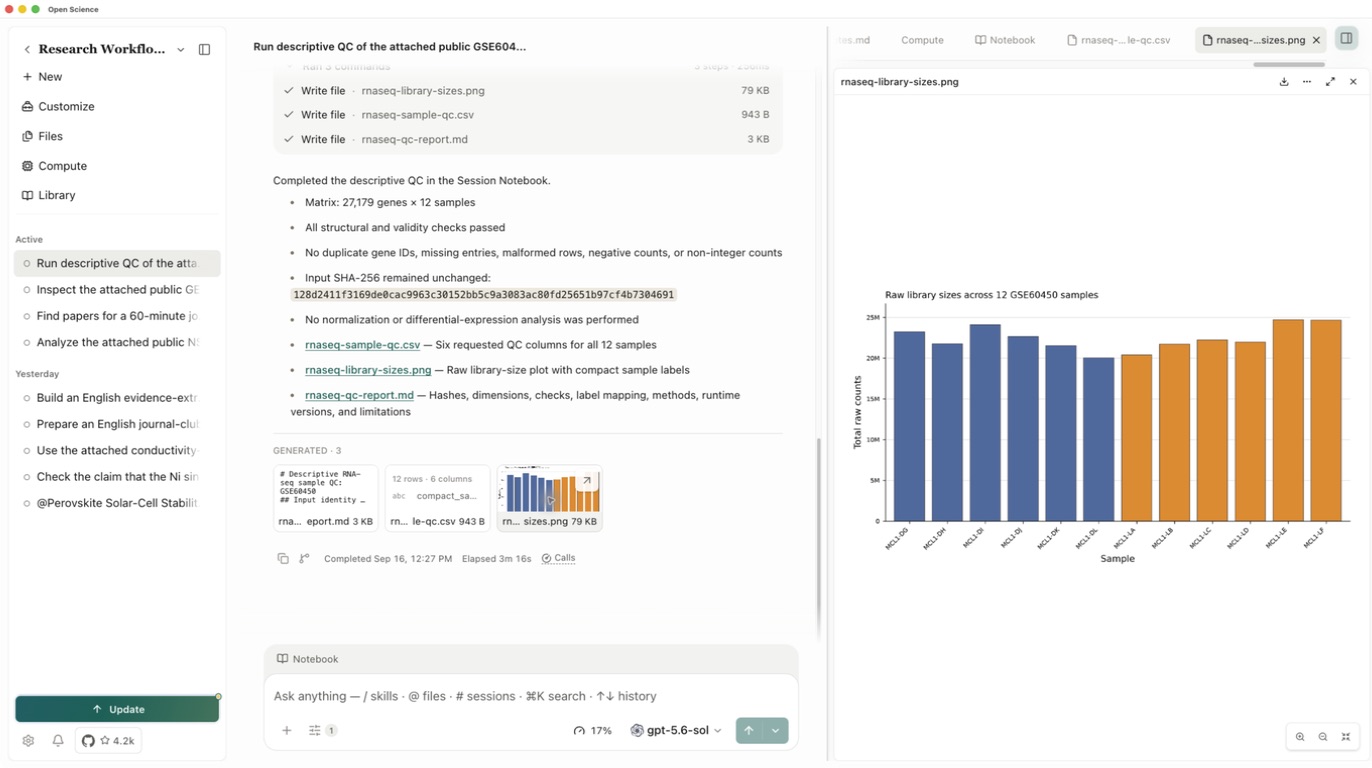
总计数较大不能证明某基因差异表达。继续下游分析前,从 GEO 核对样本特征,明确 GSM 与矩阵列名映射、研究设计、对比、归一化及过滤规则。元数据获取见连接器。
6. 保留方法与证据
保留包含输入校验值、维度、有效性检查、准确标签映射、运行环境和依赖版本、解释限制的报告。比较数值后才补充独立检查结论。保存报告修订版不会重新计算表格和图片。
9 月 16 日的重跑与已独立核对的基准相比,48 项指标全部一致。输入 SHA-256 保持为 128d2411f3169de0cac9963c30152bb5c9a3083ac80fd25651b97cf4b7304691。报告记录 Python 3.12.14 和 matplotlib 3.11.1。这些检查证明本次数值一致、输入未变,不代表已完成 Reviewer 审查或准备好独立复现所需的精确环境。
下载本次重跑的质控表、图表和报告,并保留原始输入及本会话 Notebook。示例数据页另外保留早期基准与 Notebook 导出,它们不是本次重跑的 Notebook。如需独立复现,再按可复现性检查检查环境与重新运行条件。