public dataset로 회귀 결과를 확인합니다.
실습 예제 직업 훈련 후 적립
당신은 작은 경제 데이터 세트가 있고 기본 특성이 포함되어있을 때 결과가 변경되는지 알고 싶습니다. 이 예제는 불완전한 비교와 prespecified 조정 회귀를 실행하고, 견적과 불확실성을 저장합니다.
공급 능력: Notebook 계산, 계수 CSV 및 영어 보고서. jtrain2의 445-observation 실험 샘플을 사용하며, wooldridge data dictionary의 LaLonde의 National Supported Work Analysis에 기반합니다.
데이터 준비 및 첨부
- Rdatasets에서 jtrain2.csv을 다운로드하고 사전의 변수 정의를 읽습니다.
- 프로젝트를 만들고 Python 실행 시간이 활성화되었는지 확인합니다. 이 예제는
pandas및statsmodels을 사용합니다. 필요한 경우 선택한 환경에서 누락된 패키지를 설치합니다. - 대화를 열고, 작업 모델을 선택하고 + → Attach files을 선택하고 CSV을 선택합니다. 첨부 파일을 전송하기 전에 나타납니다.
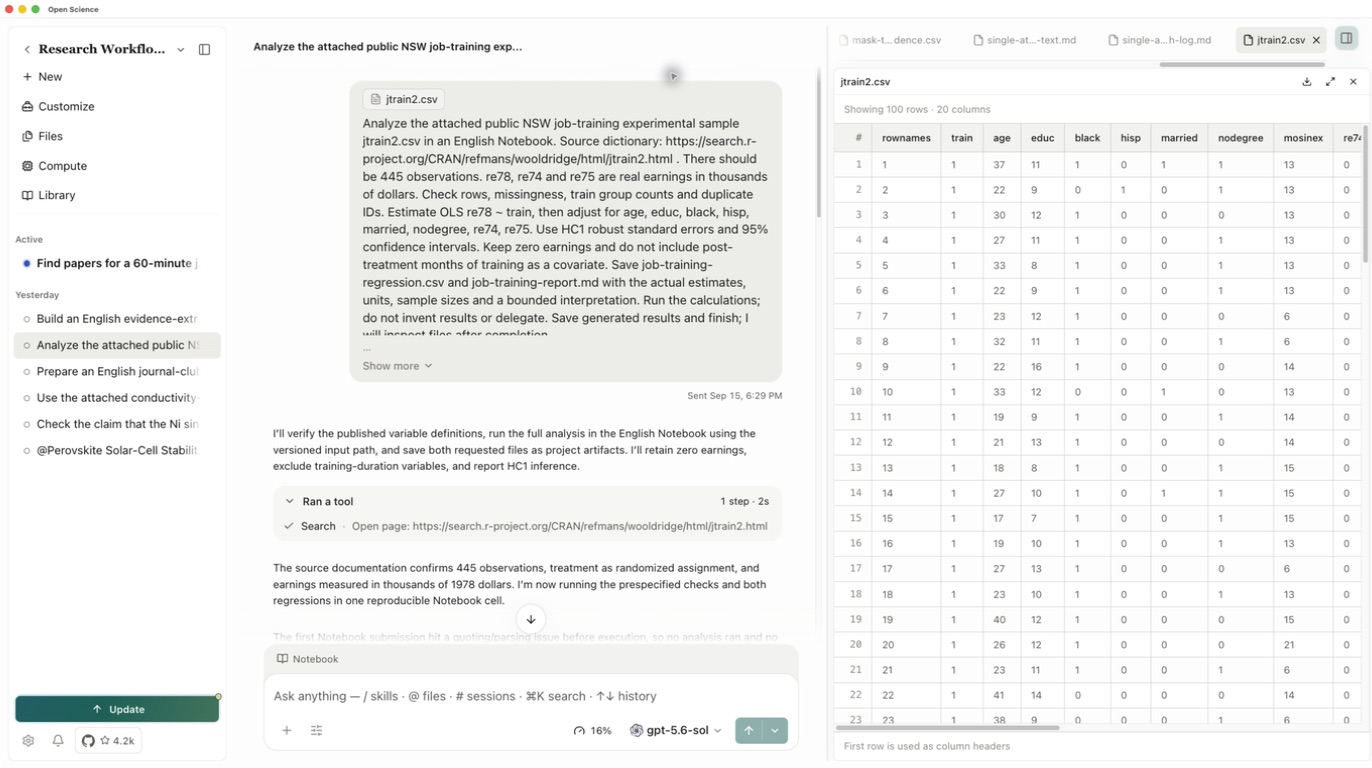
outcome re78 및 기본 변수 re74 및 re75는 천 달러에서 실제 수입입니다. 각각 1978, 1974 및 1975에서 수입을 나타냅니다. Zero Earnings는 유효한 관측입니다. train는 훈련 할당을 식별합니다; mostrn은 훈련의 달을 설명하고 기본 조정 변수가 아닙니다.
지정된 CSV을 클릭하여 계산 요청을 전송하기 전에 미리 볼 수 있습니다. train, re78, re74 및 re75를 확인하여 0의 수입을 가진 행을 포함합니다. 미리보기는 100 행만 보여줄 수 있습니다; Notebook은 전체 파일을 계산해야 합니다.
prespecified 비교를 실행
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
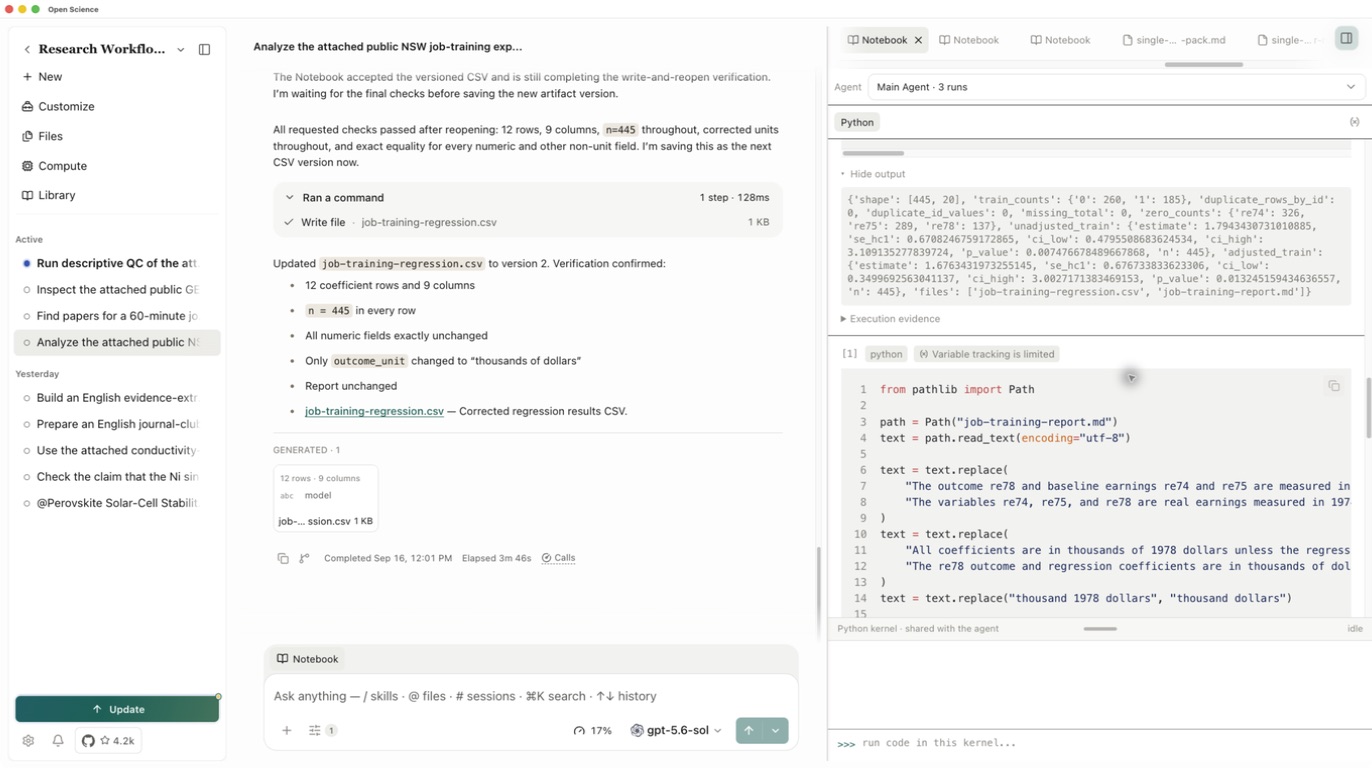
승인이 표시될 때 요청된 코드를 검토합니다. 첨부된 CSV을 읽으려면 두 개의 지정된 모델을 적합하며 출력을 저장해야합니다. 실제 실행 결과를 검사하기 위해 Notebook을 엽니 다. 실행이 실패하면, 계산된 결과로 모든 prose를 치료하기 전에 표시된 오류를 해결합니다.
대화에서 Notebook을 선택하여 실행된 Python 셀을 열고 출력을 검사합니다. 회귀 요약 전에 행과 그룹 카운트를 찾습니다. 첨부된 버전이 해결될 수 없는 경우, 이 대화의 첨부 파일과 재스트에서 첨부된 파일을 읽으려면 에이전트를 요청하십시오. 실패한 세포는 결과가 아닙니다. 성공적인 세포를 유지하고 저장된 파일로 출력합니다.
저장된 결과 검사
445 행, 훈련군 185명, 대조군 260명, 누락된 값 및 중복 행 식별자 없이 완료된 예입니다. 모든 445 관측을 유지한 회귀.
| 모델 | 교육 계수 | HC1 표준 과실 | 95% 신뢰 간격 |
|---|---|---|---|
| 옵션 정보 | 1.794 | 0.671 | 0.480에 3.109 |
| baseline 변수에 대한 조정 | 1.676 | 0.677 | 0.350에 3.003 |
계수 및 간격은 천 달러에 있습니다. 이 예제의 계산의 결과는 원본 용지에서 견적을 인용하지 않습니다.
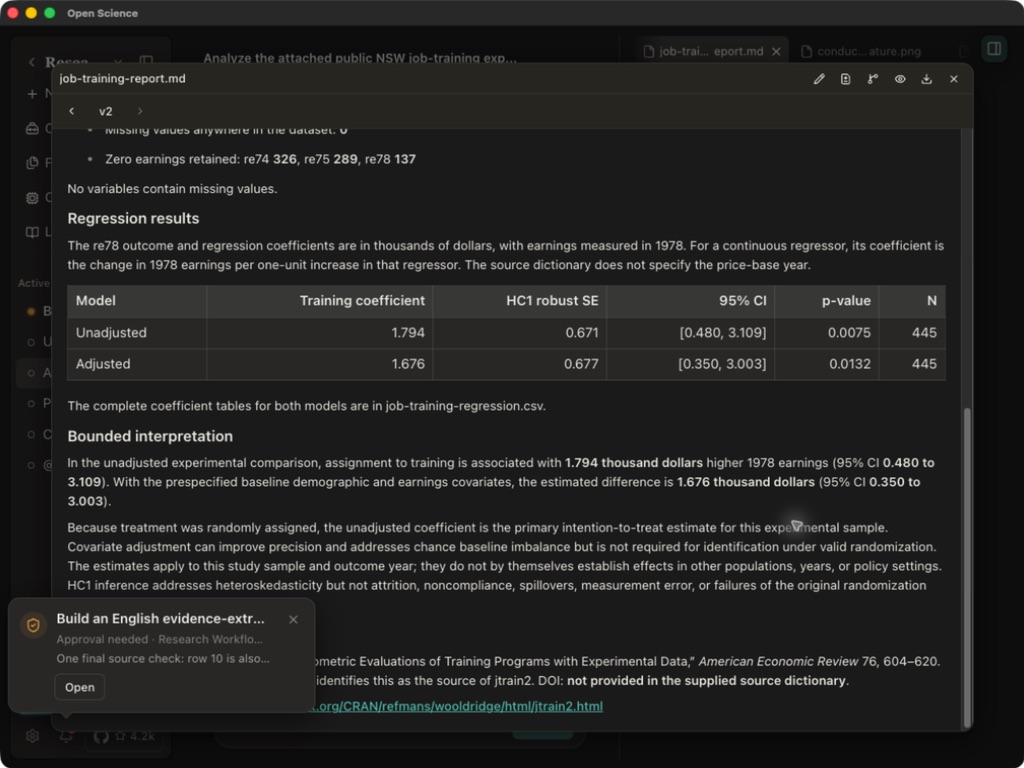
응답이 완료된 후 생성된 파일을 모두 엽니다. CSV의 train 행을 보고서와 Notebook와 비교합니다. 이 실행의 계수 테이블 및 - 연혁을 다운로드 할 수 있습니다.
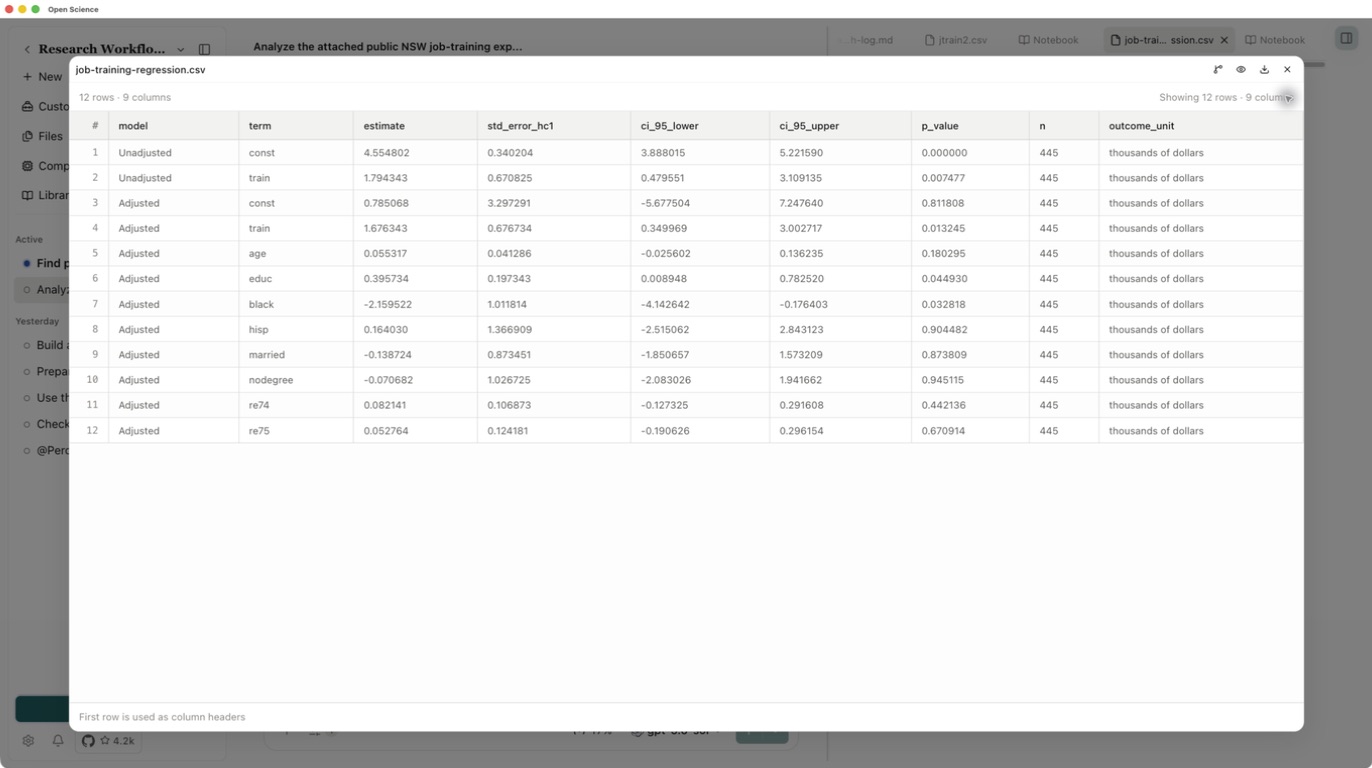
Generated에서 CSV을 열고 미리보기를 확장합니다. 저장된 계수 테이블에는 12 행 · 9 열가 있습니다: 조정한 모형을 위한 2개의 줄 및 조정한 모형을 위한 10. 각 모델의 train 행을 찾아 견적, 견고한 표준 오류, 간격, n 및 단위를 비교하십시오. 소스 사전이 국가가 아닌 inflation base year를 추가하지 마십시오. 미리보기의 Download 버튼을 사용하여 체크된 버전을 유지합니다.
비교 지원이 무엇인지 결정하십시오.
기준선 변수를 조정하면 추정치는 약 1.79천 달러에서 1.68천 달러로 바뀝니다. 이는 두 모형 설정에 대한 민감도 확인입니다. 모든 모형 선택에 대한 강건성이나 다른 집단·연도로의 일반화를 입증하지는 않습니다. HC1 표준오차는 이분산성을 고려하지만 원래 연구 설계의 문제를 해결하지는 않습니다.
colleague에 분석을 손으로, 원래 CSV, 가변 사전, 코드 및 선택된 환경을 유지. Reproducibility 검사을 사용하여 나중에 다시 실행할 수 있는 것을 평가하십시오.