Finden Sie eine Proteinsequenz und vervollständigen Sie eine BLAST-Suche
Praxisbeispiel Finden Sie den überprüften menschlichen Hämoglobin-Alpha-Eintrag und rufen Sie seine Sequenz ab
Beginnen Sie mit dem menschlichen HBA1-Gennamen, holen Sie ein überprüftes UniProt-Protein und seine kanonische FASTA ab, senden Sie dann eine BLAST-Suche und inspizieren Sie den abgeschlossenen Bericht. Dieses Beispiel lehrt Sequenz-Lookup und Vergleich mit einem bekannten Protein.
Folgen Sie vor dem Start Wissenschaftliche Datenbanken, um die erforderlichen Connectors zu aktivieren. Verwenden Sie ein verbundenes Modell und ein verfügbares Notebook-Laufzeit.
1. Finden Sie das Protein und holen Sie seine FASTA
Gene & Ontologien kann UniProt-Einträge entdecken, bevor Sie einen Beitritt kennen. Verwenden Sie search_uniprot_entries mit einem Gennamen, einer Proteinnamensphrase oder einem Organismus. organism_id entspricht dem angegebenen Taxon, während reviewed: true Swiss-Prot und false nicht überprüfte TrEMBL-Einträge auswählt. Lassen Sie reviewed aus, um beides einzuschließen. Folgen Sie next_cursor, ohne die Filter oder die Seitengröße zu ändern, wenn Sie eine Abfrage fortsetzen.
Aktivieren Sie Gene & Ontologien, öffnen Sie eine Sitzung mit einem verbundenen Modell und verfügbarer Notebook-Laufzeit und senden Sie dann:
Use Genes & Ontologies through Session Notebook. Call search_uniprot_entries
with gene HBA1, organism_id 9606, reviewed true and page_size 5.
Save the query and complete response as hba1-uniprot.json. Check the
returned organism and protein identity, then retrieve the canonical FASTA
for the matching accession with get_uniprot_entries. Add that response to
the JSON and save hba1-query.fasta. Keep everything in English. Preserve
missing or empty results; do not invent sequences.
Öffnen Sie den JSON, bevor Sie die FASTA verwenden. Diese Abfrage gab P69905/HBA_HUMAN, Homo sapiens CAS-Nr., 142 Aminosäuren mit Gennamen HBA1 und HBA2 zurück. Die Antwort identifiziert UniProt Release 2026_03, total_results: 1 und has_more: false. Der FASTA-Header bewahrt den Beitritt und den Organismus; die Sequenz 142-Reste enthält. Eine Gen-Namen-Abfrage kann einen Proteineintrag zurückgeben, der mit mehr als einem Gen assoziiert ist, also folgern Sie nicht auf eine Eins-zu-Eins-Zuordnung.
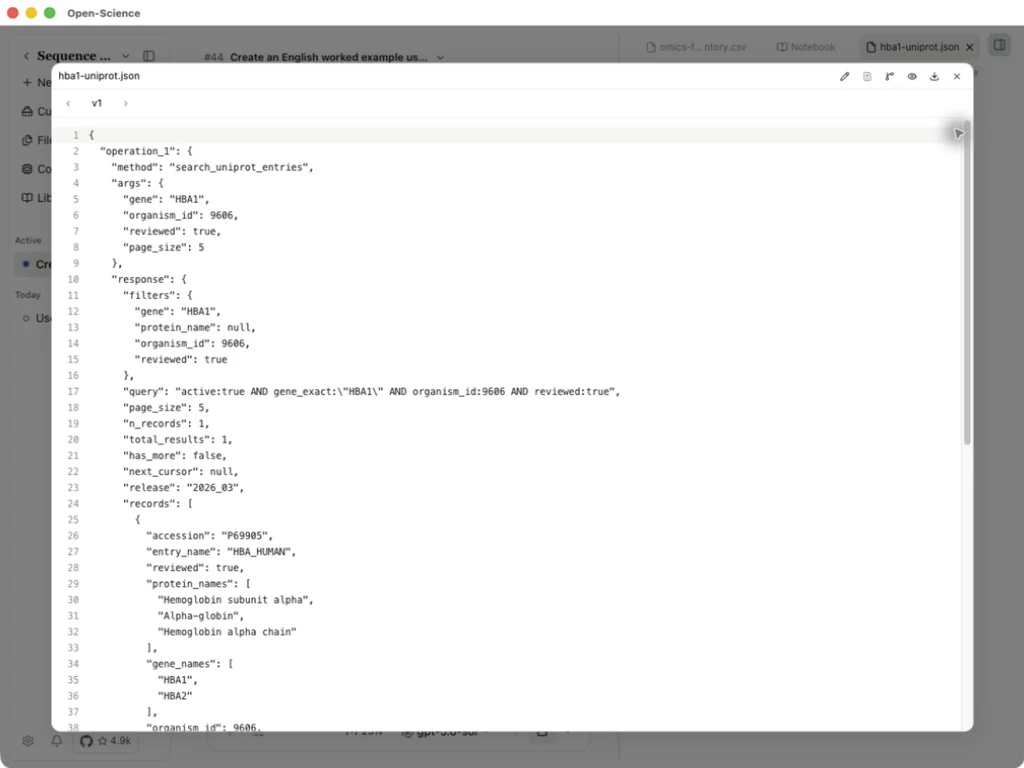
UniProt Abfrage und FASTA Antwort · Kanonische FASTA
2. Senden und folgen Sie dem BLAST Job
Aktivieren Sie für eine Ähnlichkeitssuche Genome und verwenden Sie die drei BLAST-Operationen. Die Sequenz wird an den öffentlichen NCBI-Dienst gesendet; öffentliche oder anderweitig autorisierte Eingaben zu verwenden.
- Rufen Sie
blast_submiteinmal mit der Sequenz, ihremmolecule_typeund einer kompatiblen Datenbank auf. Halten Sie die zurückgegebeneridund Polling-Anleitung. Für das obige Protein wählenmolecule_type: proteinunddatabase: swissproteine Proteinsuche aus. - Rufen Sie
blast_statusfür diese RID an. Anfragen für die gleiche RID müssen mindestens 60 Sekunden auseinander und alle BLAST-Anfragen mindestens 10 Sekunden auseinander sein. Folgen Sie einer längeren Verzögerung, die vom Dienst zurückgegeben wird.WAITINGbedeutet, dass der Job noch in der Warteschlange steht oder läuft; Behalten Sie seine RID, anstatt erneut einzureichen. - Respektieren Sie nach
READYdas gleiche Intervall vorblast_results. Verfügbare Formate sindjson2,xml2,textundtabular. Berichte sind an 2 MiB gebunden; Wenn nötig, weniger Treffer anfordern. Die tabellarische Ausgabe kann Kommentare enthalten und ist nicht automatisch eine CSV-Tabelle. - Prüfen Sie Abfragelänge, effektive Datenbank, übereinstimmende Zugriffe, Alignment-Spanne, Identität und E-Wert im eigentlichen Bericht. Sequenzähnlichkeit allein stellt keine Funktion her. Eine bekannte Hämoglobin-Sequenz ist nützlich, um die Kontrollen zu lernen, und zeigt nicht die Entdeckung eines unbekannten Proteins.
Wenn die Einreichung blast_submission_unknown zurückgibt, ist ihre Annahme unsicher: Nicht automatisch erneut senden. Bewahren Sie die Antwort und jede RID. Behandeln Sie niemals einen Einreichungsbeleg oder den WAITING-Status als abgeschlossene Anpassung. Genaue Ein- und Rückgabebedingungen sind im BLASSEN-Referenz.
3. Öffnen und Interpretieren des abgeschlossenen Berichts
Setzen Sie das gleiche Proteinbeispiel in der obigen Sitzung fort. Bewahren Sie den Einreichungsbeleg auf, damit eine spätere Anfrage den gleichen Job wieder aufnehmen kann. Senden:
Continue with the public P69905 FASTA retrieved above. Use Genomes through
Session Notebook. If this session already has a BLAST RID, resume that RID;
otherwise call blast_submit once with molecule_type protein, database
swissprot and hitlist_size 5, then save the receipt. Space requests for the
same RID by at least 60 seconds and follow any longer server delay. Check
blast_status; if it is still WAITING, keep the RID for a later check rather
than submitting again. After READY, wait the required interval and retrieve
blast_results in json2 format. Save hba1-blast-raw.json, hba1-blast-hits.csv
and hba1-blast-results.md. Include the actual database, query length,
accessions, alignment coordinates, identity counts and E-values. Explain
the coverage and identity calculations. Keep everything in English and
preserve actual errors or empty results. Never invent alignments.
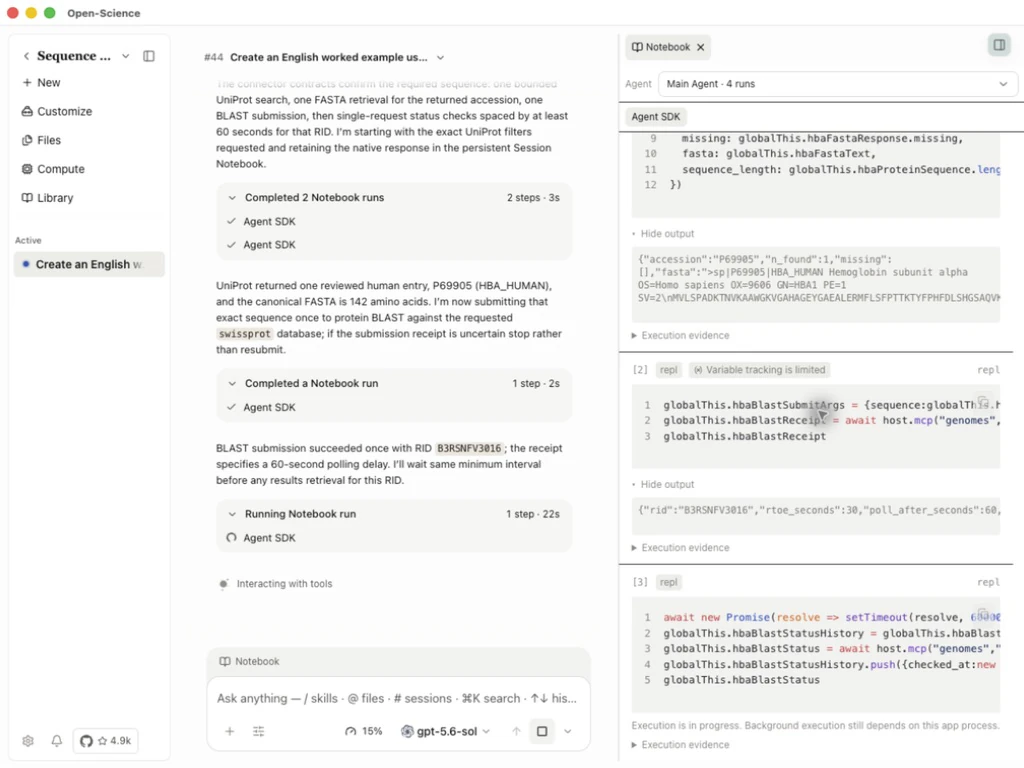
Nachdem der Bericht fertig ist, öffnen Sie hba1-blast-results.md und vergleichen Sie die Tabelle mit hba1-blast-raw.json. In diesem Beispiel wurde BILD 2.17.0+ verwendet, wobei Swissprot durch den Bericht bestätigt wurde, eine 142-Aminosäure-Abfrage und 5 Treffer:
| Beitritt | Identische Rückstände/Ausrichtungslänge | Abfrageabdeckung | E-Wert |
|---|---|---|---|
| P69905 | 142/142 (100%) | 100% | 1.99033e-100 |
| P01923 | 140/141 (99.29%) | 99.30% | 1.06845e-98 |
| Q9TS35 | 140/142 (98.59%) | 100% | 2.38346e-98 |
| P06635 | 139/142 (97.89%) | 100% | 3,57742e-98 |
| P01924 | 138/141 (97.87%) | 99.30% | 3.00466e-97 |
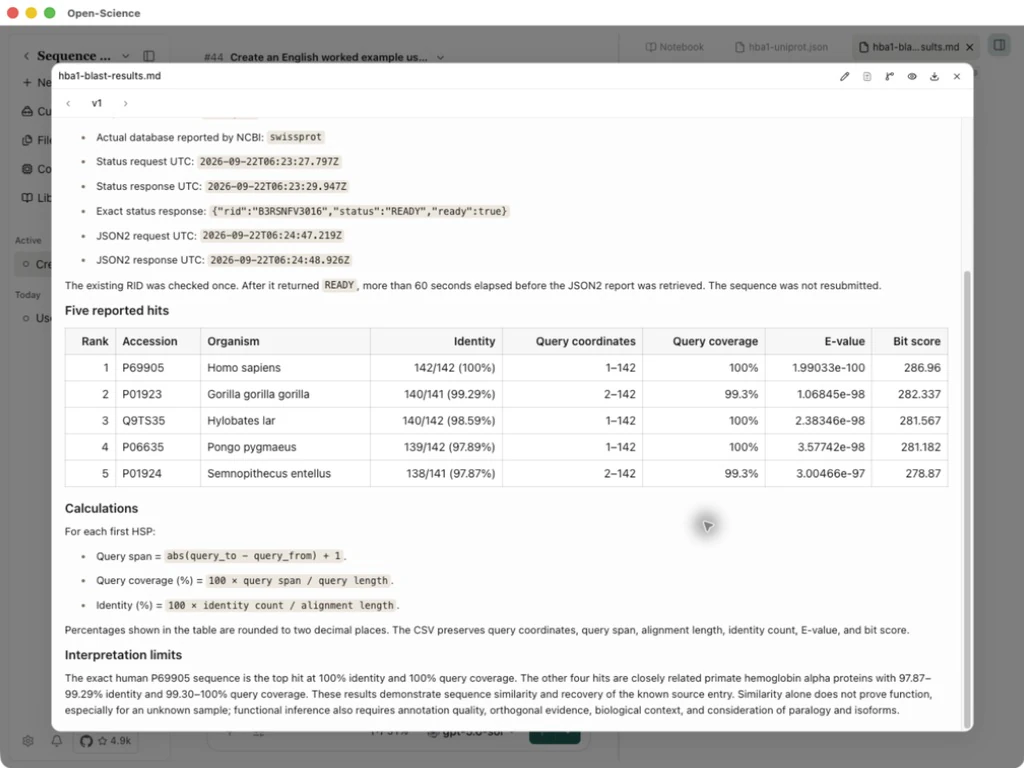
Für jeden ersten HSP ist Identität die Restzahl mit identischer Restzahl geteilt durch die Ausrichtungslänge. Die Abfrageabdeckung ist die inklusive Abfrage-Koordinatenspanne geteilt durch 142. Für P01923 ist die Abfragespanne 2–142: Abdeckung ist 141/142 = 99.30%, während Identität 140/141 = 99.29% ist. Die beiden Prozentsätze beantworten unterschiedliche Fragen; auch nicht die Wahrscheinlichkeit, dass eine Funktionszuordnung korrekt ist.
Abgeschlossener Bericht · Fünf-Hit-Tabelle · Bericht NCBI JSON2
Der Top-Hit P69905 ist die Eingabesequenz selbst, so dass seine 100% Identität und Abdeckung eine bekannte Sequenzprüfung bieten. Die anderen Treffer zeigen ähnliche Sequenzen, keine neue funktionelle Entdeckung. Bewahren Sie den Rohbericht und die Abfrage mit der Ergebnistabelle auf; Eine spätere Datenbankfreigabe kann die Trefferliste ändern.
Um drei oder mehr bekannte Sequenzen zu vergleichen, fahren Sie mit Ausrichtung mehrerer Sequenzen und konservierte Positionen fort.
Überprüfen Sie eine Proteindomäne mit HMMER
Praxisbeispiel Scannen Sie den menschlichen P69905 gegen Pfam
Nach dem Abrufen der kanonischen P69905-Proteinsequenz aktivieren Sie HMMER für Main in Settings → Connectors. Fragen Sie im selben Gespräch:
Use the HMMER Connector to scan the same human P69905 sequence against
Pfam with hmmscan. Keep the job ID, retrieve the completed domain
annotations, and save the raw result and a concise English interpretation
with coordinates and significance values. Preserve an unavailable
result as unavailable.
- Überprüfen Sie die Job-ID der Einreichung und folgen Sie dann Statusstatus für denselben Job.
- Fordern Sie Ergebnisse nach Abschluss an und speichern Sie die Rohantwort. Überprüfen Sie
readyund den Status des Ergebnisses, bevor Sie seine Treffer interpretieren. - Überprüfen Sie den Familienzugang, die Abfragekoordinaten, die E-Werte und die Einschlussflags jedes Treffers. Ein gemeldetes Fragment ist nicht unbedingt eine signifikante Domäne.
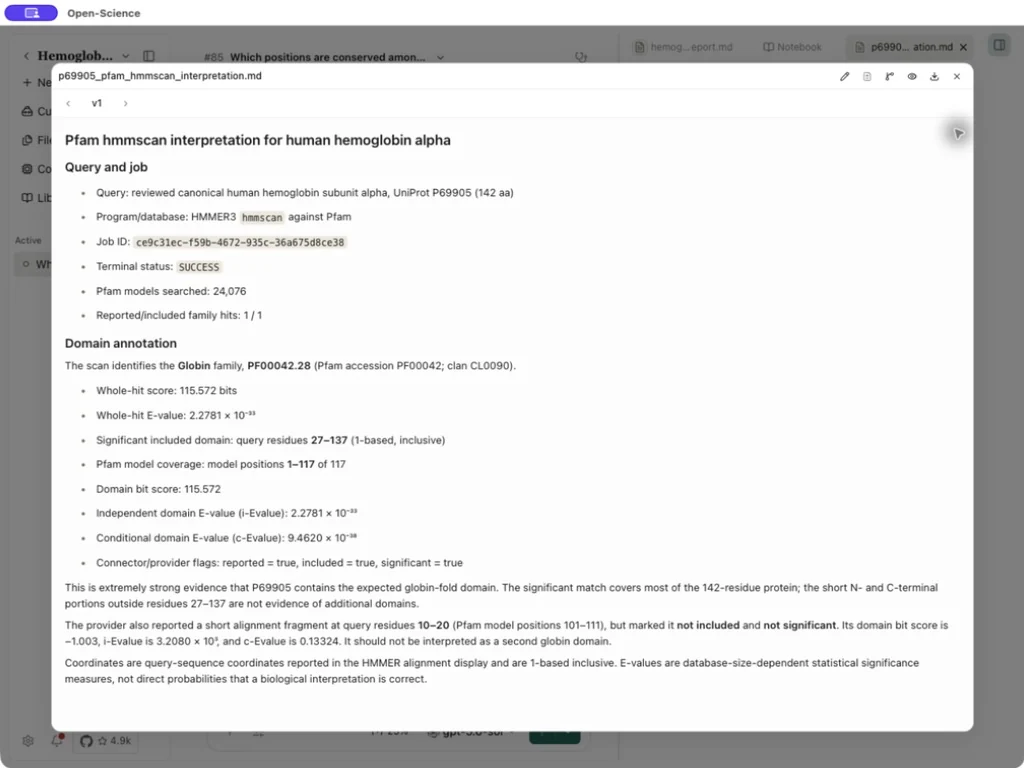
Dieser Lauf gab Globin · PF00042.28 zurück, mit einer enthaltenen Domäne bei den Abfrageresten 27–137 (1-basiert, inklusive), 115.572 Bits und dem unabhängigen Domänen-E-Wert 2.2781 × 10⁻³³. Das kurze Fragment an 10–20 war nicht enthalten und war nicht signifikant; Es ist kein Beweis für eine zweite Domain. Diese Koordinaten beziehen sich auf die eingereichte kanonische Sequenz, nicht auf ein Nummernschema für reife Proteine. E-Werte hängen vom Suchraum ab und messen nicht direkt die Wahrscheinlichkeit, dass eine biologische Interpretation korrekt ist.
Rohe HMMER Antwort · Domäneninterpretation
HMMER-Eingaben hängen vom ausgewählten Programm ab. Das Beispiel verwendet eine Proteinsequenz mit hmmscan; Siehe Betriebsnummer für andere Programme. InterProScan kann eine Proteinsequenz einreichen, den Job überprüfen und TSV-Annotationen abrufen. Konfigurieren Sie seine Kontakt-E-Mail und folgen Sie dem Einreichungsschritte; Die Ergebnisse der Mitgliederdatenbank sind von diesem HMMER-Beispiel getrennt.