Laufen funktionelle Anreicherung für einen Kandidaten-Gen-Set
Praxisbeispiel Eine absichtlich ausgewählte menschliche DNA-Schäden-Genliste
Verwandeln Sie eine definierte Genliste in eine Tabelle mit angereicherten biologischen Prozessen und Signalwegen, wobei Sie Identifikator-Mappings, statistischen Hintergrund und Quellversionen beibehalten.
Folgen Sie vor dem Start Wissenschaftliche Datenbanken, um die erforderlichen Connectors zu aktivieren. Verwenden Sie ein verbundenes Modell und ein verfügbares Notebook-Laufzeit.
Dieses v0.31.1-Beispiel verwendet 11 öffentliche Gensymbole, um g:Profiler zu demonstrieren. Sie wurden aufgrund ihrer bekannten biologischen Rollen ausgewählt, so dass eine Anreicherung erwartet wird. Sie sind keine Differenzausdrucksergebnisse aus dem GSE60450-Projekt oder Beweise für eine unvoreingenommene Entdeckung.
1. Definieren Sie die Genliste und Analyseeinstellungen
- Machen Sie in Settings → Connectors Gene & Ontologien für den Agenten verfügbar. Öffnen Sie eine Sitzung mit einem verbundenen Modell und einer verfügbaren Notebook Laufzeit.
- Geben Sie den Organismus, die Genidentifikatoren, die Datenquellen und den statistischen Hintergrund an. Für reale experimentelle Daten ist der Hintergrund anhand von Genen zu begründen, die durch das Experiment hätten ausgewählt werden können. Dieses Tutorial verwendet explizit alle annotierten Gene, nicht ein benutzerdefiniertes Messgen-Universum.
- Senden Sie die folgende Aufforderung. Behalten Sie die Quellversionsabfrage und den Anreicherungsaufruf in derselben Sitzung und speichern Sie ihre tatsächlichen Ergebnisse.
Use Genes & Ontologies through Session Notebook for an English g:Profiler
tutorial. The deliberately selected gene list is TP53, ATM, ATR, CHEK1,
CHEK2, BRCA1, BRCA2, RAD51, CDKN1A, GADD45A, MDM2.
First call list_enrichment_sources with organism hsapiens.
Then call enrich_gene_set with these genes, organism hsapiens,
sources GO:BP and REAC, domain_scope annotated,
correction_method fdr, and user_threshold 0.05.
Save the full response as dna-damage-enrichment.json, all returned terms
as dna-damage-enrichment.csv, and query, source versions, mappings,
background and limitations as dna-damage-enrichment-notes.md.
Retain unmapped, ambiguous and duplicate identifiers. Treat mapped_genes
as the returned mapping object. Report errors instead of inventing results.
This is not differential-expression evidence or evidence of regulation direction.
2. Prüfkennungen und Quellversionen
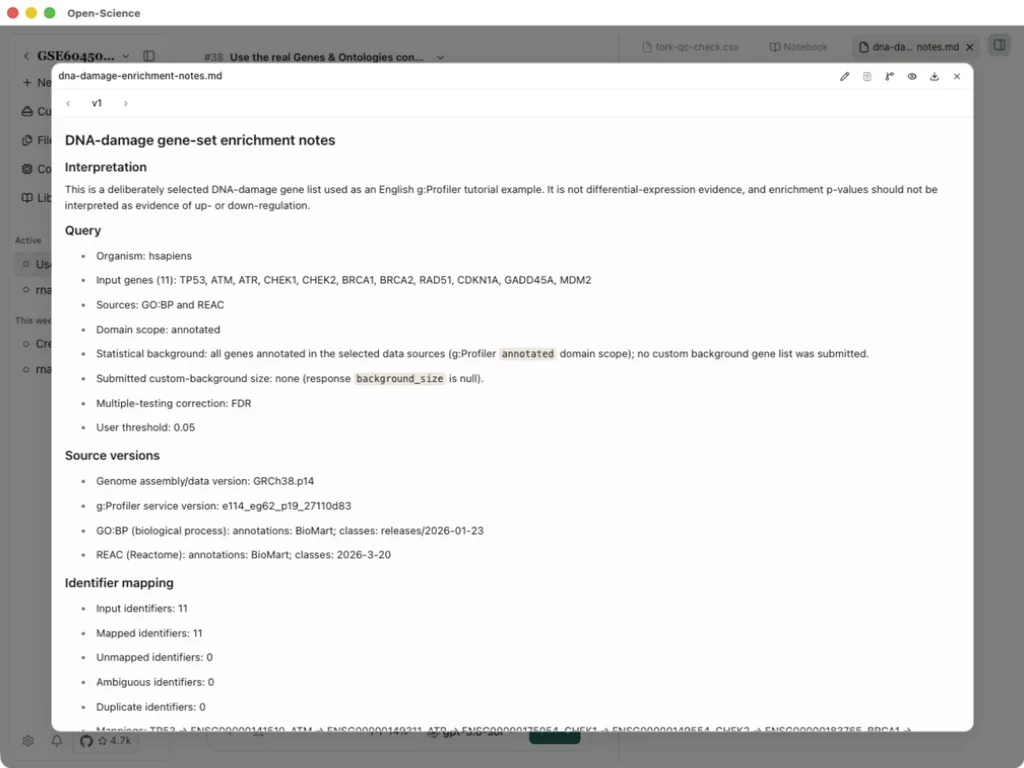
Öffnen Sie die generierten Notizen und überprüfen Sie die Abfrage- und Zuordnungszählung. Dieser Lauf kartierte 11/11-Identifikatoren mit 0 nicht zugeordneten, mehrdeutigen oder doppelten Identifikatoren. Es aufgezeichnet GRCh38.p14, g:Profiler e114_eg62_p19_27110d83, GO Klassen 2026-01-23 und Reactome Klassen 2026-03-20. Eine spätere Serviceversion kann andere Bedingungen zurückgeben.
3. Die Anreicherungstabelle prüfen
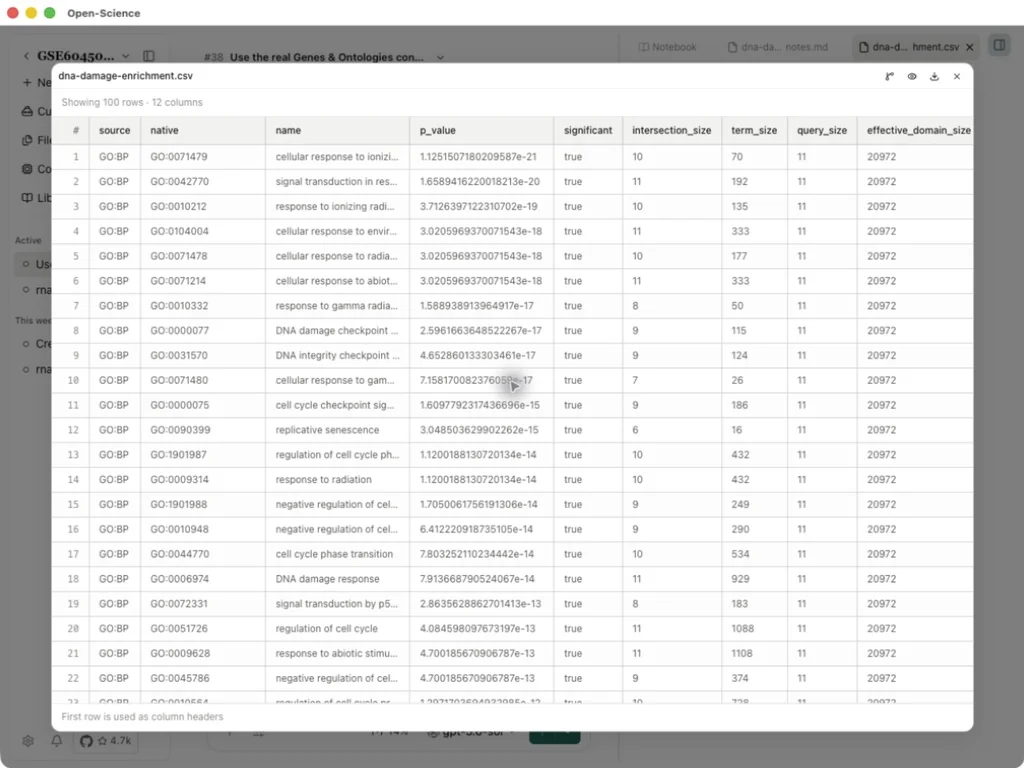
Öffnen Sie den CSV und vergleichen Sie ihn mit dem vollständigen JSON. Dieser Lauf gab 891 Begriffe am FDR 0.05 zurück. Die Vorschau zeigt nur die ersten 100-Zeilen; Das Anzeigelimit ist nicht die Gesamtergebniszählung. Behalten Sie source, native, korrigiert p_value, intersection_size, query_size und effective_domain_size bei der Interpretation eines Begriffs.
Analysenotizen · Alle 891 Ergebniszeilen · Vollständige Antwort
background_size: null bedeutet, dass keine benutzerdefinierte Hintergrundliste eingereicht wurde; Es bedeutet nicht ein statistisches Universum von null Genen. Verwenden Sie die pro-term effektive Domaingröße. Bei der Bereicherung wird keine kausale Beteiligung, kein differentieller Ausdruck oder eine Auf/Ab-Regulierung festgestellt. Siehe Betriebsparameter.