Finden Sie Public Omics-Daten und erstellen Sie ein Dateiinventar
Beginnen Sie mit einem bekannten Beitritt oder einem Forschungsthema, prüfen Sie öffentlich betriebene Metadaten und speichern Sie ein Dateiinventar mit Quellstandorten und verfügbaren Prüfsummen. Die nachstehenden Beispiele ergeben Lagerbestände; Das Herunterladen und Analysieren der Daten sind separate Aufgaben.
Folgen Sie vor dem Start Wissenschaftliche Datenbanken, um die erforderlichen Connectors zu aktivieren. Verwenden Sie ein verbundenes Modell und ein verfügbares Notebook-Laufzeit.
1. Beheben Sie einen bekannten Lauf und inspizieren Sie dessen Dateien
- aus. unter Settings → Connectors aktivieren. Geben Sie einen öffentlichen ENA/INSDC-Beitritt an
ena_search_runs, z. B. eine PRJ-Studie oder einen SRR-Durchlauf. Eine GEOGSE-Kennung muss zuerst mit ihrer INSDC-Studie verknüpft werden; Keywords werden nicht akzeptiert. - Untersuchen Sie
run_accession, Organismus, Bibliotheksstrategie/Layout undtruncated. Das Maximum ist 1,000 läuft. Es gibt kein Offset- oder Continuation-Token; den Beitritt zu verengen, wenn die Antwort verkürzt wird. - Übergeben Sie einen zurückgegebenen Lauf an
ena_get_run_files. Überprüfen Siefound,fastq_availableund jeden Eintrag infastq_files. Das Inventar liefert URL, komprimierte Dateigröße und vorgelagerte MD5; Es werden keine Dateien heruntergeladen oder deren Inhalt überprüft. - Vor einem separaten Download überprüfen Sie die Speicherung und behalten das Manifest auf. Überprüfen Sie die heruntergeladenen Bytes mit der aufgeführten Prüfsumme. Eine gepaarte Bibliothek muss nicht genau zwei Dateien haben; keine Read-Mate-Identität aus
file_indexableiten.
Praxisbeispiel Erstellen Sie ein Dateimanifest für SRR037073
Dieses v0.31.1-Beispiel verwendet Codex subscription und das aktivierte aus. Connector. Öffnen Sie eine Sitzung mit einer verfügbaren Notebook-Laufzeit und senden Sie dann:
Use Omics Archives through Session Notebook. Load its connector instructions.
Call ena_search_runs with accession SRR037073 and limit 10, then
ena_get_run_files with run_accession SRR037073. Do not download FASTQ files.
Save the complete responses as ena-run.json and ena-files.json.
Save every returned file entry as ena-fastq-manifest.csv with columns
file_index,url,size_bytes,md5. Save ena-run-notes.md with the exact inputs,
run identity, completeness flags and download limits. Keep everything in
English. Report actual errors or empty results; do not invent data.
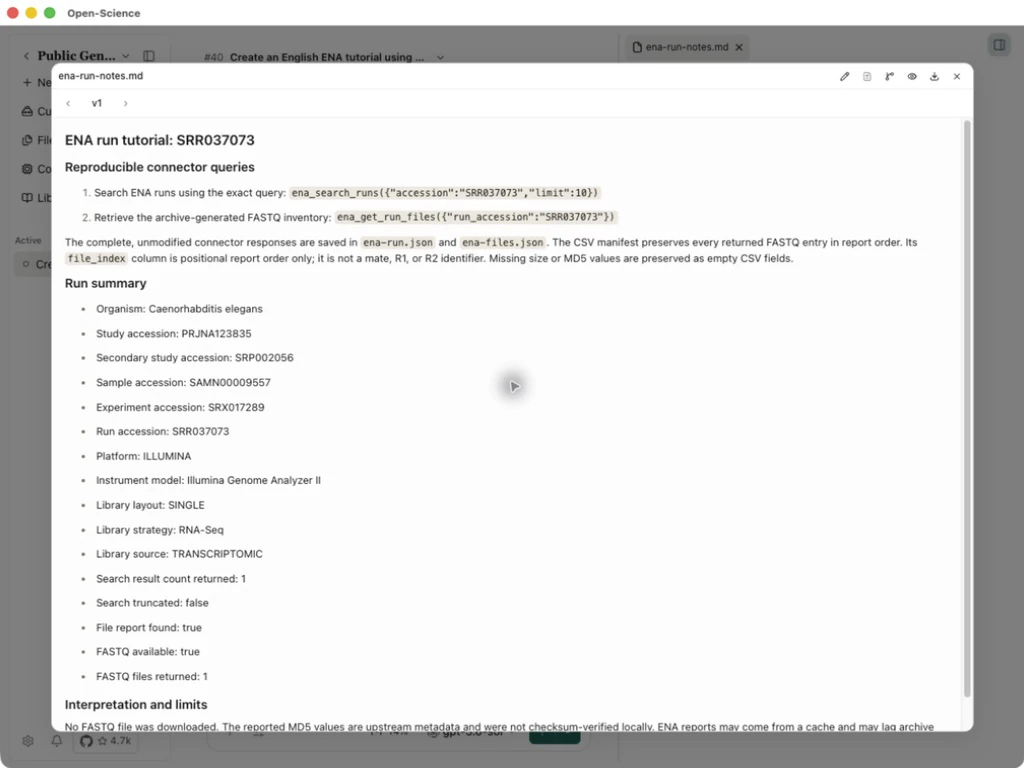
Öffnen Sie die generierten Notizen. Die eigentliche Suche lieferte 1-Lauf, Caenorhabditis elegans CAS-Nr., Studie PRJNA123835, RNA-Seq, SINGLE, mit truncated: false. Bestätigen Sie den Organismus und das Layout, bevor Sie seine Dateien verwenden.
Öffnen Sie den CSV und vergleichen Sie ihn mit ena-files.json. Dieser Lauf hat found: true, fastq_available: true und 1-Datei, Größe 25,154,397 Bytes. Das Manifest behält seine FTP-URL und Upstream-MD5 bei. Kopieren Sie den vollständigen Wert aus der herunterladbaren Datei, wenn eine Vorschauspalte beschnitten ist.
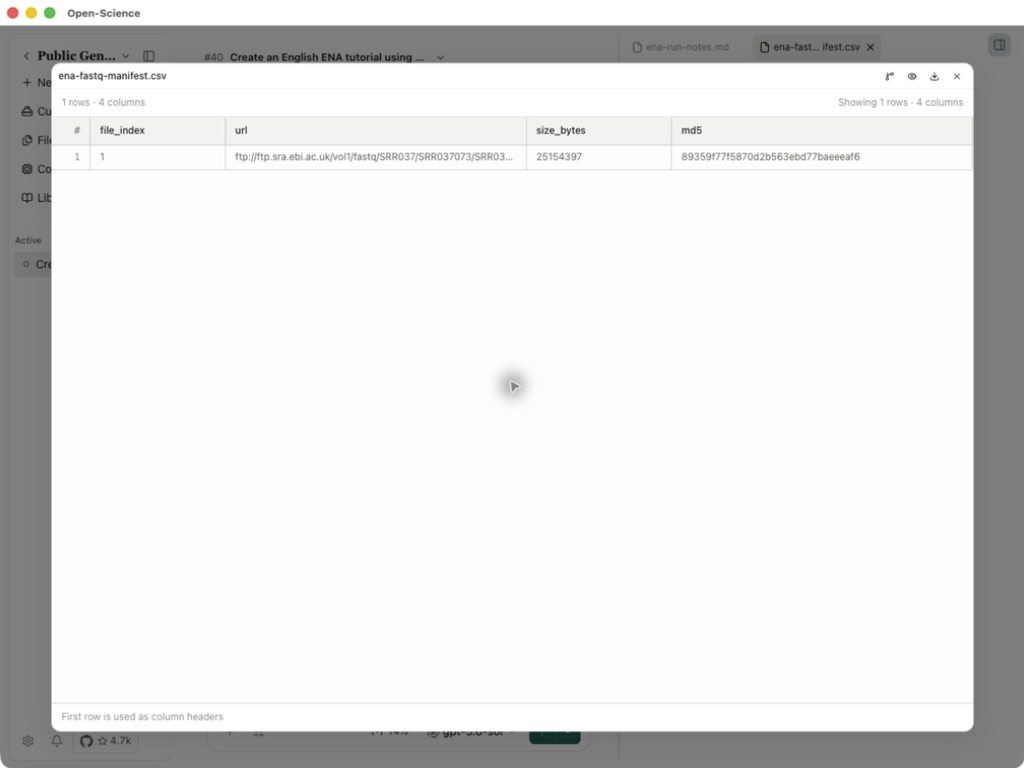
Abfragenotizen · FASTQ-Manifest · Laufendes Verhalten · Dateiantwort
Beide Abfragen und die Erstellung der Dateiliste waren erfolgreich. Keine FASTQ-Datei wurde heruntergeladen oder Checksum-verifiziert. Der Download ist ein eigener Schritt. Genaue Parameter
2. Entdecken Sie Runs nach Themen und inspizieren Sie Projektdateien
Verwenden Sie ena_query_runs, wenn Sie ein Forschungsthema, aber keinen Beitritt haben. Es kombiniert organismus, bibliotheksstrategie und keyword-filter mit and. Mindestens ein Filter ist erforderlich; tax_id enthält absteigende Taxa. Das Standardlimit ist 100 und das Maximum ist 1,000. Eine verkürzte Antwort hat keinen Fortsetzungs-Cursor: Verengen Sie die Abfrage, anstatt die zurückgegebene Anzahl als Gesamtdatensatz zu behandeln.
Praxisbeispiel Entdecken Sie fünf menschliche RNA-Seq-Läufe und inspizieren Sie ein ENA- und ein PRIDE-Dateiinventar
- Aktivieren Sie aus. in Settings → Connectors und öffnen Sie dann eine Sitzung mit einem verbundenen Modell und einer verfügbaren Notebook-Laufzeit. In diesem Beispiel wird Codex subscription verwendet.
- Verwenden Sie die folgende Eingabeaufforderung, um nur Metadaten anzufordern. Das ENA-Abfrage- und PRIDE-Projekt sind separate Beispiele; es handelt sich nicht um übereinstimmende Proben aus einer Studie.
- Öffne
ena-discovery.jsonund inspiziere die Abfrage, den Organismus, die Run-Zugänge undtruncated, bevor du Dateien auswählst.
Use Omics Archives through Session Notebook. Query ena_query_runs with
tax_id 9606, library_strategy "RNA-Seq", keyword "breast" and limit 5.
For the first returned run, call both ena_get_run_files and
ena_get_submitted_files. Separately call pride_get_project_files for
PXD000001, page 0, page_size 5; fetch its next_page once if present.
Save the exact requests and responses as ena-discovery.json,
ena-file-inventory.json and pride-file-pages.json. Save a combined
omics-file-inventory.csv and omics-discovery-notes.md. Keep generated
FASTQ, original submitted files and PRIDE records distinct. Preserve
every supplied location, size and checksum; do not infer missing values
or checksum algorithms. State query limits and pagination. Do not download
data files. Keep everything in English and report actual empty results.
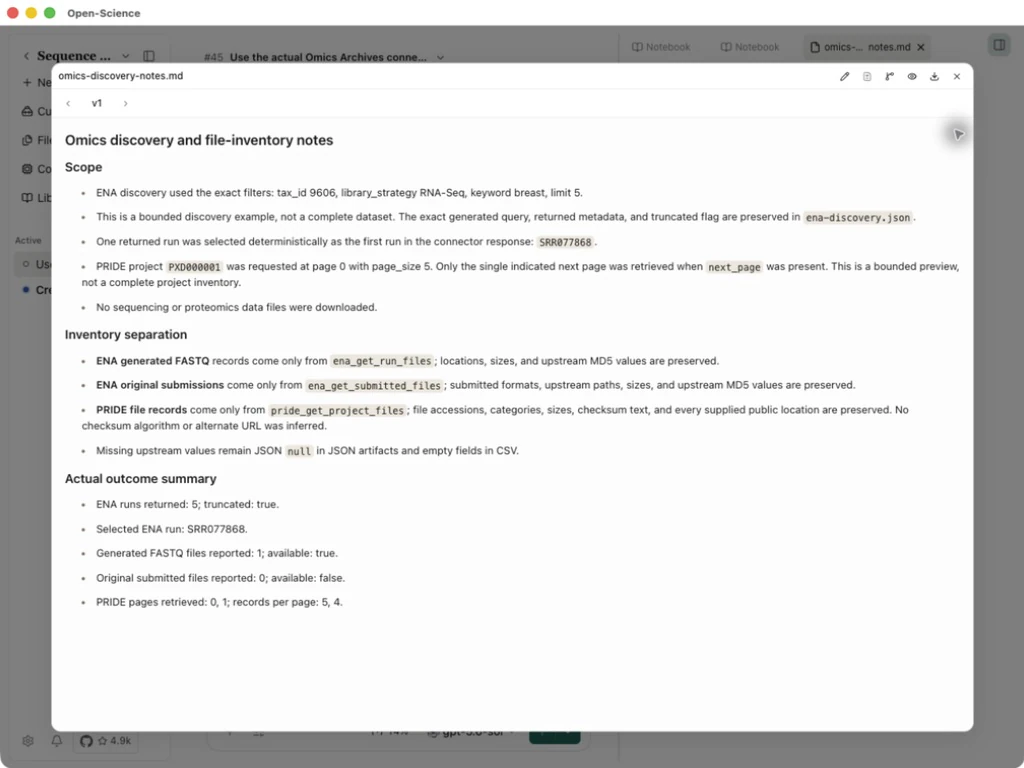
- Vergleichen Sie beide Inventare für den ausgewählten ENA-Lauf. In diesem Beispiel gibt die Abfrage 5 läuft mit
truncated: truezurück. Der erste Durchlauf, SRR077868, hat 1 Archiv FASTQ, 462,508,712 Bytes und einen vorgelagerten MD5. Das Original-Einreichungsinventar hatfound: true, abersubmitted_available: falseund 0 Dateien. Ein bestehender Durchlauf muss daher nicht beide Inventare liefern. - Überprüfen Sie die Pride Seiten. PXD000001 gibt 5-Datensätze auf Seite 0 und 4 auf Seite 1 zurück, mit
api_total: 9und dem letztennext_page: null. Die kombinierte CSV hat 19-Zeilen, weil jede der neun PRIDE-Dateien zwei Standorte neben der einen ENA FASTQ-Zeile liefert. Zählen Sie Dateizugänge getrennt von Download-Standorten.
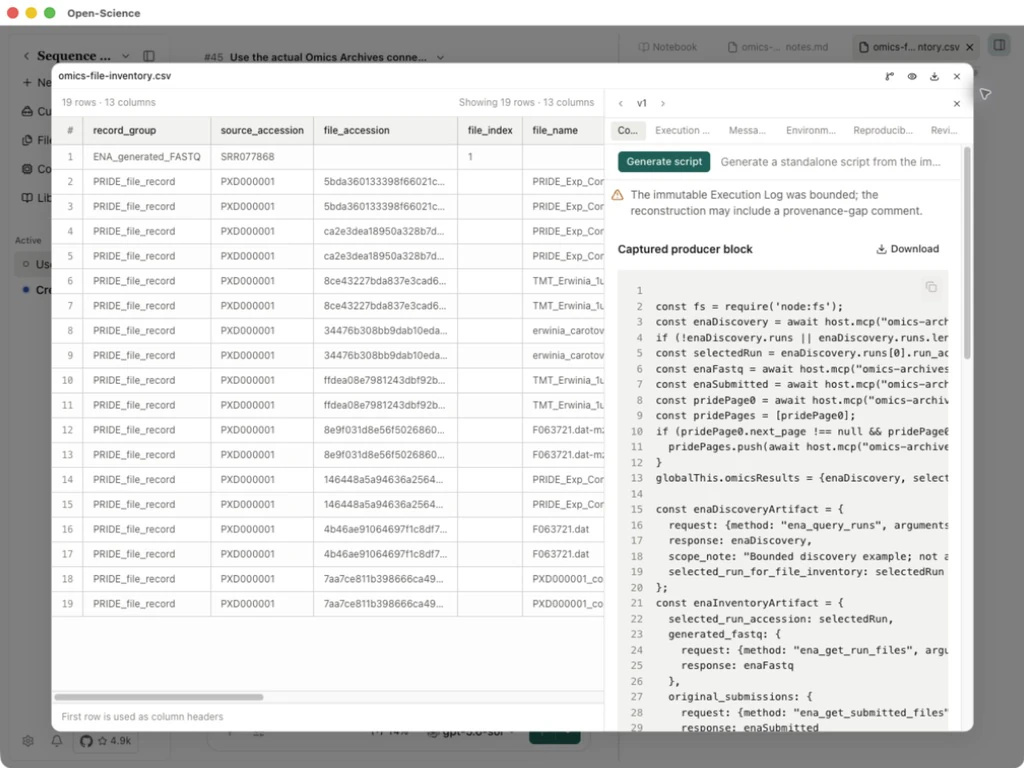
Abfragenotizen · Kombinierter Bestand · ENA-Entdeckung · ENA-Dateiinventare · PRIDE-Seiten
Die Ausgabe ist ein Dateiinventar, keine heruntergeladenen Sequenzierungs- oder Proteomikdaten. Archive FASTQ und Originaleinreichungen wie BAM/CRAM sind unterschiedliche Produkte. Halten Sie den ursprünglichen FTP-Pfad von ENA wörtlich, einschließlich jedes #-Zeichens. Verwenden Sie für PRIDE next_page und die zurückgegebenen Metadaten; api_total ist möglicherweise für andere Projekte abwesend, und Prüfsummentext identifiziert nicht immer seinen Algorithmus. Wählen Sie vor einem separaten Download das erforderliche Format aus, überprüfen Sie die Speicherung und überprüfen Sie Bytes, wenn eine vorgelagerte Prüfsumme verfügbar ist. Siehe Betriebsnummer für genaue Eingaben.