Wissenschaftliche Datenbanken
Verwenden Sie diese Seite, um eine Datenquelle auszuwählen, zu verstehen, was sie zurückgeben kann, und ihre Tools in Open-Science verfügbar zu machen. Schritt-für-Schritt-Forschungsbeispiele mit Screenshots und Ausgabedateien finden Sie unter Forschungsabläufe.
Unterstützte Datenbanken
Open-Science v1.0.5 bietet 48 integrierte Connectors mit 418 Operationen: 47 Datenquellen-Connectors stellen 416 Operationen bereit, ein Offline-Connector für Molecule zwei weitere. Die Namen unten entsprechen den Einträgen unter Settings → Connectors. Ein Connector kann mehrere Datenbanken abdecken. Ein aufgeführter Dienst stellt nicht automatisch alle Funktionen seiner Website bereit.
Die Anzahl umfasst alle integrierten Einträge, auch deaktivierte. Selbst hinzugefügte MCP-Connectors werden zusätzlich gezählt. Die Anzahl der Connectors, der abgedeckten Datenbanken und der aufrufbaren Operationen sind unterschiedliche Größen.
| Konnektor | Quellen | Vorgänge | Verwenden Sie es für |
|---|---|---|---|
Chemistry · chemistry | PubChem, ChEBI, Rhea, BindingDB, LIPID MAPS, UniChem | 14 | Kleinmolekülchemie über PubChem, ChEBI, Rhea und BindingDB. |
Literature Graph · literature | OpenAlex, arXiv, Crossref, DataCite | 13 | Papiere, Autoren, Zitate, DOI-Updates und Datensatz / Software-Datensätze. |
PubMed · pubmed | PubMed, PMC, Europe PMC, PubTator 3 | 9 | Biomedizinische Literatur über NCBI E-utilities, PMC ID Converter und Europe PMC — Suche, Metadaten, verwandte Artikel, Zitat-Lookup, ID-Konvertierung, Volltext und Copyright. |
Genes & Ontologies · genes | HGNC, MyGene, UniProt, OLS, QuickGO, Reactome, g:Profiler, Enrichr | 20 | Gen-/Protein-Identifikatoren, UniProt-Sequenzentdeckung, GO- und Reactome-Anmerkungen und g:Profiler- und Enrichr-Gen-Set-Anreicherung. |
Genome · genomes | NCBI Datasets, NCBI BLAST, EMBL-EBI Job Dispatcher, Ensembl, UCSC | 22 | Genomannotation, Homologie und Sequenz; NCBI-Taxon/-assembly/-sequence-Identität; BLAST-Suche und Clustal Omega Multiple Sequence Alignment Populationsspezifische LD und Proxy-Varianten. |
Varianten · variants | gnomAD, ClinVar, dbSNP, MaveDB | 22 | Populationshäufigkeit, klinische Aufzeichnungen und assayspezifische Funktionswerte, Zuordnungen und Experimente. |
Clinical Trials · clinical-trials | ClinicalTrials.gov | 7 | Trial Discovery, Protokolle und veröffentlichte Ergebnismessungen, Gruppennenner, Statistiken und unerwünschte Ereignisse. |
Clinical Genomics · clinical-genomics | ClinGen, CIViC, Open Targets, ClinPGx, DGIdb | 32 | Klinische Genomik-Wissensdatenbanken: ClinGen-Kurationen, klinische CIViC-Evidenz und die Open-Targets-Plattform sowie pharmakogenomische Aufzeichnungen von ClinPGx. |
Strukturen und Interaktionen · structures | PDB, PDBe, AlphaFold, EMDB, Complex Portal, IntAct, OmniPath | 20 | Strukturen und molekulare Wechselwirkungen — PDB-Strukturen, AlphaFold-Vorhersagen, EMDB-Kryo-EM-Einträge, komplexe Portalkomplexe, IntAct-Interaktionsnetzwerke. |
ChEMBL chembl | ChEMBL | 7 | Bioaktive Verbindungen, Medikamente, Targets, Bioaktivität und Mechanismen über das ChEMBL REST API. |
bioRxiv · biorxiv | bioRxiv, medRxiv, ROR | 7 | bioRxiv/medRxiv Preprints — Suche nach Datum/Kategorie, Metadaten nach DOI, Links zu Zeitschriftenveröffentlichungen, Funder-Listen und Plattformstatistiken. |
Drug Regulatory · drug-regulatory | openFDA | 11 | Drugs@FDA, Etiketten, FAERS-Nebenwirkungsberichte und Drogenrückrufe. |
Humangenetik · human-genetics | GWAS Catalog, eQTL Catalogue, PheWeb | 15 | Humangenetische Assoziationsnachweise — GWAS-Katalog, eQTL-Katalog und PheWeb-PheWAS-Portale (FinnGen, BioBank Japan). |
Ausdruck · expression | GTEx, Bgee | 16 | GTEx-Gewebeexpression und eQTL für den Menschen; Bgee-speziesübergreifender Basisausdruck. |
Proteinannotation · protein-annotation | InterPro, Pfam, Human Protein Atlas, STRING | 14 | Proteindomänenarchitektur, Familien-/Clan-Mitgliedschaft, Expressionsatlas und Interaktionsnetzwerke über InterPro/Pfam, Human Protein Atlas und STRING, einschließlich Netzwerkinteraktionsanreicherung. |
Krebsmodelle · cancer-models | cBioPortal, DepMap / CCLE | 15 | Studien, Mutationen, Kopienzahl, Proben, Patienten, klinische Eigenschaften und Expression des molekularen Profils. |
RNA · rna | Rfam, RNAcentral | 11 | Nicht-kodierende RNA-Familiendaten (Metadaten, Ausrichtungen, Modelle, Strukturen) über Rfam. |
Omics-Archive omics-archives | ArrayExpress, GEO, ENA, MetaboLights, Metabolomics Workbench, MGnify, PRIDE | 28 | Omics-Studie/-Ausführung von Metadaten und Dateiinventaren; Metabolomische Proben, Faktoren, Analysen und Aufzeichnungen über Verbindungen. |
CellGuide · cellguide | CELLxGENE | 5 | Zelltypidentität, Markergene, Quelldatensätze und Gewebe über CELLxGENE CellGuide. |
Regulation · regulation | ENCODE, JASPAR, UniBind | 16 | Funktionale Genomik der Genregulation — ENCODE-Experimente/Bioproben/Dateien, JASPAR-TF-Bindungsprofile und UniBind-ChIP-seq-TFBS. |
Research Resources · research-resources | Grants.gov, Antibody Registry | 5 | Funding-Opportunity-Suche (Grants.gov) und Antikörperkatalog-Lookups (Antibody Registry). |
BioMart · biomart | Ensembl BioMart | 8 | Ensembl BioMart Attributabfragen und Identifier-Übersetzung. |
ZINC · zinc | ZINC | 5 | ZINC22-Käuflicher chemischer Raum (CartBlanche22) — Stoffsuche nach ZINC-ID, SMILES-Suche mit exakter Ähnlichkeit, Lieferantencode-Auflösung, Zufallsstichprobenahme, 3D-Strukturstellen für das Andocken. |
GDC · gdc | Genomic Data Commons (GDC) | 5 | Krebsprojekte, Fälle, Dateimetadaten, offene/kontrollierte Etiketten und Transfermanifeste; kein Download oder Zugangszuschuss. |
Zenodo · zenodo | Zenodo | 2 | Öffentlicher Datensatz, Software- und Publikationserkennung, versionenspezifische Metadaten und Dateiinventare; Kein Upload oder Download. |
HMMER hmmer | HMMER3, EMBL-EBI | 3 | Programmspezifische Protein / Profil / Ausrichtung Suche, Job-Status und Ergebnisse. |
InterProScan · interproscan | InterProScan, EMBL-EBI | 3 | Reichen Sie Proteinsequenzen ein, überprüfen Sie den Status des Annotationsjobs und rufen Sie TSV-Berichte ab. |
Pathway Commons · pathway-commons | Pathway Commons, Reactome | 4 | Pathway-Suche, Top-Pfade, Graph-Abfragen und BioPAX-Submodellexporte. |
Alliance Genome Resources · alliance | Alliance of Genome Resources | 8 | Gene, Orthologe, Krankheitsmodelle, Phänotypen, Allele und Expression von Menschen und Modellorganismen. |
CELLxGENE Discover · cellxgene-discover | CELLxGENE Discover | 9 | Einzelzellensammlungen und Datensätze, veröffentlichte Versionen, Dateiformate, Größen und Download-URLs. |
Cellosaurus · cellosaurus | Cellosaurus | 6 | Finden Sie Zellliniennamen und Synonyme, dann prüfen Sie die Beitrittsidentität und Qualitätsanmerkungen. |
Monarch Initiative · monarch | Monarch Initiative | 2 | Krankheit / Gen-zu-Phänotyp-Assoziationen mit dem Organismus und unterstützende Beweise. |
IEDB · iedb | IEDB | 8 | Epitope, Antigene, T-Zell-, B-Zell- und MHC-Assays, TCR/BCR-Beweise und Quellenpublikationen. |
PDC · pdc | PDC | 5 | Krebs-Proteomik-Studienversionen, Probenlinks, öffentliche klinische Metadaten und Dateiinventare; kein Download. |
ENCORI · encori | ENCORI | 10 | miRNA/RBP-Targets, RNA-Wechselwirkungen, ceRNA, Motive, Bindungsstellen, Referenztabellen und Massendateien. |
Orphadata · orphadata | Orphadata, Orphanet | 2 | Seltene-Krankheit-Gen-Assoziationen und HPO-Phänotyp-Frequenzen; standardmäßig deaktiviert. |
TCIA · tcia | TCIA, NBIA | 3 | Bildgebungssammlungen, Zugangsbedingungen und Serienmetadaten. |
KEGG · kegg | KEGG | 3 | Signalwege, Verbindungen und Genzuordnungen; Lizenzbedingungen beachten. |
RxNorm / RxNav · rxnorm | RxNorm, RxNav | 2 | Auflösung von Arzneimittelnamen und Eigenschaften aktiver Konzepte. |
DailyMed · dailymed | DailyMed | 2 | Identität von Arzneimittelkennzeichnungen und Versionshistorie. |
BioSamples · biosamples | EMBL-EBI BioSamples | 2 | Öffentliche Probenmetadaten und Querverweise. |
WikiPathways · wikipathways | WikiPathways | 2 | Signalwegmetadaten, Arten und Revisionen. |
Europe PMC · europepmc | Europe PMC | 1 | Direkte Literatursuche, Abstracts und Paginierung. |
Research Datasets · research-datasets | NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, GBD | 3 | Datenzugangsbedingungen und öffentliche Dateilisten. |
ChEA3 · chea3 | ChEA3 | 2 | Anreicherungsranglisten für Transkriptionsfaktoren und GMT-Links. |
bioDBnet · biodbnet | bioDBnet | 6 | ID-Konvertierung, Orthologzuordnung und Signalwege. |
CTD · ctd | CTD | 1 | Offizielle öffentliche Berichte und Nutzungsbedingungen. |
Die Offline-Molekül-Tools sind in Wissenschaftliche Zuschauer abgedeckt. Für die genauen Operationen, die von jeder Datenquelle ausgesetzt sind, verwenden Sie den Connector Betriebsnummer.
Was du tun kannst
| Forschungsaufgaben | Beginnen Sie mit | Typischer Output |
|---|---|---|
| Papiere finden, Zitate nachzeichnen und DOI-Beziehungen überprüfen | Literatur Graph, PubMed, bioRxiv | Literaturaufzeichnungen, Identifikatoren, Zitierlinks und Volltextverfügbarkeit |
| Gene oder Proteine finden und Sequenzen vergleichen | Gene & Ontologien, Genome | Identifikator-Mappings, Proteinaufzeichnungen, FASTA- und BLAST-Berichte |
| Entdecken Sie öffentliche Omik-Daten und inspizieren Sie verfügbare Dateien | aus. | Studieren/Ausführen von Metadaten und Dateiinventaren mit Quellorten, Größen und verfügbaren Prüfsummen |
| Interpretieren Sie eine Genliste oder inspizieren Sie ein Interaktionsnetzwerk | Gene & Ontologien, Protein-Annotation | Anreicherungstabellen, Ontologie-Anmerkungen und Netzaufzeichnungen |
| Prüfvarianten, Ausdruck und regulatorische Nachweise | Varianten, Klinische Genomik, Humangenetik, Expression, Regulation | Quellenaufzeichnungen mit Organismen, Gewebe, Referenzaufbau und relevanten Evidenzfeldern |
| Retrieve Verbindung, Struktur oder klinische Studie Aufzeichnungen | Chemie, ChEMBL, Strukturen & Interaktionen, Klinische Studien | Chemische Kennzeichen/Eigenschaften, Strukturaufzeichnungen und Versuchsmetadaten |
Für die Batch-Identifier-Konvertierung fügt Gene & Ontologien submit_uniprot_id_mapping, get_uniprot_id_mapping_status und get_uniprot_id_mapping_results hinzu. Speichern Sie die Job-ID, wählen Sie mindestens drei Sekunden auseinander und rufen Sie dann jede Ergebnisseite ab. Eins-zu-viele-Mappings und explizites failed_ids beibehalten; Fehlen auf einer Seite bedeutet nicht unübertroffen. Der Dienst akzeptiert bis zu 100,000-Identifikatoren und läuft die Ergebnisse nach bis zu sieben Tagen ab. Siehe genaue Abbildungsfelder.
Zenodon stellt öffentliche Datensatz-Metadaten ohne Authentifizierung frei. Bewahren Sie die versionenspezifische Datensatz-ID und die Zugriffs- / Lizenzfelder mit dem Dateiinventar auf. GD stellt öffentliche Metadaten frei; Ein Manifest ist keine Download-Autorisierung, und kontrollierte Dateien erfordern eine GDC-Berechtigung. GDC-Operationen · Zenodo-Operationen.
Eine Datenbankantwort kann einen Forschungsschritt unterstützen; Es werden nicht automatisch Daten heruntergeladen, jedes Papier in die Literaturbibliothek aufgenommen oder eine vollständige Analyse durchgeführt. Geben Sie an, welche Datensätze und Dateien Sie speichern möchten.
RNA-Regulierungsnachweis mit ENCORI
Finden Sie ENCORI in Settings → Connectors, aktivieren Sie es und stellen Sie es Hauptagent zur Verfügung. Diese integrierte Quelle benötigt keine benutzerdefinierte MCP URL oder API Schlüssel. Mit einem funktionierenden Main-Modell ausgewählt, geben Sie den Organismus/Assembly, RNA oder Zielgen, Zelltyp und Evidenzschwellen im Gespräch.
| Aufgabe | Ergebnis und Grenze |
|---|---|
| miRNA-, RNA-RNA-, RBP-Target- und ceRNA-Abfragen | Bewahren Sie den anwendbaren CLIP-, Degradom-, Vorhersageprogramm-, p-Wert- und FDR-Beweis auf; Eine Bindung oder Assoziation begründet keine kausale Regulierung. |
| RBP-Krankheitsnachweise, Motive und Bindungsstellen | Konservierungsanordnung, Gewebe-Zell-Kontext, vorgelagerte Ordnung und ursprüngliche Koordinaten; Mischen Sie keine Arten oder koordinieren Sie Systeme. |
| Referenztabellen und Massendaten | Listen Sie zuerst genaue Tabellenpfade oder Dateinamen auf. Der Bulk-Download ist separat: Geben Sie die Datei, das Ziel und den erforderlichen Speicherplatz an, bevor Sie sie anfordern. |
Praxisbeispiel Abfrage miRNA Nachweis für PDCD4 in HeLa
Use ENCORI to find human miRNA interactions targeting PDCD4 in HeLa cells,
using hg38, mRNA targets, at least one CLIP experiment and TargetScan support.
Show at most two rows. Preserve the exact filters, total count and full raw
response in the session data folder. Explain the evidence limits in English.
Do not download bulk datasets.
Diese Abfrage hat 19-Einträge zurückgegeben; die ersten beiden waren hsa-miR-23a-3p und hsa-miR-181a-5p. Der Screenshot zeigt die gespeicherte vollständige Rohantwort und die Evidenzgrenzen. Dies sind beispielspezifische Ergebnisse und können sich ändern, wenn die Datenbank aktualisiert wird.
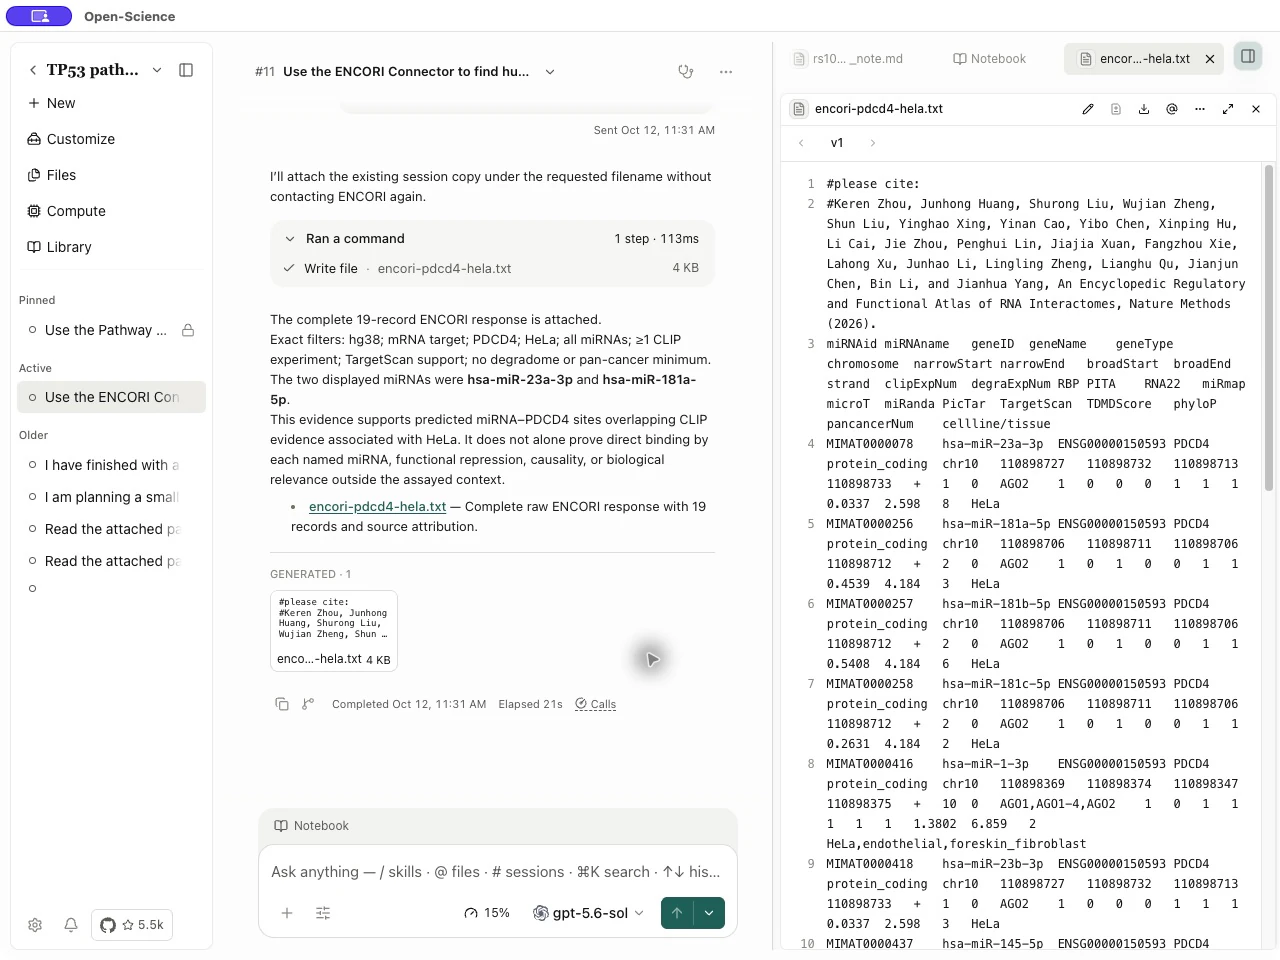
Unterscheiden Sie total_records von returned_records und prüfen Sie is_complete, result_scope und completeness_note. Eine Vorschau ist keine vollständige Zielverteilung. Der raw_response_path der vollständigen Antwort ist ein lokaler Dateipfad, nicht automatisch ein herunterladbares Sitzungsartefakt. Um es zu teilen, bitten Sie den Agenten, es in einem zugänglichen Sitzungsdatenverzeichnis zu speichern, und fügen Sie die Datei an; die Anlage öffnen, um ihren Inhalt zu überprüfen.
Eine Abfrage kann ein echtes leeres Ergebnis oder ok:false zurückgeben; Verbreitern Sie die Filter nicht leise, um einen Treffer zu erhalten. Überprüfen Sie nach einem Massendownload den tatsächlichen Pfad, die Größe und verified_gzip. Das Lesen von Referenztabellen oder das Auflisten von Datensätzen lädt die Massendateien nicht herunter. Siehe ENCORI-Operationen für genaue Parameter.
Assay-Kontext und individuelle Einreichungen
| Eingang | Verfahren | Interpretationsgrenze |
|---|---|---|
| Array aus Zeichenfolgen | Connector aktivieren; Es wird kein API-Schlüssel benötigt. Nehmen Sie assay_chembl_id aus einer Bioaktivitätsaufzeichnung, Untersuchungsmethode, Organismus, Zelle/Gewebe und Ziel mit get_assay, dann abrufen get_bioactivity für die gleiche Test-ID. | Zielzuweisungsvertrauen ist keine Messqualität. Vergleichen Sie Bedingungen, Einheiten und Beziehungsoperatoren, bevor Sie IC50/Ki-Werte kombinieren. |
| Variants → ClinVar | Konfigurieren einer echten NCBI-Kontakt-E-Mail im Connector; API ist optional. Anruf clinvar_get_submissions mit einem VCV-Zugang oder einer positiven Variations-ID, dann folgen Sie dem Version-Pinned next_page Argumente. | SCV, Submitter, Bedingung, Bewertungsdatum, Methode und Zitate beibehalten. Vergleichen Sie Keimbahn, somatische klinische Auswirkungen und Onkogenität separat. |
ChEMBL Seiten werden von activity_id bestellt. Filter unverändert halten und next_offset als nächstes offset bis has_more:false übergeben; Dies kann mehr als 1,000-Datensätze abrufen. Der summary deckt nur die aktuelle Seite ab, so dass seine stärkste Aktivität nicht unbedingt die stärkste in der vollständigen Abfrage ist. Nachdem ClinVar eine erste Seite mit der neuesten Version aufgelöst hat, behalten Sie die zurückgegebene versionierte VCV zur Fortsetzung bei; keine RCV-, SCV- oder rsID-Eingänge ersetzen.
ChEMBL Assayfelder · Paginierung von Bioaktivität · ClinVar Einreichungsfelder.
Einzelzell-, Modell-Organismus- und Varianten-Effekt-Daten
Suchen Sie nach den Einträgen unten in Settings → Connectors, aktivieren Sie die Verfügbarkeit für Hauptagent, beschreiben Sie dann den Organismus, die Forschungsfrage und die Aufzeichnungen, die Sie in Ihrem Gespräch behalten müssen. Diese neuen Operationen lesen öffentliche Daten ohne einen benutzerdefinierten MCP-Server, API Schlüssel oder NCBI Kontakt-E-Mail. Andere Dienste im selben Connector können unterschiedliche Anforderungen haben.
| Eingang | Was sie tun kann | Wie man die Ergebnisse verwendet |
|---|---|---|
| CELLxGENE Discover | Suche nach Einzelzelldatensätzen nach Organismus, Gewebe, Krankheit, Assay oder Zelltyp; Inspizieren von Versionen und Dateibeständen | Ontologiefilter verwenden exakte Beschriftungen oder IDs und werden mit AND kombiniert. dataset_version_id für eine feste Veröffentlichung behalten; dataset_id wird auf die aktuelle Version aufgelöst. Gibt verfügbare Download-URLs zurück, ohne Dateien herunterzuladen oder Zensusausdruckmatrizen abzufragen. Verwenden Sie das separate CellGuide für Zelltypbeschreibungen und Marker. |
| Alliance Genome Resources | Abfrage von Human-, Maus-, Ratten-, Fliegen-, Wurm-, Zebrafisch-, Hefe- und Froschgenen, Orthologen, Krankheitsmodellen, Phänotypen und Expression | Suchen und bestätigen Sie den Organismus, bevor Sie die zurückgegebenen Gen-IDs befolgen. Bewahren Sie Evidenz und Orthologie Stringenz; ein Modell-Organismus-Phänotyp ist keine Schlussfolgerung aus einer menschlichen Krankheit. |
| Varianten → MaveDB | Varianteneffekt-Score-Sets, Assay-Methoden, CSV-Scoreseiten und bestehende VRS-Mappings finden | Halten Sie die URN, Lizenz, Assay-Methoden und Score-Kalibrierung. Funktionelle Werte sind keine Klassifikationen der klinischen Pathogenität. CSV verwendet Start/Limit-Paginierung und zurückgegebener Text muss noch in einer Datei gespeichert werden. Mapping Retrieval führt kein Liftover durch. |
| Omics Archives → Metabolomics Workbench | Suchstudien; Proben, Faktoren, Analysen und Metaboliten nach ST-Beitritt zu untersuchen; Verbindungsstrukturen und Querverweise nachschlagen | Wählen Sie Zusammenfassung, Faktoren, Analyse oder Metaboliten mit Abschnitt. Lösen Sie zusammengesetzte Namen zuerst über PubChem in unterstützte Identifikatoren auf. Diese Operationen laden keine Rohmessmatrizen herunter. |
CELLxGENE-Filterung und Paginierung laufen lokal über den vorgelagerten Katalog, der für jede Anforderung abgerufen wurde; Der Katalog kann zwischen den Anfragen wechseln. Verwenden Sie Versions-IDs, um eine Publikation beizubehalten. Eine nicht gemeldete Dateigröße ist -1, nicht Null Bytes. Fehlende Werte und Assay-Definitionen in den Ergebnissen von MaveDB und Workbench ebenfalls beibehalten.
Siehe genaue Eingaben für CELLxGENE Discover, Allianz, MaveDB und Metabolomics Workbench.
Zelllinien, Phänotypen und Immunnachweise
Aktivieren Sie Cellosaurus, Monarch Initiative oder IEDB in Settings → Connectors und stellen Sie es Hauptagent zur Verfügung. Diese Operationen stellen öffentliche Datensätze ohne einen benutzerdefinierten Server oder API-Schlüssel ab.
| Eingang | Was zu verlangen ist | Was zu bewahren ist |
|---|---|---|
| Cellosaurus | Suchen Sie einen Zellliniennamen / Synonym und rufen Sie dann den zurückgegebenen CVCL-Zugriff oder RRID ab | Art, Identität, Synonyme und Anmerkungen zur Kontamination/Fehlidentifikation. Die Suche nimmt eine wörtliche Phrase, keine rohe Solr-Abfrage. Fehlende Qualitätsanmerkungen zertifizieren die Zelllinie nicht. |
| Monarch Initiative | Krankheit oder Gen-Phänotyp-Assoziationen mit kanonischen CURIEs, wie MONDO:0007254 oder HGNC:11998 | Organismus, Phänotyp, Quelle und Nachweis. Aliasnamen werden nicht automatisch konvertiert; Bezeichner zuerst auflösen. Eine direkte Übereinstimmung betrifft den Identifikator-Matching, nicht die experimentelle Bestätigung. |
| IEDB | Epitope oder Antigene oder ein spezifischer T-Zell-, B-Zell- oder MHC-Test | Mindestens ein biologischer/evidence Filter ist erforderlich; Die Paginierung allein reicht nicht aus. Verwenden Sie entweder antigen_iri oder uniprot_accession, nicht beides. Konservierungstestmethode, Ergebnis, Einheiten und Veröffentlichung; eine MHC-Elutionsbeobachtung ist keine Affinitätsmessung. |
Ein aggregierter Epitop/Antigen-Rekord kann Beobachtungen aus verschiedenen Experimenten kombinieren. Wenn die Filter durch dasselbe Experiment erfüllt werden müssen, ist der entsprechende Testvorgang abzufragen. Null Übereinstimmungen stellen keinen negativen biologischen Befund dar. Cellosaurus-Parameter · Monarchparameter · IEDB-Parameter.
Finden Sie GEO-Matrizen und Sequenz-matched Strukturen
Omics Archives → geo_get_matrix_files Entdeckt offiziell GEO Reihe Matrix und NCBI-generierte Anzahl/FPKM/TPM/Annotationsdateien. Es gibt Dateistandorte zurück; Ihre Bytes werden nicht heruntergeladen. geo_get_series bleibt ein Metadaten-Lookup.
Nach Erhalt einer Matrix überprüft geo_preflight_matrix bereits gelesenen, dekomprimierten Text bis 8 MiB. Es hat keinen Netzwerk- oder Dateisystemzugriff. Behalten Sie GSM-Identifikatoren und Plattformmetadaten, damit Samples nach ID und nicht nach Spaltenposition abgebildet werden können. Setz vollständig: falsch für eine Vorschau; vollständig: wahr nur für die gesamte Datei übergeben. Eine Vorschau kann keine Volldateidimensionen festlegen. Geben Sie kein komprimiertes Archiv, eine spärliche Matrix oder eine HDF5-Datei in den Textchecker ein. Siehe Matrixentdeckung und Textvorflug.
Structures & Interactions → pdb_search_sequence akzeptiert eine Proteinsequenz von 25-10,000-Resten als Rohsequenz oder einen FASTA-Datensatz. Identitäts- und Abfrageabdeckungsschwellenwerte sind Brüche von 0 bis 1. Die zurückgegebene Abfrageabdeckung beschreibt die Ausrichtung auf die Abfrage; Es ist keine experimentelle Strukturabdeckung. Die Upstream-Gesamtmenge geht der lokalen Abdeckungsfilterung voraus, und ein begrenzter Scan kann spätere Übereinstimmungen auslassen. Die Operation findet Strukturdatensätze, ohne Koordinaten herunterzuladen. Siehe Genaue Eingaben und Scan-Grenzen.
Verbinden und Starten der Verwendung einer Datenbank
1. Aktivieren Sie das eingebaute Connector
- Öffnen Sie Settings → Connectors und suchen Sie nach der oben aufgeführten Familie, z. B. aus..
- Öffnen Sie seine Details und erweitern Sie Tools. Lesen Sie die Eingaben der ausgewählten Operation, Ergebnisgrenzen und Anforderungen von Drittanbietern.
- Aktivieren Sie die Verfügbarkeit für Hauptagent und überprüfen Sie Used by. Verwenden Sie Manage access in der Ressource, um Main-Agenten- und Specialist-Zuordnungen anzupassen. Verfügbarkeits- und Genehmigungsrichtlinien pro Werkzeug sind separate Kontrollen.
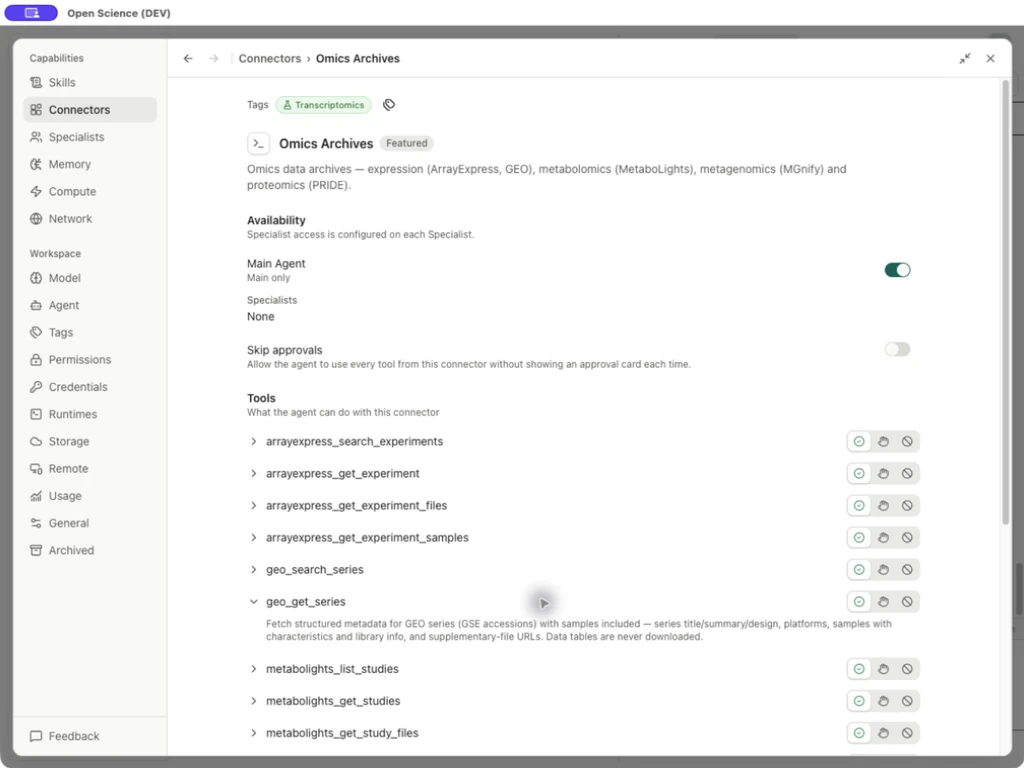
Diese Steckverbinder sind eingebaut; Sie müssen keinen benutzerdefinierten server für sie hinzufügen. Für einen externen Dienst, den Sie selbst betreiben, siehe Benutzerdefiniertes Connector Setup. Ein aufgelistetes oder aktiviertes Connector ist kein Beweis dafür, dass die Authentifizierung oder eine Abfrage erfolgreich war.
2. Hinzufügen von Anmeldeinformationen, wenn die Operation diese erfordert
| Service oder Bedingung | Wo Sie es konfigurieren |
|---|---|
| OpenAlex | Optionaler Schlüssel. Um einen zu konfigurieren, offen Settings → Connectors → Literature Graph → Manage credentials → OpenAlexund es zu validieren, dann zu retten. |
| Direkte NCBI-Variantenabfragen, die Kontaktdaten erfordern | Settings → Connectors → Manage credentials → Literature accessfort. Füllen Sie ein Contact email und wählen Savefort. Ein NCBI API-Schlüssel ist optional. |
| Eine weitere Operation mit Anmeldepflicht | Befolgen Sie die Anforderungen dieses Tools und Anmeldeinformationenfort. Binden Sie den Nachweis an den beabsichtigten Dienst. |
Geben Sie Schlüssel in der Anmeldeformular, nicht in einer Forschungsaufforderung oder eine freigegebene Ausgabedatei. Anforderungen für den ausgewählten Vorgang konfigurieren; die oben genannte Anforderung an die Kontakt-E-Mail bedeutet nicht, dass jedes NCBI-Tool dieselbe Anforderung hat.
Literatur Graph bietet auch crossref_get_work, crossref_get_updates, datacite_search_records und datacite_get_record an. Diese vier öffentlichen Methoden erfordern keinen OpenAlex-Schlüssel. Für OpenAlex-Zitatanweisungen findet openalex_citations Werke, die ein Werk zitieren, während openalex_references die Werke findet, die es zitiert. Literatur Graph Parameter.
3. Bestätigen Sie den Zugriff mit einer kleinen Abfrage
Aktivieren Sie Gene & Ontologien, öffnen Sie eine Konversation mit einem verbundenen Modell und senden Sie:
Beispiel Überprüfen Sie einen bekannten menschlichen Gen-Identifikator
Use Genes & Ontologies query_genes to resolve TP53 with scopes="symbol",
species="human" and fields="symbol,name,entrezgene". Return the input query,
matched records and any unmatched identifiers. Keep the response in English.
Überprüfen Sie das tatsächliche Werkzeugergebnis. Für menschliche TP53, überprüfen Sie query, symbol, Entrez Gene 7157 und den Namen Tumorprotein p53. Behalten Sie mehrere Übereinstimmungen, bis Sie den Organismus bestätigt und aufgezeichnet haben. Eine erfolgreiche Abfrage bestätigt diese bestimmte Operation; Es stellt nicht den Zugang zu allen Quellen her. Genaue Felder.
Folgen Sie einem Forschungs-Workflow
Jeder artikel unten enthält die eingaben, schritte, aktuelle englischsprachige screenshots und herunterladbare beispielausgaben.
Finden Sie öffentliche Omik-Daten
Finden Sie Public Omics-Daten und erstellen Sie ein Dateiinventar: Beginnen Sie mit einem bekannten Lauf oder einem Thema, prüfen Sie ENA- und PRIDE-Datensätze und speichern Sie Quellorte und Prüfsummen. Der Download der Daten bleibt ein separater Schritt.
Vergleichen Sie eine Proteinsequenz
Finden Sie eine Proteinsequenz und vervollständigen Sie eine BLAST-Suche: UniProt FASTA abrufen, die BLAST-Job-ID behalten und dann die abgeschlossenen Ausrichtungen, Identität und Abfrageabdeckung überprüfen.
Analysieren Sie einen Kandidaten-Gen-Set
Laufen funktionelle Anreicherung für einen Kandidaten-Gen-Set: Wählen Sie den Organismus, die Identifikatoren und den Hintergrund, führen Sie g:Profiler aus und interpretieren Sie korrigierte Wahrscheinlichkeiten mit Quellversionen.
Bestätigung eines Referenzgenoms
Kontrollarten, Referenzgenom und Chromosomenkennzeichen: Lösen Sie das Taxon, die versionierte Assembler und die Chromosomenaliase, bevor Sie Datensätze verbinden.
Inspizieren eines Pathway-Netzwerks
Untersuchen Sie einen Pfad und sein Interaktionsnetzwerk: Finde einen menschlichen Reactome-Pfad durch Pathway Commons, bewahre seinen zurückgegebenen URI, exportiere die Interaktionen und unterscheide ein ausgewähltes Netzwerk vom Nachweis der Signalwegaktivität.
Bei anderen Aufgaben folgen Sie strukturierte PubChem-Aufzeichnungen, Abgleich wissenschaftlicher Aufzeichnungen oder Literaturentdeckung für ein Gruppentreffen.
Verwenden Sie die zurückgegebenen Daten korrekt
- Bewahren Sie die Abfrage, Quelle, Organismus, Gewebe, Einheiten und Beitrittsversionen auf. Datenbankeinträge, Vorhersagen und generierte Zusammenfassungen sind verschiedene Arten von Beweisen.
- Überprüfen Sie die zurückgegebenen Zählungen, Paginierungs- und Abkürzungsflags, bevor Sie eine Antwort als vollständig behandeln. Null Übereinstimmungen, eine Teilantwort und ein Anforderungsfehler erfordern unterschiedliche Folgeaktionen.
- Ein Dateiinventar bietet Standorte und Metadaten. Das Herunterladen von Bytes, das Überprüfen von Prüfsummen und das Analysieren der Daten sind separate Operationen.
- Wenn eine Anfrage Anmeldeinformationen benötigt, füllen Sie das entsprechende Formular aus, bevor Sie es erneut versuchen. Für Tariflimits, folgen Sie der Verzögerung des Dienstes; für Timeouts die Anforderungsgröße reduzieren. Siehe Fehlerbehebung.
Populationsfrequenzen und Interaktionsnetze
Setzen Sie für get_variant include_populations: true nur, wenn Populationsdetails benötigt werden. Bewahren Sie den Dataset und den Referenz-Build auf. Exom- und Genombeobachtungen bleiben getrennt. Ein nicht verfügbarer Wert ist null, nicht Null; Überlappende Bevölkerungs- oder Geschlechtsschichten dürfen nicht summiert werden. Dies sind beobachtete Frequenzen, nicht das Filtern von Allelfrequenzen. gnomAD-Parameter
Von v0.31.0 enthält get_string_network.nodes zurückgegebene Nachbarn und isolierte kartierte Eingaben. Eine einzelne kartierte Eingabe fordert Nachbarn an; Mehrere abgebildete Eingänge werden nicht erweitert. Filtern Sie is_query, um Eingabeknoten wiederherzustellen, und verwenden Sie queries für alle abgebildeten Aliase. n_nodes zählt den Graphen n_mapped zählt Input-Mappings. Aktualisieren Sie Skripte, die die beiden gleichgesetzt haben, bevor Sie sie wiederverwenden. STRING-Parameter
Suche nach Betriebsparametern
Der Connector Betriebsnummer listet die erforderlichen Eingaben, erlaubten Werte und genauen Aufrufe auf. Verwenden Sie diese Seite, um eine Quelle auszuwählen und sie zu verbinden; Verwenden Sie die Referenz für die Felder eines bestimmten Werkzeugs.
Katalogquelle: catalog.ts, registry.ts.
Sequenzsuche und Ausrichtung
HMMER bietet programmspezifische Proteinsequenz-, Profil-HMM- und Alignment-Suchen. Wählen Sie das Programm und die Datenbank zusammen, behalten Sie die Job-ID bei und rufen Sie die Ergebnisse erst nach ERFOLG ab. HMMER-Betrieb.
InterProScan unterstützt die Einreichung von Proteinsequenzen, den Jobstatus und den TSV-Annotationsabruf aus v0.35.1. Folgen Sie InterProScan Einreichung für die Einrichtung und Schritte.
Genomes → Clustal Omega ordnet mindestens drei eindeutig benannte Protein-, DNA- oder RNA-FASTA-Datensätze an. Konfigurieren Sie die vom Dienst angeforderte Kontakt-E-Mail, senden Sie sie einmal, behalten Sie die Job-ID bei, überprüfen Sie dann den Status und speichern Sie die zurückgegebene Ausrichtung. Mehrfachsequenz-Ausrichtungs-Workflow.
Enrichr, STRING und ClinPGx
- Genes & Ontologies → Enrichr: Liste der aktuellen Bibliotheken, dann Abfrage Gen-Set-Anreicherung für Funktionen, Transkriptionsfaktoren, Störungen, Medikamente, Krankheiten, Gewebe oder Zelltypen. Wählen Sie eine Bibliothek, die dem Organismus und der Frage angemessen ist, und behalten Sie ihren Namen, Hintergrund und angepasste P-Werte bei.
- Protein Annotation → STRING: Testen Sie, ob ein Proteinnetzwerk mehr Interaktionen hat als von seinem Hintergrund erwartet. Dies stellt eine andere Frage als die Pathway-Überrepräsentation; Der P-Wert des Netzwerks ist kein Pfadtest. Folgen Sie dem Workflow für Gen-Set-Anreicherung.
- Clinical Genomics → ClinPGx: Arzneimittel, Gen- oder Variantenanmerkungen, Richtlinien, regulatorische Etiketten und Populationsfrequenzen abrufen. Lösen Sie zuerst die Identifikatoren, liefern Sie die für die Operation erforderlichen Felder und behalten Sie die ursprünglichen Quellen und Evidenzniveaus bei. Dies ruft Forschungsaufzeichnungen ab; Es wird nicht automatisch ein individueller Behandlungsplan erstellt.
Aktivieren Sie die entsprechende Connector für den Wirkstoff in Settings → Connectors. Diese eingebauten Einträge erfordern keinen benutzerdefinierten MCP-Server. Siehe Operationsreferenz für genaue Felder und bedingte Anforderungen.
Pathways, Expression und klinische Daten
Aktivieren Sie die entsprechende Familie in Settings → Connectors und teilen Sie dem Agenten dann den Organismus, die Quelle, die Identifikatoren und den beabsichtigten Umfang mit. Diese Ergänzungen verwenden eingebaute Konnektoren; Es ist kein benutzerdefinierter MCP Server erforderlich.
| Eingang | Was sie tun kann | Verbindung und Interpretation |
|---|---|---|
| Pathway Commons | Suchpfade, Liste Top-Pfade, Abfragepfade zwischen Genen oder Export eines Submodells | Öffentlicher Dienst; die zurückgegebene URI, den Organismus und die Quelle behalten. Graphabfragen unterscheiden sich von Anreicherungstests. Folgen Sie Workflow für die Interaktion zwischen den Signalen. |
| Ausdruck → Bgee | Speziesübergreifend vorhandene/abwesende Anrufe, normalisierte Werte, begrenzte SPARQL-Abfragen und Download-Links | Entdecken Sie zuerst Arten und behalten Sie die NCBI-Taxonomie-ID. SPARQL erfordert Gene, Spezies und Gewebe. Gesunde Wildtyp-Baseline-Aufrufe sind kein differentieller Ausdruck; Download Links sind keine heruntergeladenen Dateien. |
| Krebsmodelle → cBioPortal | Auflisten von Proben/Patienten und Abfrage klinischer Attribute oder mRNA/Proteinexpression | Wählen Sie eine Studie, entdecken Sie ihre Profile und wählen Sie Messung / Normalisierung. Lieferkennungen, die der klinischen Probe/dem Patienten entsprechen; Molekulare Daten benötigen explizite Gene und genau eines von sample_ids oder sample_list_id. Fehlende Zeilen sind keine Nullen. |
| Drug Regulatory → openFDA | Suchen / Zählen FAERS Berichte und Suchen Drogenrückrufe | Daten und Produkte gebunden und Verkürzungsinformationen aufbewahrt werden. Die Anzahl der Berichte ist keine Inzidenz oder kausale Beweise. Mehrwertige Eimer können sich überschneiden; Ihre summe ist kein einzigartiger bericht insgesamt. |
| Omics Archives → MGnify | Ergebnisdateien nach MGYA-Analyse-Zugang auflisten | Gibt Art, Kategorie, Upstream-URL und Größe zurück, wenn gemeldet. Es werden keine Dateibytes heruntergeladen; Fehlende Größen oder URLs bleiben null. |
Siehe Connector Betriebsnummer für genaue erforderliche Felder, Bedingungen und Beispiele.
Interpretieren Bgee Arten Verfügbarkeit
Beginnen Sie mit bgee_species, um die Arten zu identifizieren. Sein taxon_id ist die NCBI-Taxonomie-ID des Organismus, nicht die Spezies, die sein Referenzgenom liefert. In einer Listenantwort bedeutet has_expression_data: null, dass die Verfügbarkeit nicht bestimmt wurde. Abfrage erneut unter Verwendung des zurückgegebenen taxon_id als species_id, um die Metadaten dieser Spezies zu laden. Halten Sie null als unbekannt, wenn Metadaten fehlen; Nur ein explizites false ist ein negatives Verfügbarkeitsergebnis. Diese Felder beschreiben die Atlasabdeckung, nicht ob ein bestimmtes Gen in einem Gewebe exprimiert wird.
GWAS Zusammenfassungsstatistiken finden
Ganzzahl für Main in Settings → Connectors aktivieren. Bitten Sie um eine Zusammenfassung der Statistik mit dem GCST Beitritt der Studie und behalten Sie die zurückgegebenen URLs der Original- / harmonisierten Dateien, Metadaten und das deklarierte Referenzgenom bei. Die öffentliche Suche erfordert keinen API-Schlüssel.
gwas_get_summary_statistics listet Studiendateien auf und liest verfügbare YAML-Metadaten; Es werden keine großen Assoziationstabellen heruntergeladen. Seine GWAS-SSF-Spaltendefinitionen beschreiben den Standard, keinen inspizierten Dateikopf. Laden Sie die beabsichtigte Datei separat herunter und überprüfen Sie die tatsächlichen Spalten, den Genomaufbau, das Effektallel und die Einheiten vor der Analyse. Signifikante Assoziationstreffer sind kein Ersatz für vollständige zusammenfassende Statistiken. Parameter und Output.
Einreichen einer Proteinsequenz an InterProScan
- InterProScan für Main in Settings → Connectors aktivieren. Speichern Sie in Settings → Credentials → Literature access die gültige Kontakt-E-Mail, die für EMBL-EBI-Jobs verwendet wird; Es ist kein API-Schlüssel erforderlich.
- Geben Sie eine Proteinsequenz oder eindeutig benannte Protein-FASTA-Datensätze an und fordern Sie einmal die Einreichung an. Die Sequenz und die Kontakt-E-Mail werden an EMBL-EBI gesendet. Eine Anfrage akzeptiert bis zu 1,000-Datensätze, 10,000-Reste pro Sequenz und einen 4 MiB-kodierten Anfragekörper.
- Behalten Sie die zurückgegebene job_id. SUBMITTED mit ready: false ist eine Quittung, kein Annotationsergebnis. Statusstatus im Abstand von mindestens zehn Sekunden überprüfen; Polling ist nicht automatisch.
- Fordern Sie nach FINISHED Ergebnisse an und speichern Sie das vollständige TSV, bevor das Remote-Ergebnis abläuft. Eine Antwort über das 2 MiB-Abruflimit schlägt fehl, anstatt stillschweigend einen verkürzten Bericht zurückzugeben.
- Überprüfen Sie die Protein-Identifikatoren, Quellanwendungen und 1-basierte inklusive Koordinaten. Noten aus verschiedenen Mitgliedsanwendungen sind nicht austauschbar; Kein Treffer beweist nicht, dass einem Protein eine Funktion fehlt.
Vermeiden Sie eine doppelte Einreichung nach einem Timeout: Stellen Sie zuerst eine bekannte Job-ID wieder her. Das Abbrechen einer lokalen Anfrage storniert keinen eingereichten Remote-Job. Siehe Submission, Status und Ergebnisparameter.
Finden Sie TCR und BCR Beweise in IEDB
Aktivieren Sie IEDB für Main und fordern Sie search_tcrs oder search_bcrs mit mindestens einem biologischen oder Beweisfilter an. Pagination allein reicht nicht aus. Verwenden Sie sequence für die Epitop-Sequenz; chain1_cdr3- und chain2_cdr3-Filterrezeptor-CDR3-Sequenzen. Diese öffentlichen Suchanfragen benötigen keinen API-Schlüssel.
Bewahren Sie die Rezeptorgruppen-ID, Ketten, gemeldete Assay-IDs und Quellenpublikationen auf. Host- und Outcome-Filter gelten für aggregierte Gruppen und können durch verschiedene Experimente befriedigt werden. Um festzustellen, dass im selben Assay Bedingungen auftreten, folgen Sie den gemeldeten Assay-IDs in den entsprechenden Assay-Vorgang und wenden Sie dort die erforderlichen Filter an. Pagination umfasst Rezeptorgruppen, nicht die Vollständigkeit jedes eingebetteten Exports. Diese Aufzeichnungen sind Evidenzabruf, keine Vorhersage der Rezeptorbindung. IEDB-Parameter.
Entdecken Sie Krebsproteomik mit PDC
PDC in Settings → Connectors aktivieren. Seine öffentlichen Metadaten API benötigen keinen API-Schlüssel. Verwenden Sie es, um Studien und Versionen zu finden, Assays und Probenzahlen zu untersuchen, Fall-Probe-Aliquot-Assoziationen zu kartieren und quantitative Dateien wie Proteinanordnung-Berichte aufzulisten. Es gibt keine Behandlungs- / Ergebnisdaten zurück oder lädt Dateien herunter.
Beginnen Sie mit einem Studienzugang wie PDC000127 oder suchen Sie Studienbezeichner und Versionsnamen. PDC Keyword Matching ist kein klinischer Krankheitsfilter. Holen Sie die Studie ab und verwenden Sie dann die zurückgegebene study_id-UUID, um nachfolgende Aufrufe anzuheften; pdc_study_id wählt die neueste Version aus. Geben Sie genau einen dieser Selektoren an.
Für Probenlisten zählt die Vorwärts-Paginierung Fälle; expandierende Proben und Aliquots können mehr Zeilen als die Fallgrenze produzieren. Die Standardseiten des lokal-Modus erhielten Assoziationen und haben eine vorgelagerte 1,000-Assoziation. Eine endgültige lokale Seite beweist keine Vollständigkeit, wenn diese Obergrenze erreicht wird. Halten Sie PDC-IDs und benannte externe GDC-Referenzen getrennt. Dateilisten umfassen Namen, Bytegrößen, MD5-Werte und Speicherpfade; Ein aufgelisteter Pfad ist keine autorisierte Download-URL.
Siehe PDC-Operationen und Paginierung. Bevor Sie Quellen kombinieren, überprüfen Sie die Studienversion, den Assay, die Probenidentität und die Zugriffs- und Zitieranforderungen jeder Quelle.
Bevölkerungsspezifisches LD überprüfen
Genome in Settings → Connectors aktivieren. Seine Ensembl LD-Tools verwenden das öffentliche API ohne Schlüssel. Geben Sie zwei Varianten-IDs für ensembl_ld_pairwise oder eine für ensembl_ld_proxies zusammen mit dem vollständigen Populationsnamen wie 1000GENOMES:phase_3:KHV an. Die Werkzeuge entdecken nicht die Bevölkerung oder schließen Abstammung; eine für die Studie geeignete Referenzpopulation auswählen.
Paarweise Ergebnisse berichten r2 und D′. Proxy-Abfragen standardmäßig zu r2 ≥ 0.8 und einem 500 kb Gesamtfenster, ungefähr 250 kb auf beiden Seiten. max_records begrenzt die zurückgegebene Liste nach dem Sortieren, nicht die vorgelagerte Arbeit. Behalten Sie die Population und Abrufen von Metadaten mit dem Ergebnis; Dieser Endpunkt meldet die Referenzbaugruppe oder Ensembl-Freigabe nicht. Leere Ergebnisse bedeuten, dass keine qualifizierenden Daten zurückgegeben werden, nicht Null LD. Hohes LD stellt weder Kausalität noch funktionale Äquivalenz fest. Siehe paarweise Felder und Proxyfelder.
Konservieren von Probe, Ausdruck und Assemblierungskontext
| Abfrage | Interpretation in v1.0.2 |
|---|---|
arrayexpress_get_experiment_samples | samples enthält Beziehungszeilen aus der ersten SDRF-Datei, sortiert nach Pfad. n_rows_total / n_rows_returned Zeilen zählen; n_samples / n_samples_returned Zählen Sie verschiedene Identifikatoren, bevorzugen Probenbezeichnung, dann **Quelle:**fort. Sie sind keine unabhängigen biologischen Replikatzählungen. Fehlende Identifikatoren können zu Stichprobenzählungen führen nullfort. Eine leere Datei oder no_sdrf Die Reaktion stellt nicht fest, dass das Experiment keine Proben hat. |
metabolights_get_studies mit include_samples | Verwenden Sie die zurückgegebene headers Bestellung beim Export sample_tablefort. Wiederholte Spaltennamen haben eindeutige #2, #3, ... Suffixe ohne Überschreibung der Originalnamen. Alle Spalten aufbewahren; einem leeren String in einer kurzen Zeile fehlen Metadaten. Überprüfung rows_truncated. |
bgee_expression_calls | Bleiben anatomical_entity_id/name zusammen mit cell_type_id/namefort. Ein fehlender Zelltyp ist nullNicht ein negativer Ausdruck. Halten Sie den Ausdruck Zustand, Qualität und Zustand zusammen. |
| dbSNP Variante Lookups | Behalten Sie jede Platzierung assembly, assembly_full, seq_id, Position und Allele. Eine Sequenz kann mehr als einer Baugruppe zugeordnet werden; Diese Assoziationen nicht zusammenbrechen oder die erste Platzierung als automatischen Liftover verwenden. |
Diese Korrekturen ändern, wie zurückgegebene Beweise gelesen werden sollten. Überprüfen Sie den Operationsreferenz, bevor Sie eine ältere gespeicherte Antwort mit einem neuen Lookup vergleichen.
OpenAlex-Anmeldeaufforderungen
v1.0.2 erinnert sich an eine abgelehnte OpenAlex-Anmeldeaufforderung für die aktuelle Sitzung, wodurch wiederholte Eingabeaufforderungen vermieden werden. Wenn Sie diese Quelle später benötigen, konfigurieren Sie sie explizit in Settings → Connectors → Literature Graph → Manage credentials → OpenAlex und die beabsichtigte Abfrage wiederholen. Sinkende Eingabeaufforderung liefert weder einen Schlüssel noch garantiert Zugang oder Kontingent.
Verbinden Sie die neuen Quellen und bewahren Sie ihre Bedeutung
In Settings → Connectors, finden Sie den Eintrag unten und erlauben Sie es für Main oder den beabsichtigten Spezialisten. HGNC, PubTator 3, DGIdb und RNAcentral sind Werkzeuge innerhalb bestehender Einträge. Orphadata ist ein separater Eintrag und ist standardmäßig deaktiviert. Diese neuen Tools verwenden öffentliche Endpunkte ohne eigenen API-Schlüssel; andere Tools im selben Eintrag können unterschiedliche Anmeldeanforderungen haben.
| Quelle | Einstellungseintrag | Antrag und Prüfung |
|---|---|---|
| HGNC | Genes & Ontologies | Abfrage eines genehmigten menschlichen Symbols oder Auflösung eines genauen Alias. Behalten Sie jede mehrdeutige Übereinstimmung und den genehmigten / zurückgezogenen Status bei, bevor Sie ein Gen auswählen. |
| PubTator 3 | PubMed | Abrufen von Anmerkungen durch PMID oder Suchentitäten/Beziehungen. Annotation Retrieval deckt Titel / Abstracts ab; es reicht keinen Rohtext ein oder beweist die Volltextunterstützung für einen Anspruch. |
| DGIdb | Clinical Genomics | Abfragen Sie einen Gen- oder Arzneimittelnamen, bewahren Sie Quellen und Publikationen auf und folgen Sie dem zurückgegebenen Cursor. Eine Drogen-Gen-Interaktion ist keine Behandlungsempfehlung. |
| RNAcentral | RNA | Schauen Sie sich einen URS-Beitritt an und blättern Sie dann durch Experten-Datenbank-Querverweise. Bewahren Sie Taxonomie, Sequenz MD5 und Beitrittsversionen. |
| Orphadata | Orphadata | Ermöglichen Sie zuerst den Zugriff und liefern Sie dann einen ORPHA-Code für Gene oder HPO-Phänotypen. Assoziationstypen und Häufigkeitskategorien beibehalten; sie sind keine patientenspezifischen Wahrscheinlichkeiten. |
Genaue Anrufe: HGNC, PubTator, DGIdb, RNAcentral, Orphadata.
Verknüpfen Sie Krebsmetadaten und interpretieren Sie eine Variante
- PDC: öffentliche Demografie und Diagnosefelder mit
pdc_list_clinical. Verwendung entwederpdc_study_idfür die neueste Version oderstudy_idfür eine feste Version. Fehlende/verschleierte Werte und benannte externe Referenzen beibehalten; PDC- und GDC-UUIDs sind nicht austauschbar. - GDC: Filterdateien von
case_ids,sample_typesundworkflow_types. Bewahren Sie die Stichproben-, Aliquoten- und Tumor- / normalen Workflow-Assoziationen jeder Datei auf, anstatt alle Dateien unter einem Fall zusammenzuführen. Filter sind ODER innerhalb eines Feldes und UND über Felder hinweg. Der Zugriff auf Metadaten autorisiert keine Downloads von kontrollierten Dateien. - Ensembl VEP: Pass
hgvs_notationallein, ohnevariant_id,region,alleleoderallele_orientation. Bewahren Sie die gemeldete Assembly, Transkriptversionen und Verkürzungsflags auf. Input-Referenzversionen werden durchlaufen, nicht validiert;matchedstellt keine Versionsübereinstimmung her. Dies ist Konsequenz Annotation, nicht klinische Interpretation oder Liftover. - Clinical Trials: Verwendung
get_trial_resultsfür veröffentlichte Ergebnismessungen, Nenner, statistische Analysen und unerwünschte Ereignisse. Gruppen-IDs nur innerhalb desselben Ergebnismoduls/Ergebnisses übereinstimmen. Fehlende Ergebnisse sind keine Null-Ereignisse oder Beweise für keine Wirkung.
Siehe PDC-Felder, GDC-Filter, VEP-Modus und Veröffentlichte Versuchsergebnisse.
Imaging, Pathways, Lipide und Krebsmodelle
In Settings → Connectors, aktivieren Sie die vorgesehene Quelle und stellen Sie sie zur Verfügung Main. TCIA, KEGG, RxNorm / RxNav, DailyMed, BioSamples und WikiPathways sind separate Einträge, standardmäßig deaktiviert. Die folgenden Operationen verwenden öffentliche Dienste ohne einen benutzerdefinierten MCP-Server oder API-Schlüssel. Durch die Aktivierung eines Connectors wird keine Datenlizenz oder ein eingeschränkter Datenzugriff gewährt.
| Eingang | Antrag | Behalten Sie mit dem Ergebnis |
|---|---|---|
| TCIA | Sammlungen finden; eine Sammlung oder eine bestehende DICOM-Serie UID inspizieren | Lizenz, Zugangsbedingungen und Download-Anforderungen. Zurückgegebene Links können Data Retriever-Manifeste sein, keine Bilddateien. |
| KEGG | Suchpfad/KO/Verbindung/Reaktionseinträge; Kartierung eines Organismus-qualifizierten Gens | Akademische Nutzungsberechtigung und Lizenzbedingungen; One-to-Many-Mappings und Verkürzung. Das ist keine Gen-Set-Anreicherung. |
| Chemie → LIPID MAPS / UniChem | Suchen Sie eine genaue LMID oder PubChem CID; Karte eine InChIKey oder ChEMBL ID | Lösen Sie Namen zuerst mit PubChem. Bewahren Sie verschiedene Übereinstimmungen und Quellenzuordnung; dies sind keine Ähnlichkeitssuchen. |
| Strukturen & Interaktionen → OmniPath | Abfrage Upstream/Downstream Regulierung für einen kanonischen menschlichen UniProt-Zugangsnummer | Richtung, widersprüchliche Stimulations-/Hemmungsnachweise und komplexe Identifikatoren. Aggregierte Beziehungen sind kein gewebespezifischer Kausalbeweis. |
| Strukturen & Interaktionen → PDBe / PDB | Prüfen Sie die experimentelle Strukturvalidierung oder finden Sie ähnliche hinterlegte Proteinketten | Methode und fehlende Metriken; Verwenden Sie label_asym_id, keine Autorketten-ID. Ähnlichkeitswerte sind keine berechnete strukturelle Ausrichtung oder RMSD. |
| Krebsmodelle → DepMap / CCLE | Lösen Sie eine Zelllinie auf ModelID und fragen Sie dann ein Gen- oder Verbindungsprofil ab | Datensatzfreigabe und -skala: Chronos ist keine Wahrscheinlichkeit; PRISM AUC ist nicht IC50; RNA ist log2(TPM+1); Kopienzahl ist relativ zur Ploidie. |
| RxNorm / RxNav · DailyMed | Lösen Sie Arzneimittelnamen auf RxCUIs; prüfen Sie SPL-Labelidentitäten und Versionsverlauf | Behalte mehrdeutige Identitäten. Passende Namen stellen keine klinische Äquivalenz dar; eine DailyMed-Liste stellt keine FDA-Zulassung dar. |
| BioSamples · WikiPathways | Suchen Sie Probenmetadaten oder Pfadmetadaten und Revisionen | Zugangsnummer, Spezies, Quelldaten und verbundene Nachweise. Diese Lookups laden keine verknüpften Probendateien oder Pfadgraphen herunter. |
Verwendung der Operationsreferenz für genaue Eingaben und Paginierung. Bewahren Sie null-Werte und Markierungen für gekürzte Ergebnisse; Ein begrenztes Ergebnis ist nicht die gesamte Datenbank.
Entdecken Sie offizielle Forschungsdaten und Dateilisten
In Settings → Connectors, aktivieren Sie nur die Einträge, die für Ihre Frage erforderlich sind. Die neuen Einträge Europe PMC, Research Datasets, ChEA3, bioDBnet und CTD verwenden öffentliche Dienste ohne einen erforderlichen API-Schlüssel. Anfragen senden weiterhin die bereitgestellten Suchbegriffe, Identifikatoren oder Genlisten an diese Dienste. Verbindungssteuerung.
| Bedarf | Eingabe und Ergebnis | Nächster Schritt |
|---|---|---|
| Biomedizinische Papiere direkt durchsuchen | Europe PMC gibt Kerndatensätze, verfügbare Abstracts und einen Cursor für die nächste Seite zurück | Bezeichner speichern und Paginierung fortsetzen; eine Volltext-URL wird nicht als Volltext abgerufen |
| Finden Sie Umfragen oder klinische Demo-Dateien | Research Datasets listet NHANES-Dateien mit Zyklus-/Dokumentationslinks und öffentlichen MIMIC/eICU-Demos mit fester Version auf | Prüfen Sie Zyklus, Version, Lizenz und Dokumentation, bevor Sie von der offiziellen Quelle herunterladen |
| Dataset-Zugriff verstehen | Research Datasets erklärt Einstiegspunkte für NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, FAERS und GBD | Füllen Sie bei Bedarf den eigenen Registrierungs-, Schulungs- oder Exportprozess der Quelle aus |
| Entdecken Sie öffentliche Berichte | Drug Regulatory, CTD und Cellosaurus Liste der offiziellen Dateistandorte | Überprüfen Sie die aktuelle Quellseite, Release und Bedingungen; Discovery lädt oder importiert keine Dateien |
| Gen-Identifikatoren normalisieren | Genes & Ontologies HGNC-Dienstfelder, Feldabfragen und Dateilisten hinzufügt; bioDBnet fügt Conversion und Ortholog Mapping hinzu | Unterstützte Felder/Typen zuerst entdecken; zweideutige, nicht zugeordnete und eins-zu-viele Ergebnisse beibehalten |
| Rang Kandidaten Regulierungsbehörden | ChEA3 Gibt pro Bibliothek Transkriptionsfaktor-Rankings und GMT-Bibliothekslinks zurück | Behandeln Sie Rankings als Hypothesen; eine heruntergeladene GMT-Bibliothek kann sich von der Bibliothek hinter einem Online-Ergebnis unterscheiden |
| Zellliniennachweise prüfen | Cellosaurus fügt RDF, Bounded SPARQL und STR Ähnlichkeit hinzu | Beitritts- und Markereinstellungen bewahren; Ähnlichkeit allein bescheinigt keine Musteridentität |
Dateilisten geben offizielle URLs und Quellmetadaten zurück, nicht heruntergeladene Dateien oder eine fertige Analysedatenbank. Die NHANES-Analyse erfordert immer noch das richtige Umfragedesign und die richtigen Gewichte. MIMIC/eICU Demo Access gewährt keinen Zugriff auf ihre vollständigen Datensätze. FAERS-Berichte können nicht als Inzidenzraten interpretiert werden. Für genaue Felder und Beispiele verwenden Sie die Betriebsnummer.