Compruebe un resultado de regresión con un conjunto de datos público
Ejemplo práctico Ganancias después de un experimento de formación profesional
Usted tiene un pequeño conjunto de datos económicos y desea saber si un resultado cambia cuando se incluyen las características de referencia. Este ejemplo lleva a cabo una comparación injustificada y una regresión ajustada preestablecida, a continuación, ahorra las estimaciones y su incertidumbre.
Aplicable: a Notebook cálculo, un coeficiente CSV y un informe en inglés. Utiliza la muestra experimental de observación 445 en jtrain2, atribuida al análisis de trabajo de apoyo nacional de LaLonde por el wooldridge data dictionary.
Preparar y adjuntar los datos
- Descargar jtrain2.csv de Rdatasets y leer las definiciones variables en el diccionario.
- Cree un proyecto y confirme que un Hora de correr Python está habilitado. Este ejemplo utiliza
pandasystatsmodels; instalar paquetes perdidos en el entorno seleccionado cuando sea necesario. - Abra una conversación, seleccione un modelo de trabajo, luego elija + → Attach files y seleccione el CSV. Confirme el apego aparece antes de enviar.
El resultado re78 y las variables de base re74 y re75 son ganancias reales en miles de dólares. Se refieren a los ingresos en 1978, 1974 y 1975 respectivamente. Las ganancias cero son observaciones válidas. train identifica la asignación de capacitación; mostrn describe meses de entrenamiento y no es una variable de ajuste de referencia.
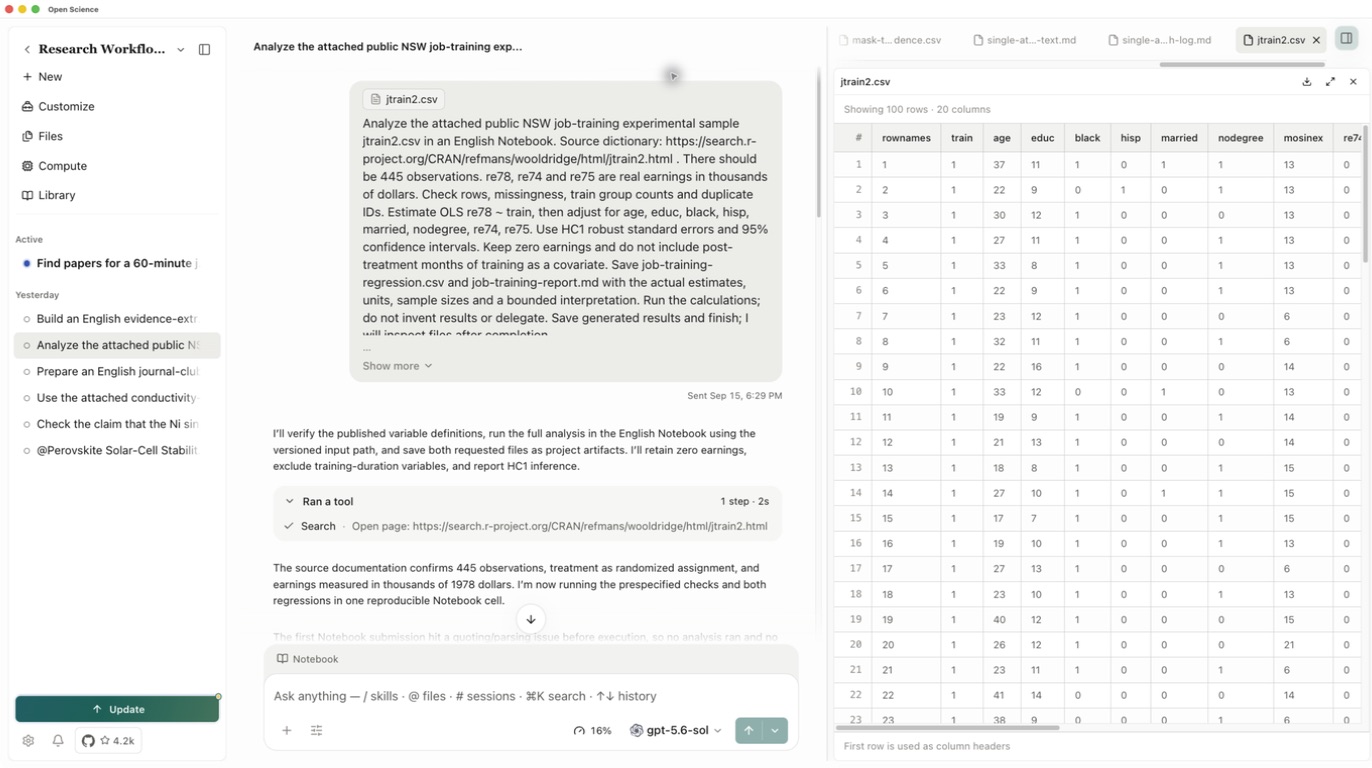
Haga clic en el CSV adjunto para previsualizarlo antes de enviar la solicitud de cálculo. Chequee train, re78, re74 y re75, incluyendo filas con cero ganancias. La vista previa puede mostrar sólo filas 100; el Notebook debe contar todo el archivo.
Ejecute la comparación preespeciada
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
Revise el código solicitado cuando aparezca la aprobación. Debe leer el CSV adjunto, caber los dos modelos especificados y guardar los productos. Abra Notebook para inspeccionar el resultado de ejecución real. Si la ejecución falla, resuelva el error mostrado antes de tratar cualquier prose como resultado calculado.
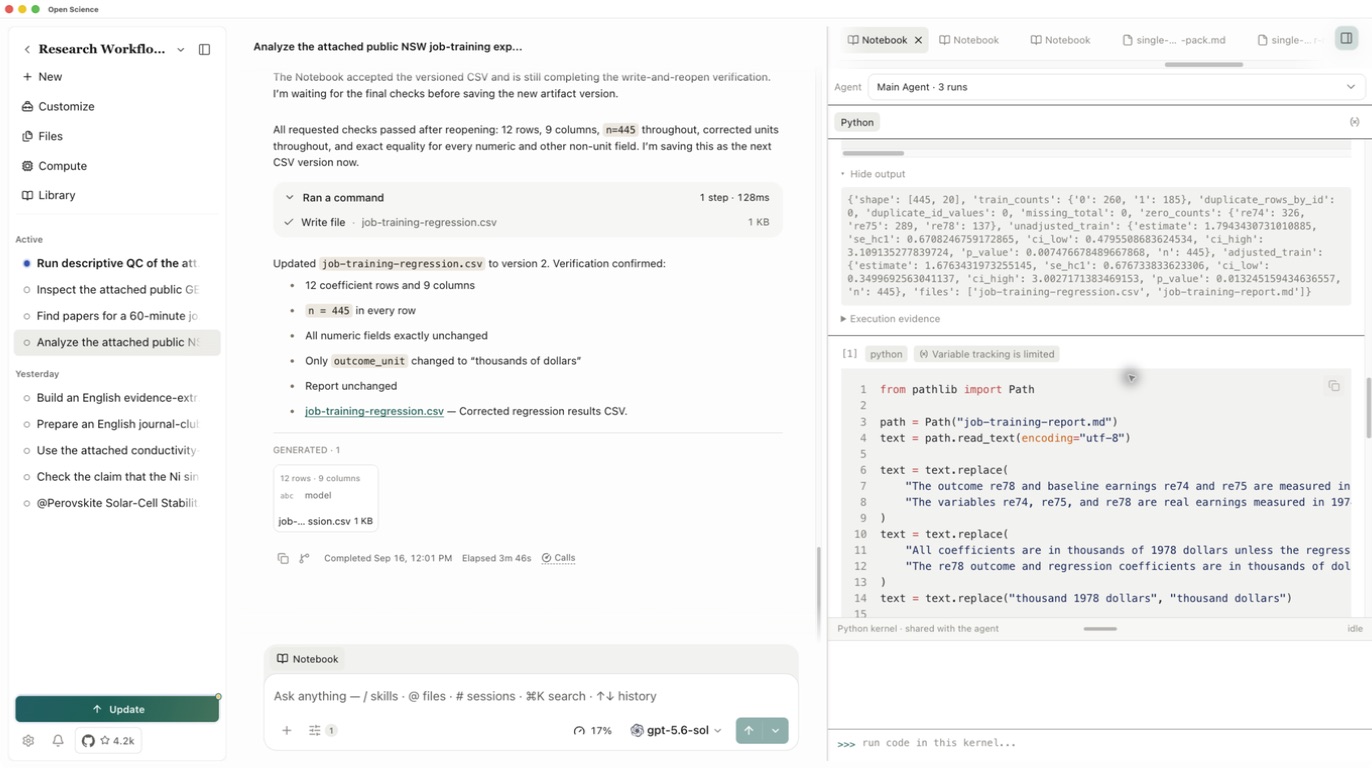
En la conversación, elija Notebook, abra la célula Python ejecutada e inspeccione su salida. Busque la fila y el grupo cuenta antes del resumen de regresión. Si la versión adjunta no puede ser resuelta, pídale al Agente que lea el archivo montado del apego y la reiniciación de esta conversación; una célula fallida no es un resultado. Mantenga la célula exitosa y su salida con los archivos guardados.
Inspeccione el resultado salvado
El ejemplo se completó con Renglones 445, 185 asignado a la formación, Controles 260, sin valores perdidos y sin identificadores de fila duplicados. Ambas regresiones retuvieron todas las observaciones de 445.
| Modelo | Coeficiente de capacitación | HC1 error estándar | intervalo de confianza 95% |
|---|---|---|---|
| Injustificada | 1.794 | 0.671 | 0.480 a 3.109 |
| Ajuste de las variables de referencia | 1.676 | 0.677 | 0.350 a 3.003 |
Los coeficientes y los intervalos están en miles de dólares. Estos son los resultados del cálculo de este ejemplo, no las estimaciones citadas del papel original.
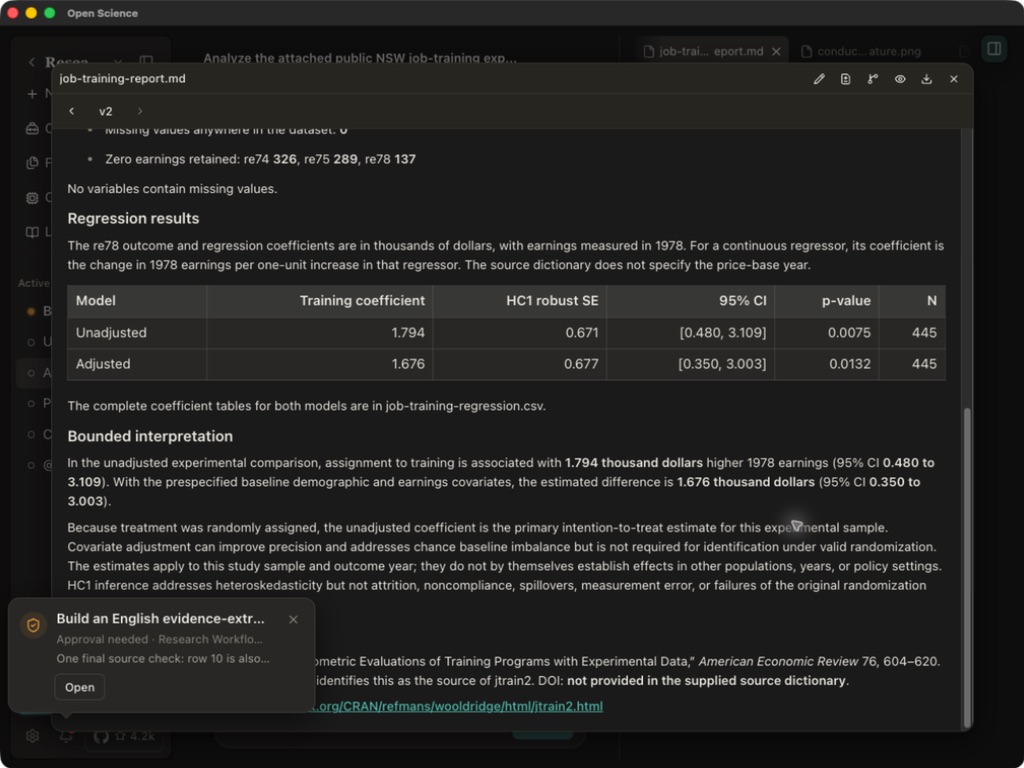
Abra ambos archivos generados después de que la respuesta termine. Compare las filas train en el CSV con el informe y Notebook. Puede descargar Cuadro de coeficientes y informe.
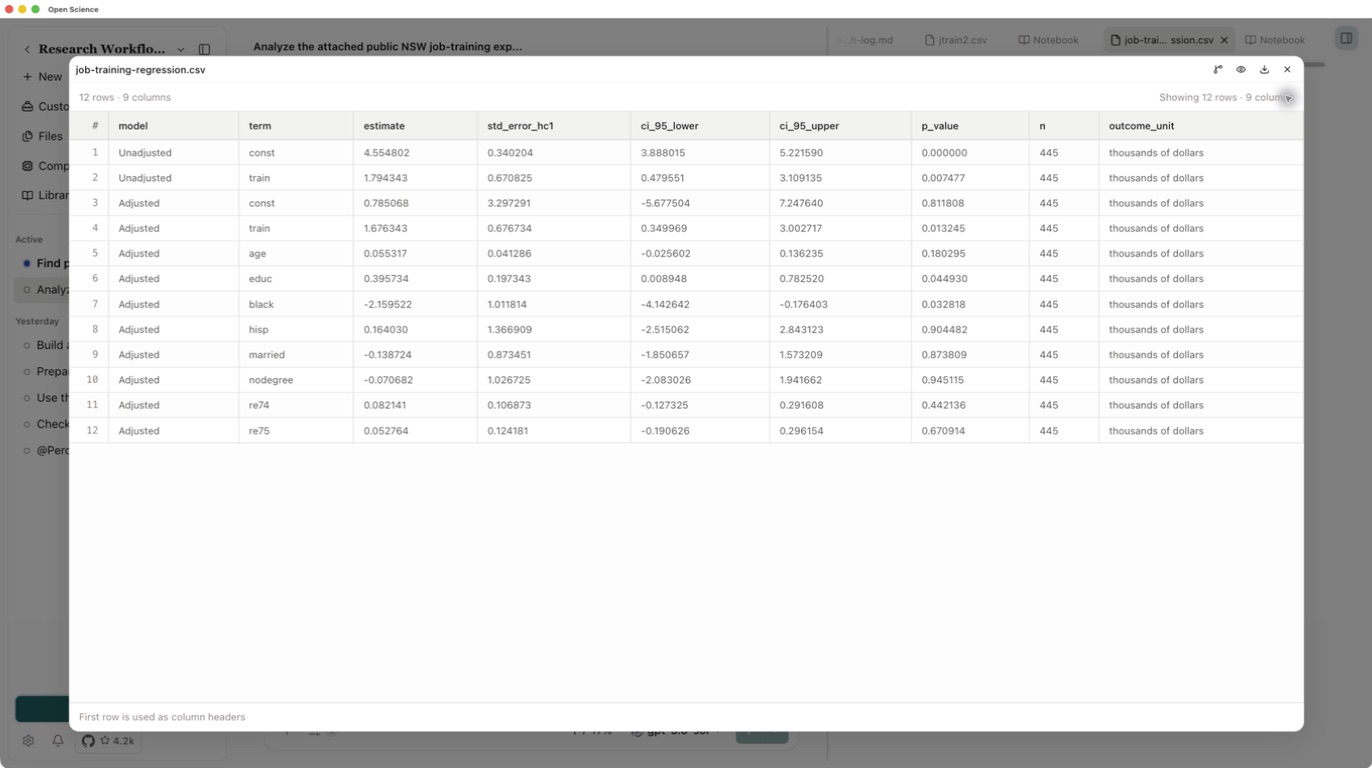
En Generated, abre el CSV y expande su vista previa. La tabla de coeficiente guardada tiene filas 12 · columnas 9: dos filas para el modelo no ajustado y diez para el modelo ajustado. Localice la fila train de cada modelo y compare su estimación, error estándar robusto, intervalo, n y unidad. No agregue un año base de inflación que el diccionario fuente no indica. Utilice el botón Download de la vista previa para mantener la versión revisada.
Decidir qué soporta la comparación
El ajuste de la base cambia la estimación de aproximadamente 1.79 a 1.68 mil dólares. Eso es un control de sensibilidad para estas dos especificaciones. No establece la robustez para cada elección de modelado o generaliza el experimento a otras poblaciones y años. Los errores estándar HC1 abordan la heteroskedasticidad; no reparan problemas en el diseño original del estudio.
Para entregar el análisis a un colega, retenga el CSV original, diccionario variable, código y entorno seleccionado. Utilice Comprobaciones de reproducción para evaluar lo que está disponible para una repetición posterior.