用公開資料檢查迴歸結果
案例演示 就業培訓實驗後的收入變化
已有一份小型經濟學資料,想確認加入基線特徵後,結果是否變化。本例先進行未調整比較,再執行預先指定的調整迴歸,儲存估計值及其不確定性。
交付結果: Notebook 計算、迴歸係數 CSV 和英文報告。使用 jtrain2 中的 445 條實驗樣本;wooldridge 資料字典將其來源歸於 LaLonde 對 National Supported Work 專案的分析。
準備並附加資料
- 從 Rdatasets 下載 jtrain2.csv,閱讀資料字典中的變數定義。
- 建立專案,確認已啟用 Python 執行時。本例使用
pandas和statsmodels,缺少時需在選中的環境中安裝。 - 開啟會話,選擇可用模型,透過 + → Attach files 選擇 CSV。傳送前確認附件已顯示。
結果變數 re78 和基線變數 re74、re75 的單位是千美元。三者分別對應 1978、1974 和 1975 年的實際收入。收入為零是有效觀測。train 表示培訓分配;mostrn 是實際培訓月數,不屬於基線調整變數。
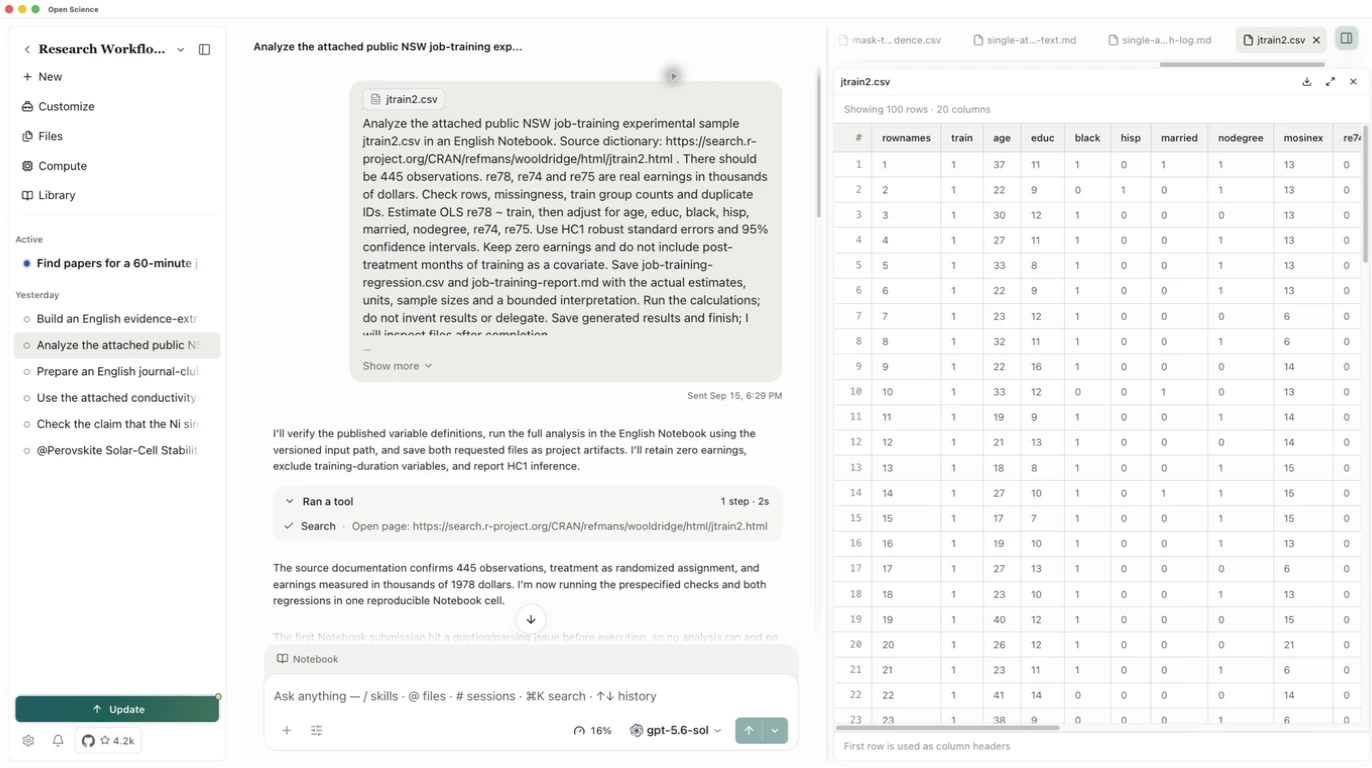
計算前點選附加的 CSV 預覽,檢查 train、re78、re74、re75 及收入為零的記錄。預覽可能只顯示 100 行,完整檔案的行數應由 Notebook 計算。
執行預先指定的比較
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
出現審批時檢查請求中的程式碼:應讀取附加的 CSV,擬合指定的兩個模型並儲存結果。開啟 Notebook 檢視實際執行結果。如果執行失敗,應先處理顯示的錯誤,再判斷文字回答是否有真實計算支撐。
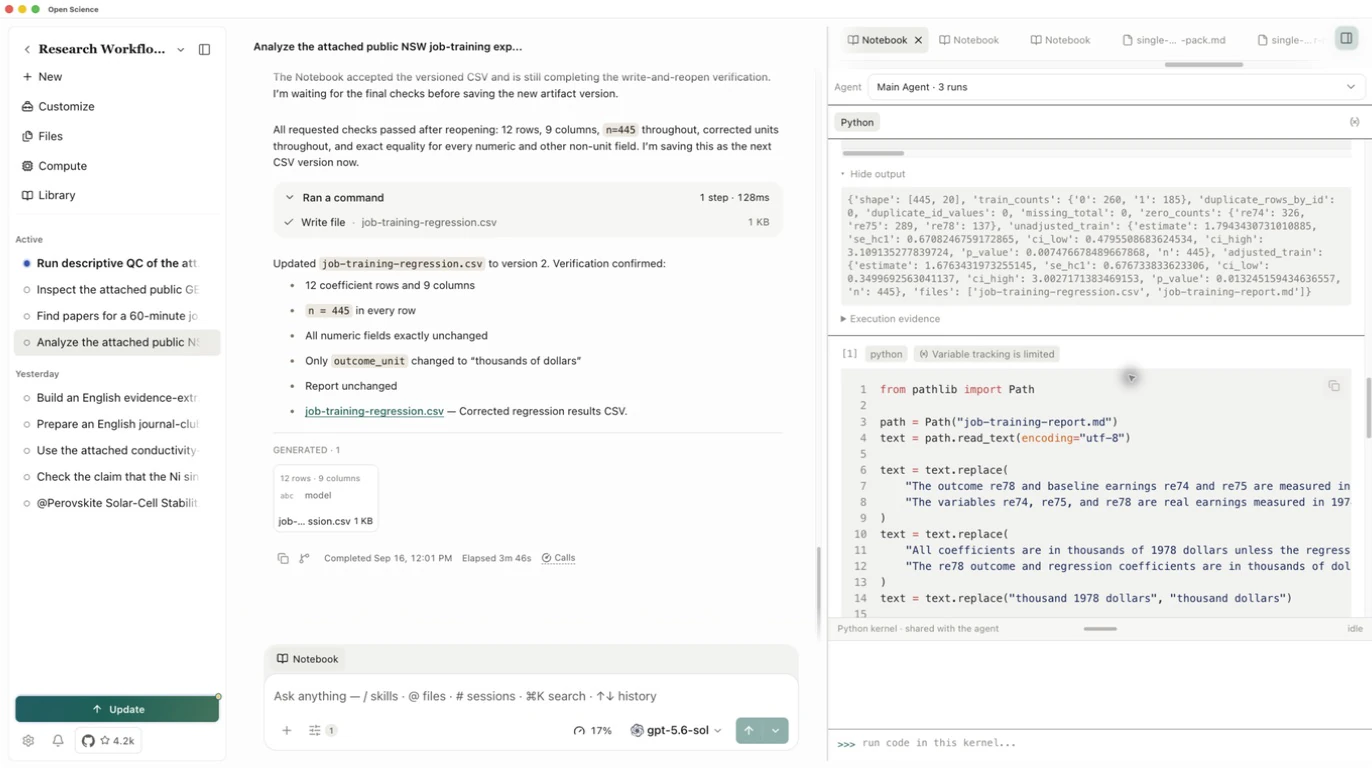
在會話中點選 Notebook,開啟實際執行的 Python 單元,先檢查輸出中的行數和分組人數,再看回歸結果。若附件版本無法解析,要求 Agent 讀取本會話附件掛載的檔案並重試;失敗的單元不能作為計算結果。保留成功執行的程式碼和輸出。
檢查儲存後的結果
本例完成時共有 445 行,其中 185 人分配到培訓組、260 人為對照,無缺失值和重複行標識。兩個迴歸都保留全部 445 條觀測。
| 模型 | 培訓係數 | HC1 標準誤 | 95% 置信區間 |
|---|---|---|---|
| 未調整 | 1.794 | 0.671 | 0.480 至 3.109 |
| 調整基線變數 | 1.676 | 0.677 | 0.350 至 3.003 |
係數與區間的單位均為千美元。這些是本例計算所得的結果,不是直接引用原論文的估計值。
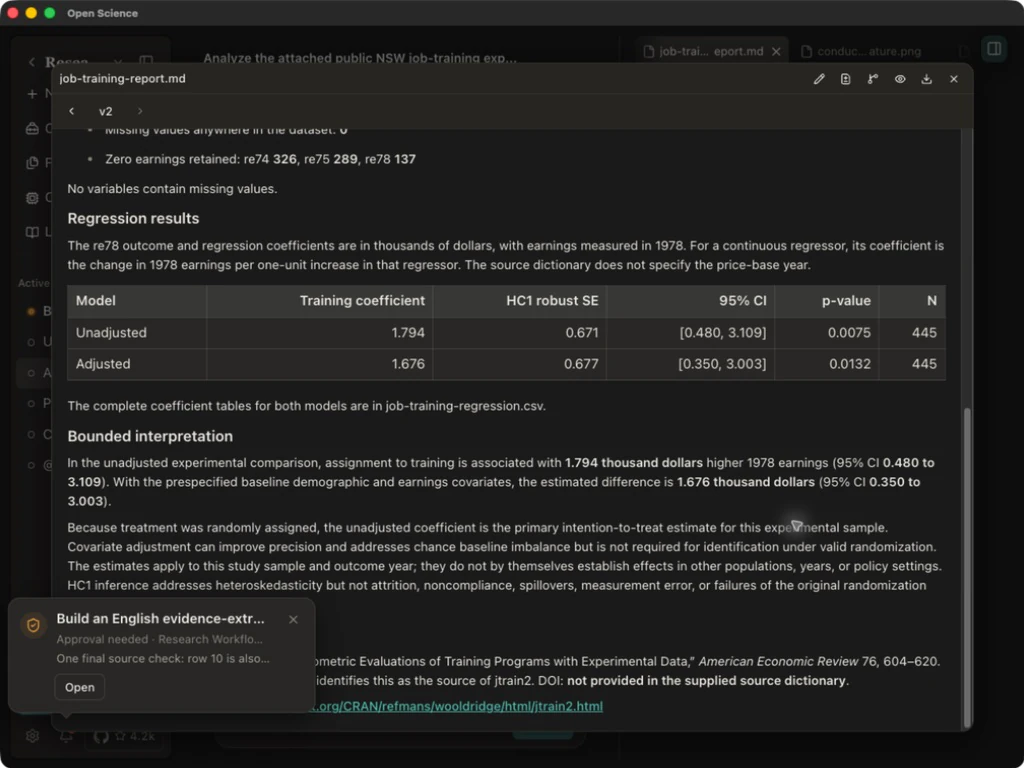
回答完成後開啟兩個生成檔案,將 CSV 中的 train 行與報告和 Notebook 對照。可下載本次執行的係數表和報告。
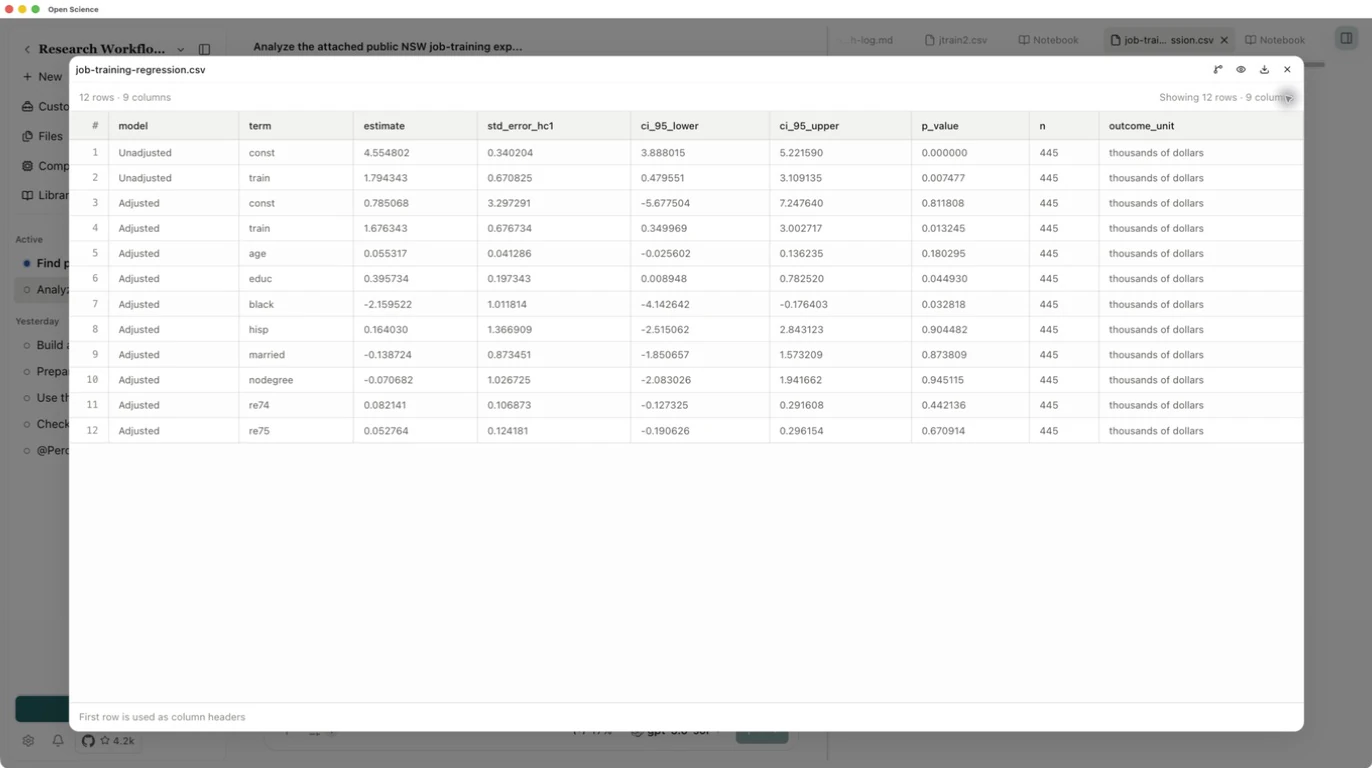
在 Generated 中開啟 CSV,展開預覽。本次係數表為 12 rows · 9 columns:未調整模型兩行,調整模型十行。分別找到兩個模型的 train 行,檢查估計值、穩健標準誤、區間、n 和單位。資料字典未註明的通脹基年不要自行補寫。使用預覽的 Download 按鈕儲存核對後的版本。
判斷這次比較說明了什麼
加入基線調整後,估計值從約 1.79 變為 1.68 千美元。這是對兩個指定模型的敏感性檢查,不能說明所有建模選擇下都穩健,也不能直接推廣到其他人群和年份。HC1 標準誤處理異方差,不會修復原研究設計中的問題。
交給同事複用時,應保留原始 CSV、變數字典、程式碼和所選環境。透過可復現性檢查判斷後續重新執行還需要哪些材料。