Проверьте результат регрессии с помощью общедоступного набора данных
Практический пример Заработок после эксперимента по обучению работе
У вас есть небольшой набор экономических данных и вы хотите знать, изменяется ли результат при включении базовых характеристик. В этом примере проводится нескорректированное сравнение и предварительно заданная скорректированная регрессия, затем сохраняются оценки и их неопределенность.
Доставка: - расчет Notebook, коэффициент CSV и английский отчет. Он использует экспериментальную выборку 445-наблюдения в jtrain2, приписанную анализу Национальной вспомогательной работы Лалонда wooldridge data dictionary.
Подготовьте и прикрепите данные
- Загрузите jtrain2.csv из Rdatasets и прочитайте в словаре переменные определения.
- Создайте проект и подтвердите, что включен Python Runtime. В данном примере используются
pandasиstatsmodels; Установите недостающие пакеты в выбранной среде, когда это необходимо. - Откройте разговор, выберите рабочую модель, затем выберите + → Attach files и выберите CSV. Подтвердите, что вложение появляется перед отправкой.
Результат re78 и базовые переменные re74 и re75 являются реальными доходами в тысячи долларов. Они относятся к прибыли в 1978, 1974 и 1975 соответственно. Нулевой заработок – это достоверные наблюдения. train определяет учебное задание; mostrn описывает месяцы обучения и не является базовой переменной регулировки.
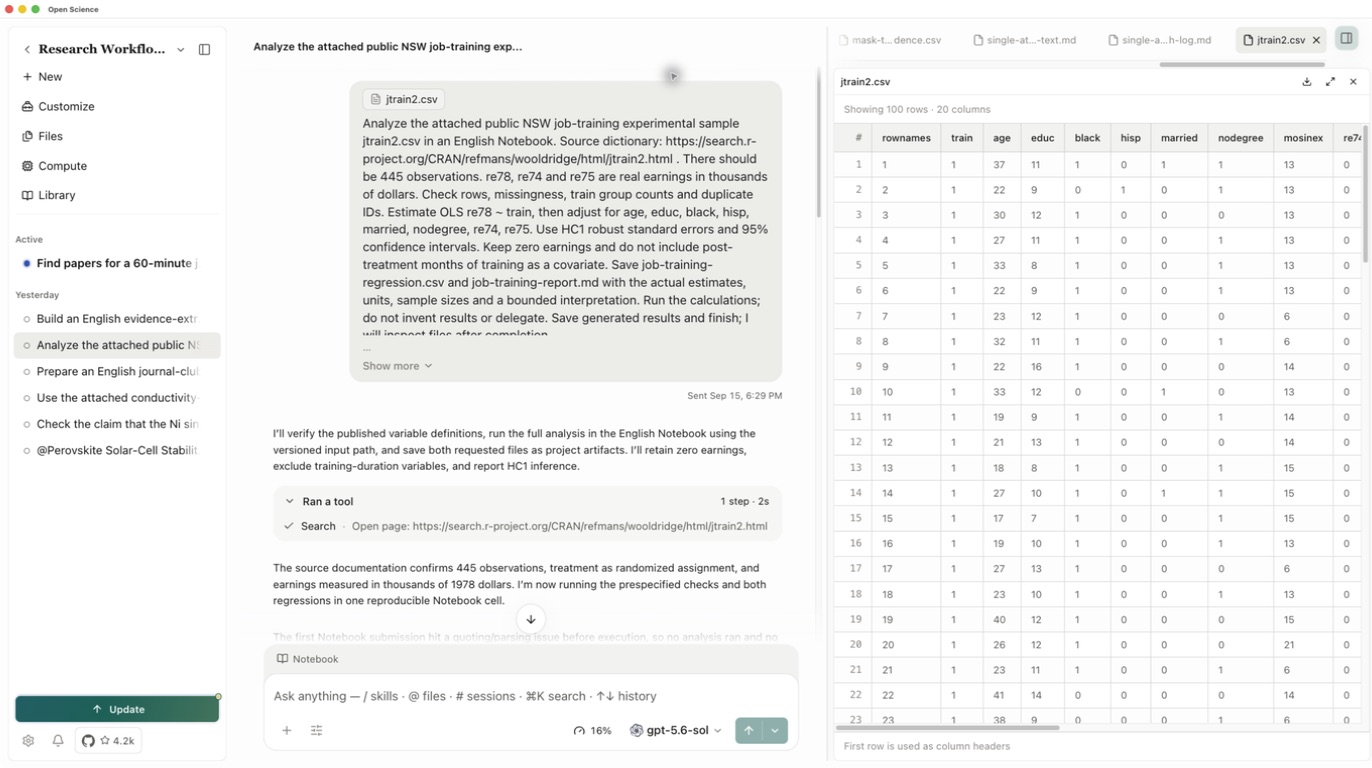
Нажмите на прилагаемый CSV, чтобы просмотреть его перед отправкой запроса на вычисление. Проверьте train, re78, re74 и re75, включая строки с нулевой прибылью. Предварительный просмотр может показывать только строки 100; Notebook должен считать весь файл.
Проведите предварительное сравнение
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
Просмотрите запрашиваемый код при появлении одобрения. Он должен считывать прилагаемый CSV, соответствовать двум указанным моделям и сохранять выходы. Откройте Notebook, чтобы проверить фактический результат выполнения. Если выполнение не удается, устраните отображаемую ошибку, прежде чем рассматривать любую прозу как рассчитанный результат.
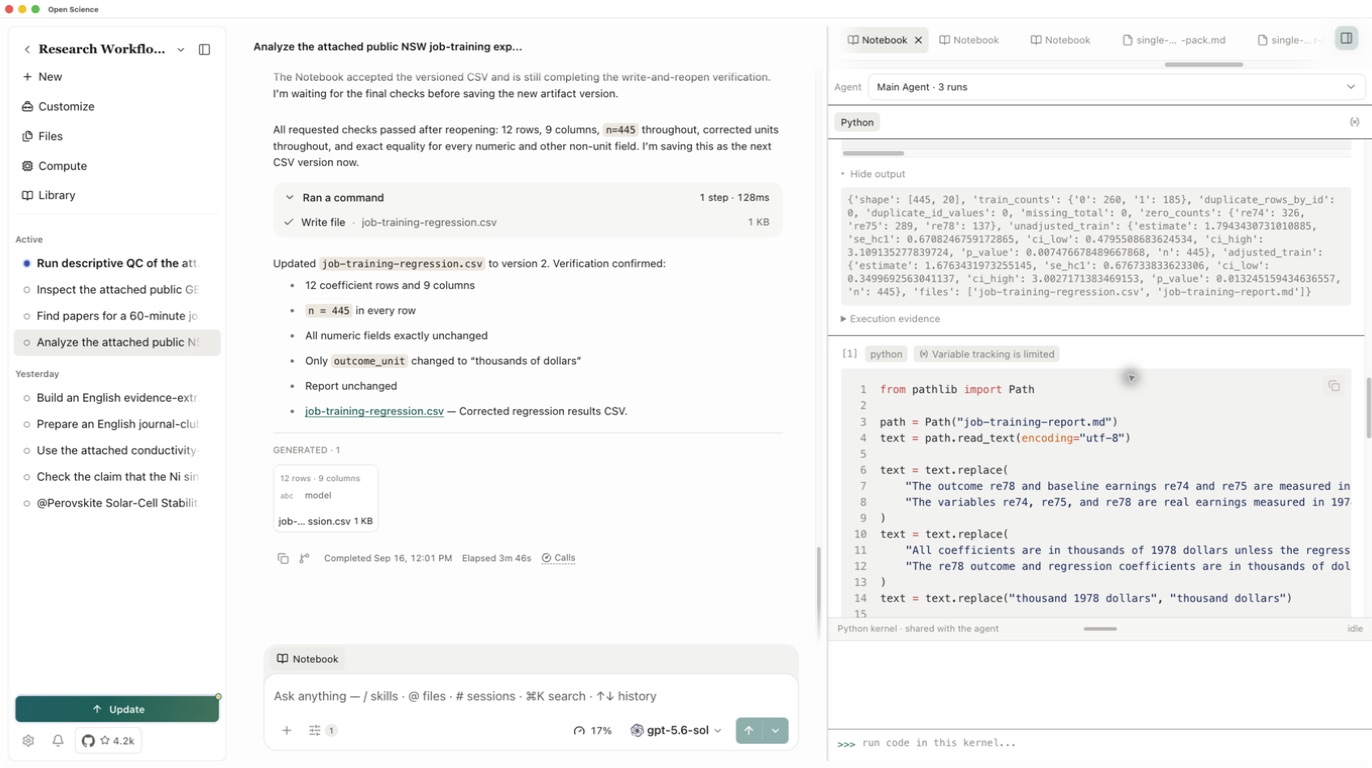
В разговоре выберите Notebook, откройте выполненную ячейку Python и проверьте ее выход. Ищите строку и количество групп перед резюме регрессии. Если приложенная версия не может быть решена, попросите агента прочитать файл, смонтированный из вложения и повторного использования этого разговора; Неудавшаяся клетка не является результатом. Сохраняйте успешную ячейку и ее выход с сохраненными файлами.
Проверить сохраненный результат
Пример выполнен с 445 строки, 185 назначен на обучение, 260 контролирует, без отсутствующих значений и без идентификаторов дубликатов строк. Обе регрессии сохранили все наблюдения 445.
| Модель | Коэффициент подготовки | Стандартная ошибка HC1 | Доверительный интервал 95% |
|---|---|---|---|
| нескорректированный | 1.794 | 0.671 | 0.480 и 3.109 |
| Скорректировано для базовых переменных | 1.676 | 0.677 | 0.350 и 3.003 |
Коэффициенты и интервалы находятся в тысячи долларов. Это результаты расчета этого примера, а не цитируемые оценки из оригинальной статьи.
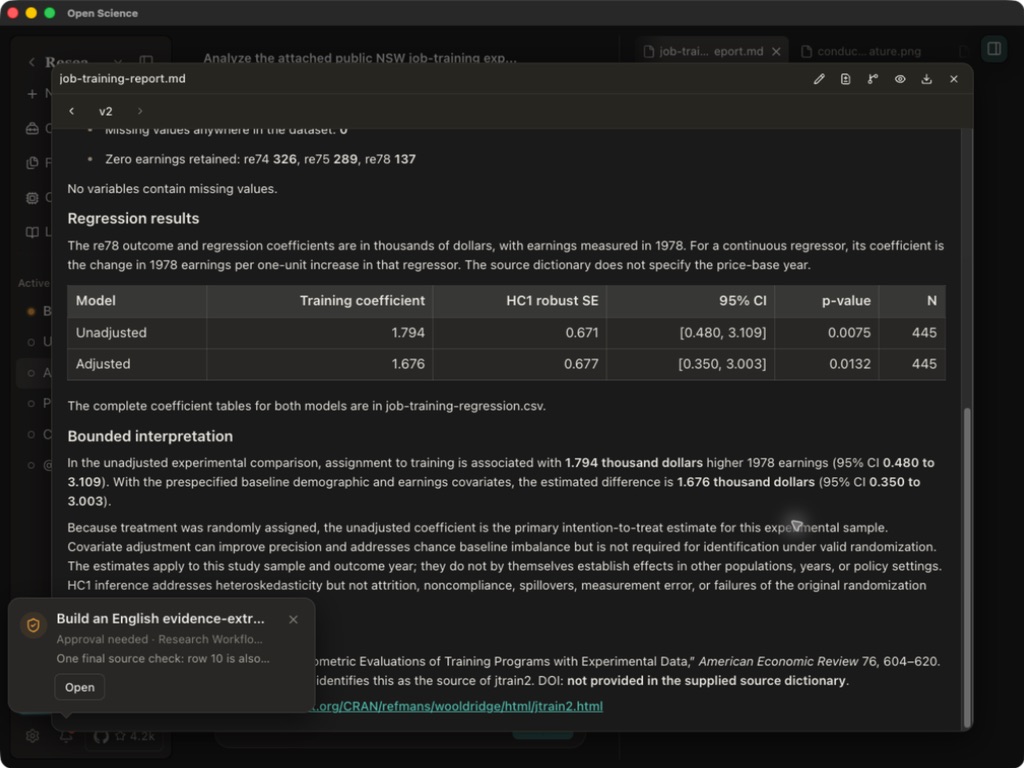
Откройте оба сгенерированных файла после завершения ответа. Сравните строки train в CSV с отчетом и Notebook. Вы можете скачать таблица коэффициентов и доклад.
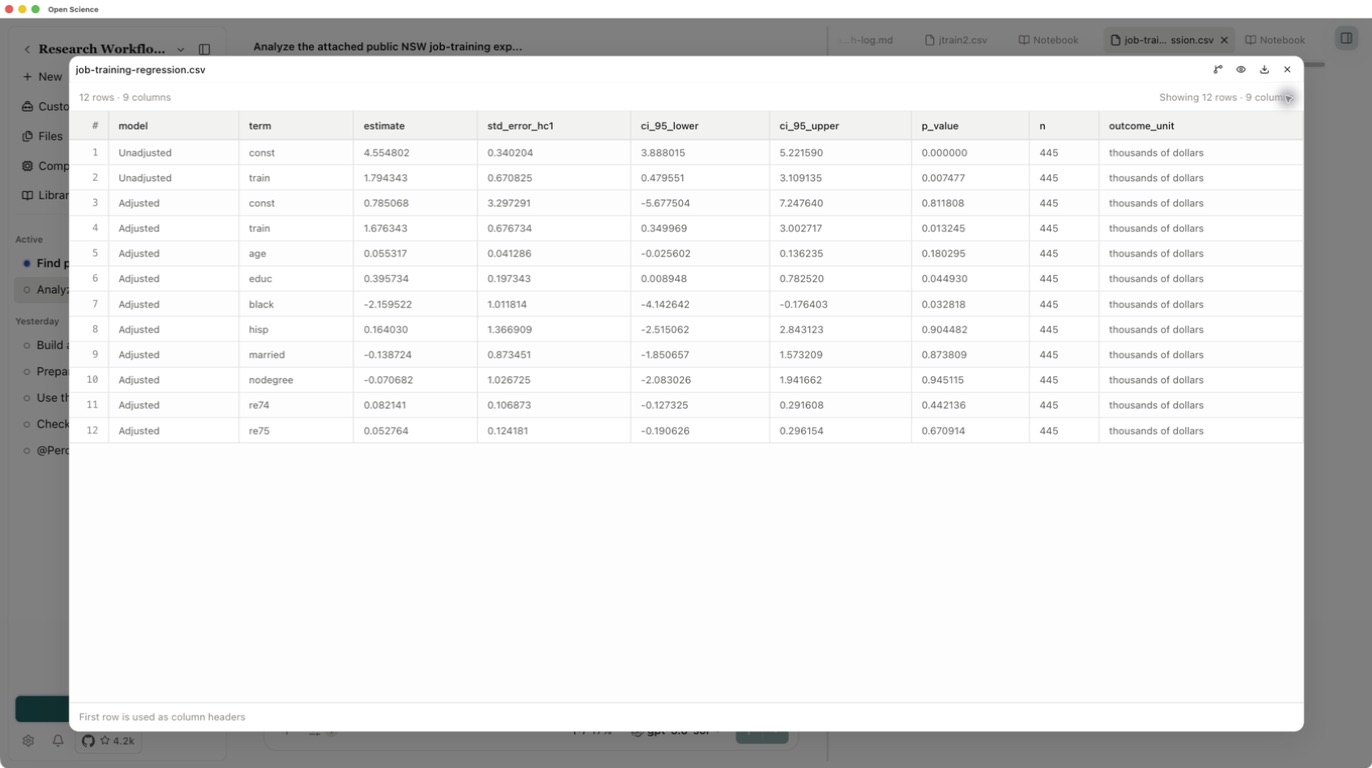
В Generated откройте CSV и расширьте его превью. Сэкономленная таблица коэффициентов имеет 12 строки · 9 столбцы: два ряда для нескорректированной модели и десять для скорректированной модели. Найдите строку train каждой модели и сравните ее оценку, стандартную ошибку, интервал, n и блок. Не добавляйте базовый год инфляции, который не указан в словаре источника. Используйте кнопку предварительного просмотра Download, чтобы сохранить проверенную версию.
Определите, что поддерживает сравнение
Поправка на исходные характеристики меняет оценку примерно с 1.79 до 1.68 тысячи долларов. Это проверка чувствительности к двум спецификациям модели, а не доказательство устойчивости ко всем вариантам моделирования или применимости к другим популяциям и годам. Стандартные ошибки HC1 учитывают гетероскедастичность, но не исправляют недостатки исходного дизайна исследования.
Чтобы передать анализ коллеге, сохраните исходный CSV, переменный словарь, код и выбранную среду. Используйте Проверка воспроизводимости для оценки того, что доступно для последующего повтора.