用公开数据检查回归结果
案例演示 就业培训实验后的收入变化
已有一份小型经济学数据,想确认加入基线特征后,结果是否变化。本例先进行未调整比较,再运行预先指定的调整回归,保存估计值及其不确定性。
交付结果: Notebook 计算、回归系数 CSV 和英文报告。使用 jtrain2 中的 445 条实验样本;wooldridge 数据字典将其来源归于 LaLonde 对 National Supported Work 项目的分析。
准备并附加数据
- 从 Rdatasets 下载 jtrain2.csv,阅读数据字典中的变量定义。
- 创建项目,确认已启用 Python 运行时。本例使用
pandas和statsmodels,缺少时需在选中的环境中安装。 - 打开会话,选择可用模型,通过 + → Attach files 选择 CSV。发送前确认附件已显示。
结果变量 re78 和基线变量 re74、re75 的单位是千美元。三者分别对应 1978、1974 和 1975 年的实际收入。收入为零是有效观测。train 表示培训分配;mostrn 是实际培训月数,不属于基线调整变量。
计算前点击附加的 CSV 预览,检查 train、re78、re74、re75 及收入为零的记录。预览可能只显示 100 行,完整文件的行数应由 Notebook 计算。
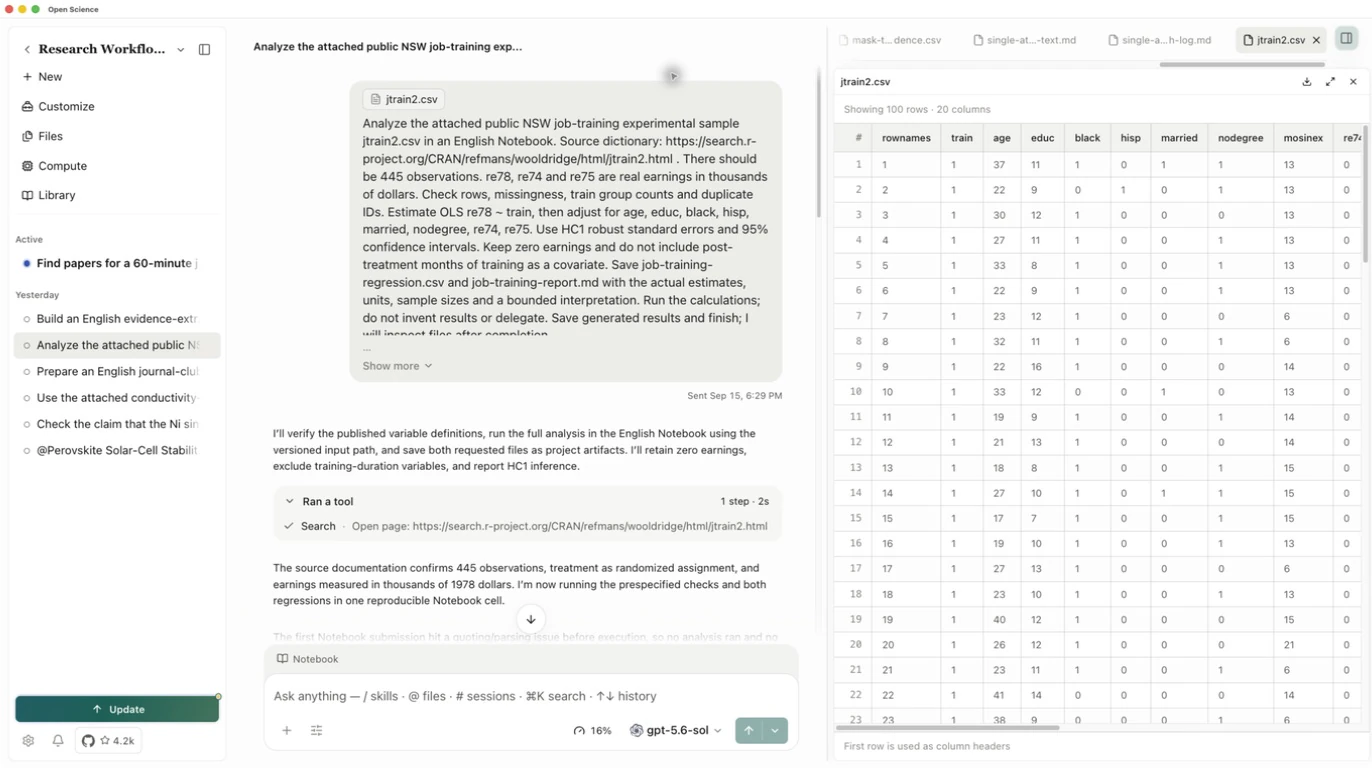
运行预先指定的比较
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
出现审批时检查请求中的代码:应读取附加的 CSV,拟合指定的两个模型并保存结果。打开 Notebook 查看实际执行结果。如果运行失败,应先处理显示的错误,再判断文字回答是否有真实计算支撑。
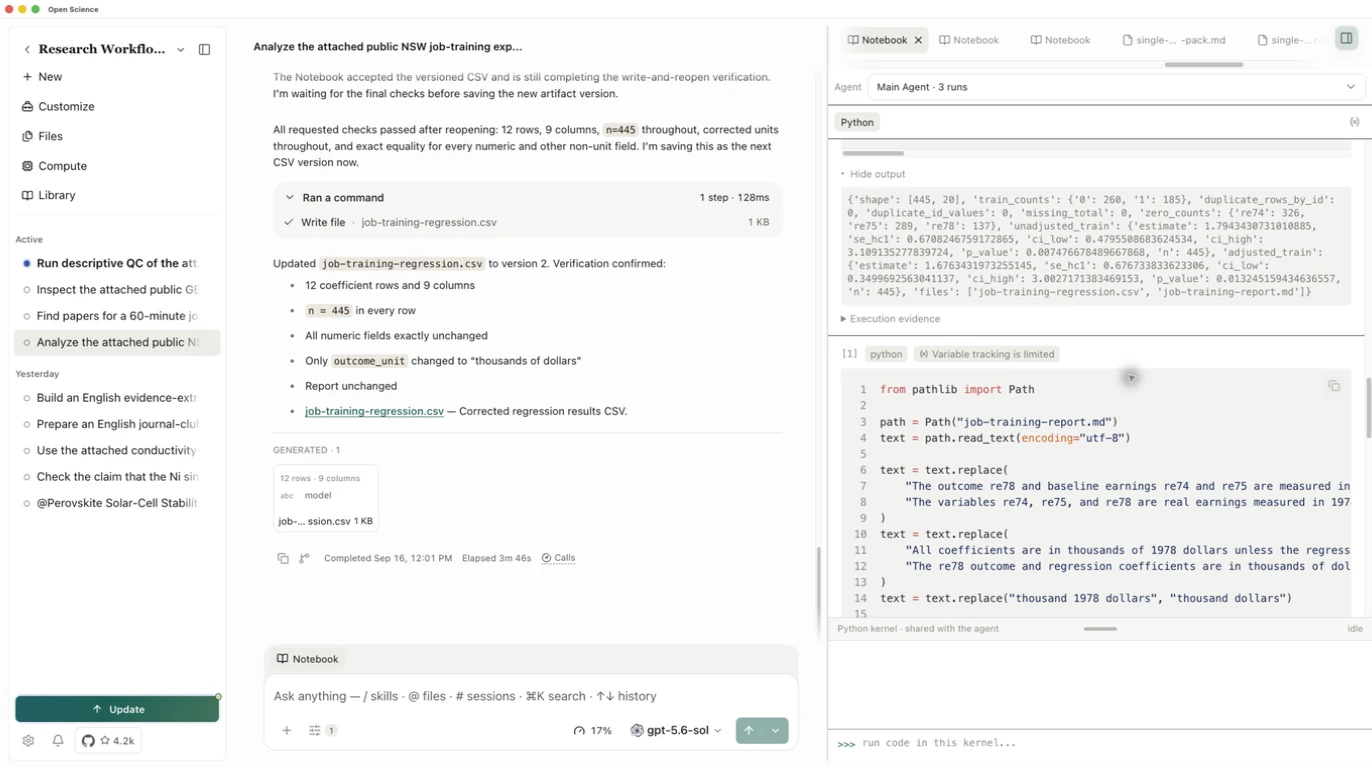
在会话中点击 Notebook,打开实际执行的 Python 单元,先检查输出中的行数和分组人数,再看回归结果。若附件版本无法解析,要求 Agent 读取本会话附件挂载的文件并重试;失败的单元不能作为计算结果。保留成功执行的代码和输出。
检查保存后的结果
本例完成时共有 445 行,其中 185 人分配到培训组、260 人为对照,无缺失值和重复行标识。两个回归都保留全部 445 条观测。
| 模型 | 培训系数 | HC1 标准误 | 95% 置信区间 |
|---|---|---|---|
| 未调整 | 1.794 | 0.671 | 0.480 至 3.109 |
| 调整基线变量 | 1.676 | 0.677 | 0.350 至 3.003 |
系数与区间的单位均为千美元。这些是本例计算所得的结果,不是直接引用原论文的估计值。
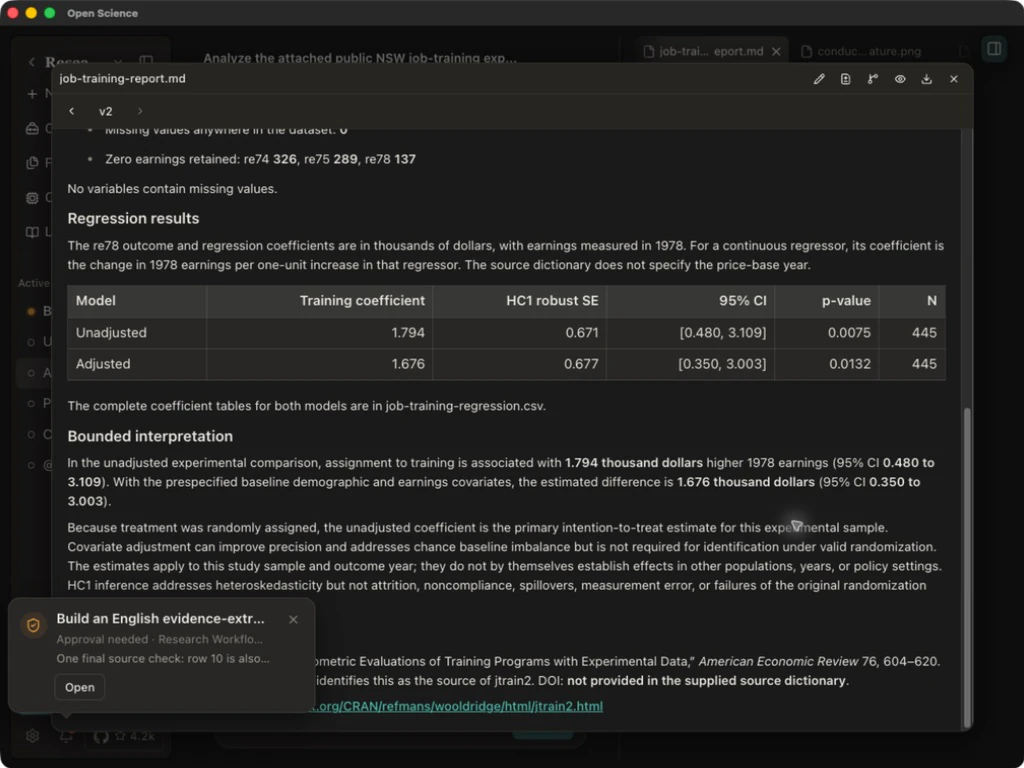
回答完成后打开两个生成文件,将 CSV 中的 train 行与报告和 Notebook 对照。可下载本次运行的系数表和报告。
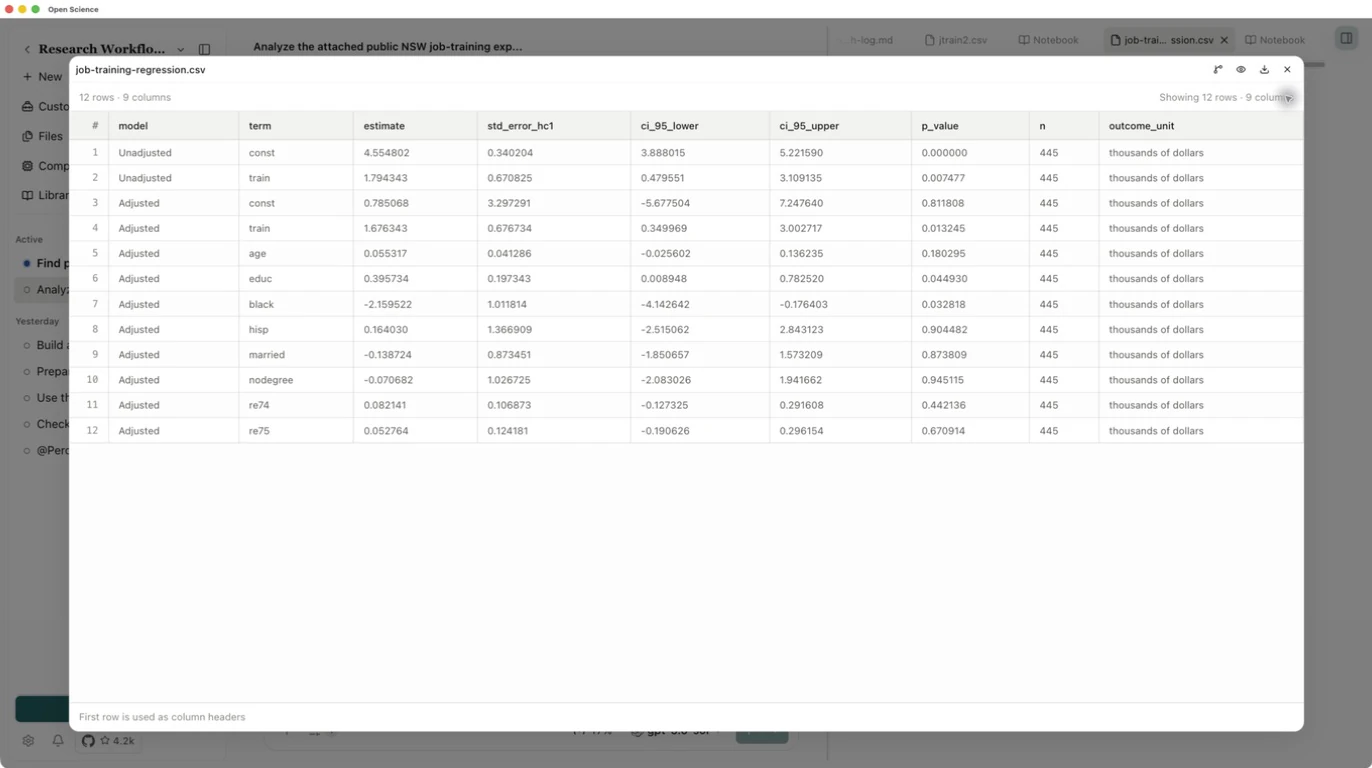
在 Generated 中打开 CSV,展开预览。本次系数表为 12 rows · 9 columns:未调整模型两行,调整模型十行。分别找到两个模型的 train 行,检查估计值、稳健标准误、区间、n 和单位。数据字典未注明的通胀基年不要自行补写。使用预览的 Download 按钮保存核对后的版本。
判断这次比较说明了什么
加入基线调整后,估计值从约 1.79 变为 1.68 千美元。这是对两个指定模型的敏感性检查,不能说明所有建模选择下都稳健,也不能直接推广到其他人群和年份。HC1 标准误处理异方差,不会修复原研究设计中的问题。
交给同事复用时,应保留原始 CSV、变量字典、代码和所选环境。通过可复现性检查判断后续重新运行还需要哪些材料。