Vérifier un résultat de régression avec un ensemble de données publiques
Exemple pratique Gains après une expérience de formation professionnelle
Vous avez un petit ensemble de données économiques et vous voulez savoir si un résultat change lorsque les caractéristiques de base sont incluses. Cet exemple fait une comparaison non ajustée et une régression ajustée prédéfinie, puis économise les estimations et leur incertitude.
Produit livrable : un calcul Notebook, un coefficient CSV et un rapport en anglais. Il utilise l'échantillon expérimental d'observation 445 de jtrain2, attribué à l'analyse du travail soutenu national de LaLonde par le wooldridge data dictionary.
Préparer et joindre les données
- Téléchargez jtrain2.csv de Rdatasets et lisez les définitions des variables dans le dictionnaire.
- Créez un projet et confirmez qu'un Python temps d'exécution est activé. Cet exemple utilise
pandasetstatsmodels; installer les paquets manquants dans l'environnement sélectionné au besoin. - Ouvrez une conversation, sélectionnez un modèle de travail, puis choisissez + → Attach files et sélectionnez CSV. Confirmez que la pièce jointe apparaît avant l'envoi.
Les résultats re78 et les variables de base re74 et re75 sont des gains réels dans milliers de dollars. Ils se réfèrent aux gains en 1978, 1974 et 1975 respectivement. Les gains nuls sont des observations valables. train identifie l'affectation de formation; mostrn décrit les mois de formation et n'est pas une variable d'ajustement de base.
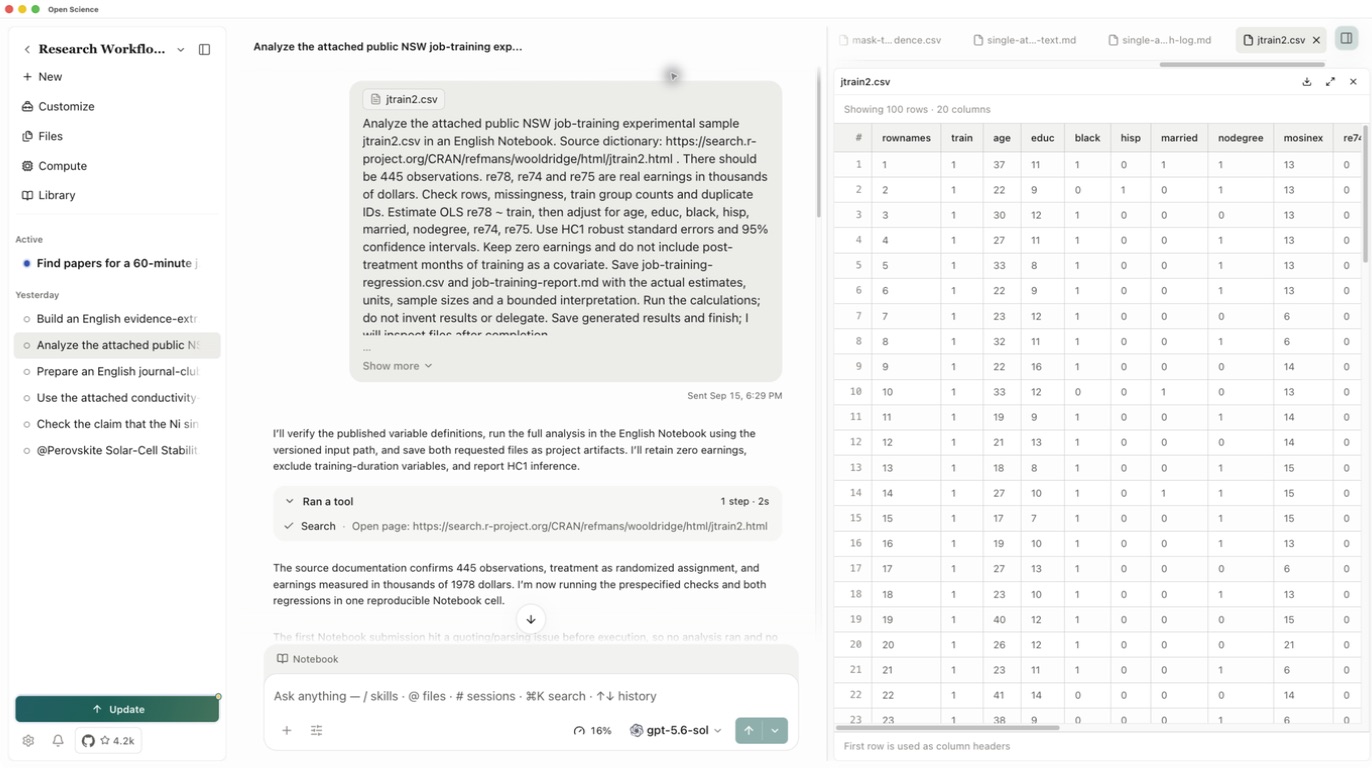
Cliquez sur le CSV ci-joint pour le prévisualiser avant d'envoyer la demande de calcul. Cochez train, re78, re74 et re75, y compris les lignes avec aucun gain. L'aperçu ne peut afficher que les lignes 100; le Notebook doit compter l'ensemble du fichier.
Exécuter la comparaison prédéfinie
Analyze the attached jtrain2.csv in an English Notebook.
Check row count, missingness, train group counts and duplicate IDs.
Estimate OLS re78 ~ train, then adjust for age, educ, black, hisp,
married, nodegree, re74 and re75. Use HC1 robust standard errors
and 95% confidence intervals. Keep zero earnings. Do not include
post-treatment months of training as a covariate.
Save job-training-regression.csv and job-training-report.md with
the estimates, units, sample sizes and a bounded interpretation.
Run the calculations; do not invent results or delegate.
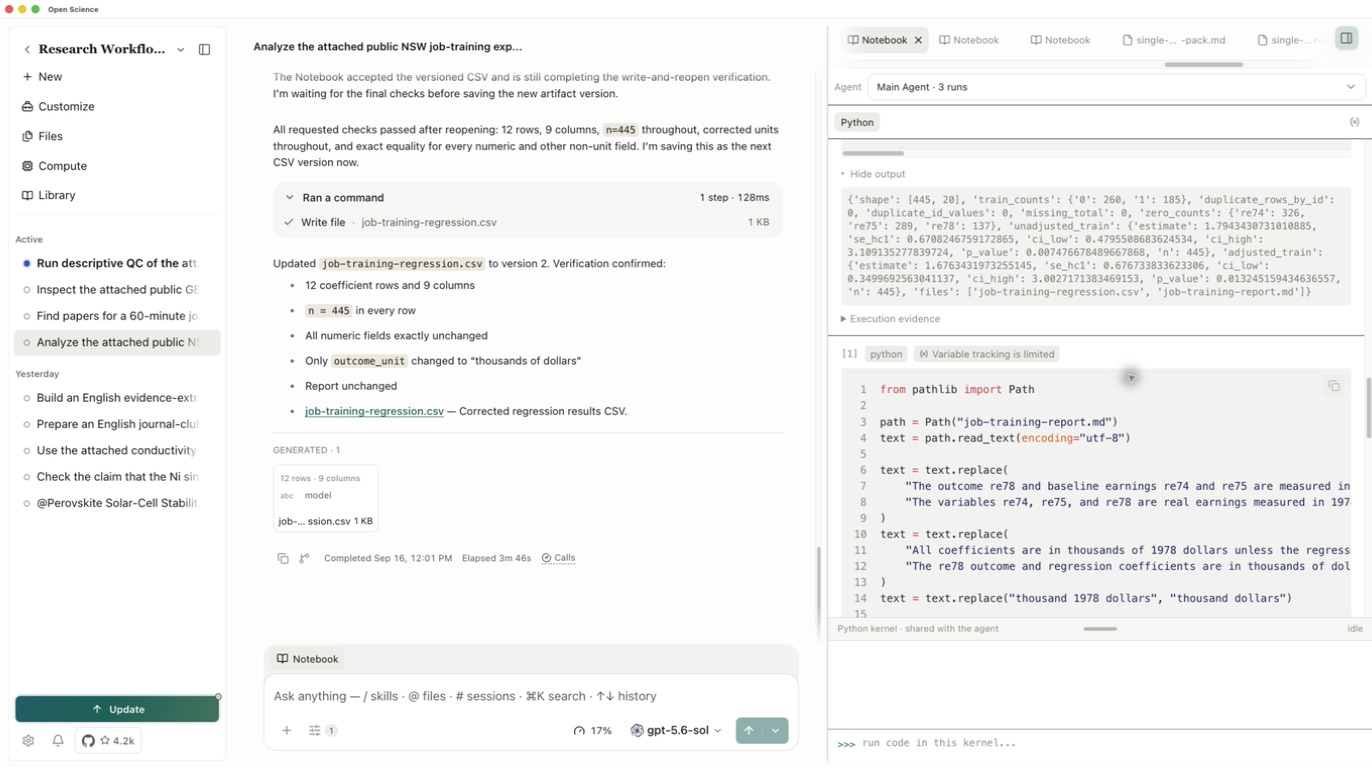
Revoir le code demandé lorsque l'approbation paraît. Il doit lire le CSV attaché, s'adapter aux deux modèles spécifiés et enregistrer les sorties. Ouvrez Notebook pour inspecter le résultat d'exécution réel. Si l'exécution échoue, résolvez l'erreur affichée avant de traiter toute prose comme un résultat calculé.
Dans la conversation, choisissez Notebook, ouvrez la cellule Python exécutée et inspectez sa sortie. Recherchez la ligne et le groupe avant le résumé de régression. Si la version ci-jointe ne peut pas être résolue, demandez à l'Agent de lire le fichier monté à partir de cette conversation. une cellule défaillante n'est pas un résultat. Gardez la cellule réussie et sa sortie avec les fichiers sauvegardés.
Inspecter le résultat enregistré
L'exemple a été complété par Lignes 445, 185 personnes affectées à la formation, 260 témoins, aucune valeur manquante et aucun identifiant de ligne dupliquée. Les deux régressions ont retenu toutes les observations de 445.
| Modèle | Coefficient de formation | Erreur type HC1 | Intervalle de confiance 95% |
|---|---|---|---|
| Non ajusté | 1.794 | 0.671 | 0.480 à 3.109 |
| Ajusté pour les variables de référence | 1.676 | 0.677 | 0.350 à 3.003 |
Les coefficients et les intervalles sont en milliers de dollars. Il s'agit des résultats du calcul de cet exemple, et non des estimations tirées de l'article original.
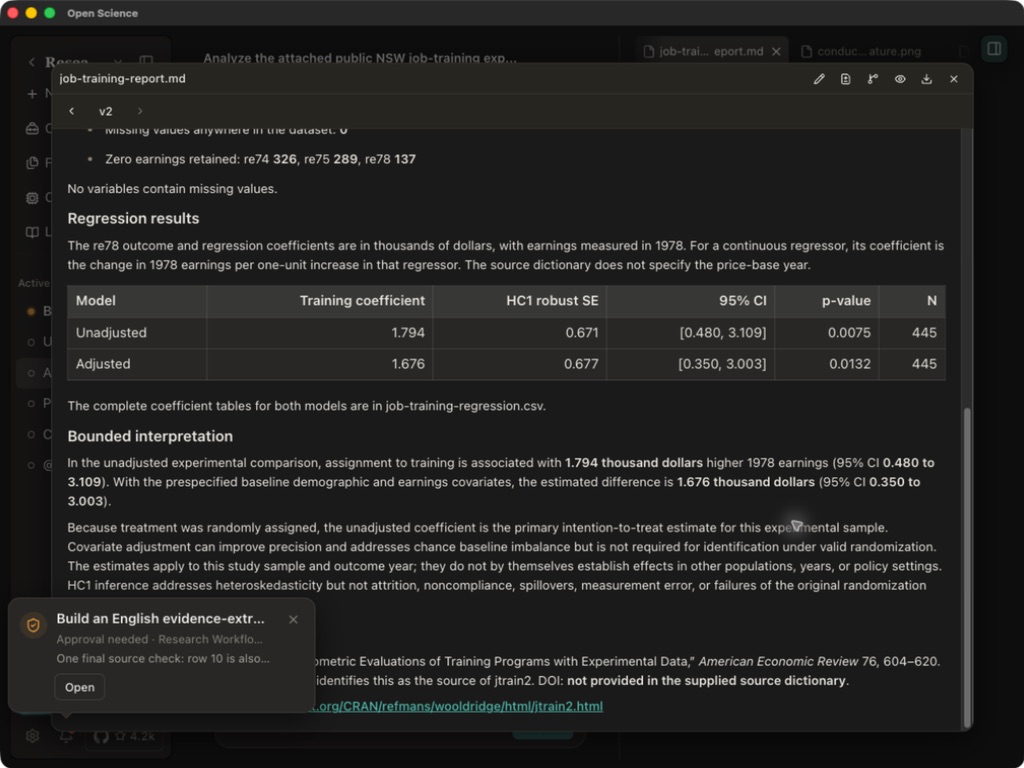
Ouvrez les deux fichiers générés après la réponse complète. Comparez les lignes train dans le CSV avec le rapport et Notebook. Vous pouvez télécharger les Tableau des coefficients et rapport de cette exécution.
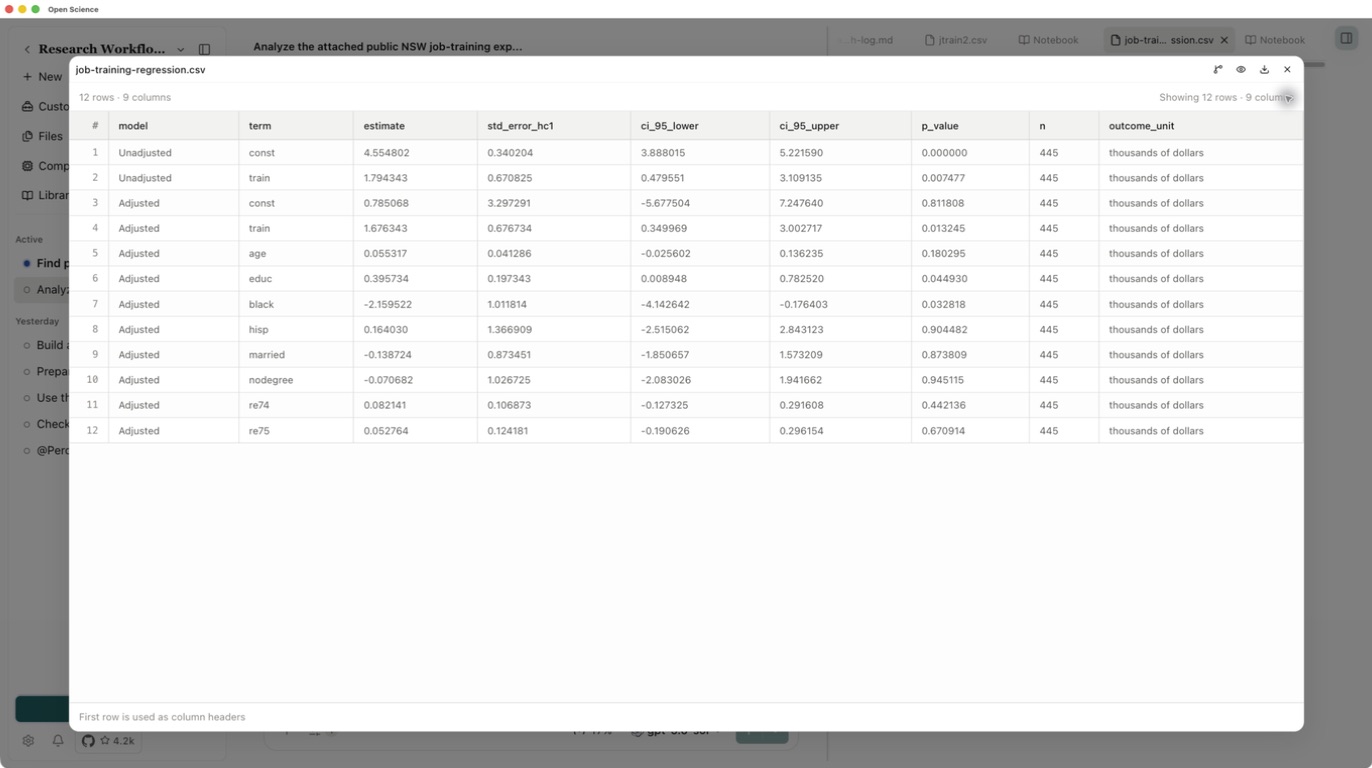
Dans Generated, ouvrez la CSV et élargissez son aperçu. Le tableau des coefficients enregistrés a Lignes 12 · Colonnes 9: deux lignes pour le modèle non ajusté et dix pour le modèle ajusté. Localiser chaque ligne train de chaque modèle et comparer son estimation, une erreur standard robuste, l'intervalle, n et l'unité. N'ajoutez pas d'année de référence de l'inflation que le dictionnaire source n'indique pas. Utilisez le bouton prévisualiser , Download pour conserver la version cochée.
Décider de ce que la comparaison soutient
L'ajustement de base modifie l'estimation d'environ 1.79 à 1.68 mille dollars. C'est une vérification de sensibilité pour ces deux spécifications. Il n'établit pas la robustesse de chaque choix de modélisation ni la généralisation de l'expérience à d'autres populations et années. Les erreurs types de HC1 concernent l'hétéroskédasticité; ils ne réparent pas les problèmes dans la conception originale de l'étude.
Pour transmettre l'analyse à un collègue, conservez le CSV original, le dictionnaire variable, le code et l'environnement sélectionné. Utilisez Contrôles de reproductibilité pour évaluer ce qui est disponible pour une nouvelle version ultérieure.