Mehrere Sequenzen ausrichten und konservierte Positionen untersuchen
Praxisbeispiel Vergleichen Sie menschliche, Maus- und Rinder-Hämoglobin-Alpha-Ketten
Holen Sie sich drei überprüfte UniProt-Sequenzen, richten Sie sie an den entfernten Clustal Omega-Dienst aus und prüfen Sie, welche Spalten in allen dreien die gleiche Aminosäure enthalten. Das Beispiel ergab eine 142-Säulenausrichtung mit 116 vollständig konservierten Säulen. Dies sind Ergebnisse für diesen kleinen Drei-Spezies-Satz, nicht eine funktionelle Annotation oder phylogenetischen Baum.
1. Bereiten Sie die Sitzung und die Quellen vor
Der Verbindungsaufbau wird in Wissenschaftliche Datenbanken beschrieben.
- Erstellen Sie Hämoglobin-Sequenz-Alignment und öffnen Sie eine neue Konversation mit einem verbundenen Modell. In diesem Beispiel wurde Codex subscription verwendet.
- In Settings → Connectors, Marke Gene & Ontologien und Genome zur Verfügung stehen Main. Clustal Omega gehört zu Genomen; Es ist kein separates Connector.
- Konfigurieren Sie die von Clustal Omega angeforderte gültige E-Mail für Forschungsdienste in Settings → Privacy → Share contact email with research data services. Verwenden Sie Ihren tatsächlichen Kontakt, nicht eine erfundene Adresse. Sequenzeingaben werden an EMBL-EBI gesendet.
- Senden Sie die Aufforderung unten. Verwenden Sie öffentliche oder anderweitig autorisierte Sequenzen.
Which positions are conserved among human, mouse and bovine hemoglobin
alpha chains? Retrieve the reviewed canonical sequences from UniProt,
record their accessions and organisms, and align the three FASTA records
with Clustal Omega through the Genomes Connector in Session Notebook.
Follow the submitted job through completion, then save the input FASTA,
raw alignment, submission receipt and a short English report with
conserved-column counts and a few clearly mapped examples. Explain why
sequence conservation alone does not prove function.
Überprüfen Sie die zurückgegebenen Datensätze vor dem Abgleich:
| Organismus | Überprüfter Beitritt | Taxon | Kanonische Länge |
|---|---|---|---|
| Mensch · Homo sapiens | P69905 | 9606 | 142 aa |
| Maus · Mus musculus | P01942 | 10090 | 142 aa |
| Rinder · Bos taurus | P01966 | 9913 | 142 aa |
Die FASTA-Namen sind human_P69905, mouse_P01942 und bovine_P01966. Alle Namen müssen eindeutig sein. Menschliches P69905 ist mit HBA1 und HBA2 assoziiert; Ein Proteineintrag ist nicht unbedingt ein einzigartiges Gen. Behalten Sie den Beitritt und den Organismus mit jeder Sequenz.
2. Einmal einreichen und dem Job folgen
Der Agent ruft Genomes → clustalo_submit mit den kombinierten FASTA, stype: protein und outfmt: clustal_num auf. Der Dienst benötigt mindestens drei Datensätze und akzeptiert höchstens 4,000-Datensätze oder 4 MiB. Bewahren Sie das zurückgegebene job_id, das angeforderte Format und den Eingangsbeleg auf.
- Überprüfen Sie die Antwort auf die Notebook-Einreichung. Eine Job-ID und ZUGELASSENE bedeuten akzeptiert, nicht abgeschlossen.
- Abfrage
clustalo_statusfür die gleiche ID, warten Sie mindestens zehn Sekunden zwischen den Prüfungen und nach einer längeren Serviceführung. Reichen Sie keine weitere Kopie ein, da die Warteschlange langsam ist. - Rufen Sie nach AUSGESCHLOSSEN
clustalo_resultsmit der gleichen ID und dem gleichen Format an. Speichern Sie den zurückgegebenen Inhalt als.aln-Datei; Das Empfangen eines vorgeschlagenen Dateinamens speichert nicht selbst eine Datei. - Wenn die Sitzung beendet wird, behalten Sie die Job-ID bei und setzen Sie den gleichen Job später fort. Eine unsichere Antwort auf die Einreichung kann immer noch einer angenommenen Stelle entsprechen; Vermeiden Sie eine automatische erneute Einreichung. FEHLER, FAIL und NOT_FOUND erfordern eine Untersuchung, keine leere Ausrichtungsinterpretation.
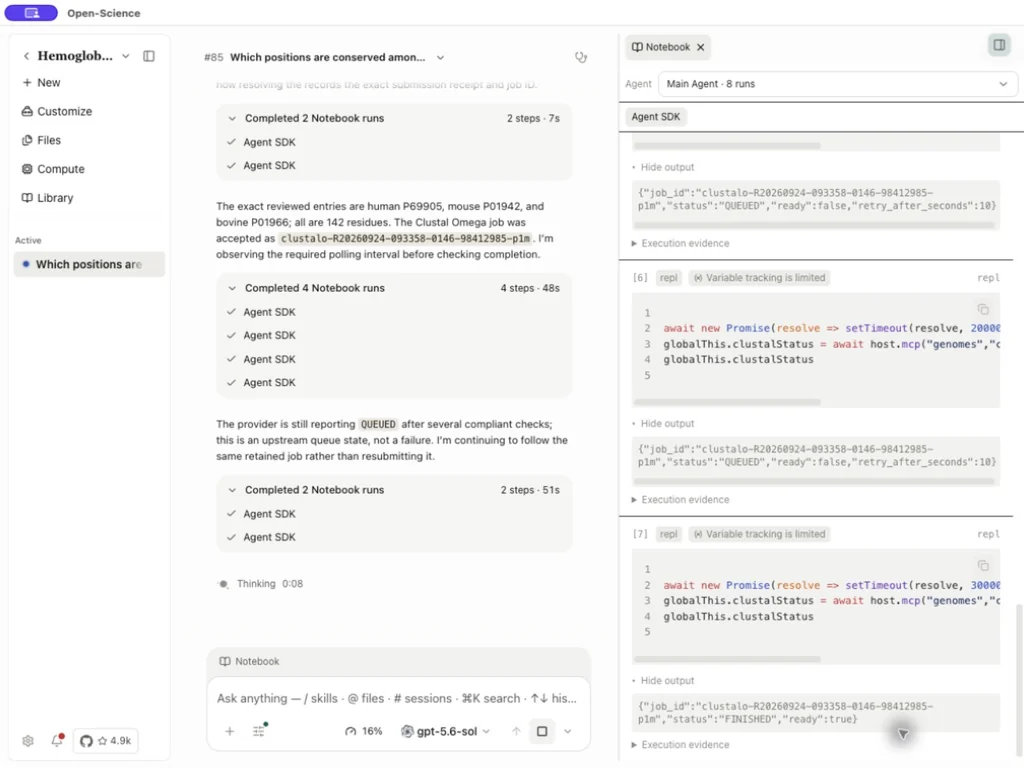
Die Quittung dieses Beispiels zeichnet zunächst ZUGELASSENE auf. Das spätere Notebook-Ergebnis meldete AUSGESCHLOSSEN und gab eine Clustal O(1.2.4)-Ausrichtung zurück. Die Ergebnisse haben eine vom Anbieter kontrollierte Aufbewahrungsfrist, die als bis zu einer Woche dokumentiert ist; Speichern Sie den Bericht umgehend. Die Ergebnisgrößenbegrenzung ist 8 MiB. Siehe Operationsfelder.
Ursprünglicher Eingangseingang · Rohabstimmung
3. Überprüfen Sie die Ausrichtung und zählen Sie konservierte Spalten
Öffnen Sie das generierte hemoglobin_alpha_conservation_report.md. Vergleichen Sie seine Zugänge und Sequenzlängen mit der Eingabe FASTA und der rohen Ausrichtung. Entfernen von Lücken aus jeder aufeinander abgestimmten Sequenz und Bestätigung, dass die verbleibenden Rückstände genau mit ihrem Input übereinstimmen; Dies führt zu einer zufälligen Sequenzsubstitution oder -abkürzung.
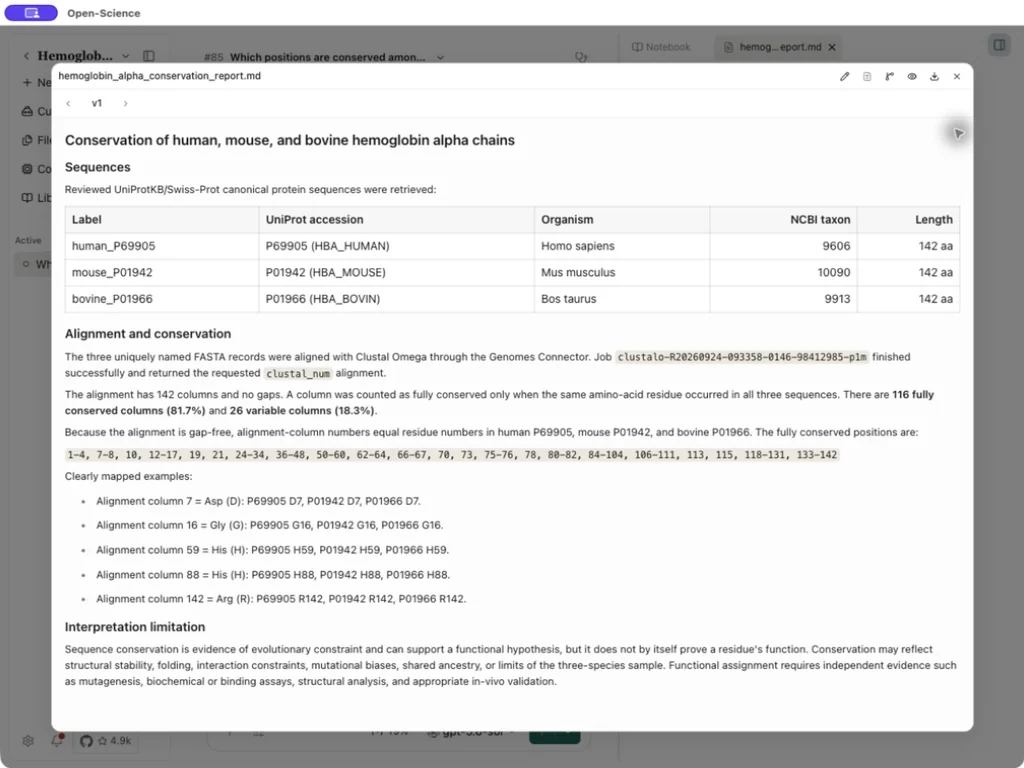
Für diesen Lauf:
| Überprüfung | Optionen und Grenzen |
|---|---|
| Input- und Aligned-Sequenzen | Drei, jeweils 142-Reste |
| Ausrichtungssäulen | 142 |
| Spaltenhaltige Spalten | 0 |
| Identischer Rückstand in allen drei Sequenzen | 116-Spalten |
| Variable Spalten | 26 |
| Voll konservierter Anteil | 116 / 142 = 81.7% |
In der Clustal-Ausgabe markiert * eine vollständig konservierte Spalte; : und . beschreiben Gruppen mit ähnlichen Eigenschaften, nicht identischen Resten. Zählen Sie nur identische Nicht-Lücken-Spalten für die obige Fraktion. Beispiele sind D7, G16, H59, H88 und R142. Hier ist die Ausrichtung lückenfrei, so dass Spalten den kanonischen Sequenzrestzahlen entsprechen. Bei Lücken ist jede Sequenz separat abzubilden, wobei die Ausrichtungsspalten nicht mit Rückstandszahlen oder der Nummerierung von reifen Proteinen zu verwechseln sind.
4. Halten Sie die Interpretation innerhalb der Beweise
Die Konservierung dieser drei verwandten Säugetiere unterstützt eine Hypothese über die Einschränkung, beweist jedoch nicht die Funktion eines Rückstands. Folding, Stabilität, gemeinsame Abstammung und die gewählte Probe können alle von Bedeutung sein. Breitere Taxon-Probenahme, struktureller Kontext und experimentelle Beweise sind separate nächste Schritte. Eine Multiple-Sequenz-Alignment ist keine BLAST-Suche oder ein phylogenetischer Baum.
Halten Sie die Eingabe FASTA, Rohabgleich, Empfang und Bericht zusammen. Um mit einer unbekannten Sequenz zu beginnen, verwenden Sie Protein Discovery und BLAST. Für programmspezifische Profilsuche siehe HMMER und InterProScan Fähigkeiten.