Tabellen und Datensätze
Verwenden Sie die Vorschau, um die Struktur einer Tabelle zu verstehen, und verwenden Sie dann Python oder R, um die gesamte Datei zu validieren und zu transformieren. Gemeinsame Anzeige- und Download-Steuerelemente gehören zu Öffnen und Vorschauen von Dateien; Renderer-Limits und -Erweiterungen sind in Dateiformate aufgeführt.
Verwenden Sie für eine Tabelle, die in eine Literatur PDF eingebettet ist, PDF-Extraktion, öffnen Sie die exportierte Tabelle erneut und überprüfen Sie ihre Kopfzeilen, Werte und Notizen mit der Quelle.
Identifizieren Sie, was eine Zeile darstellt
Praxisbeispiel Lesen Sie Beispielbezeichner und Metriken in einer QC-Tabelle
- Öffnen Sie Beispiel-QC-Tabelle aus einem gespeicherten Ergebnis, Dateien oder einem Anhang.
- Lesen Sie die Spaltennamen und entscheiden Sie, ob Zeilen Proben, Gene oder eine andere Einheit darstellen. In dieser Ausgabe ist jede Zeile ein Sample; In ihrer Quellmatrix ist jede Zeile ein Gen.
- Suchen Sie die vollständige Kennung Spalte. Halten Sie kurze Plotting-Etiketten, die diesen Identifikatoren zugeordnet sind.
- Lesen Sie den angezeigten Bereich, bevor Sie die Größe des Datensatzes schätzen. Verwenden Sie eine Volldateiberechnung, wenn die Vorschau begrenzt ist.
- Vergleichen Sie die Abtastwerte mit dem Gemeinsames QC-Baseline.
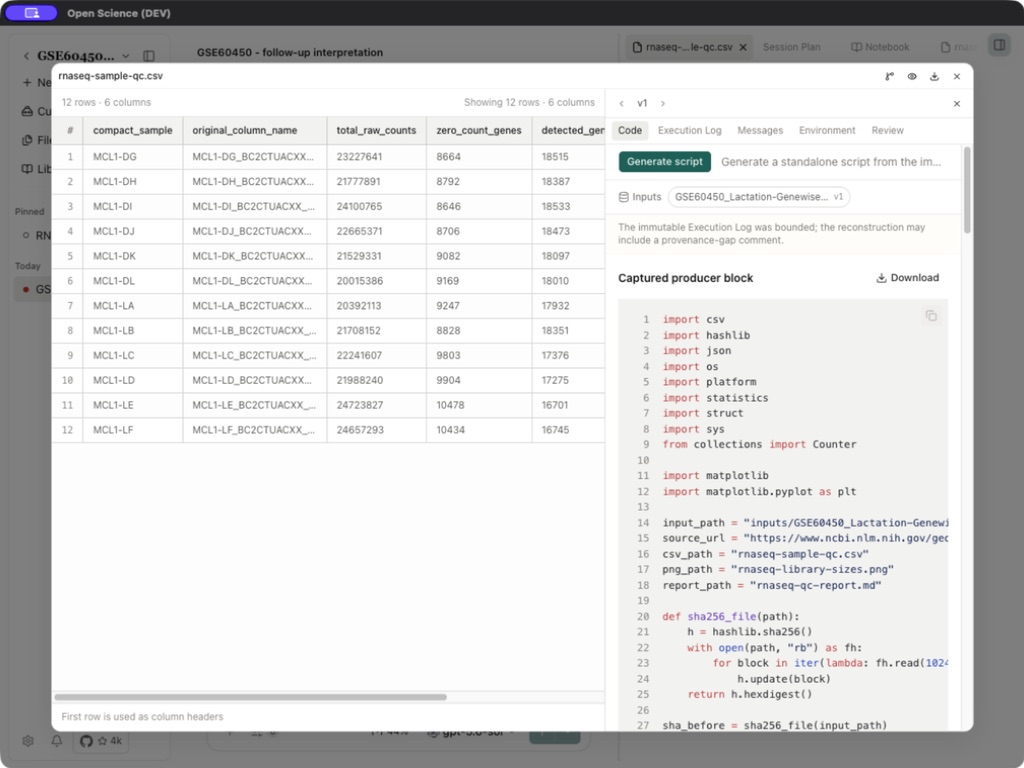
QC-Tabelle: Spaltenbedeutungen
| Spalte | Auslegung | Überprüfen Sie, bevor Sie es verwenden |
|---|---|---|
| compact_sample | Kurzfigurenetikett | Behalten Sie seine Zuordnung zum ursprünglichen Bezeichner |
| original_column_name | Kennung der Originalprobe | Fehlende und doppelte Namen prüfen |
| total_raw_counts | Summe der Stichprobenzählungen | Rohzähleinheiten konservieren; Nennen Sie diesen normalisierten Ausdruck nicht |
| zero_count_genes | Anzahl der Gene mit Nullzählungen | Zusammen mit nachgewiesenen Genen müssen alle Input-Genreihen abgedeckt sein |
| detected_genes_count_gt_0 | Anzahl der Gene mit positiver Zählung | Dies ist eine Anzahl von Genen, nicht Ausdrucksgröße |
| median_count_among_detected_genes | Median über positive Zählungen | Anzugeben ist, dass Nullzählgene ausgeschlossen sind. |
Überprüfen Sie den vollständigen Datensatz
Separate Identifikatoren und Metadaten aus Messspalten vor der Auswahl numerischer Operationen. Bewahren Sie Gen-IDs als Identifikatoren auf und halten Sie die Genlänge aus den Berechnungen der Stichprobenzählung heraus. Überprüfen Sie fehlende Werte, doppelte Identifikatoren und zulässige Wertebereiche in der vollständigen Eingabe.
Eine sichtbare Zeilenzahl kann nur die Vorschau beschreiben. Lesen Sie die komplette Datei in Notebook, um Dimensionen festzulegen. Der CSV Renderer ist schreibgeschützt; Header-Klicks sind kein Ersatz für eine Sortier- oder Filteroperation.
Speichern Sie Transformationen als neue Ergebnisse
Geben Sie den Join-Schlüssel, die Filterregel, die Richtlinie zum Fehlen von Werten und die erwarteten Ausgabespalten in Ihrer Anforderung an. Fordern Sie eine separate abgeleitete Datei an, damit die ursprüngliche Eingabe verfügbar bleibt. Öffne die Ausgabe erneut, vergleiche ihre Zeilenanzahl und Bezeichner mit der Eingabe und inspiziere den ausgeführten Code, bevor du Änderungen interpretierst.
Notebook-Variablen sind temporäre Kernel-Zustände, bis sie gespeichert werden. Eine sichtbare Variable und eine verwaltete Dateiversion haben unterschiedliche Lebenszyklen; Verwenden Sie Dateien und Versionen, um gespeicherte Ergebnisse zu speichern und zu vergleichen.
Wählen Sie einen Reader für andere Formate
Verwenden Sie für .xls/.xlsx die in Vorschau beschriebenen Office-Vorschau- und Arbeitsblattsteuerelemente. Binäre Container wie .h5ad oder .h5 erfordern eine kompatible Analysebibliothek. Eine tab-getrennte .txt-Matrix kann sich als Text öffnen. Das Umbenennen einer Erweiterung konvertiert keine Daten oder macht ein nicht unterstütztes Format lesbar.