Bases de données scientifiques
Utilisez cette page pour choisir une source de données, comprendre ce qu'elle peut retourner et rendre ses outils disponibles en Open-Science. Pour des exemples de recherche étape par étape avec des captures d'écran et des fichiers de sortie, voir Parcours de recherche.
Bases de données prises en charge
Open-Science v1.0.5 comprend 48 Connectors intégrés et 418 opérations : 47 Connectors de sources de données fournissent 416 opérations, et un Connector Molecule hors ligne en fournit deux. Les noms ci-dessous correspondent aux entrées de Settings → Connectors. Un Connector peut couvrir plusieurs bases de données. La présence d’une source ne signifie pas que toutes les fonctions de son site sont disponibles.
Ce total comprend toutes les entrées intégrées, y compris celles qui sont désactivées. Les Connectors MCP ajoutés par l’utilisateur sont comptés séparément. Le nombre de Connectors, de bases de données couvertes et d’opérations disponibles correspond à des mesures différentes.
| Connecteur | Sources | Opérations | Utilisez-le pour |
|---|---|---|---|
Chemistry · chemistry | PubChem, ChEBI, Rhea, BindingDB, LIPID MAPS, UniChem | 14 | Chimie des petites molécules via PubChem, ChEBI, Rhea et BindingDB. |
Literature Graph · literature | OpenAlex, arXiv, Crossref, DataCite | 13 | Papiers, auteurs, citations, mises à jour DOI et enregistrements dataset/software. |
PubMed · pubmed | PubMed, PMC, Europe PMC, PubTator 3 | 9 | Littérature biomédicale par l'intermédiaire de l'E-utilities NCBI, du PMC ID Converter et d'Europe PMC — recherche, métadonnées, articles connexes, recherche de citation, conversion d'ID, texte intégral et copyright. |
Genes & Ontologies · genes | HGNC, MyGene, UniProt, OLS, QuickGO, Reactome, g:Profiler, Enrichr | 20 | Identificateurs de gènes/protéines, découverte de séquences UniProt, annotations GO et Réactome, et enrichissement de g:Profiler et Enrichr. |
Génomes · genomes | NCBI Datasets, NCBI BLAST, EMBL-EBI Job Dispatcher, Ensembl, UCSC | 22 | annotation du génome, homologie et séquence; l'identification des taxons/ensembles/séquences de la BCNI; Recherche BLAST et alignement de plusieurs séquences de Clustal Omega; Variantes LD et proxy propres à la population. |
Variantes · variants | gnomAD, ClinVar, dbSNP, MaveDB | 22 | Fréquences des populations, dossiers cliniques et scores fonctionnels, cartes et expériences propres à chaque essai. |
Clinical Trials · clinical-trials | ClinicalTrials.gov | 7 | Découverte des essais, protocoles et mesures des résultats affichés, dénominateurs de groupe, statistiques et événements indésirables. |
Clinical Genomics · clinical-genomics | ClinGen, CIViC, Open Targets, ClinPGx, DGIdb | 32 | Bases de connaissances en génomique clinique: ClinGenations, preuves cliniques du CIVIC, et la plateforme Open Targets, ainsi que les dossiers pharmacogénomiques ClinPGx. |
Structures et interactions · structures | PDB, PDBe, AlphaFold, EMDB, Complex Portal, IntAct, OmniPath | 20 | Structures et interactions moléculaires — Structures PDB, prédictions AlphaFold, entrées EMDB cryo-EM, complexes de portails complexes, réseaux d'interactions IntAct. |
ChEMBL · chembl | ChEMBL | 7 | Composés bioactifs, médicaments, cibles, bioactivité et mécanismes via le ChEMBL REST API. |
bioRxiv · biorxiv | bioRxiv, medRxiv, ROR | 7 | préimpressions bioRxiv/medRxiv — recherche par date/catégorie, métadonnées par DOI, liens de publication de revues, listes de bailleurs de fonds et statistiques des plates-formes. |
Réglementation des médicaments · drug-regulatory | openFDA | 11 | Médicaments@FDA, étiquettes, rapports d'événements indésirables FAERS et rappels de médicaments. |
Génétique humaine · human-genetics | GWAS Catalog, eQTL Catalogue, PheWeb | 15 | Données probantes sur les associations génétiques humaines — Catalogue GWAS, catalogue eQTL et portails PheWeb PheWAS (FinnGen, BioBank Japan). |
Expression · expression | GTEx, Bgee | 16 | expression des tissus humains GTEx et eQTL; Expression de base de Bgee pour les espèces croisées. |
Annotation protéique · protein-annotation | InterPro, Pfam, Human Protein Atlas, STRING | 14 | Architecture du domaine protéique, appartenance à la famille/clan, atlas d'expression et réseaux d'interactions via InterPro/Pfam, l'Atlas des protéines humaines et STRING, y compris l'enrichissement des interactions réseau. |
Modèles de cancer · cancer-models | cBioPortal, DepMap / CCLE | 15 | Études, mutations, nombre de copies, échantillons, patients, attributs cliniques et expression du profil moléculaire. |
RNA · rna | Rfam, RNAcentral | 11 | Données sur les familles d'ARN non codantes (métadonnées, alignements, modèles, structures) via Rfam. |
Archives Omics · omics-archives | ArrayExpress, GEO, ENA, MetaboLights, Metabolomics Workbench, MGnify, PRIDE | 28 | Étude et gestion des métadonnées et des répertoires de fichiers Omics; des échantillons, des facteurs, des analyses et des enregistrements composés. |
CellGuide · cellguide | CELLxGENE | 5 | Identité de type cellulaire, gènes marqueurs, ensembles de données source et tissus via CELLxGENE CellGuide. |
Regulation · regulation | ENCODE, JASPAR, UniBind | 16 | Génomique fonctionnelle de régulation génétique — expériences ENCODE/biosamples/files, profils de liaison JASPAR TF et UniBind ChIP-seq TFBS. |
Research Resources · research-resources | Grants.gov, Antibody Registry | 5 | Recherche de financement-opportunité (Grants.gov) et recherche de catalogue d'anticorps (Registre des anticorps). |
BioMart · biomart | Ensembl BioMart | 8 | Ensembl BioMart requêtes d'attributs et traduction d'identificateurs. |
ZINC · zinc | ZINC | 5 | ZINC22 espace chimique purchasable (CartBlanche22) — recherche composée par ZINC id, recherche exacte/similaire de SMILES, résolution de code fournisseur, échantillonnage aléatoire, emplacements de structure 3D pour l'arrimage. |
GDC · gdc | Genomic Data Commons (GDC) | 5 | Projets, cas, métadonnées de fichiers, étiquettes ouvertes/contrôlées et manifestes de transfert pour le cancer; pas de subvention pour télécharger ou accéder. |
Zenodo · zenodo | Zenodo | 2 | Ensemble de données, logiciels et découvertes de publications publics, métadonnées et inventaires de fichiers spécifiques à une version; pas de téléchargement. |
HMMER · hmmer | HMMER3, EMBL-EBI | 3 | Recherche de protéines, de profils et d'alignements spécifiques au programme, état d'avancement et résultats. |
InterProScan · interproscan | InterProScan, EMBL-EBI | 3 | Soumettre des séquences de protéines, vérifier l'état d'emploi annotation et récupérer les rapports TSV. |
Pathway Commons · pathway-commons | Pathway Commons, Reactome | 4 | Recherche de trajectoires, voies supérieures, requêtes de graphiques et exportations de sous-modèles BioPAX. |
Alliance Genome Resources · alliance | Alliance of Genome Resources | 8 | Les gènes humains et modèles-organismes, orthologues, modèles de maladies, phénotypes, allèles et expression. |
CELLxGENE Discover · cellxgene-discover | CELLxGENE Discover | 9 | Collections et ensembles de données monocellulaires, versions publiées, formats de fichiers, tailles et URLs de téléchargement. |
Cellosaurus · cellosaurus | Cellosaurus | 6 | Trouvez les noms de lignes cellulaires et les synonymes, puis inspectez l'identité d'adhésion et les annotations de qualité. |
Monarch Initiative · monarch | Monarch Initiative | 2 | Les associations entre la maladie et le gène et le phénotype avec l'organisme et les preuves à l'appui. |
IEDB · iedb | IEDB | 8 | Epitopes, antigènes, tests sur cellules T, cellules B et MHC, preuves TCR/BCR et publications sources. |
PDC · pdc | PDC | 5 | Les versions des études sur le cancer-protéomique, les liens de spécimens, les métadonnées cliniques de cas public et les répertoires de fichiers; aucun téléchargement. |
ENCORI · encori | ENCORI | 10 | cibles miRNA/RBP, interactions RNA, ceRNA, motifs, sites de fixation, tableaux de référence et fichiers en vrac. |
Orphadata · orphadata | Orphadata, Orphanet | 2 | Associations de gènes des maladies rares et fréquences de phénotype HPO; désactivé par défaut. |
TCIA · tcia | TCIA, NBIA | 3 | Collections d’imagerie, conditions d’accès et métadonnées des séries. |
KEGG · kegg | KEGG | 3 | Voies, composés et correspondances de gènes ; restrictions de licence. |
RxNorm / RxNav · rxnorm | RxNorm, RxNav | 2 | Résolution des noms de médicaments et propriétés des concepts actifs. |
DailyMed · dailymed | DailyMed | 2 | Identifiants des notices de médicaments et historique des versions. |
BioSamples · biosamples | EMBL-EBI BioSamples | 2 | Métadonnées publiques des échantillons et références croisées. |
WikiPathways · wikipathways | WikiPathways | 2 | Métadonnées des voies, espèces et révisions. |
Europe PMC · europepmc | Europe PMC | 1 | Recherche bibliographique directe, résumés et pagination. |
Research Datasets · research-datasets | NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, GBD | 3 | Conditions d’accès aux données et découverte de fichiers publics. |
ChEA3 · chea3 | ChEA3 | 2 | Classements d’enrichissement de facteurs de transcription et liens GMT. |
bioDBnet · biodbnet | bioDBnet | 6 | Conversion d’identifiants, orthologues et voies. |
CTD · ctd | CTD | 1 | Accès aux rapports publics officiels et conditions. |
Les outils Molecule hors ligne sont couverts par Vérificateurs scientifiques. Pour les opérations exactes exposées par chaque source de données, utilisez le Référence de fonctionnement Connector.
Ce que vous pouvez faire
| Tâche de recherche | Commencez par | Sortie typique |
|---|---|---|
| Trouver des papiers, des citations de traces et vérifier les relations DOI | Graphique de littérature, PubMed, bioRxiv | Documents documentaires, identifiants, liens de citation et disponibilité du texte intégral |
| Trouver des gènes ou des protéines et comparer des séquences | Genes & Ontologies, Génomes | Cartographie des identificateurs, enregistrements des protéines, rapports FASTA et BLAST |
| Découvrez les données omicales publiques et consultez les fichiers disponibles | Omics Archives | Étude/réalisation des métadonnées et des inventaires de fichiers avec l'emplacement des sources, la taille et les montants de contrôle disponibles |
| Interpréter une liste de gènes ou inspecter un réseau d'interaction | Genes & Ontologies, Annotation des protéines | Tableaux d'enrichissement, annotations d'ontologie et enregistrements réseau |
| Vérifier les variantes, l'expression et les preuves réglementaires | Variantes, génomique clinique, génétique humaine, expression, réglementation | Registres des sources avec organisme, tissu, base de référence et champs de données pertinents |
| Récupérer des dossiers composés, de structure ou d'étude clinique | Chimie, ChEMBL, Structures et Interactions, Essais cliniques | Identificateurs/propriétés chimiques, dossiers de structure et métadonnées d'essai |
Pour la conversion de l'identificateur de lot, Genes & Ontologies ajoute submit_uniprot_id_mapping, get_uniprot_id_mapping_status et get_uniprot_id_mapping_results. Enregistrez l'ID de travail, sondagez au moins trois secondes d'intervalle, puis récupérer chaque page de résultat. Préserver des cartes à un à plusieurs et des failed_ids explicites; manquer d'une page ne signifie pas être inégalé. Le service accepte jusqu'à 100,000 identifiants et expire les résultats après sept jours. Voir champs de cartographie exacts.
Zenodo expose les métadonnées des enregistrements publics sans authentification. Conservez l'identifiant d'enregistrement propre à la version et les champs d'accès/licence avec l'inventaire des fichiers. GDC expose les métadonnées publiques; un manifeste n'est pas une autorisation de téléchargement, et les fichiers contrôlés nécessitent une autorisation GDC. Opérations de développement durable · Opérations Zenodo.
Une réponse à une base de données peut appuyer une étape de recherche; il ne télécharge pas automatiquement les données, n'ajoute pas chaque papier à la bibliothèque de littérature ou n'effectue pas une analyse complète. Spécifiez quels enregistrements et fichiers vous souhaitez enregistrer.
Preuves réglementaires de l'ARN avec ENCORI
Trouvez ENCORI dans Settings → Connectors, activez-le et rendez-le disponible sur Agent principal. Cette source intégrée n'a pas besoin d'être personnalisée MCP URL ou API La clé. Avec un modèle Main fonctionnel sélectionné, spécifiez l'organisme/assemblage, l'ARN ou le gène cible, le type de cellule et les seuils de preuve dans la conversation.
| Tâche | Résultat et limite |
|---|---|
| requêtes miRNA, RNA–ARN, RBP-cible et ceRNA | Conserver les preuves applicables de CLIP, de dégradome, de programme de prédiction, de valeur p et de FDR; n'établit pas de réglementation causale. |
| Preuves, motifs et sites de fixation de la maladie du RBP | Préserver l'assemblage, le contexte tissulaire/cellulaire, l'ordre en amont et les coordonnées originales; ne mélangent pas les espèces et ne coordonnent pas les systèmes. |
| Tableaux de référence et données globales | Listez d'abord les chemins exacts de table ou les noms de fichiers. Le téléchargement en vrac est séparé: spécifiez le fichier, la destination et le stockage requis avant de le demander. |
Exemple pratique Interroger les preuves de l'ARNi pour PDCD4 dans HeLa
Use ENCORI to find human miRNA interactions targeting PDCD4 in HeLa cells,
using hg38, mRNA targets, at least one CLIP experiment and TargetScan support.
Show at most two rows. Preserve the exact filters, total count and full raw
response in the session data folder. Explain the evidence limits in English.
Do not download bulk datasets.
Cette requête a retourné les enregistrements 19; les deux premiers étaient hsa-miR-23a-3p et hsa-miR-181a-5p. La capture d'écran montre la réponse brute complète enregistrée et les limites de preuve. Ce sont des résultats spécifiques à l'exemple et peuvent changer à mesure que la base de données est mise à jour.
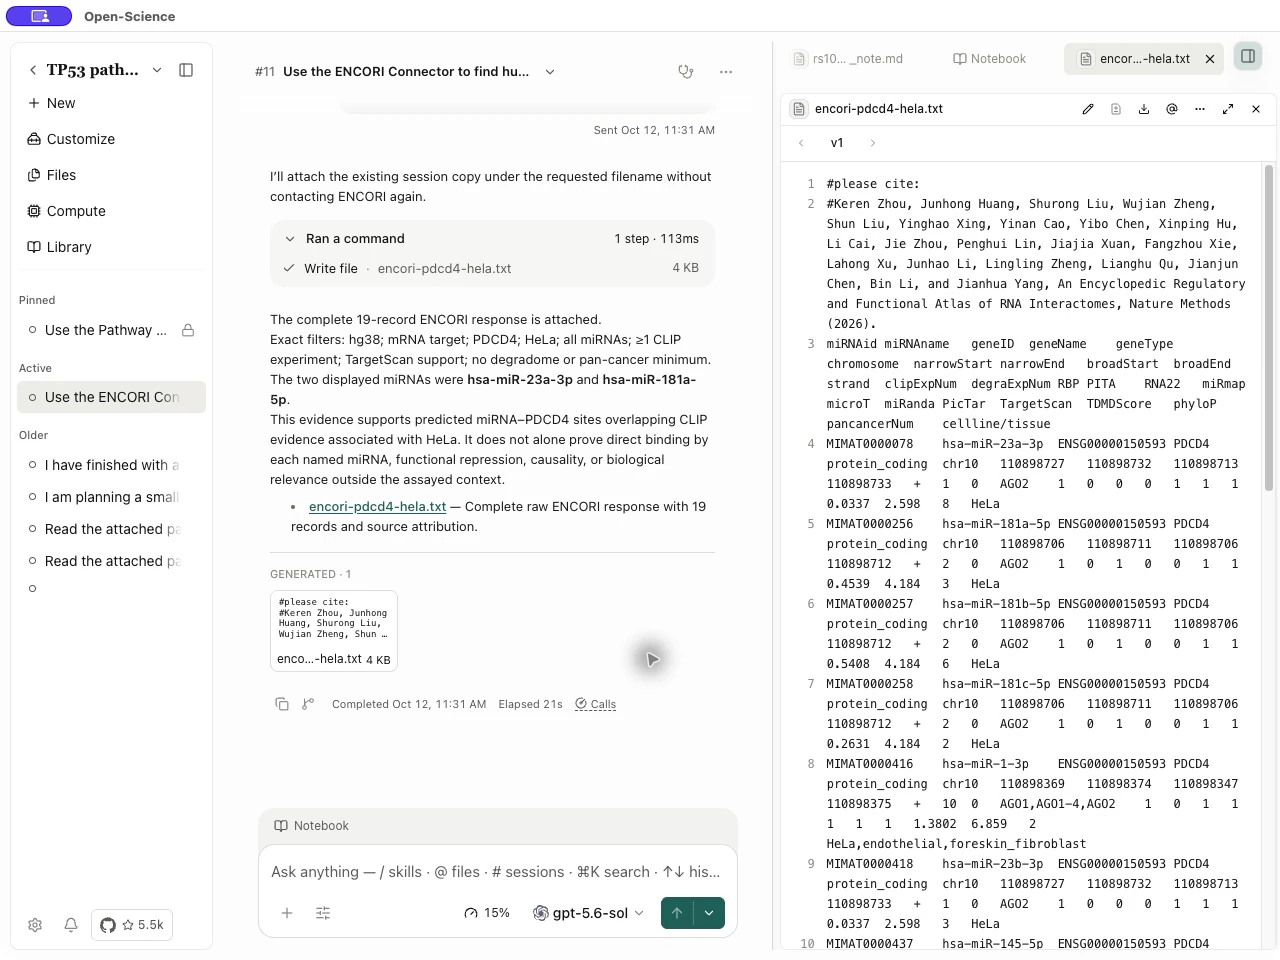
Distinguer total_records de returned_records et inspecter is_complete, result_scope et completeness_note. Un aperçu n'est pas une distribution cible complète. Le raw_response_path de la réponse complète est un chemin de fichier local, pas automatiquement un artefact de session téléchargeable. Pour le partager, demandez à l'agent de l'enregistrer dans un répertoire de données de session accessible et joignez le fichier; ouvrir la pièce jointe pour vérifier son contenu.
Une requête peut renvoyer un véritable résultat vide ou ok:false; n'élargissez pas silencieusement les filtres pour obtenir un coup. Après un téléchargement en vrac, vérifiez le chemin, la taille et verified_gzip. Lire des tableaux de référence ou des ensembles de données ne télécharge pas les fichiers en vrac. Voir Opérations ENCORI pour les paramètres exacts.
Contexte de l'analyse et observations individuelles
| Entrée | Procédure | Limite d'interprétation |
|---|---|---|
| CEMBL | Activer le Connector; Aucune clé API n'est nécessaire. Prenez assay_chembl_id à partir d'un dossier de bioactivité, inspecter la méthode, l'organisme, les cellules/tissus et la cible avec get_assay, puis récupérer get_bioactivity pour la même identification d'essai. | La confiance dans l'attribution des cibles n'est pas une qualité de mesure. Comparer les conditions, les unités et les opérateurs de relation avant de combiner les valeurs IC50/Ki. |
| Variants → ClinVar | Configurer un véritable courriel de contact NCI dans le Connector; La clé API est optionnelle. Appeler clinvar_get_submissions avec une adhésion VCV ou un identifiant de variation positif, puis suivre la version épinglée next_page les arguments. | Préserver SCV, soumettre, condition, date d'évaluation, méthode et citations. Comparer séparément la germination, l'impact clinique somatique et l'oncogénicité. |
Les pages ChEMBL sont commandées par activity_id. Conserver les filtres inchangés et passer next_offset comme offset suivant jusqu'à has_more:false; cela peut récupérer plus d'enregistrements 1,000. Le summary ne couvre que la page actuelle, de sorte que son activité la plus forte n'est pas nécessairement la plus forte dans la requête complète. Après que ClinVar résout une première page de la dernière version, conservez la version retournée VCV pour la suite; ne remplacez pas une entrée RCV, SCV ou rsID.
Champs d'essai ChEMBL · Pagination de la bioactivité · Champs de soumission ClinVar.
Données monocellulaires, modélistes-organismes et variables-effets
Rechercher les entrées ci-dessous dans Settings → Connectors, activer la disponibilité pour Agent principal, puis décrire l'organisme, la question de recherche et les dossiers à conserver dans votre conversation. Ces nouvelles opérations lisent les données publiques sans serveur MCP personnalisé, clé API ou courriel de contact NBCI. D'autres services dans le même Connector peuvent avoir des exigences différentes.
| Entrée | Ce qu'il peut faire | Comment utiliser les résultats |
|---|---|---|
| CELLxGENE Discover | Trouver des ensembles de données unicellulaires par organisme, tissu, maladie, test ou type de cellule; Inspecter les versions et les inventaires des fichiers | Les filtres en ontologie utilisent des étiquettes ou des ID exacts et sont combinés avec ET. Conserver dataset_version_id pour une publication fixe; dataset_id se résout dans la version actuelle. Retourne les URLs de téléchargement disponibles, sans télécharger de fichiers ou demander des matrices d'expression de recensement. Utilisez le CellGuide séparé pour les descriptions de type cellulaire et les marqueurs. |
| Alliance Genome Resources | Interroger les gènes humains, souris, rats, mouches, vers, zèbres, levures et grenouilles, orthologues, modèles de maladies, phénotypes et expression | Rechercher et confirmer l'organisme avant de suivre les ID de gènes retournés. Préserver les preuves et la rigueur orthologique; un phénotype modèle-organisme n'est pas une conclusion de maladie humaine. |
| Variantes → MaveDB | Trouver des ensembles de scores à effet variable, des méthodes d'essai, des pages de score CSV et des cartes existantes VRS | Gardez la URN, licence, méthodes d'essai et calibrage des scores. Les scores fonctionnels ne sont pas des classifications cliniques de pathogénicité. CSV utilise la pagination start/limit et le texte renvoyé doit encore être enregistré dans un fichier. La cartographie n'effectue pas de soulèvement. |
| Archives Omics → Metabolomics Workbench | Études de recherche; inspecter les échantillons, les facteurs, les analyses et les métabolites par accession à la ST; rechercher les structures composées et les références croisées | Choisir un résumé, des facteurs, une analyse ou des métabolites avec la section. Résoudre les noms des composés par l'intermédiaire de PubChem en premiers identifiants pris en charge. Ces opérations ne téléchargent pas de matrices de mesure brutes. |
Le filtrage et la pagination CELLxGENE fonctionnent localement sur le catalogue en amont récupéré pour chaque requête; le catalogue peut changer entre les requêtes. Utilisez les ID de version pour conserver une publication. Une taille de fichier non déclarée est -1, pas zéro octets. Préserver les valeurs manquantes et les définitions des essais dans les résultats MaveDB et Workbench.
Voir les entrées exactes pour CELLxGENE Discover, Alliance, MaveDB et Metabolomics Workbench.
Lignes cellulaires, phénotypes et preuves immunitaires
Activer Cellosaurus, Monarch Initiative ou IEDB dans Settings → Connectors et le rendre disponible sur Agent principal. Ces opérations interrogent les enregistrements publics sans serveur personnalisé ou clé API.
| Entrée | Que demander | Que préserver |
|---|---|---|
| Cellosaurus | Recherche d'un nom/synonyme de ligne cellulaire, puis récupérer l'adhésion CVCL retournée ou RRID | Espèces, identités, synonymes et annotations de contamination/d'identification erronée. La recherche prend une phrase littérale, pas une requête brute Solr. Les annotations de qualité manquantes ne certifient pas la lignée cellulaire. |
| Monarch Initiative | Associations de phénotypes de maladies ou de gènes utilisant des CURIES canoniques, telles que MONDO:0007254 ou HGNC:11998 | Organisme, phénotype, source et preuve. Les alias ne sont pas automatiquement convertis; résoudre les identifiants d'abord. Une correspondance directe concerne une correspondance d'identificateur, et non une confirmation expérimentale. |
| IEDB | Epitopes ou antigènes, ou un dosage spécifique de cellules T, B ou MHC | Au moins un filtre biologique/de preuve est requis; La pagination seule est insuffisante. Utilisez soit antigen_iri ou uniprot_accession, pas les deux. Préserver la méthode d'essai, le résultat, les unités et la publication; une observation d'élution du MHC n'est pas une mesure d'affinité. |
Un enregistrement d'épitope/antigène agrégé peut combiner des observations issues de différentes expériences. Lorsque les filtres doivent être satisfaits par la même expérience, interrogez l'opération d'essai correspondante. Les allumettes zéro n'établissent pas de résultat biologique négatif. Paramètres Cellosaurus · Paramètres du monarque · Paramètres IEDB.
Trouver des matrices GEO et des structures assorties de séquences
Omics Archives → geo_get_matrix_files découvre les fichiers officiels de la série GEO Matrix et les fichiers de count/FPKM/TPM/annotation générés par NCI. Il retourne les emplacements des fichiers; il ne télécharge pas leurs octets. geo_get_series reste une recherche de métadonnées.
Après avoir obtenu une matrice, geo_preflight_matrix vérifie le texte déjà lu et décompressé jusqu'à 8 MiB. Il n'a pas d'accès au réseau ou au système de fichiers. Conservez les identifiants GSM et les métadonnées de la plate-forme afin que les échantillons puissent être mapés par ID plutôt que par colonne. Définir Complète : faux pour un aperçu; ne passez que Complètement : true pour l'ensemble du fichier. Un aperçu ne peut pas établir les dimensions du fichier entier. Ne pas alimenter une archive compressée, une matrice clairsemée ou un fichier HDF5 dans le vérificateur de texte. Voir découverte de matrices et texte avant vol.
Structures & Interactions → pdb_search_sequence accepte une séquence protéique de résidus de 25–10,000, comme séquence brute ou un enregistrement FASTA. Les seuils d'identité et de couverture des requêtes sont des fractions de 0 à 1. La couverture de requête retournée décrit l'alignement à la requête; Ce n'est pas une couverture de structure expérimentale. Le total en amont précède le filtrage de la couverture locale, et un balayage limité peut omettre des correspondances ultérieures. L'opération trouve des enregistrements de structure sans télécharger les coordonnées. Voir des entrées exactes et des limites de balayage.
Connectez et commencez à utiliser une base de données
1. Activer le Connector intégré
- Ouvrez Settings → Connectors et recherchez la famille ci-dessus, comme Omics Archives.
- Ouvrez ses détails et développez Tools. Lisez les entrées de l'opération choisie, les limites de résultats et les exigences des tiers.
- Activer la disponibilité pour Agent principal et vérifier Used by. Utilisez Manage access sur la ressource pour ajuster les associations Main Agent et Specialist. Les politiques de disponibilité et d'approbation par outil sont des contrôles distincts.
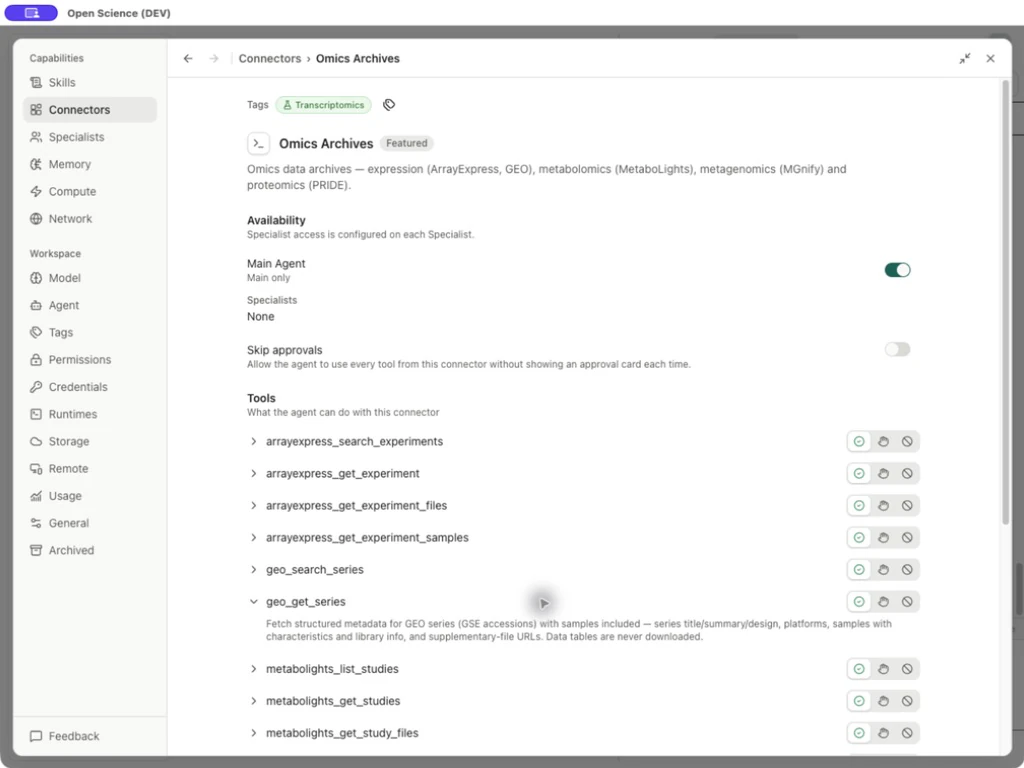
Ces connecteurs sont construits dans; vous n'avez pas besoin d'ajouter un serveur personnalisé pour eux. Pour un service externe vous-même, consultez configuration personnalisée de Connector. Un Connector listé ou activé n'est pas la preuve qu'une authentification ou une requête a réussi.
2. Ajouter des identifiants lorsque l'opération les nécessite
| Service ou état | Où le configurer |
|---|---|
| OpenAlex | Clé optionnelle. Pour en configurer un, ouvrez Settings → Connectors → Literature Graph → Manage credentials → OpenAlex, validez-le, puis enregistrez. |
| Demandes directes de renseignements sur les variantes de l'ICNE nécessitant des coordonnées | Settings → Connectors → Manage credentials → Literature access. Remplir Contact email et sélectionner Save. Une clé NPCI API est facultative. |
| Une autre opération avec une exigence de justificatifs | Suivez les exigences de cet outil et guide de vérification des pouvoirs. Reliez le titre de service au service prévu. |
Entrez les clés dans la forme de l'attestation, pas dans une demande de recherche ou un fichier de sortie partagé. Configurer les exigences pour l'opération sélectionnée; l'exigence relative au contact-email ci-dessus ne signifie pas que chaque outil de l'ICNE a la même exigence.
Littérature Graph offre également crossref_get_work, crossref_get_updates, datacite_search_records et datacite_get_record. Ces quatre méthodes publiques ne nécessitent pas la clé OpenAlex. Pour les directions de citation d'OpenAlex, openalex_citations trouve des œuvres citant une oeuvre, tandis que openalex_references trouve les œuvres qu'il cite. Littérature Paramètres du graphique.
3. Confirmer l'accès avec une petite requête
Activez Genes & Ontologies, ouvrez une conversation avec un modèle connecté, et envoyez :
Exemple Vérifiez un identifiant de gène humain connu
Use Genes & Ontologies query_genes to resolve TP53 with scopes="symbol",
species="human" and fields="symbol,name,entrezgene". Return the input query,
matched records and any unmatched identifiers. Keep the response in English.
Inspecter le résultat de l'outil. Pour les TP53 humains, vérifiez query, symbol, Entrez Gene 7157 et le nom protéine tumorale p53. Conservez plusieurs allumettes jusqu'à ce que vous ayez confirmé l'organisme et enregistré. Une requête réussie confirme cette opération particulière; il n'établit pas l'accès à toutes les sources. Champs exacts.
Suivre un flux de travail de recherche
Chaque article ci-dessous comprend les entrées, les étapes, les captures d'écran réelles d'interface anglaise et les sorties d'exemple téléchargeables.
Trouver des données omiques publiques
Trouver des données omiques publiques et construire un inventaire de fichiers : commencez par une exécution connue ou un sujet, inspectez les enregistrements ENA et PRIDE, et enregistrez les emplacements des sources et les comptes de contrôle. Le téléchargement des données reste une étape séparée.
Comparer une séquence protéique
Trouvez une séquence protéique et effectuez une recherche BLAST: récupérer UniProt FASTA, conserver l'ID de travail BLAST, puis inspecter les alignements, l'identité et la couverture de requête terminées.
Analyser un ensemble de gènes candidats
Exécuter l'enrichissement fonctionnel d'un ensemble de gènes candidats : choisissez l'organisme, les identifiants et l'arrière-plan, lancez g:Profiler, et interpréter les probabilités corrigées avec les versions source.
Confirmer un génome de référence
Vérifier les espèces, le génome de référence et les identifiants chromosomiques : résoudre le taxon, l'assemblage en version et les alias chromosomiques avant de joindre les enregistrements.
Inspecter un réseau de voies
Inspecter une voie et son réseau d'interaction: trouver une voie Reactome humaine via Pathway Commons, préserver son URI retourné, exporter les interactions et distinguer un réseau sélectionné de la preuve de l'activité de voie.
Pour d'autres tâches, suivez dossiers PubChem structurés, des données scientifiques croisées ou découverte de la littérature pour une réunion de groupe.
Utiliser correctement les données retournées
- Conserver la requête, la source, l'organisme, les tissus, les unités et les versions d'adhésion. Les dossiers de base de données, les prévisions et les résumés générés sont différents types de preuves.
- Vérifiez les nombres retournés, les drapeaux de pagination et de troncation avant de traiter une réponse comme complète. Zero correspond, une réponse partielle et une erreur de requête nécessitent différentes actions de suivi.
- Un inventaire de fichiers fournit des emplacements et des métadonnées. Le téléchargement d'octets, la vérification des bilans et l'analyse des données sont des opérations distinctes.
- Si une demande a besoin de justificatifs, remplissez le formulaire pertinent avant de réessayer. Pour les limites tarifaires, suivez le délai du service; pour les temps d'attente, réduire la taille de la demande. Voir Dépannage.
Fréquences des populations et réseaux d'interaction
Pour get_variant, définissez include_populations: true uniquement lorsque les détails de la population sont nécessaires. Conserver l'ensemble de données et la compilation de référence. Les observations de l'exome et du génome restent distinctes. Une valeur non disponible est null, pas zéro; les strates de population ou de sexe ne doivent pas être résumées. Ce sont des fréquences observées, et non des fréquences allèles filtrantes. Paramètres de gnomAD
À partir de v0.31.0, get_string_network.nodes inclut des voisins retournés et des entrées cartographiques isolées. Une seule saisie cartographiée demande aux voisins; plusieurs entrées cartographiées ne sont pas développées. Filtrez is_query pour récupérer les nœuds d'entrée, et utilisez queries pour tous les alias cartographiés. n_nodes compte le graphique; n_mapped compte les mappages d'entrée. Mettre à jour les scripts qui ont assimilé les deux avant de les réutiliser. Paramètres de la STRING
Rechercher les paramètres d'exploitation
Les listes Référence de fonctionnement Connector contiennent les entrées requises, les valeurs autorisées et les appels exacts. Utilisez cette page pour choisir une source et la connecter; utiliser la référence pour les champs d'un outil particulier.
Source du catalogue : catalog.ts, registry.ts.
Recherches de séquences et alignement
HMMER fournit des recherches de séquence protéique, de profil HMM et d'alignement spécifiques au programme. Choisissez le programme et la base de données ensemble, conservez l'ID de travail, et récupérer les résultats seulement après SUCCÈS. Opérations HMMER.
InterProScan supporte la soumission de séquences protéiques, l'état de travail et la recherche d'annotation TSV de v0.35.1. Suivez Présentation de InterProScan pour la configuration et les étapes.
Le Genomes → Clustal Omega aligne au moins trois enregistrements uniques de protéines, d'ADN ou d'ARN FASTA. Configurez l'e-mail de contact demandé par le service, soumettez une fois, conservez l'ID de travail, puis vérifiez l'état et enregistrez l'alignement retourné. Déroulement de l'alignement de plusieurs séquences.
Enrichr, STRING et ClinPGx
- Genes & Ontologies → Enrichr: lister les bibliothèques actuelles, puis interroger l'enrichissement de gènes pour les fonctions, les facteurs de transcription, les perturbations, les médicaments, les maladies, les tissus ou les types de cellules. Sélectionnez une bibliothèque appropriée à l'organisme et questionnez, et conservez son nom, son arrière-plan et les valeurs P ajustées.
- Protein Annotation → STRING: vérifier si un réseau protéique a plus d'interactions que prévu à partir de son arrière-plan. Cela pose une question différente de la surreprésentation des voies; sa valeur réseau P n'est pas un test de parcours. Suivez le flux de travail d'enrichissement de groupes génétiques.
- Clinical Genomics → ClinPGx : récupérer les annotations de médicaments, de gènes ou de variantes, les lignes directrices, les étiquettes réglementaires et les fréquences des populations. Résoudre d'abord les identificateurs, fournir les champs requis par l'opération et conserver les sources originales et les niveaux de preuves. Cette méthode permet de récupérer les dossiers de recherche; il ne produit pas automatiquement un plan de traitement individuel.
Activez le Connector correspondant à l'agent actif dans Settings → Connectors. Ces entrées intégrées ne nécessitent pas de serveur MCP personnalisé. Consultez le Référence de l'opération pour connaître les champs exacts et les exigences conditionnelles.
Voies, expression et données cliniques
Activer la famille correspondante dans Settings → Connectors, puis indiquer à l'agent l'organisme, la source, les identifiants et la portée prévue. Ces ajouts utilisent des connecteurs intégrés; aucun serveur MCP personnalisé n'est requis.
| Entrée | Ce qu'il peut faire | Connexion et interprétation |
|---|---|---|
| Pathway Commons | Les chemins de recherche, les chemins de recherche, les chemins de requêtes entre gènes ou l'exportation d'un sous-modèle | Fonction publique; conserver l'URI retourné, l'organisme et la source. Les requêtes graphiques diffèrent des tests d'enrichissement. Suivez la flux de travail d'interaction de parcours. |
| Expression → Bgee | Inter-espèces présentes/absentes, scores normalisés, requêtes SPARQL limitées et liens de téléchargement | Découvrez d'abord les espèces et conservez l'ID de taxonomie de la BCNI. SPARQL nécessite des gènes, des espèces et des tissus. Les appels de base sains de type sauvage ne sont pas une expression différentielle; les liens de téléchargement ne sont pas téléchargés. |
| Modèles de cancer → cBioPortal | Lister les échantillons/patients et demander les attributs cliniques ou l'expression de l'ARNm/protéine | Sélectionnez une étude, découvrez ses profils et choisissez la mesure/normalisation. les cartes d'identité de l'offre correspondant à l'échantillon clinique/au niveau du patient; les données moléculaires ont besoin de gènes explicites et exactement un de sample_ids ou sample_list_id. Les rangées manquantes ne sont pas des zéros. |
| Réglementation pharmaceutique → openFDA | Recherche/compte des rapports FAERS et rappels de médicaments de recherche | Dates et produits en vrac et conservation de l'information sur la troncation. Les dénombrements ne sont pas des données d'incidence ou de cause. Les seaux à plusieurs valeurs peuvent se chevaucher; leur somme n'est pas un total de rapports unique. |
| Archives Omics → MGnify | Lister les fichiers de résultats par l'adhésion à l'analyse MGYA | Retourne le type, la catégorie, l'URL en amont et la taille lorsque signalé. Aucun octet de fichier n'est téléchargé; Les tailles manquantes ou les URL restent nulles. |
Consultez le Référence de fonctionnement Connector pour connaître les champs, les conditions et les exemples requis.
Interpréter la disponibilité des espèces Bgee
Commencez par bgee_species pour identifier l'espèce. Son taxon_id est l'ID taxonomique de l'organisme, et non l'espèce fournissant son génome de référence. Dans une réponse à la liste, has_expression_data: null signifie que la disponibilité n'a pas été déterminée. Redemandez-vous à l'aide du taxon_id retourné comme species_id pour charger les métadonnées source de données de cette espèce. Conserver null comme inconnu lorsque les métadonnées sont absentes; Seul un false explicite est un résultat de disponibilité négatif. Ces champs décrivent la couverture de l'atlas, et non pas si un gène particulier est exprimé dans un tissu.
Trouver des fichiers de statistiques sommaires GWAS
Activer Génétique humaine pour Main dans Settings → Connectors. Demandez la découverte de statistiques sommaires avec le Adhésion à GCST de l'étude, et conservez les URLs de fichiers originales/harmonisées retournées, les métadonnées et le génome de référence déclaré. La recherche publique ne nécessite pas de clé API.
gwas_get_summary_statistics liste les fichiers d'étude et lit les métadonnées disponibles YAML; il ne télécharge pas les grandes tables d'association. Ses définitions de colonnes GWAS-SSF décrivent la norme, et non un en-tête de fichier inspecté. Téléchargez le fichier prévu séparément et vérifiez ses colonnes réelles, la construction du génome, l'effet allèle et les unités avant l'analyse. Les résultats significatifs des associations ne remplacent pas les statistiques sommaires complètes. Paramètres et sortie.
Soumettre une séquence protéique à InterProScan
- Activer InterProScan pour Main dans Settings → Connectors. Dans Settings → Credentials → Literature access, enregistrez l'e-mail de contact valide utilisé pour les emplois EMBL-EBI; aucune clé API n'est requise.
- Fournir une séquence protéique ou une protéine unique nommée FASTA enregistre et demande de soumission une fois. La séquence et le courriel de contact sont envoyés à EMBL-EBI. Une demande accepte jusqu'à 1,000 enregistrements, 10,000 résidus par séquence et un corps de requête encodé 4 MiB.
- Conserver le job_id retourné. SUBMITTED avec ready: false est un reçu, pas un résultat d'annotation. Vérifier que État est séparé d'au moins dix secondes; le scrutin n'est pas automatique.
- Après FINISHED, demandez résultats et enregistrez le TSV complet avant l'expiration du résultat distant. Une réponse sur la limite de récupération de 2 MiB échoue plutôt que de renvoyer silencieusement un rapport tronqué.
- Vérifiez les identificateurs de protéines, les applications sources et les coordonnées inclusives basées sur 1. Les notes provenant de différentes applications membres ne sont pas interchangeables; aucun résultat ne prouve qu'une protéine manque de fonction.
Évitez la soumission de duplicata après un délai : récupérez d'abord un ID d'emploi connu. L'annulation d'une demande locale n'annule pas un emploi à distance soumis. Voir paramètres de soumission, d'état et de résultats.
Trouver des preuves TCR et BCR dans IEDB
Activez IEDB pour Main et demandez search_tcrs ou search_bcrs avec au moins un filtre biologique ou de preuve. La pagination seule est insuffisante. Utiliser sequence pour la séquence épitope; Les séquences chain1_cdr3 et chain2_cdr3 du récepteur de filtre CDR3. Ces recherches publiques n'ont pas besoin de clé API.
Conservez l'ID du groupe récepteur, les chaînes, les ID d'essai déclarés et les publications sources. Les filtres d'hôte et de résultat s'appliquent aux groupes agrégés et peuvent être satisfaits par différentes expériences. Pour établir que les conditions se produisent dans le même essai, suivez les ID de l'essai rapportés dans l'opération d'essai correspondante et appliquez les filtres requis là-bas. La pagination couvre les groupes récepteurs, pas l'intégralité de chaque exportation intégrée. Ces dossiers sont des données probantes, et non une prédiction de la liaison des récepteurs. Paramètres IEDB.
Découvrez la protéomique du cancer avec PDC
Activer PDC dans Settings → Connectors. Ses métadonnées publiques API n'ont pas besoin de clé API. Utilisez-le pour trouver des études et des versions, inspecter les dosages et les dénombrements des spécimens, cartographier les associations cas–échantillon–aliquotes et lister les fichiers quantitatifs tels que les rapports Assemblage des protéines. Il ne renvoie pas les données de traitement/de résultat ou de téléchargement des fichiers.
Commencez par une adhésion à l'étude comme PDC000127, ou des identifiants d'étude de recherche et des noms de version. La correspondance des mots clés PDC n'est pas un filtre clinique. Récupérer l'étude, puis utiliser son retour study_id UUID pour épingler les appels suivants; pdc_study_id sélectionne la dernière version. Fournir exactement un de ces sélecteurs.
Pour les listes de spécimens, les cas de dénombrements de pagination en amont; l'expansion des échantillons et des aliquotes peut produire plus de lignes que la limite de cas. Les pages par défaut du mode locaux ont reçu des associations et ont un plafond en amont de l'association 1,000. Une page locale finale ne s'avère pas complète lorsque ce plafond est atteint. Gardez séparément les ID PDC et les références externes GDC. Les listes de fichiers comprennent les noms, les tailles d'octets, les valeurs MD5 et les chemins de stockage; un chemin listé n'est pas une URL de téléchargement autorisée.
Voir Opérations et pagination PDC. Avant de combiner les sources, vérifiez la version de l'étude, l'analyse, l'identité du spécimen et les exigences d'accès et de citation de chaque source.
Vérifier LD spécifique à la population
Activer Genomes dans Settings → Connectors. Ses outils Ensembl LD utilisent le public API sans clé. Fournir deux ID de variante pour ensembl_ld_pairwise, ou un pour ensembl_ld_proxies, ainsi que le nom complet de la population, comme 1000GENOMES:phase_3:KHV. Les outils ne découvrent ni la population ni l'ascendance; choisir une population de référence appropriée à l'étude.
Rapport de résultats par paire r2 et D′. Les requêtes proxy par défaut à r2 ≥ 0.8 et un 500 kb fenêtre totale, environ 250 kb de chaque côté. max_records capte la liste retournée après le tri, et non le travail en amont. Garder les métadonnées de la population et les récupérer avec le résultat; ce paramètre ne signale pas l'ensemble de référence ou la libération de Ensembl. Les résultats vides signifient qu'aucune donnée admissible n'a été retournée, et non pas LD. Le niveau élevé de LD n'établit ni causalité ni équivalence fonctionnelle. Voir champs appariés et champs proxy.
Préserver le contexte de l'échantillon, de l'expression et du montage
| Demande | Interprétation dans v1.0.2 |
|---|---|
arrayexpress_get_experiment_samples | samples contient des lignes de relation à partir du premier fichier SDRF trié par chemin. n_rows_total / n_rows_returned nombre de lignes; n_samples / n_samples_returned compter les identifiants distincts, en préférant Nom de l'échantillon, alors Nom de la source. Ils ne sont pas des comptes biologiques de répétition indépendants. Les identificateurs manquants peuvent faire des dénombrements d'échantillons null. Un fichier vide ou no_sdrf la réponse n'établit pas que l'expérience n'a pas d'échantillons. |
metabolights_get_studies avec include_samples | Utiliser le retour headers commande lors de l'exportation sample_table. Les noms de colonnes répétés sont uniques #2, #3, ... suffixes sans écraser les noms originaux. Conserver toutes les colonnes; une chaîne vide dans une rangée courte est manquante de métadonnées. Vérifier rows_truncated. |
bgee_expression_calls | Gardez anatomical_entity_id/name avec cell_type_id/name. Un type de cellule manquant est null, pas un appel d'expression négative. Conservez l'état d'expression, la qualité et la condition ensemble. |
| Recherche de variantes de dbSNP | Conserver chaque placement assembly, assembly_full, seq_id, position et allèles. Une séquence peut être associée à plus d'un assemblage; ne pas effondrer ces associations ou utiliser le premier placement comme un renvoi automatique. |
Ces corrections modifient la façon dont les éléments de preuve retournés doivent être lus. Vérifiez le Référence de l'opération avant de comparer une réponse enregistrée plus ancienne avec une nouvelle recherche.
OpenAlex invites à la reconnaissance
v1.0.2 se souvient d'une prompte d'identification d'OpenAlex refusée pour la session en cours, en évitant les invites répétées. Si vous avez plus tard besoin de cette source, configurez-la explicitement dans Settings → Connectors → Literature Graph → Manage credentials → OpenAlex et réessayer la requête prévue. Le déclin de l'invite ne fournit ni clé ni garantie d'accès ni quota.
Connecter les nouvelles sources et préserver leur sens
Dans Settings → Connectors, trouver l'entrée ci-dessous et le permettre Main ou le spécialiste prévu. HGNC, PubTator 3, DGIdb et RNAcentral sont des outils dans les entrées existantes. Orphadata est une entrée séparée et est désactivée par défaut. Ces nouveaux outils utilisent des paramètres publics sans leur propre clé API; d'autres outils dans la même entrée peuvent avoir des exigences de certification différentes.
| Source | Entrée des paramètres | Demande et contrôle |
|---|---|---|
| HGNC | Genes & Ontologies | Interroger un symbole humain approuvé ou résoudre un alias exact. Conserver chaque match ambigu et le statut approuvé/retiré avant de choisir un gène. |
| PubTator 3 | PubMed | Récupérer les annotations par le PMID ou les entités/relations de recherche. La recherche de l'annotation couvre les titres/abstracts; elle ne soumet pas votre texte brut ou ne prouve pas que le texte complet supporte une revendication. |
| DGIdb | Clinical Genomics | Interrogez un nom de gène ou de médicament, conservez les sources et les publications et suivez le curseur retourné. Une interaction médicament-gène n'est pas une recommandation thérapeutique. |
| RNAcentral | RNA | Rechercher une adhésion URS, puis page à travers des références de base de données d'experts. Préserver la taxonomie, la séquence MD5 et les versions d'adhésion. |
| Orphadata | Orphadata | Activer l'accès d'abord, puis fournir un ORPHAcode pour les gènes ou les phénotypes HPO. Conserver les types d'association et les catégories de fréquence; ce ne sont pas des probabilités propres au patient. |
Appels exacts : HGNC, PubTator, DGIdb, RNAcentral, Orphadata.
Relier les métadonnées sur le cancer et interpréter une variante
- PDC: demander des données démographiques publiques et des champs de diagnostic avec
pdc_list_clinical. Utiliser soitpdc_study_idpour la dernière version oustudy_idpour une version fixe. Conserver les valeurs manquantes/obfusées et les références externes nommées; les UUID PDC et GDC ne sont pas interchangeables. - GDC: filtre les fichiers par
case_ids,sample_typesetworkflow_types. Conservez l'échantillon de chaque fichier, les associations aliquote et tumorale/normale au lieu de fusionner tous les fichiers dans un seul cas. Les filtres sont OU dans un champ et ET à travers les champs. L'accès aux métadonnées n'autorise pas les téléchargements de fichiers contrôlés. - Ensembl VEP: passe
hgvs_notationde lui-même, sansvariant_id,region,alleleouallele_orientation. Conservez le rapport d'assemblage, les versions de transcription et les drapeaux de troncation. les versions de référence d'entrée sont transmises, non validées;matchedn'établit pas de correspondance de version. Il s'agit de l'annotation de conséquence, et non de l'interprétation clinique ou du soulèvement. - Clinical Trials: Utilisation
get_trial_resultspour les mesures des résultats affichés, les dénominateurs, les analyses statistiques et les événements indésirables. Les identifiants de groupe correspondent uniquement dans le même module/résultats. Les résultats manquants ne sont pas des événements nuls ni une preuve d'aucun effet.
Voir Champs PDC, Filtres GDC, Modes VEP et résultats d'essai affichés.
Imagerie, voies, lipides et modèles de cancer
Dans Settings → Connectors, activer la source prévue et la mettre à la disposition Main. TCIA, KEGG, RxNorm / RxNav, DailyMed, BioSamples et WikiPathways sont des entrées séparées, désactivées par défaut. Les opérations ci-dessous utilisent des services publics sans serveur MCP personnalisé ou clé API. L'activation d'un connecteur n'accorde pas de licence de données ou d'accès restreint aux données.
| Entrée | Demande | Conservez avec le résultat |
|---|---|---|
| TCIA | Trouver des collections; inspecter une collection ou une série DICOM UID existante | Licence, conditions d'accès et exigences de téléchargement. Les liens retournés peuvent être des manifestes Data Retriever, et non des fichiers image. |
| KEGG | Recherche par voie/KO/compound/réaction; cartographie d'un gène qualifié d'organisme | Conditions d'admissibilité à l'utilisation académique et de licence; cartographies et troncations d'un à plusieurs. Il ne s'agit pas d'enrichissement par gènes. |
| Chimie → LIPID MAPS / UniChem | Rechercher un CID LMID ou PubChem exact; carter un ID InChIKey ou ChEMBL | Résoudre les noms avec PubChem. Préserver des correspondances distinctes et l'attribution des sources; ce ne sont pas des recherches de similitude. |
| Structures et interactions → OmniPath | Demande de règlement en amont/en aval pour une identifiant UniProt canonique humain | Direction, signes contradictoires de stimulation/inhibition et identifiants complexes. Les relations agrégées ne sont pas une preuve causale propre aux tissus. |
| Structures et interactions → PDBe / PDB | Vérifier la validation expérimentale de la structure ou trouver des chaînes protéiques déposées similaires | Méthode et paramètres manquants; utiliser label_asym_id, pas un identifiant de chaîne d'auteur. Les scores de similarité ne sont pas un alignement structural calculé ou un RMSD. |
| Modèles de cancer → DepMap / CCLE | Résoudre une ligne cellulaire à ModelID, puis demander un profil génétique ou composé | Diffusion et échelle des données : Chronos n'est pas une probabilité ; PRISM AUC n'est pas IC50 ; l'ARN est log2(TPM+1) ; le numéro de copie est relatif à la ploïdie. |
| RxNorm / RxNav · DailyMed | Résoudre les noms de médicaments à RxCUI; inspecter les identités des étiquettes SPL et l'historique des versions | Gardez des identités ambiguës. Les noms correspondants n'établissent pas d'équivalence clinique; une liste DailyMed n'établit pas l'approbation de la FDA. |
| BioSamples · WikiPathways | Trouver des métadonnées d’échantillons ou de métadonnées de cheminement et des révisions | Identifiant, espèce, dates de la source et preuves liées. Ces recherches ne téléchargent pas de fichiers d’échantillons ni de graphiques de parcours liés. |
Utiliser référence de l'opération pour les entrées exactes et la pagination. Préserver les nulls et les marqueurs de résultats tronqués; un résultat limité n'est pas la base de données entière.
Découvrez les données de recherche officielles et les listes de fichiers
Dans Settings → Connectors, activez uniquement les entrées nécessaires pour votre question. Les nouvelles entrées Europe PMC, Research Datasets, ChEA3, bioDBnet et CTD utilisent des services publics sans clé API requise. Les demandes continuent d'envoyer les termes de recherche, les identifiants ou les listes de gènes fournis à ces services. Contrôles de connexion.
| Besoin | Entrée et résultat | Prochaine étape |
|---|---|---|
| Rechercher directement des documents biomédicaux | Europe PMC retourne les enregistrements de base, les résumés disponibles et un curseur de la page suivante | Enregistrer les identifiants et continuer la pagination ; une URL texte complet n'est pas récupérée texte complet |
| Trouver des dossiers d'enquête ou de démonstration clinique | Research Datasets liste les fichiers NHANES avec des liens de cycle/documentation et des démos publiques de version fixe MIMIC/eICU | Vérifier le cycle, la version, la licence et la documentation avant de télécharger depuis la source officielle |
| Comprendre l'accès aux ensembles de données | Research Datasets explique les points d'entrée pour NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, FAERS et GBD | Compléter le processus d'enregistrement, de formation ou d'exportation de la source au besoin |
| Découvrez les rapports publics | Drug Regulatory, CTD et Cellosaurus lister les emplacements des fichiers officiels | Vérifiez la page source actuelle, la version et les termes; la découverte ne télécharge pas ou n'importe pas les fichiers |
| Normaliser les identifiants de gènes | Genes & Ontologies ajoute les champs de service HGNC, les requêtes de champ et les listes de fichiers; bioDBnet ajoute conversion et cartographie orthologique | Découvrez d'abord les champs/types pris en charge; conservez des résultats ambigus, non maquillés et uniques à beaucoup |
| Régulateurs candidats | ChEA3 Retours par bibliothèque transcription-facteur classement et liens de bibliothèque GMT | Traiter les classements comme des hypothèses; une bibliothèque GMT téléchargée peut différer de la bibliothèque derrière un résultat en ligne |
| Inspecter les preuves de la ligne cellulaire | Cellosaurus ajoute RDF, limited SPARQL et STR similarité | Préserver les paramètres d'adhésion et de marquage; la similarité seule ne certifie pas l'identité de l'échantillon |
Les listes de fichiers renvoient les URLs officielles et les métadonnées sources, pas les fichiers téléchargés ou une base de données d'analyse prête. L'analyse NHANES exige toujours la conception et les poids corrects de l'enquête. L'accès à la démo MIMIC/eICU ne permet pas l'accès à leurs ensembles de données complets. Les rapports FAERS ne peuvent être interprétés comme des taux d'incidence. Pour des champs et des exemples exacts, utilisez la référence de l'opération.