科學資料庫
本頁介紹支援哪些資料來源、可以完成什麼任務,以及如何在 Open-Science 中啟用和連線。需要帶操作截圖與結果檔案的完整案例時,進入科研工作流。
目前支援哪些資料庫
Open-Science v1.0.5 內建 48 個 Connector,共提供 418 項操作:其中 47 個資料來源 Connector 提供 416 項操作,1 個離線 Molecule Connector 提供 2 項操作。下表名稱對應 Settings → Connectors 中的項目,一個 Connector 可以包含多個資料庫。支援某個資料來源不表示涵蓋其網站的全部功能。
此處統計全部內建項目,包括未啟用的項目;使用者自行新增的 MCP Connector 另計。Connector 數量、涵蓋的資料庫數量和可呼叫的操作數量是不同的統計口徑。
| Connector | 來源 | 運算元 | 用途 |
|---|---|---|---|
Chemistry · chemistry | PubChem, ChEBI, Rhea, BindingDB, LIPID MAPS, UniChem | 14 | 小分子、化學識別符號、反應及結合資料 |
Literature Graph · literature | OpenAlex, arXiv, Crossref, DataCite | 13 | 文獻、作者、引用、DOI 更新及資料集/軟體記錄 |
PubMed · pubmed | PubMed, PMC, Europe PMC, PubTator 3 | 9 | PubMed 文獻檢索與記錄 |
Genes & Ontologies · genes | HGNC, MyGene, UniProt, OLS, QuickGO, Reactome, g:Profiler, Enrichr | 20 | 基因及蛋白標識映射、UniProt 序列查找、GO 與 Reactome 註釋、g:Profiler 與 Enrichr 基因集富集 |
Genomes · genomes | NCBI Datasets, NCBI BLAST, EMBL-EBI Job Dispatcher, Ensembl, UCSC | 22 | 基因組註釋、同源及序列資訊;NCBI 物種、組裝與序列身分;BLAST 檢索、Clustal Omega 多序列比對;指定人群的 LD 與代理變異 |
Variants · variants | gnomAD, ClinVar, dbSNP, MaveDB | 22 | 群體頻率、臨床記錄,以及實驗特定的功能分數、變異對映和實驗資訊 |
Clinical Trials · clinical-trials | ClinicalTrials.gov | 7 | 檢索試驗與方案,並讀取已公佈的結局測量、分組、統計及不良事件 |
Clinical Genomics · clinical-genomics | ClinGen, CIViC, Open Targets, ClinPGx, DGIdb | 32 | 臨牀基因組證據資源;新增 ClinPGx 藥物基因組學記錄 |
Structures & Interactions · structures | PDB, PDBe, AlphaFold, EMDB, Complex Portal, IntAct, OmniPath | 20 | 結構檔案與相關記錄 |
ChEMBL · chembl | ChEMBL | 7 | 化合物、靶標和活性記錄 |
bioRxiv · biorxiv | bioRxiv, medRxiv, ROR | 7 | 預印本後設資料 |
Drug Regulatory · drug-regulatory | openFDA | 11 | Drugs@FDA、藥品標籤、FAERS 不良事件報告和藥品召回 |
Human Genetics · human-genetics | GWAS Catalog, eQTL Catalogue, PheWeb | 15 | 人類遺傳關聯資源 |
Expression · expression | GTEx, Bgee | 16 | GTEx 人類組織表達和 eQTL;Bgee 跨物種基線表達 |
Protein Annotation · protein-annotation | InterPro, Pfam, Human Protein Atlas, STRING | 14 | 蛋白結構域與功能註釋;新增互作富集檢驗 |
Cancer Models · cancer-models | cBioPortal, DepMap / CCLE | 15 | 研究、突變、複製數、樣本、患者、臨床屬性及分子 profile 表達 |
RNA · rna | Rfam, RNAcentral | 11 | RNA 家族與相關資源 |
Omics Archives · omics-archives | ArrayExpress, GEO, ENA, MetaboLights, Metabolomics Workbench, MGnify, PRIDE | 28 | 組學研究/執行後設資料與檔案清單;代謝組樣本、實驗因素、分析及化合物記錄 |
CellGuide · cellguide | CELLxGENE | 5 | 細胞型別參考資訊 |
Regulation · regulation | ENCODE, JASPAR, UniBind | 16 | 調控與功能組學記錄 |
Research Resources · research-resources | Grants.gov, Antibody Registry | 5 | 研究專案、資助等資源 |
BioMart · biomart | Ensembl BioMart | 8 | BioMart 資料集與欄位查詢 |
ZINC · zinc | ZINC | 5 | ZINC 化合物記錄 |
GDC · gdc | Genomic Data Commons (GDC) | 5 | 癌症專案、病例與檔案後設資料,公開/受控訪問類別及傳輸清單;不下載或授予受控訪問 |
Zenodo · zenodo | Zenodo | 2 | 公開資料集、軟體和文獻記錄的檢索、版本級後設資料與檔案清單;不上傳或下載檔案 |
HMMER · hmmer | HMMER3, EMBL-EBI | 3 | 按程式提交蛋白序列/profile HMM/比對檢索,查詢狀態並獲取結果 |
InterProScan · interproscan | InterProScan, EMBL-EBI | 3 | 提交蛋白序列、查詢註釋任務狀態並獲取 TSV 報告 |
Pathway Commons · pathway-commons | Pathway Commons, Reactome | 4 | 通路檢索、頂層通路、圖查詢及 BioPAX 子模型匯出 |
Alliance Genome Resources · alliance | Alliance of Genome Resources | 8 | 人類與模式生物基因、直系同源、疾病模型、表型、等位基因及表達 |
CELLxGENE Discover · cellxgene-discover | CELLxGENE Discover | 9 | 單細胞集合與資料集發現、釋出版本、檔案格式/大小/下載 URL |
Cellosaurus · cellosaurus | Cellosaurus | 6 | 查詢細胞系名稱和別名,再檢查編號身份及質量註釋 |
Monarch Initiative · monarch | Monarch Initiative | 2 | 查詢疾病或基因與表型的關聯,保留物種和支援證據 |
IEDB · iedb | IEDB | 8 | 檢索表位、抗原、T 細胞、B 細胞和 MHC 實驗、TCR/BCR 證據及來源文獻 |
PDC · pdc | PDC | 5 | 癌症蛋白組研究版本、樣本關聯、公開病例臨牀信息及文件元數據;不下載文件 |
ENCORI · encori | ENCORI | 10 | miRNA/RBP 靶標、RNA 互作、ceRNA、motif、結合位點與參考/批次資料 |
Orphadata · orphadata | Orphadata, Orphanet | 2 | 罕見病—基因關聯及 HPO 表型頻率;默認關閉 |
TCIA · tcia | TCIA, NBIA | 3 | 公開影像集合、訪問條件與序列元數據 |
KEGG · kegg | KEGG | 3 | 通路、化合物條目及基因映射;須遵守許可限制 |
RxNorm / RxNav · rxnorm | RxNorm, RxNav | 2 | 藥名解析與有效概念屬性 |
DailyMed · dailymed | DailyMed | 2 | 藥品標籤身份與版本歷史 |
BioSamples · biosamples | EMBL-EBI BioSamples | 2 | 公開樣本元數據與交叉引用 |
WikiPathways · wikipathways | WikiPathways | 2 | 通路元數據、物種及修訂信息 |
Europe PMC · europepmc | Europe PMC | 1 | 直接檢索文獻、摘要與分頁 |
Research Datasets · research-datasets | NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, GBD | 3 | 數據訪問條件與公開文件發現 |
ChEA3 · chea3 | ChEA3 | 2 | 轉錄因子富集排名與 GMT 鏈接 |
bioDBnet · biodbnet | bioDBnet | 6 | 標識轉換、同源映射與通路 |
CTD · ctd | CTD | 1 | 官方公開報告入口與條款 |
離線 Molecule 工具見科學檢視器。各資料來源實際提供的操作見 Connector 操作引數參考。
可以完成什麼任務
| 科研任務 | 使用的 Connector | 常見輸出 |
|---|---|---|
| 查詢文獻、追蹤引用、檢查 DOI 關聯關係 | Literature Graph、PubMed、bioRxiv | 文獻記錄、編號、引用關係和全文可用資訊 |
| 查詢基因或蛋白並比較序列 | Genes & Ontologies、Genomes | 識別符號對映、蛋白記錄、FASTA 和 BLAST 報告 |
| 發現公開組學資料並檢查可用檔案 | Omics Archives | 專案/執行後設資料,以及帶來源地址、大小和可用校驗值的檔案清單 |
| 解釋基因列表或檢視相互作用網路 | Genes & Ontologies、Protein Annotation | 富集結果表、本體註釋和網路記錄 |
| 核查變異、表達與調控證據 | Variants、Clinical Genomics、Human Genetics、Expression、Regulation | 帶物種、組織、參考基因組版本和相關證據欄位的來源記錄 |
| 獲取化合物、結構或臨床研究記錄 | Chemistry、ChEMBL、Structures & Interactions、Clinical Trials | 化學標識及性質、結構檔案和試驗後設資料 |
批次轉換識別符號時,Genes & Ontologies 提供 submit_uniprot_id_mapping、get_uniprot_id_mapping_status 和 get_uniprot_id_mapping_results。儲存任務 ID,至少間隔三秒查詢一次狀態,再取完所有結果頁。保留一對多對映和明確返回的 failed_ids,某頁未出現不等於未匹配。最多可提交 100000 個識別符號,結果最長保留約七天。見對映引數。
Zenodo 無需認證即可查詢公開記錄後設資料,應保留版本級記錄 ID、訪問和許可欄位。GDC 提供公開後設資料,生成清單不等於獲得下載授權,受控檔案仍需 GDC 權限。GDC 操作 · Zenodo 操作。
資料庫響應可以支援一個科研步驟,但不會自動下載資料、把所有論文加入文獻庫或完成整套分析。需要儲存哪些記錄和檔案,應在請求中明確說明。
RNA 調控證據:ENCORI
在 Settings → Connectors 搜尋 ENCORI,啟用並使其對 Main 可用。它是內建資料來源,不需要自定義 MCP 地址或 API key。選擇可用主模型,在會話中明確物種/assembly、RNA 或靶基因、細胞型別與證據閾值。
| 任務 | 結果與使用邊界 |
|---|---|
| miRNA、RNA–RNA、RBP 靶標及 ceRNA 查詢 | 保留 CLIP、降解組、預測程式、p 值與 FDR 等適用證據;結合或關聯不等於因果調控 |
| RBP 疾病、motif 與結合位點 | 保留參考基因組、組織/細胞、上游順序和原始座標,避免混合不同物種或座標體系 |
| 參考表與批次資料 | 先列出精確表路徑或檔名;批次下載是單獨操作,明確檔案、目錄與所需空間後再執行 |
案例演示 查詢 PDCD4 在 HeLa 條件下的 miRNA 靶標證據
Use ENCORI to find human miRNA interactions targeting PDCD4 in HeLa cells,
using hg38, mRNA targets, at least one CLIP experiment and TargetScan support.
Show at most two rows. Preserve the exact filters, total count and full raw
response in the session data folder. Explain the evidence limits in English.
Do not download bulk datasets.
本例得到 19 條記錄,前兩條為 hsa-miR-23a-3p 與 hsa-miR-181a-5p。下圖顯示儲存後的完整原始響應及其證據範圍;這是本次查詢結果,資料庫更新後數量可能變化。
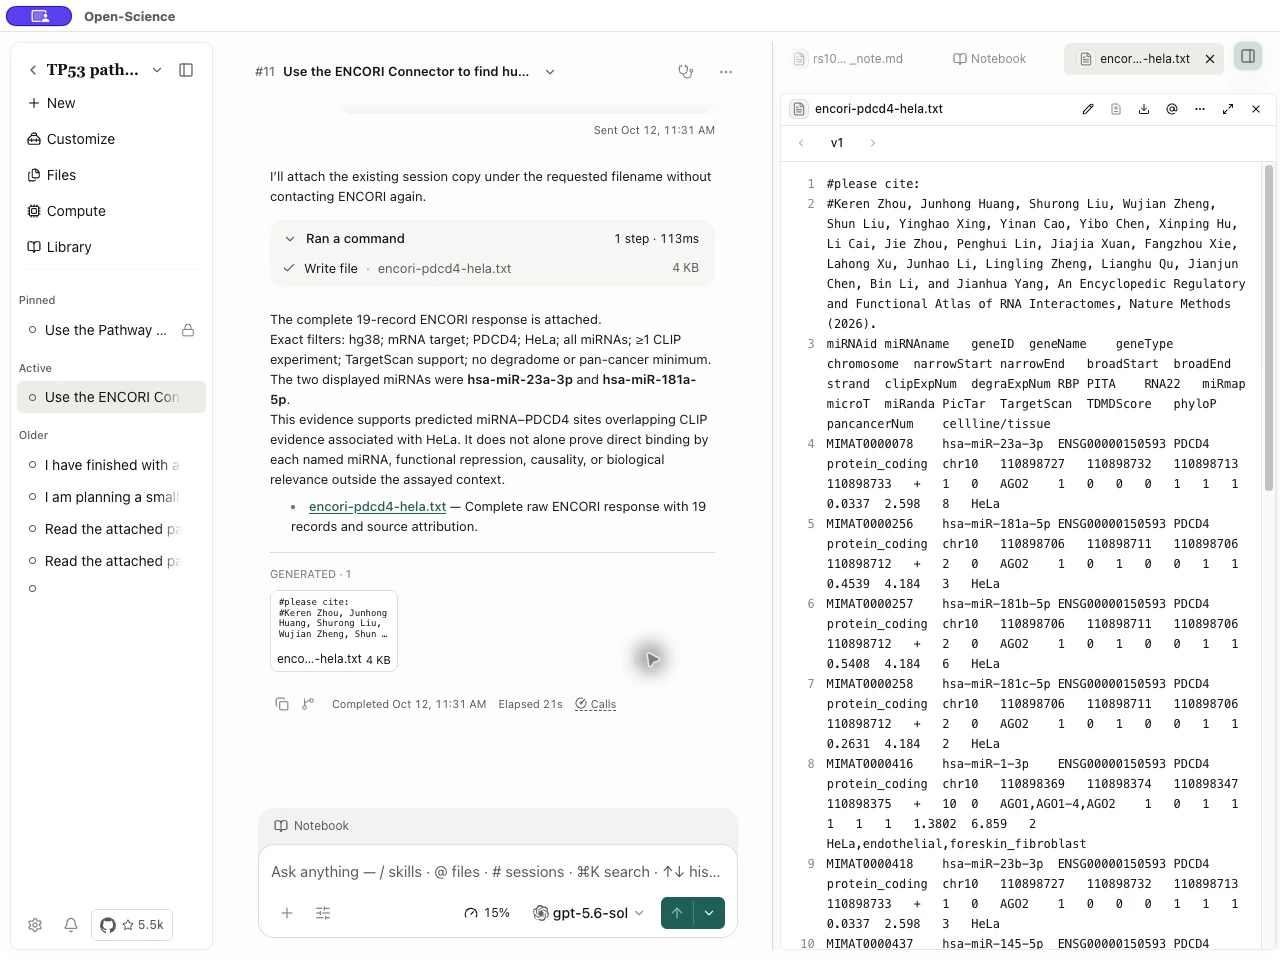
讀取結果時,區分 total_records 與 returned_records,並檢查 is_complete、result_scope 和 completeness_note。預覽只顯示部分行時,不要用它概括全部靶標分佈。完整原始響應的 raw_response_path 是本地檔案路徑,不自動等於可下載的會話產物;需要共享時,讓 Agent 儲存到會話可訪問的資料目錄並附加檔案,開啟後核對內容。
查詢可返回真實空結果,也可返回 ok:false。不要為了得到命中自動放寬條件。批次檔案下載完成後檢查實際路徑、大小與 verified_gzip;參考表查詢和檔案列表不等於已取得批次資料。精確引數見 ENCORI 操作參考。
實驗條件與逐條提交證據
| 入口 | 操作順序 | 判斷邊界 |
|---|---|---|
| ChEMBL | 啟用 Connector,無需 API key。先從活性記錄取得 assay_chembl_id,用 get_assay 檢視方法、物種、細胞/組織和靶標;再用同一 assay ID 查詢 get_bioactivity | 靶標歸屬置信度不是測量質量;比較 IC50/Ki 前核對條件、單位及關係符號 |
| Variants → ClinVar | 在 Connector 中配置真實的 NCBI 聯絡郵箱,API key 可選。查詢 clinvar_get_submissions,傳入 VCV accession 或正整數 Variation ID;後續分頁沿返回的 next_page 固定版本 | 保留 SCV、提交者、疾病、評估日期、方法及引用;胚系、體細胞臨床影響與致癌性應分別比較 |
ChEMBL 每頁按 activity_id 排序。保持過濾條件不變,將 next_offset 作為下一頁 offset,直到 has_more:false;可以取得超過 1,000 條記錄。summary 僅覆蓋當前頁,不能用一頁最強活性代表整個查詢。ClinVar 首頁解析到最新版本後,繼續使用返回的帶版本 VCV;不要用 RCV、SCV 或 rsID 替代輸入。
ChEMBL 實驗引數 · 活性分頁 · ClinVar 提交引數。
單細胞、模式生物及變異功能資料
在 Settings → Connectors 搜尋下表中的入口,開啟 Main 的可用性,再向會話說明研究物件、物種及需要儲存的記錄。這四類新增操作讀取公開資料,無需另外新增自定義 MCP 伺服器、API key 或 NCBI 聯絡郵箱;同一 Connector 的其他服務可能有不同要求。
| 入口 | 可以做什麼 | 使用要點 |
|---|---|---|
| CELLxGENE Discover | 按物種、組織、疾病、實驗方法或細胞型別發現單細胞資料集;查詢版本及檔案清單 | 本體過濾使用精確標籤或 ID,多個條件同時滿足。保留 dataset_version_id,按釋出快照讀取檔案清單;普通 dataset_id 指向當前版本。只返回可用下載 URL,不下載檔案或查詢 Census 表達矩陣。細胞型別說明和標記基因仍使用獨立的 CellGuide |
| Alliance Genome Resources | 查詢人類、小鼠、大鼠、果蠅、線蟲、斑馬魚、酵母和蛙的基因、同源關係、疾病模型、表型及表達 | 先搜尋並核對物種,再沿返回的基因 ID 查詢。保留證據及同源嚴格程度;模型生物的表型不等於人類疾病結論 |
| Variants → MaveDB | 查詢變異效應實驗分數集、實驗方法、CSV 分數頁及已有 VRS 對映 | 保留 URN、許可、實驗方法與分數校準。功能分數不是臨床致病分類;CSV 按 start/limit 分頁,返回文字仍需儲存成檔案。對映查詢不會執行 liftover |
| Omics Archives → Metabolomics Workbench | 搜尋研究,檢視 ST 編號對應的樣本、因素、分析及代謝物;查化合物結構和交叉引用 | section 區分 summary、factors、analysis、metabolites。化合物名稱先用 PubChem 解析為支援的識別符號;這些操作不下載原始測量矩陣 |
CELLxGENE 的篩選與分頁在本地對當次取得的上游目錄執行,跨請求目錄可能更新。固定釋出版本時使用版本 ID;上游沒有報告的檔案大小為 -1,不能當成零位元組。MaveDB、Workbench 的缺失值和實驗定義也應隨結果保留。
具體輸入見 CELLxGENE Discover、Alliance、MaveDB 和 Metabolomics Workbench。
細胞系、表型與免疫實驗證據
在 Settings → Connectors 啟用 Cellosaurus、Monarch Initiative 或 IEDB,並將其提供給 Main。這些操作讀取公共記錄,無需自建伺服器或 API key。
| 入口 | 可以查詢什麼 | 應保留和核對什麼 |
|---|---|---|
| Cellosaurus | 按細胞系名稱或別名搜尋,再讀取返回的 CVCL 編號或 RRID | 物種、身份、別名,以及汙染或錯誤鑑定註釋。搜尋接受普通短語,不接受原始 Solr 查詢。缺少質量註釋不代表細胞系已透過認證 |
| Monarch Initiative | 使用 MONDO:0007254、HGNC:11998 等規範 CURIE 查詢疾病或基因的表型關聯 | 物種、表型、來源與證據。別名不會自動轉換,先解析識別符號。直接匹配描述的是識別符號匹配方式,不代表實驗確認 |
| IEDB | 檢索表位、抗原,或具體的 T 細胞、B 細胞、MHC 實驗 | 至少提供一個生物學或證據篩選條件,僅分頁不夠。antigen_iri 與 uniprot_accession 二選一。保留實驗方法、結果、單位和文獻;MHC 洗脫觀察不等於親和力測量 |
聚合的表位或抗原記錄可能合併多個實驗的觀察。如果多個篩選條件必須在同一實驗中成立,應查詢相應的實驗操作。零匹配不代表生物學上的陰性結論。Cellosaurus 引數 · Monarch 引數 · IEDB 引數。
查詢 GEO 矩陣和序列匹配結構
Omics Archives → geo_get_matrix_files 查詢官方 GEO Series Matrix 和 NCBI 生成的計數、FPKM、TPM、註釋檔案。它返回檔案位置,不會下載檔案內容。geo_get_series 仍用於後設資料查詢。
取得矩陣後,geo_preflight_matrix 檢查已經讀取、解壓的文字,大小上限為 8 MiB。該操作不訪問網路或檔案系統。保留 GSM 識別符號與平臺後設資料,按樣本 ID 對映,而不是依賴列的位置。預覽片段必須設定 complete: false;只有傳入完整檔案時才能使用 complete: true。片段不能證明整個檔案的維度。壓縮包、稀疏矩陣和 HDF5 檔案不能直接交給此文字檢查器。見矩陣發現和文字預檢查。
Structures & Interactions → pdb_search_sequence 接受一條 25–10,000 個殘基的蛋白質序列,可用原始序列或單條 FASTA。序列一致性和查詢覆蓋度閾值均為 0 到 1 的比例。返回的查詢覆蓋度描述與輸入序列的比對範圍,不等於實驗解析的結構覆蓋度。上游總數是在本地覆蓋度篩選前計算的,有上限的掃描也可能未讀到後續匹配。該操作查詢結構記錄,不下載座標檔案。見精確輸入與掃描上限。
如何連線並開始使用
1. 啟用內建 Connector
- 開啟 Settings → Connectors,搜尋上表中的名稱,例如 Omics Archives。
- 開啟詳情並展開 Tools,閱讀目標操作的輸入、結果上限和第三方要求。
- 啟用 Main 的訪問權限,檢查 Used by。透過資源的 Manage access 調整 Main Agent 和 Specialist 關聯。啟用 Connector 與每個工具的審批策略是獨立設定。
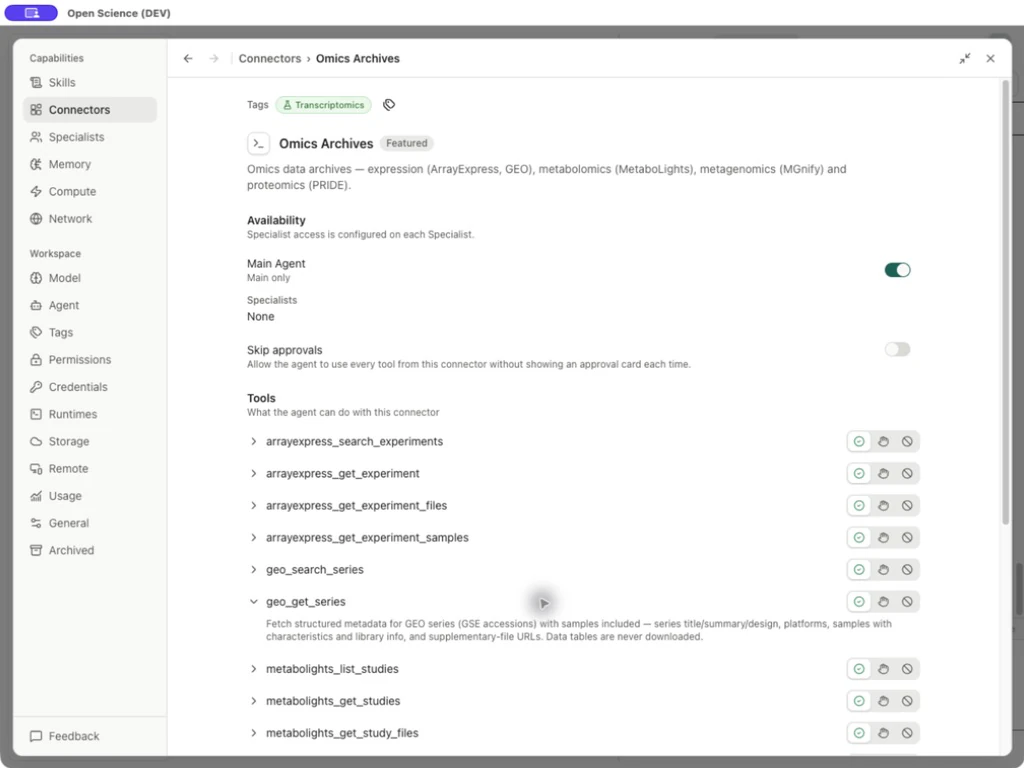
這些 Connector 已內建,無需為它們新增自定義伺服器。連線自己執行的外部服務時,參閱自定義 Connector 設定。出現在列表中或已啟用,不等於認證透過或查詢成功。
2. 按目標操作配置憑據
| 服務或使用條件 | 配置位置 |
|---|---|
| OpenAlex | 金鑰可選。需要配置時,開啟 Settings → Connectors → Literature Graph → Manage credentials → OpenAlex,驗證後儲存 |
| 要求聯絡郵箱的 NCBI 直接變異查詢 | Settings → Connectors → Manage credentials → Literature access。填寫 Contact email 並點選 Save;NCBI API key 為可選項 |
| 其他需要憑據的操作 | 按工具要求及憑據指南配置,並將憑據繫結到目標服務 |
金鑰應填寫在憑據表單中,不要放進科研提示詞或共享結果檔案。按所選操作配置要求;上面的聯絡郵箱要求不表示所有 NCBI 工具都需要同樣的設定。
Literature Graph 還提供 crossref_get_work、crossref_get_updates、datacite_search_records 和 datacite_get_record,這四個公開方法不需要 OpenAlex key。OpenAlex 引用關係中,openalex_citations 查詢引用該成果的文獻,openalex_references 查詢該成果引用的文獻。具體欄位見 Literature Graph 引數。
3. 用一次小查詢確認可用
啟用 Genes & Ontologies,開啟已連線模型的會話,傳送:
示例 核對一個已知的人類基因標識
Use Genes & Ontologies query_genes to resolve TP53 with scopes="symbol",
species="human" and fields="symbol,name,entrezgene". Return the input query,
matched records and any unmatched identifiers. Keep the response in English.
檢查實際工具返回。對於人 TP53,核對 query、symbol、Entrez Gene 7157 和名稱 tumor protein p53。有多個匹配時,先保留全部結果,再確認物種與目標記錄。一次查詢成功只說明該操作可用,不代表所有來源均已連通。準確欄位。
進入完整科研工作流
以下文章包含輸入材料、操作步驟、真實英文介面截圖和可下載的案例結果。
查詢公開組學資料
查詢公共組學資料並整理檔案清單:從已知執行編號或研究主題出發,檢查 ENA 與 PRIDE 記錄,儲存來源地址和校驗值。下載資料是後續獨立步驟。
比較蛋白序列
從基因名稱獲取蛋白序列並完成 BLAST 比對:獲取 UniProt FASTA,儲存 BLAST 任務編號,再檢查完成後的比對、一致率和查詢覆蓋率。
分析候選基因集
對候選基因集進行功能富集分析:選擇物種、識別符號和統計背景,執行 g:Profiler,並結合來源版本解讀校正後的機率。
核對參考基因組
分析前核對物種、參考基因組與染色體編號:關聯記錄前,先核對物種、帶版本的組裝和染色體別名。
檢查通路網路
檢查通路及其互作網路:透過 Pathway Commons 查詢人類 Reactome 通路,保留返回的 URI、匯出互作,並區分選定的網路與通路活性證據。
其他任務可參閱 PubChem 結構化記錄獲取、科學記錄交叉核對及組會文獻發現。
使用資料時注意什麼
- 儲存查詢條件、來源、物種、組織、單位及登入號版本。資料庫記錄、預測和模型生成的總結屬於不同證據型別。
- 檢查返回數量、分頁和截斷標記,再判斷是否完整。零條匹配、部分響應和請求錯誤需要分別處理。
- 檔案清單提供地址與後設資料。下載檔案、校驗內容和分析資料是獨立操作。
- 請求需要憑據時,先填寫對應表單再重試。觸發限流時按服務要求等待,超時時縮小請求範圍。具體處理見故障排查。
人群頻率與相互作用網路
需要人群細節時,對 get_variant 設定 include_populations: true,保留資料集與參考組裝。外顯子組與基因組觀察應分開;不可用值為 null,不等於零;相互重疊的人群或性別分層不能相加。這些是觀察頻率,不是過濾等位基因頻率。gnomAD 引數
從 v0.31.0 起,get_string_network.nodes 包含返回的鄰居及孤立的已對映輸入。單個對映輸入會請求鄰居,多個對映輸入不擴充套件。只需輸入節點時篩選 is_query,全部輸入別名使用 queries。n_nodes 是網路節點數,n_mapped 是輸入對映數;複用舊指令碼前修正將兩者等同的邏輯。STRING 引數
查詢具體操作引數
Connector 操作引數參考列出必填輸入、可選值和準確呼叫方法。本頁用於選擇和連線資料來源,引數參考用於查詢某個具體工具的欄位。
目錄來源:catalog.ts、registry.ts。
序列檢索與多序列比對
HMMER 支援按程式選擇蛋白序列、profile HMM 或比對輸入。將程式與資料庫配對,儲存任務 ID,等 SUCCESS 後獲取結果,見 HMMER 操作。
InterProScan 從 v0.35.1 起支援提交蛋白序列,再查詢任務狀態並獲取 TSV 註釋。具體連線與步驟見提交 InterProScan。
Genomes → Clustal Omega 對至少三條名稱唯一的蛋白質、DNA 或 RNA FASTA 記錄進行比對。配置服務要求的聯絡郵箱,提交一次並儲存任務 ID,再查詢狀態、儲存返回的比對,見多序列比對工作流。
Enrichr、STRING 與 ClinPGx
- Genes & Ontologies → Enrichr:先列出當前庫,再用基因列表查詢功能、轉錄因子、擾動、藥物、疾病、組織或細胞型別相關富集。選擇與物種和問題相符的庫;記錄背景、庫名稱及校正 P 值。
- Protein Annotation → STRING:檢查蛋白網路的互作數量是否超過背景預期。它與通路過度代表分析回答不同問題,不能用網路 P 值代替通路檢驗。參見基因集富集工作流。
- Clinical Genomics → ClinPGx:按藥物、基因或變異查閱臨床註釋、指南、監管標籤和族群頻率。先解析識別符號,再按操作所需欄位查詢,保留原始來源和證據等級。該入口用於檢索資料,不自動給出個體用藥方案。
在 Settings → Connectors 中向當前代理開啟相應 Connector;這些內建入口不需要另建自定義 MCP 伺服器。準確欄位和條件見操作參考。
通路、表達及臨床資料
在 Settings → Connectors 中開啟對應家族,再向代理說明物種、來源、識別符號和所需範圍。這些擴充套件沿用內建 Connector,無需另建自定義 MCP 伺服器。
| 入口 | 可以做什麼 | 連線和解釋要點 |
|---|---|---|
| Pathway Commons | 搜尋通路、查頂層通路、查詢基因間路徑或匯出子模型 | 公共服務;保留實際返回的 URI、物種和來源。圖查詢與富集檢驗不同,見通路互作工作流 |
| Expression → Bgee | 跨物種表達存在/缺失判斷、標準化分數、有界 SPARQL 查詢及下載連結 | 先查物種,保留 NCBI taxonomy ID;SPARQL 的基因、物種、組織均必填。健康野生型基線不是差異表達結果,下載連結不等於已下載檔案 |
| Cancer Models → cBioPortal | 列出樣本與患者、查詢臨床屬性和 mRNA/蛋白表達 | 先定 study,再查 profile,明確測量與歸一化。臨床值按樣本/患者層級提供相應 ID;表達查詢提供明確基因,並在 sample_ids 與 sample_list_id 中恰好選一個。缺失行不是零 |
| Drug Regulatory → openFDA | 搜尋/統計 FAERS 報告及藥品召回 | 限定日期和產品,保留截斷資訊。報告計數不是發生率或因果證據;多值分組可能重疊,不能相加當作去重報告總數 |
| Omics Archives → MGnify | 按 MGYA 分析編號列出結果檔案 | 返回型別、類別、來源 URL 和可用大小;沒有下載檔案內容,缺少大小或 URL 時保留 null |
準確必填欄位、條件和示例見Connector 操作參考。
理解 Bgee 物種的資料可用性
先用 bgee_species 確定物種。taxon_id 是該物種的 NCBI taxonomy ID,不是為它提供參考基因組的物種 ID。列表響應中的 has_expression_data: null 表示尚未判斷可用性。將返回的物種 ID 作為 species_id 再查一次,載入該物種的資料來源後設資料。後設資料缺失時保留 null 的未知狀態,只有明確的 false 才是無可用資料的結果。這些欄位描述圖譜的資料覆蓋範圍,不表示某個基因在某組織中是否表達。
查詢 GWAS 彙總統計檔案
在 Settings → Connectors 將 Human Genetics 提供給 Main。用研究的 GCST 編號請求發現彙總統計檔案,保留返回的原始/標準化檔案 URL、後設資料和宣告的參考基因組。公開查詢不需要 API key。
gwas_get_summary_statistics 列出研究檔案並讀取可用的 YAML 後設資料,不下載大型關聯結果表。返回的 GWAS-SSF 列定義描述的是標準,不是已檢查的實際檔案表頭。另行下載目標檔案後,核對實際列名、基因組版本、效應等位基因和單位,再進行分析。顯著關聯位點不能代替完整彙總統計。引數與輸出。
向 InterProScan 提交蛋白序列
- 在 Settings → Connectors 將 InterProScan 提供給 Main。在 Settings → Credentials → Literature access 儲存用於 EMBL-EBI 任務的有效聯絡郵箱,不需要 API key。
- 提供蛋白序列或名稱唯一的蛋白 FASTA 記錄,請求提交一次。序列和聯絡郵箱會傳送到 EMBL-EBI。單次最多 1,000 條記錄,每條最多 10,000 個殘基,編碼後的請求體不超過 4 MiB。
- 儲存返回的 job_id。SUBMITTED 且 ready: false 是提交回執,不是註釋結果。至少間隔十秒查詢一次 status,系統不會自動輪詢。
- 狀態為 FINISHED 後獲取 results,在遠端結果過期前儲存完整 TSV。超過 2 MiB 獲取限制時會報錯,不會靜默返回截斷報告。
- 核對蛋白標識、來源程式及從 1 開始且包含兩端的座標。不同成員程式的得分不能直接比較;沒有命中不代表蛋白沒有功能。
超時後避免重複提交,先找回已有任務 ID。取消本地請求不會取消已提交的遠端任務。見提交、狀態和結果引數。
查詢 IEDB 的 TCR 與 BCR 證據
將 IEDB 提供給 Main,使用 search_tcrs 或 search_bcrs,至少給出一個生物學或證據篩選條件,僅分頁不夠。sequence 指表位序列,chain1_cdr3 與 chain2_cdr3 才篩選受體的 CDR3 序列。這些公開查詢不需要 API key。
保留受體組 ID、鏈資訊、返回的實驗 ID 和來源文獻。宿主及結果條件作用於聚合後的組,可能分別由不同實驗滿足。若要確認條件在同一實驗中成立,應按返回的實驗 ID 查詢對應的實驗操作,並在那裡應用所需篩選。分頁針對受體組,不保證每條內嵌匯出記錄都完整。這是在檢索已有證據,不是在預測受體結合。IEDB 引數。
用 PDC 查詢癌症蛋白組資料
在 Settings → Connectors 啟用 PDC。公開後設資料 API 不需要 API key。它可查詢研究及版本、檢視實驗型別與樣本計數、關聯 case—sample—aliquot,並列出 Protein Assembly 等定量檔案。它不返回治療/結局資料,也不下載檔案。
可從 PDC000127 等研究編號開始,或搜尋研究識別符號和版本名稱。PDC 的關鍵詞匹配不是臨床疾病篩選。取得研究記錄後,使用實際返回的 study_id UUID 固定後續查詢版本;pdc_study_id 選擇最新版本。這兩個選擇欄位必須且只能提供一個。
生物樣本列表的 upstream 分頁按 case 計數,展開 sample 與 aliquot 後的關聯行數可以超過病例上限。預設 local 模式在已收到的關聯中分頁,上游最多返回 1,000 條關聯;達到此上限時,即使到了本地最後一頁,也不能證明研究資料完整。分別保留 PDC 識別符號和註明來源的 GDC 外部引用。檔案列表包含名稱、位元組數、MD5 和儲存路徑;列出的路徑不是授權下載 URL。
具體引數見 PDC 操作與分頁。合併來源前,核對研究版本、實驗型別、樣本身份,以及各來源的訪問與引用要求。
查詢指定人群的連鎖不平衡
在 Settings → Connectors 啟用 Genomes。Ensembl LD 工具使用公開 API,不需要金鑰。ensembl_ld_pairwise 需要兩個變異 ID,ensembl_ld_proxies 需要一個;兩者都必須提供完整人群名,例如 1000GENOMES:phase_3:KHV。工具不會自動發現人群或推斷祖源,應選擇適合研究的參考人群。
兩變異查詢報告 r² 和 D′。代理變異查詢預設 r² ≥ 0.8,視窗為 總寬 500 kb,即兩側各約 250 kb。max_records 限制排序後的返回列表,不限制上游工作量。結果應保留人群與檢索後設資料;該介面不報告參考基因組或 Ensembl 版本。空結果表示未返回符合條件的資料,不是零 LD;高 LD 既不證明因果,也不證明功能等價。見兩變異引數與代理變異引數。
保留樣本、表達和組裝背景
| 查詢 | v1.0.2 中的解讀方式 |
|---|---|
arrayexpress_get_experiment_samples | samples 是按路徑排序後的第一個 SDRF 檔案中的關係行。n_rows_total/n_rows_returned 計行數;n_samples/n_samples_returned 計去重標識數量,優先 Sample Name,其次 Source Name,不是獨立生物學重複數。缺少標識可使樣本計數為 null;空檔案或 no_sdrf 不表示實驗沒有樣本 |
metabolights_get_studies 配合 include_samples | 匯出 sample_table 時按返回的 headers 順序處理;重名列使用不覆蓋原名稱的 #2、#3 等字尾。保留所有列,短行中的空字串表示缺失後設資料,並檢查 rows_truncated |
bgee_expression_calls | 同時保留 anatomical_entity_id/name 與 cell_type_id/name。細胞型別缺失時是 null,不是陰性表達判斷;表達狀態、質量和條件應一起保留 |
| dbSNP 變異查詢 | 保留每個定位結果的 assembly、assembly_full、seq_id、位置與等位基因。同一序列可能關聯多個組裝,不能摺疊這些關聯,也不能把第一個定位結果當成自動座標轉換 |
這些修正影響返回證據的解讀。比較舊響應與新查詢前,先核對操作引數參考。
OpenAlex 憑據提示
v1.0.2 會在當前會話中記住對 OpenAlex 憑據提示的拒絕,避免重複打斷。之後需要該來源時,在 Settings → Connectors → Literature Graph → Manage credentials → OpenAlex 主動配置,再重試目標查詢。拒絕提示不等於已經提供密鑰,也不保證訪問權限或額度。
連接新增數據源並正確理解結果
在 Settings → Connectors 找到下表入口,向 Main 或目標 Specialist 開放。HGNC、PubTator 3、DGIdb 和 RNAcentral 屬於現有入口中的工具;Orphadata 爲獨立入口,默認關閉。這些新工具使用公開接口,不需要單獨的 API key;同一入口內的其他工具可能有不同憑據要求。
| 數據源 | 設置入口 | 請求與檢查 |
|---|---|---|
| HGNC | Genes & Ontologies | 查詢已批准的人類基因符號或解析精確別名;選擇基因前保留全部歧義匹配及批准/撤回狀態 |
| PubTator 3 | PubMed | 按 PMID 獲取標註或搜索實體/關係;標註獲取覆蓋標題/摘要,不提交你的原始文本,也不能證明全文支持某個論斷 |
| DGIdb | Clinical Genomics | 按基因或藥物名稱查詢,保留來源與文獻,並沿返回遊標繼續;藥物—基因相互作用不是用藥建議 |
| RNAcentral | RNA | 查詢 URS accession,再分頁讀取專家數據庫交叉引用;保留分類、序列 MD5 和 accession 版本 |
| Orphadata | Orphadata | 先啓用訪問,再提供 ORPHAcode 查詢基因或 HPO 表型;保留關聯類型及頻率類別,它們不是個體患者概率 |
具體調用:HGNC、PubTator、DGIdb、RNAcentral、Orphadata。
關聯癌症元數據與解釋變異
- PDC: 用
pdc_list_clinical獲取公開人口學和診斷字段。pdc_study_id選擇最新版本,study_id固定具體版本,二者選一。保留缺失/遮蔽值與標明來源的外部引用;PDC 和 GDC 的 UUID 不可互換。 - GDC: 用
case_ids、sample_types和workflow_types篩選文件。保留每個文件的樣本、aliquot 及腫瘤/正常流程關聯,不要將同一病例下所有文件混合。單個字段內按 OR 合併,字段之間按 AND 合併。能查詢元數據不代表獲准下載受控文件。 - Ensembl VEP: 單獨傳入
hgvs_notation,不要同時提供variant_id、region、allele或allele_orientation。保留返回組裝、轉錄本版本和截斷標誌。輸入參考版本會原樣傳遞,不進行驗證;matched不表示版本匹配。這是後果註釋,不是臨牀解釋或 liftover。 - Clinical Trials: 用
get_trial_results讀取已公佈的結局測量、分母、統計分析和不良事件。組 ID 僅在同一個結果模塊/結局內匹配。缺失結果不等於零事件,也不證明無效果。
參數見 PDC 字段、GDC 篩選、VEP 模式和已公佈試驗結果。
影像、通路、脂質與癌症模型
在 Settings → Connectors 中啓用所需來源,並設置爲 Main 可用。TCIA、KEGG、RxNorm / RxNav、DailyMed、BioSamples 和 WikiPathways 是默認關閉的獨立入口。下列操作訪問公開服務,不需要自建 MCP 服務或 API key。啓用 Connector 不等於取得數據許可或受限數據權限。
| 入口 | 可以請求什麼 | 結果中要保留什麼 |
|---|---|---|
| TCIA | 查找影像集合;查看集合或已有 DICOM series UID | 許可、訪問條件和下載要求;返回鏈接可能是 Data Retriever 清單,而不是影像文件 |
| KEGG | 搜索通路、KO、化合物與反應條目;映射帶物種前綴的基因 | 學術用途資格和許可條款、一對多映射及截斷標記;這不是基因集富集分析 |
| Chemistry → LIPID MAPS / UniChem | 用精確 LMID 或 PubChem CID 查詢;用 InChIKey 或 ChEMBL ID 映射 | 名稱先通過 PubChem 解析;保留不同匹配結果與來源歸屬,這些操作不做相似性搜索 |
| Structures & Interactions → OmniPath | 按人類標準 UniProt accession 查詢上游或下游調控 | 方向、激活與抑制的衝突證據、複合物標識;彙總關係不是組織特異的因果證據 |
| Structures & Interactions → PDBe / PDB | 查看實驗結構驗證統計,或檢索相似的已存檔蛋白鏈 | 實驗方法與缺失指標;使用 label_asym_id 而非作者鏈編號;相似性分數不是實際計算的結構比對或 RMSD |
| Cancer Models → DepMap / CCLE | 將細胞系解析爲 ModelID,再查詢基因或化合物的測量值 | 數據版本與量綱:Chronos 不是概率,PRISM AUC 不是 IC50,RNA 爲 log2(TPM+1),拷貝數相對於倍性 |
| RxNorm / RxNav · DailyMed | 將藥名解析爲 RxCUI;查看 SPL 標籤身份與版本歷史 | 保留有歧義的身份;名稱匹配不代表臨牀等效,DailyMed 收錄不代表 FDA 批准 |
| BioSamples · WikiPathways | 查找樣本元數據或通路元數據與修訂信息 | accession、物種、來源日期及證據鏈接;查詢不會下載關聯的樣本文件或通路圖 |
精確輸入與分頁方式見操作參數參考。保留空值與結果截斷標記;有限結果不等於整個數據庫。
查找官方研究數據與文件列表
在 Settings → Connectors 中,只啓用當前問題需要的入口。新增的 Europe PMC、Research Datasets、ChEA3、bioDBnet 和 CTD 使用公開服務,不要求 API Key;請求仍會將輸入的檢索詞、標識或基因列表發送給相應服務。連接控件。
| 需要做什麼 | 入口與返回內容 | 下一步 |
|---|---|---|
| 直接檢索生物醫學文獻 | Europe PMC 返回核心記錄、可用摘要與下一頁遊標 | 保存標識並繼續翻頁;全文 URL 不等於已經取得全文 |
| 找調查數據或臨牀演示文件 | Research Datasets 提供帶週期及說明鏈接的 NHANES 文件列表,以及固定版本的公開 MIMIC/eICU 演示數據 | 從官方來源下載前核對週期、版本、許可和文檔 |
| 瞭解數據訪問條件 | Research Datasets 說明 NHANES、CHARLS、CHNS、SEER、MIMIC、eICU、FAERS、GBD 的入口 | 按來源要求完成註冊、培訓或導出流程 |
| 找公開報告文件 | Drug Regulatory、CTD 和 Cellosaurus 列出官方文件位置 | 查看當前來源頁面、發佈版本和條款;發現文件不會自動下載或導入 |
| 整理基因標識 | Genes & Ontologies 補充 HGNC 服務字段、字段查詢及文件列表;bioDBnet 提供轉換和同源映射 | 先查詢支持的字段或類型;保留歧義、未映射和一對多結果 |
| 排序候選調控因子 | ChEA3 返回各來源庫的轉錄因子排名及 GMT 庫鏈接 | 將排名用於提出假設;下載的 GMT 庫可能不同於在線結果使用的庫 |
| 檢查細胞系證據 | Cellosaurus 補充 RDF、有邊界的 SPARQL 查詢和 STR 相似度 | 保留 accession 和標記設置;僅憑相似度不能認證樣本身份 |
文件列表返回官方 URL 與來源元數據,不會自動下載文件或建立分析數據庫。NHANES 分析仍需正確的調查設計和權重;MIMIC/eICU 演示數據權限不等於完整數據集權限;FAERS 報告不能直接解釋爲發生率。具體字段和示例見操作參考。