科学データベース
このページでは、データソースを選択し、それが返すことができるものを理解し、Open-Scienceで利用可能なツールを作るために使用します。 スクリーンショットと出力ファイルを含むステップバイステップのリサーチ例については、研究ワークフローを参照してください。
サポートされているデータベース
Open-Science v1.0.5 は 48 個の組み込み Connector と 418 操作を提供します。内訳は、47 個のデータソース Connector の 416 操作と、オフラインの Molecule Connector 1 個の 2 操作です。以下の名前は Settings → Connectors の項目に対応します。1 個の Connector が複数のデータベースを扱う場合があります。掲載されたデータソースの Web サイトの全機能を利用できるとは限りません。
この数には無効なものを含む全組み込み項目が含まれます。独自に追加した MCP Connector は別途数えます。Connector 数、対象データベース数、呼び出せる操作数は異なる指標です。
| コネクタ | 出典 | 操作 | 利用する |
|---|---|---|---|
Chemistry · chemistry | PubChem, ChEBI, Rhea, BindingDB, LIPID MAPS, UniChem | 14 | パブケム、チェビ、レア、ビンディングDBによる小分子化学。 |
Literature Graph · literature | OpenAlex, arXiv, Crossref, DataCite | 13 | 論文、著者、引用、DOIの更新とデータセット/ソフトウェアレコード。 |
PubMed · pubmed | PubMed, PMC, Europe PMC, PubTator 3 | 9 | NCBI E-utilities、PMC ID Converter、Europe PMC を通じて生物医学文献を検索し、メタデータ、関連論文、引用、ID 変換、全文と著作権情報を取得します。 |
Genes & Ontologies · genes | HGNC, MyGene, UniProt, OLS, QuickGO, Reactome, g:Profiler, Enrichr | 20 | 遺伝子・タンパク質の識別子、UniProt 配列検索、GO・Reactome 注釈、g:Profiler・Enrichr の遺伝子セット濃縮解析。 |
ゲノム・ genomes | NCBI Datasets, NCBI BLAST, EMBL-EBI Job Dispatcher, Ensembl, UCSC | 22 | ゲノムのアノテーション、均質学および順序; NCBIタムン/アセンブリ/シーケンスアイデンティティ; BLAST検索とClustal Omegaの複数のシーケンスアライメント。 人口固有のLDおよびプロキシの変形。 |
バリアント・ variants | gnomAD, ClinVar, dbSNP, MaveDB | 22 | 人口の頻度、臨床記録および試金固有の機能スコア、マッピングおよび実験。 |
Clinical Trials · clinical-trials | ClinicalTrials.gov | 7 | 臨床試験の検索、プロトコル、公開済み評価項目の測定値、群別の分母、統計解析、有害事象。 |
Clinical Genomics · clinical-genomics | ClinGen, CIViC, Open Targets, ClinPGx, DGIdb | 32 | ClinGen のキュレーション、CIViC の臨床エビデンス、Open Targets Platform、ClinPGx の薬理ゲノム情報。 |
構造と相互作用 · structures | PDB, PDBe, AlphaFold, EMDB, Complex Portal, IntAct, OmniPath | 20 | 構造と分子相互作用 — PDB 構造, アルファフォールド予測, EMDB クリオ-EM エントリ, 複雑なポータルの複合体, IntAct 相互作用ネットワーク. |
ChEMBL・ chembl | ChEMBL | 7 | CEMBL REST API による生体活性化合物、薬物、標的、生体活性およびメカニズム。 |
bioRxiv · biorxiv | bioRxiv, medRxiv, ROR | 7 | BioRxiv/medRxiv のプリプリント — 日付/カテゴリ、DOI によるメタデータ、ジャーナル公開リンク、ファンダリスト、およびプラットフォームの統計による検索。 |
薬物規制・ drug-regulatory | openFDA | 11 | Drugs@FDA、ラベル、FAERSの副作用報告および薬剤のrecalls。 |
ヒト遺伝学・ human-genetics | GWAS Catalog, eQTL Catalogue, PheWeb | 15 | GWASカタログ、eQTLカタログ、PheWeb PheWASポータル(FinnGen、BioBank Japan) |
エクスプレス・ expression | GTEx, Bgee | 16 | 人間のGTExのティッシュの表現およびeQTL; Bgee のクロススペックのベースライン式。 |
タンパク質アノテーション・ protein-annotation | InterPro, Pfam, Human Protein Atlas, STRING | 14 | タンパク質ドメインアーキテクチャ、家族/クランのメンバーシップ、InterPro/Pfam、ヒューマンプロテインアトラス、STRINGによる表現アトラスと相互作用ネットワーク、ネットワークの相互作用の豊かさを含みます。 |
がんモデル・ cancer-models | cBioPortal, DepMap / CCLE | 15 | 研究、変異、コピー番号、サンプル、患者、臨床属性および分子プロファイル式。 |
RNA · rna | Rfam, RNAcentral | 11 | Rfam の非コード RNA ファミリー情報(メタデータ、アラインメント、モデル、構造)。 |
Omics アーカイブズ・ omics-archives | ArrayExpress, GEO, ENA, MetaboLights, Metabolomics Workbench, MGnify, PRIDE | 28 | Omics はメタデータとファイルインベントリを学習/実行します。 メタボロミクスのサンプル、要因、分析および化合物レコード。 |
CellGuide · cellguide | CELLxGENE | 5 | セルックスジーン・セルギドによる細胞型アイデンティティ、マーカー遺伝子、ソースデータセット、組織。 |
Regulation · regulation | ENCODE, JASPAR, UniBind | 16 | 遺伝子調整機能ゲノム — ENCODE実験/biosamples/files、JASPAR TF結合プロファイル、UniBind ChIP-seq TFBS。 |
Research Resources · research-resources | Grants.gov, Antibody Registry | 5 | 資金調達機会検索(Grants.gov)と抗体カタログ検索(抗体レジストリ)。 |
BioMart · biomart | Ensembl BioMart | 8 | BioMart 属性のクエリと識別子の翻訳を統合します。 |
ZINC · zinc | ZINC | 5 | ZINC22 浄化可能な化学空間(CartBlanche22) — ZINC id、SMILES の完全/類似検索、サプライヤーコードの解像度、ランダムサンプリング、ドックのための 3D 構造の場所による化合物のルックアップ。 |
GDC · gdc | Genomic Data Commons (GDC) | 5 | がんプロジェクト、例、ファイルメタデータ、オープン/コントロールラベル、およびマニフェストを転送する。 ダウンロードやアクセスの付与はありません。 |
Zenodo · zenodo | Zenodo | 2 | 公開データセット、ソフトウェアおよび出版物の発見、バージョン固有のメタデータおよびファイル在庫; アップロードやダウンロードはありません。 |
ムマー・ hmmer | HMMER3, EMBL-EBI | 3 | プログラム固有のタンパク質/プロファイル/アライメント検索、ジョブの状態と結果。 |
インタープロスキャン・ interproscan | InterProScan, EMBL-EBI | 3 | タンパク質シーケンスを提出し、アノテーションジョブの状態を確認し、TSVレポートを取得します。 |
Pathway Commons · pathway-commons | Pathway Commons, Reactome | 4 | パスウェイ検索、トップパスウェイ、グラフクエリ、BioPAXサブモデルエクスポート。 |
Alliance Genome Resources · alliance | Alliance of Genome Resources | 8 | 人間とモデル組織遺伝子、オルトログ、病気モデル、フェノタイプ、アレルと表現。 |
CELLxGENE Discover · cellxgene-discover | CELLxGENE Discover | 9 | 単一セルコレクションとデータセット、公開バージョン、ファイル形式、サイズ、ダウンロードURL。 |
Cellosaurus · cellosaurus | Cellosaurus | 6 | セル・ラインの名前と同義語を見つけ、アクセスアイデンティティと品質アノテーションを検査します。 |
Monarch Initiative · monarch | Monarch Initiative | 2 | 生物と遺伝子対フェノタイプと遺伝子の関連と、証拠を支持する。 |
IEDB · iedb | IEDB | 8 | エピトープ、抗原、Tセル、B細胞、MHCアッセイ、TCR/BCRの証拠、およびソース出版物。 |
PDC · pdc | PDC | 5 | がんプロテオミクス研究のバージョン、検体の対応関係、公開症例メタデータ、ファイル一覧。ファイルのダウンロードは行いません。 |
ENCORI · encori | ENCORI | 10 | miRNA/RBPターゲット、RNAインタラクション、ceRNA、モチーフ、バインディングサイト、参照テーブル、バルクファイル。 |
Orphadata · orphadata | Orphadata, Orphanet | 2 | 希少疾患と遺伝子の関連、HPO 表現型の頻度。既定では無効です。 |
TCIA · tcia | TCIA, NBIA | 3 | 公開画像コレクション、アクセス条件、シリーズのメタデータ。 |
KEGG · kegg | KEGG | 3 | 経路・化合物の項目と遺伝子の対応。ライセンス条件に従う。 |
RxNorm / RxNav · rxnorm | RxNorm, RxNav | 2 | 薬剤名の照合と有効な概念の属性。 |
DailyMed · dailymed | DailyMed | 2 | 医薬品ラベルの識別情報と版の履歴。 |
BioSamples · biosamples | EMBL-EBI BioSamples | 2 | 公開サンプルのメタデータと相互参照。 |
WikiPathways · wikipathways | WikiPathways | 2 | 経路のメタデータ、種、改訂情報。 |
Europe PMC · europepmc | Europe PMC | 1 | 文献の直接検索、抄録、ページ送り。 |
Research Datasets · research-datasets | NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, GBD | 3 | データの利用条件と公開ファイルの検索。 |
ChEA3 · chea3 | ChEA3 | 2 | 転写因子のエンリッチメント順位と GMT リンク。 |
bioDBnet · biodbnet | bioDBnet | 6 | 識別子の変換、オルソログの対応、経路。 |
CTD · ctd | CTD | 1 | 公式公開レポートの入口と利用条件。 |
科学ビューアでオフラインのモレキュラーツールがカバーされています。 それぞれのデータソースで露出した正確な操作については、Connectorの操作の参照 を使用します。
できること
| 研究課題 | はじめに | 典型的な出力 |
|---|---|---|
| 論文を検索し、引用を追跡し、DOIの関係をチェックする | 文献グラフ、パブフィード、バイオRxiv | 文献レコード、識別子、引用リンク、フルテキストの可用性 |
| 遺伝子やタンパク質を見つけ、シーケンスを比較する | 遺伝子と腫瘍学、ゲノム | 識別子マッピング、タンパク質記録、FASTAおよびBLASTレポート |
| 公共オミクスデータを発見し、利用可能なファイルを調べる | Omics アーカイブ | ソースの場所、サイズ、利用可能なチェックサムとメタデータとファイルインベントリを学習/実行 |
| 遺伝子リストを解釈したり、インタラクションネットワークを検査したりする | 遺伝子とオノテーション、タンパク質のアノテーション | 豊富なテーブル、オントロジーの注釈とネットワークレコード |
| バリアント、式、規制証拠をチェックする | バリアント、臨床ゲノム、ヒト遺伝学、発現、規制 | 生物、組織、参照ビルドおよび関連する証拠フィールドのソースレコード |
| 化合物、構造、臨床研究記録の取得 | 化学、ChemBL、構造及び相互作用、臨床試験 | 化学識別子/プロパティ、構造レコードおよび試験メタデータ |
バッチ識別子の変換のために、ジャンルとオノトロジーはsubmit_uniprot_id_mapping、get_uniprot_id_mapping_statusおよびget_uniprot_id_mapping_resultsを追加します。 ジョブ ID を保存し、少なくとも 3 秒離れた場所をポーリングし、各結果ページを取得します。 ワンツーマンのマッピングとエクスプリシットfailed_idsを保存します。 1ページから欠落しても、一致しないわけではありません。 本サービスは、100,000 の識別子に最大を受け入れ、最大 7 日間経過した後に結果が期限切れになります。 正確なマッピングフィールド を参照してください。
ゼノドー は、認証なしで公開レコードメタデータを公開します。 バージョン固有のレコードIDとアクセス/ライセンスフィールドをファイル在庫で保持します。 GDCの特長 は公開メタデータを公開します。 マニフェストは、認可をダウンロードせず、管理されたファイルはGDC権限が必要です。 GDC の操作 · Zenodo オペレーション.
データベースの応答は、研究のステップをサポートすることができます。 自動的にデータをダウンロードし、すべての論文を文献ライブラリに追加するか、完全な分析を実行しません。 保存したいレコードやファイルを指定します。
ENCORIによるRNA規制証拠
Settings → ConnectorsでENCORIを検索し、メインエージェントに有効化して使用可能にします。 この組み込みのソースは、カスタムMCP URLまたはAPIキーを必要としません。 選択された Main モデルを使用して、生物/アセンブリ、RNA またはターゲット遺伝子、細胞タイプおよび証拠の境界を会話で指定します。
| タスク | 結果と境界 |
|---|---|
| miRNA, RNA-RNA, RBP-target, ceRNA のクエリ | 該当するCLIP、劣化、予測プログラム、p値、FDRのエビデンスが含まれています。 結束または協会は、因果規制を確立しません。 |
| RBP疾患の証拠、モチーフおよび結合サイト | アセンブリ、組織/細胞のコンテキスト、上流の順序および元の座標を予約して下さい; 種別や座標系を混合しないでください。 |
| 参照テーブルとバルクデータ | 最初に正確なテーブルパスまたはファイル名をリストします。 一括ダウンロードは別々です。リクエストの前にファイル、宛先、必要なストレージを指定します。 |
実践例 HeLaでPDCD4のMIRNA証拠をクエリする
Use ENCORI to find human miRNA interactions targeting PDCD4 in HeLa cells,
using hg38, mRNA targets, at least one CLIP experiment and TargetScan support.
Show at most two rows. Preserve the exact filters, total count and full raw
response in the session data folder. Explain the evidence limits in English.
Do not download bulk datasets.
このクエリは、19レコードを返しました。 最初の2つはhsa-miR-23a-3pとhsa-miR-181a-5pでした。 スクリーンショットは、保存された完全な生の応答と証拠の制限を示しています。 これらは、データベースの更新として、例固有の結果であり、変更することができます。
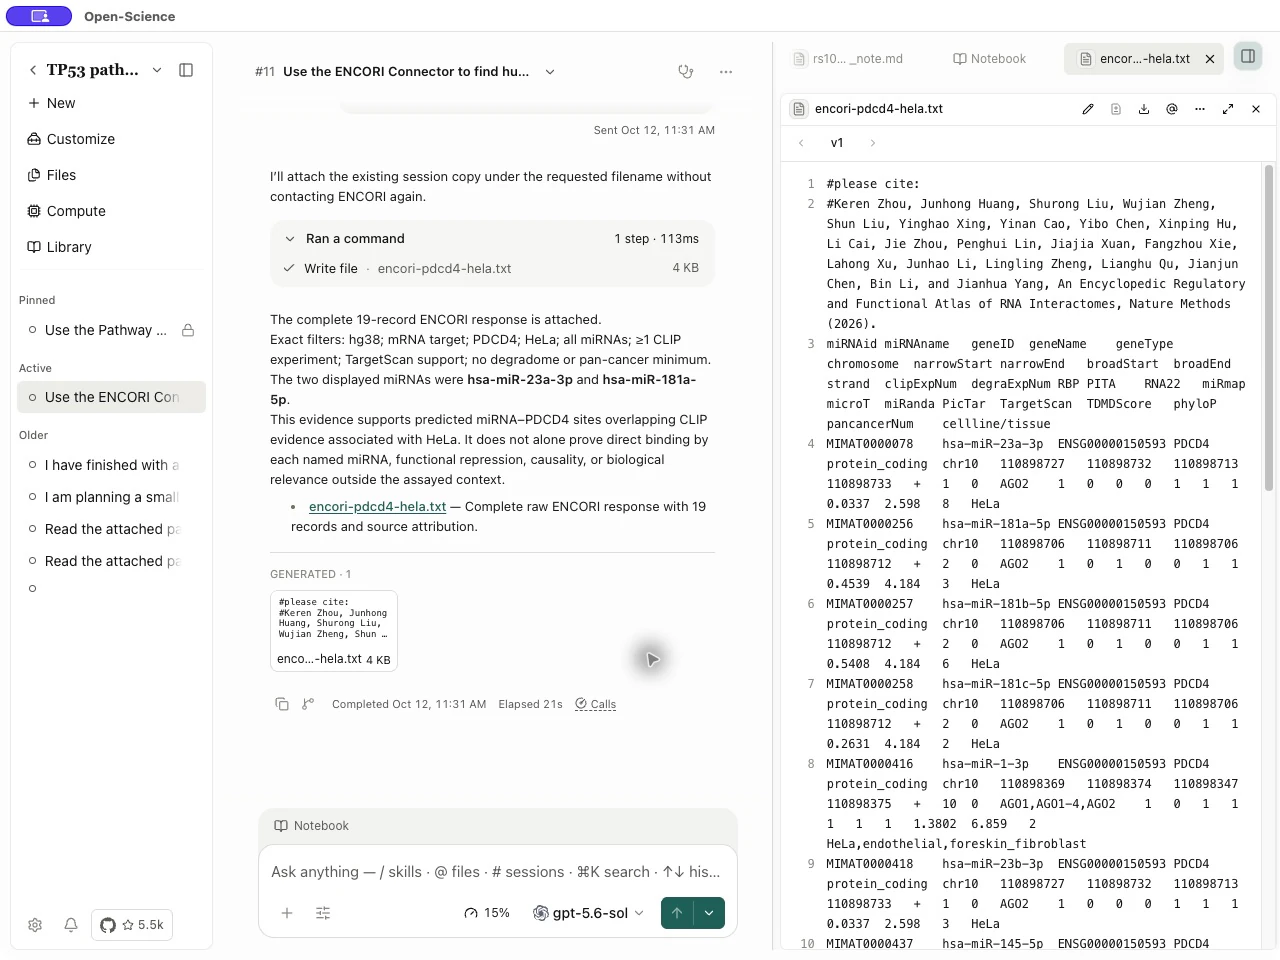
returned_recordsからtotal_recordsを区別し、is_complete、result_scopeおよびcompleteness_noteを点検して下さい。 プレビューは、完全なターゲット分布ではありません。 フルレスポンスのraw_response_pathはローカルファイルパスで、ダウンロード可能なセッションアーティファクトは自動ではありません。 共有するには、エージェントがアクセス可能なセッションデータディレクトリに保存し、ファイルを添付するかどうかを尋ねます。 添付ファイルを開き、その内容を確認します。
クエリは、本物の空の結果やok:falseを返すことができます。 フィルターをサイレントに広げてヒットしません。 一括ダウンロード後、実際のパス、サイズ、およびverified_gzipを確認してください。 参照表やデータセットのリストを読み込み、バルクファイルをダウンロードしません。 正確なパラメータについては、ENCORIの操作を参照してください。
文脈と個々の投稿を試す
| エントリーフォーム | プロシージャ | 通訳の境界 |
|---|---|---|
| チャムBL | Connectorを有効にします。 APIキーは必要ありません。 お問い合わせ assay_chembl_id 生体活性記録、検査方法、生物、細胞/チス、ターゲットから get_assay, 取得します。 get_bioactivity 同じアッセイIDの場合。 | ターゲットアサインの自信は測定品質ではありません。 IC50/Ki値を組み合わせる前に条件、ユニット、リレーション演算子を比較します。 |
| Variants → ClinVar | Connector の実際の NCBI の連絡先メールの設定 API キーは任意です。 コールセンター clinvar_get_submissions VCVアクセスまたは肯定的な変化IDを使って、そして版ピン留めに従って下さい next_page 引数。 | SCV、送信者、条件、評価日、方法および引用を保存します。 germline、ソマチックな臨床影響および腫瘍性を別に比較して下さい。 |
ChEMBLページはactivity_idで注文されます。 has_more:false までの次の offset としてフィルターを交換し、next_offset に渡して下さい; これは、1,000レコード以上を取得することができます。 summaryは現在のページのみをカバーしています。そのため、最も強力なアクティビティは必ずしも完全なクエリで最も強いものではありません。 ClinVar が最新バージョンの最初のページを解決した後、返されたバージョンの VCV を継続します。 RCV、SCV、または rsID の入力を代入しません。
ChEMBLアッセイフィールド · 生物活動のpagination · ClinVar 投稿フィールド.
単一セル、モデルオーナリズムおよび変形欠陥データ
Settings → Connectors のエントリを検索し、メインエージェント の可用性を有効にします。その後、生物、研究の質問と記録を記述して、会話を維持します。 これらの新しい操作は、カスタムMCPサーバー、APIキーまたはNCBIの連絡先メールなしで公開データを読み取ります。 同じConnectorの他のサービスに異なった条件があります。
| エントリーフォーム | できること | 結果の使い方 |
|---|---|---|
| CELLxGENE Discover | 生物、組織、病気、アッセイまたは細胞のタイプによって単一セルのデータセットを見つけて下さい; バージョンとファイルの在庫を調べる | オントロジーフィルタは、正確なラベルまたはIDを使用しており、 AND と組み合わせています。 dataset_version_idを固定出版物に保持する。 dataset_idは、現在のバージョンに解決します。 ファイルのダウンロードやCensus式をクエリせずに、利用可能なダウンロードURLを返します。 セルタイプの記述およびマーカーのための別のCellGuideを使用して下さい。 |
| Alliance Genome Resources | 人間、マウス、ラット、フライ、ワーム、ゼブラフィッシュ、イースト、カエル遺伝子、オルソログ、疾患モデル、フェノタイプ、および式を問い合わせる | 返された遺伝子IDの後に生物を検索し、確認します。 証拠と整形外科の連鎖を保持する。 人体疾患の結論ではなく、モデル・オーガニズムの現象です。 |
| バリアント → MaveDB | バリアント効果のスコアセット、アッセイメソッド、CSVスコアページ、既存のVRSマッピングを見つける | URN、ライセンス、アッセイメソッド、スコアキャリブレーションをキープします。 機能的なスコアは臨床病原性分類ではないです。 CSVは、開始/制限のペジネーションと返されたテキストをファイルに保存する必要があります。 マッピングの検索は、リフトオーバーを実行しません。 |
| Omics アーカイブ → Metabolomics Workbench | 調査研究; STアクセスによるサンプル、要因、分析、代謝検査 化合物構造とクロス環境を調べる | セクションで要約、要因、分析、または代謝を選択します。 サポートされている識別子に PubChem を介して化合物名を解決します。 これらの操作は生の測定のマトリックスをダウンロードしません。 |
CELLxGENE フィルタリングとパジネーションは、各リクエストに対して取得された上流カタログの上にローカルで実行されます。 カタログはリクエスト間で変更する場合があります。 バージョン ID を使用して、出版物を保持します。 報告されていないファイルサイズは -1 で、ゼロバイトではありません。 MaveDB と Workbench の結果の欠落した値とアッセイの定義を保存します。
CELLxGENE Discover、パートナー、MaveDB、Metabolomics Workbenchの入力を正確に参照してください。
細胞ライン、フェノタイプおよび免疫の証拠
Cellosaurus、Monarch Initiative、IEDB を Settings → Connectors で有効化し、メインエージェント に使用可能にします。 これらの操作は、カスタムサーバーまたはAPIキーなしで公開レコードを問い合わせます。
| エントリーフォーム | 要求の何 | 保存するべきこと |
|---|---|---|
| Cellosaurus | セル・ライン名/匿名名を検索し、返されたCVCLアクセスまたはRRIDを取得 | 標本、アイデンティティ、同義語および汚染/誤認の注釈。 検索は、生のSolrのクエリではなく、リテラルフレーズを取ります。 品質のアノテーションを欠くと、セルラインを認証しません。 |
| Monarch Initiative | モノドー:0007254 や HGNC:11998 | 組織、フェノタイプ、ソースおよび証拠。 アリアーゼは自動的に変換されません。 識別子を最初に解決します。 直接一致の懸念識別子マッチング、実験的な確認はありません。 |
| IEDB | エピトップスまたは抗原、または特定のT細胞、B細胞またはMHCアッセイ | 少なくとも1つの生物的/証拠フィルターが要求されます; パジネーションだけでは不十分です。 antigen_iri か uniprot_accession を両方使用して下さい。 アッセイ方法、結果、単位および出版物を保存します。 MHCの溶出観察は、親和性測定ではありません。 |
集計されたエピトープ/抗原レコードは、異なる実験から観察を組み合わせることができます。 フィルターが同じ実験で満足する必要がある場合は、対応するアッセイ操作をクエリします。 ゼロマッチは、負の生物学的発見を確立しません。 Cellosaurusパラメータ · Monarch パラメータ · IEDBパラメータ.
GEOのマトリックスとシーケンスマッチ構造を見つける
Omics Archives → geo_get_matrix_files は、公式の GEO シリーズ マトリックスと NCBI 生成カウント/FPKM/TPM/annotation ファイルを発見します。 ファイルの場所を返します。 バイトをダウンロードしません。 geo_get_series はメタデータルックアップのままです。
行列を取得すると、geo_preflight_matrix は既に読み込まれているチェックを行い、8 MiB までのテキストを解凍します。 ネットワークやファイルシステムアクセスがない場合。 GSM の識別子とプラットフォームのメタデータを保存しておくと、カラムの位置ではなく ID でサンプルをマッピングできます。 完了: 偽 をプレビューに設定します。 ファイル全体に 完了: true を渡します。 プレビューは、ファイル全体の寸法を確立できません。 圧縮されたアーカイブ、スパース行列、HDF5ファイルをテキストチェッカーに送りません。 行列の発見とテキスト preflightを参照してください。
Structures & Interactions → pdb_search_sequenceは、生のシーケンスまたは1 FASTAレコードとして、25–10,000残余の1つのタンパク質シーケンスを受け入れます。 アイデンティティとクエリー カバーのしきい値は、0 から 1 への亜辞です。 返されたクエリカバレッジは、クエリへのアライメントを記述します。 実験的な構造のカバレッジではありません。 上流の合計はろ過するローカル カバーを指示し、分岐させたスキャンは後で一致を省略できます。 操作は、座標をダウンロードせずに構造レコードを見つけます。 正確な入力とスキャンの制限 を参照してください。
データベースの接続と起動
1. 組み込みのConnectorを有効にします
- Settings → Connectors を開き、Omics アーカイブ などの上記の家族を検索します。
- 細部を開け、拡大して下さい Tools. . . . 選択した操作の入力、結果の制限、およびサードパーティの要件をお読みください。
- メインエージェント の可用性を有効にし、Used by をチェックします。 Main エージェントと Specialist の関連付けを調整するリソースで Manage access を使用します。 可用性とパーツールの承認ポリシーは、別々の制御です。
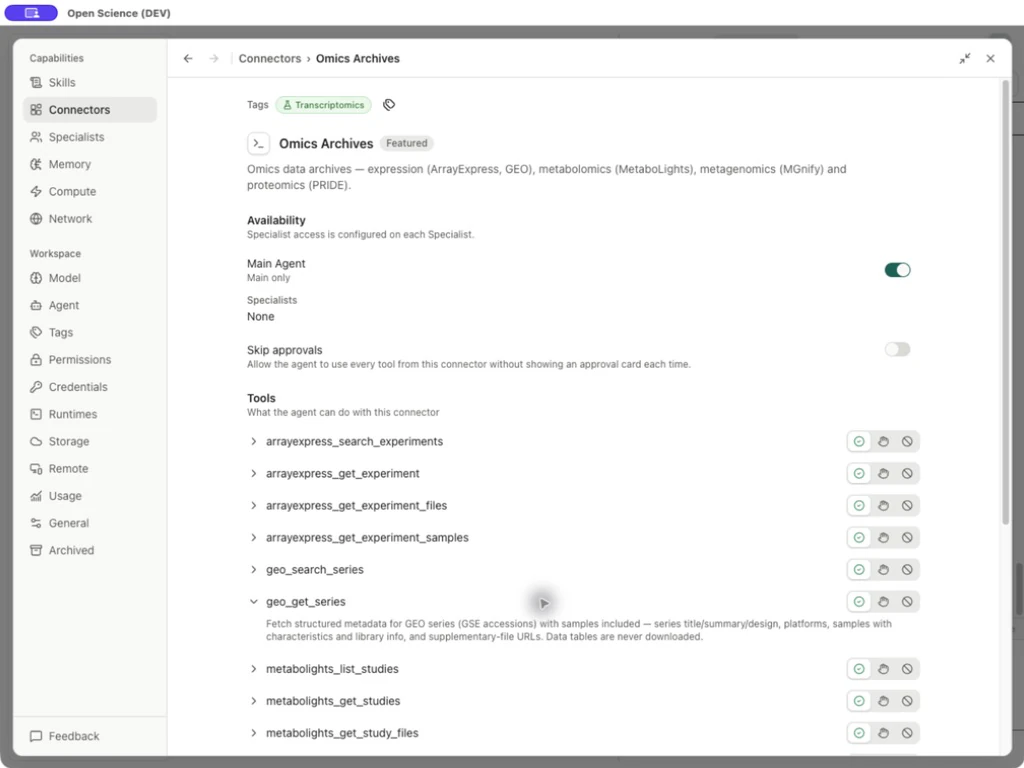
これらのコネクターはで造られます; 専用のサーバーを追加する必要はありません。 自分で操作する外部サービスについては、カスタムConnectorセットアップを参照してください。 リストされているか、または有効なConnectorは、認証やクエリが成功する証拠ではありません。
2. 操作がそれらを必要とするとき、資格情報を追加
| サービスまたは条件 | 設定する場所 |
|---|---|
| OpenAlex | 任意キー。 1 つを構成するには、開く Settings → Connectors → Literature Graph → Manage credentials → OpenAlex、それを検証し、保存します。 |
| コンタクト情報が必要なNCBIのバリアントのクエリを直接送信する | Settings → Connectors → Manage credentials → Literature accessに進んでください。 お問い合わせ Contact email 選択する Saveに進んでください。 NCBI API キーは任意です。 |
| 資格要件の別の操作 | ツールの要件と要件に従う 認証ガイドに進んでください。 意図したサービスに資格を埋めます。 |
研究プロンプトや共有出力ファイルではなく、クレデンシャルフォームにキーを入力します。 選択された操作のための条件を構成して下さい; 上記の連絡先メール要件は、すべてのNCBIツールが同じ要件を持っているという意味ではありません。
文字グラフは、crossref_get_work、crossref_get_updates、datacite_search_records、datacite_get_recordも提供しています。 これらの4つのパブリックメソッドは、OpenAlexキーを必要としません。 OpenAlex の引用の方向では、openalex_citations は、openalex_references が引用する作品を見つけます。 文献グラフパラメータ.
3. 小さなクエリでアクセスを確認する
ジャンルとオノトロジーを有効にし、接続されたモデルで会話を開き、次のようにします。
例 既知のヒト遺伝子識別子をチェックする
Use Genes & Ontologies query_genes to resolve TP53 with scopes="symbol",
species="human" and fields="symbol,name,entrezgene". Return the input query,
matched records and any unmatched identifiers. Keep the response in English.
実際のツールの結果を調べます。 ヒトTP53の場合、query、symbol、Entrez Gene 7157、腫瘍タンパク質p53の名称を確認してください。 生物や記録を確認するまで、複数のマッチを保持します。 成功したクエリは、この特定の操作を確認します。 すべてのソースへのアクセスを確立しません。 正確なフィールド.
研究ワークフローのフォロー
各記事には、入力、手順、実際の英語インターフェイススクリーンショット、ダウンロード可能な例の出力が含まれます。
公共オミクスデータを見つける
パブリックオミクスデータを見つけてファイル在庫をビルドする:既知の実行またはトピックから始めて、ENAとPRIDEのレコードを調べ、ソースの場所とチェックサムを保存します。 データのダウンロードは、別のステップのままです。
タンパク質シーケンスを比較する
タンパク質シーケンスを見つけてBLAST検索を完了:UniProt FASTAを取得、BLASTジョブIDを保持し、完了したアライメント、アイデンティティ、クエリカバレッジを検査します。
候補遺伝子セットを分析する
候補遺伝子セットのための機能強化を実行: 生物、識別子、背景を選択し、g:Profilerを実行し、修正された確率をソースバージョンと解釈します。
参照のゲノムを確かめて下さい
種、参照のゲノムおよび染色体識別子をチェックして下さい: レコードに参加する前に、タムン、バージョンアップされたアセンブリ、染色体エイリアスを解決します。
パスウェイネットワークを調べる
パスウェイとインタラクションネットワークを調べる:Pathway Commonsを介して人間のReactome経路を見つけ、返されたURIを保存し、インタラクションをエクスポートし、パスウェイアクティビティの証拠から選択したネットワークを識別します。
他のタスクについては、構造化された PubChem レコード、科学的記録の交差チェック、グループ会議の文献発見に従う。
返されたデータを正しく使用
- クエリ、ソース、生物、組織、単位およびアクセス版を保持します。 データベースのレコード、予測、および生成された要約は、さまざまな種類の証拠です。
- 応答を完全に処理する前に、返されたカウント、ペジネーション、およびトランジションフラグを確認してください。 ゼロマッチ、部分的な応答とリクエストエラーは、異なるフォローアップアクションを必要とします。
- ファイルのインベントリは、場所とメタデータを提供します。 バイトをダウンロードし、チェックサムを確認し、データを分析することは、別の操作です。
- 要求の資格情報が必要な場合は、再試行の前に関連するフォームを完了してください。 レート制限については、サービスの遅延に従う。 タイムアウトのため、要求のサイズを減らして下さい。 パッケージのミラーおよび証明書の信頼の構成 を参照してください。
人口の頻度とインタラクションネットワーク
get_variant では、人口の詳細は必要なときにのみ include_populations: true を設定します。 データセットとリファレンスビルドを保持します。 ゲノム観測とゲノム観測は別々に残っています。 未利用可能な値は、null、ゼロではありません。 集団や性的な strata を重ねるには、要約しないでください。 これらは、alleleの周波数をフィルタリングしていない周波数を観察されます。 gnomAD パラメータ
v0.31.0から、get_string_network.nodesには、返された隣人や分離した地図入力が含まれます。 シングルマップされた入力要求の隣人; 複数のマッピングされた入力は展開されません。 入力ノードを回復するためにis_queryをフィルタリングし、すべてのマップされたエイリアスにqueriesを使用します。 n_nodes はグラフをカウントします。 n_mapped は入力マッピングをカウントします。 再利用する前に2つを装備したスクリプトを更新します。 ストリングパラメータ
操作パラメータの検索
Connectorの操作の参照 は、入力、許可された値、および正確な呼び出しを要求するリストです。 このページを使用してソースを選択し、それを接続します。 特定のツールのフィールドの参照を使用してください。
カタログの出典: catalog.ts, registry.ts.
シーケンス検索とアライメント
ムマーはプログラム固有のタンパク質シーケンス、プロファイルHMMおよびアライメント検索を提供します。 プログラムとデータベースを一緒に選択し、ジョブIDを保持し、ソリューションの後にのみ結果を取得します。 HMMER オペレーション.
インタープロスキャンは、v0.35.1からタンパク質シーケンス送信、ジョブステータス、TSVアノテーション検索をサポートしています。 InterProScan 投稿 に従ってセットアップと手順を実行します。
Genomes → Clustal Omega は、タンパク質、DNA、RNA FASTA のレコードを3つ以上一意に名付けます。 サービスで要求される連絡先メールを構成し、一度送信し、ジョブIDを保持し、ステータスを確認し、返されたアライメントを保存します。 複数のシーケンス・アライメント・ワークフロー.
Enrichr、STRING、ClinPGx
- Genes & Ontologies → Enrichr: 現在のライブラリを一覧表示し、関数、転写因子、パーチャブレーション、薬物、病気、組織、または細胞タイプのための遺伝子組換えの強化をクエリします。 生物や質問に適切なライブラリを選択し、名前、背景、および調整されたP値を保持します。
- Protein Annotation → STRING: タンパク質ネットワークが、その背景から期待されるよりも相互作用が多かったかどうかをテストします。 これは、パスウェイの過剰表現から異なる質問を要求します。 パスウェイテストではなく、ネットワークP値がパスウェイテストではありません。 遺伝子組込み強化ワークフロー をフォローしてください。
- Clinical Genomics → ClinPGx: 薬物、遺伝子、または異種注釈、ガイドライン、規制ラベル、および人口の頻度を取得します。 識別子を最初に解決し、操作で必要なフィールドを供給し、元のソースと証拠レベルを保持します。 これにより、研究記録が取得されます。 個別治療プランを自動的に生成しません。
Settings → Connectorsの活性剤に関連したConnectorを有効にします。 これらの組み込みエントリは、カスタムMCPサーバを必要としません。 正確なフィールドと条件の要件については、操作の参照 を参照してください。
パスウェイ、式、臨床データ
Settings → Connectors で対応する家族を有効にし、エージェントに生物、ソース、識別子、および意図したスコープを指示します。 これらの付加は作り付けのコネクターを使用します; MCP サーバは必須ではありません。
| エントリーフォーム | できること | 接続と解釈 |
|---|---|---|
| Pathway Commons | パスウェイを検索し、トップのパスウェイをリストし、遺伝子間のクエリパスやサブモデルをエクスポートします | 公共サービス; 返された URI、生物およびソースを保持します。 グラフのクエリは、濃縮テストとは異なる。 フォロー パスウェイインタラクションワークフロー. |
| 式典 → Bgee | クロススペクシーの提示/従順な呼び出し、正規化スコア、バインドSPARQLのクエリとダウンロードリンク | 種を最初に発見し、NCBIの分類IDを保持します。 SPARQLは遺伝子、種、組織を必要とします。 健康なワイルドタイプのベースライン呼び出しは、差異的な表現ではありません。 ダウンロードリンクはダウンロードされていないファイルです。 |
| がんモデル → cBioPortal | リストサンプル/患者とクエリ臨床属性またはmRNA/タンパク質表現 | 研究を選択し、そのプロファイルを発見し、測定/正規化を選択します。 臨床サンプル/患者レベルに合ったIDを供給します。 分子データは、明示的な遺伝子とsample_idsまたはsample_list_idの1つを必要とします。 行を欠くことはゼロではありません。 |
| 薬規制 → openFDA | 検索/アカウント FAERS レポートと検索薬のリコール | 傷の日付およびプロダクトおよび保存のtruncation情報。 レポートのカウントは、発生または原因の証拠ではありません。 複数の評価されたバケツは重複するかもしれません; 独自のレポートの合計ではなく、その合計はユニークです。 |
| Omics アーカイブ → MGnify | MGYA解析アクセスによる結果ファイルを一覧表示 | 報告されたときタイプ、カテゴリ、上流 URL およびサイズを返します。 ファイルバイトはダウンロードされません。 行方不明のサイズや URL が null にとどまります。 |
必要なフィールド、条件、例については、Connectorの操作の参照 を参照してください。
通訳 Bgee 種 利用可能
bgee_speciesで種を識別します。 そのtaxon_idは、その参照ゲノムを供給する種ではなく、生物のNCBIの分類IDです。 リスト応答では、has_expression_data: null は可用性が決定されていないことを意味します。 返された taxon_id を species_id として使用して、その種のデータソースメタデータをロードします。 メタデータが不在であるとき、null を未知の状態に保って下さい; 明示的なfalseのみが負の可用性の結果です。 これらのフィールドは、特定の遺伝子が組織で表現されているかどうかではなく、アトラスカバレッジを記述します。
GWASサマリー統計ファイルを探す
Settings → ConnectorsでMainでヒト遺伝学を有効にします。 研究のGCSTアクセスで概要統計の発見を依頼し、返された元の/調和したファイルURL、メタデータ、および参照のゲノムを保持します。 パブリックルックアップはAPIキーを必要としません。
gwas_get_summary_statistics は、学習ファイルをリストし、利用可能な YAML メタデータを読み込みます。 大規模な関連付け表をダウンロードしません。 そのGWAS-SSFカラム定義は、検査されたファイルヘッダではなく、標準を記述します。 意図したファイルを個別にダウンロードし、実際の列、ゲノムビルド、効果アレルと単位を分析する前に確認します。 著名な協会のヒットは、完全な要約統計のための代替ではありません。 変数および出力.
InterProScanにタンパク質シーケンスを提出する
- Settings → ConnectorsでMainでインタープロスキャンを有効にします。 Settings → Credentials → Literature accessでは、EMBL-EBIジョブに使用される有効な連絡先メールを保存します。 APIキーは必須ではありません。
- タンパク質のシーケンスまたは一意に名前を付けたタンパク質FASTAレコードとリクエストの投稿を一度供給します。 EMBL-EBI へメールが送られてきます。 1,000 レコード、10,000 レジス/シーケンスと 4 MiB のエンコードされたリクエストボディまでのリクエストを受け付けます。
- 返されたjob_idを保持します。 ready: falseとSUBMITTEDは、アノテーションの結果ではなく、レシートです。 ステータス を 10 秒以上離れた状態にチェックします。 ポーリングは自動ではありません。
- FINISHED の後、結果発表 を要求し、リモート結果が切れる前に完全な TSV を保存します。 2 MiB の検索制限に対する応答は、未読の報告を返すのではなく、失敗します。
- タンパク質識別子、ソースアプリケーション、1ベースの包括的な座標をチェックします。 異なるメンバーアプリケーションからのスコアは変更できません。 タンパク質が機能に欠けていることを証明しません。
タイムアウト後の重複投稿を避ける: 既知のジョブ ID を最初に復元します。 ローカルリクエストのキャンセルは、送信されたリモートジョブをキャンセルしません。 投稿、ステータス、結果のパラメータ を参照してください。
TCR と BCR の証拠を IEDB で見つける
MainでIEDBを有効にし、少なくとも1つの生物学的または証拠フィルタでsearch_tcrsまたはsearch_bcrsを要求します。 パジネーションだけでは不十分です。 エピトープ のシーケンスに sequence を使用します。 chain1_cdr3およびchain2_cdr3フィルター受容器CDR3の順序。 これらの公開検索では、API キーは必要ありません。
受容体グループ ID、チェーン、報告されたアッセイ ID およびソース出版物を保って下さい。 ホストと結果フィルタは、集約されたグループに適用され、異なる実験で満足することができます。 同じアッセイでその条件が起こることを確立するために、報告されたアッセイIDを対応するアッセイ操作に従い、そこに必要なフィルタを適用します。 パジネーションは、すべての埋め込まれた輸出の完全性ではなく、受容体グループをカバーします。 これらのレコードは、受容体結合の予測ではなく、証拠検索です。 IEDBパラメータ.
PDCでがんプロテオミクスを発見
Settings → ConnectorsでPDCを有効にします。 パブリックメタデータ API は API キーを必要としません。 研究やバージョンを見つけるために、アッセイと標本のカウント、マップケース - サンプル - アリコ協会、およびタンパク質アセンブリレポートなどの定量ファイルのリストを参照してください。 処理/アウトカムデータやファイルのダウンロードは返しません。
PDC000127などの学習アクセスから、学習識別子やバージョン名を検索できます。 PDC キーワードマッチングは、臨床疾患フィルタではありません。 調査を受け取り、返された study_id UUID を使用して、その後の呼び出しをピン留めします。 pdc_study_idは最新バージョンを選択します。 これらのセレクターの1つを正確に提供します。
標本のリストのために、アップストリームのpaginationは場合を数えます; サンプルとアリコを拡張することで、ケースの限界よりも多くの行を生成できます。 デフォルトのローカルモードページは協会を受け、1,000-associationのアップストリームキャップを持っています。 そのキャップが到達したときに最終ローカルページは完全性を証明しません。 PDC ID を保ち、外部の GDC 参照を別々に示します。 ファイルリストには、名前、バイトサイズ、MD5値、ストレージパスが含まれます。 リストされたパスは、認証されたダウンロードURLではありません。
PDCの操作とペジネーション を参照してください。 ソースを組み合わせる前に、学習バージョン、試金、標本のアイデンティティ、各ソースのアクセスと引用の要件を確認してください。
人口固有のLDをチェックする
Settings → Connectorsでゲノムを有効にします。 そのEnsembl LDツールは、キーなしで公開APIを使用します。 2つの variant ID をのための供給して下さい ensembl_ld_pairwise、またはのための1つ ensembl_ld_proxies、のような完全な人口の名前と共に、 1000GENOMES:phase_3:KHV. . . . ツールは、人口や推論を発見しません。 研究に適した参照人口を選択します。
平等な結果報告 r2 と D ′. プロキシのクエリは r2 ≥ 0.8 と 500 kb合計ウィンドウ にデフォルトで、両側で約 250 kb です。 max_recordsは、上流作業ではなく、ソート後に返されたリストをキャップします。 その結果、人口と反省のメタデータを保存します。 このエンドポイントは、参照アセンブリやEnsemblリリースを報告しません。 空の結果は、LD をゼロにしない、返されたデータの修飾を意味しません。 高いLDは、因果性および機能的な等価性を確立しません。 ペアウェイトフィールドとプロキシフィールドを参照してください。
サンプル、式およびアセンブリコンテキストを予約する
| クエリ | v1.0.2 での解釈 |
|---|---|
arrayexpress_get_experiment_samples | samples パスでソートされた最初のSDRFファイルからリレーション行が含まれています。 n_rows_total / n_rows_returned カウント行; n_samples / n_samples_returned 異なる識別子を数える, 好み サンプル名, それから ソース名に進んでください。 彼らは独立した生物学的複製数ではありません。 識別子を欠くと、サンプルカウントが生成できます。 nullに進んでください。 空のファイルまたは no_sdrf 実験にサンプルがないという反応は確立しません。 |
metabolights_get_studies とりあえず include_samples | 返された使用 headers 輸出するときの順序 sample_tableに進んでください。 繰り返しカラム名は一意 #2, #3,... 元の名前を上書きせずに接尾辞. すべての列を保持します。 短い行の空の文字列はメタデータが欠落しています。 チェックイン rows_truncated. |
bgee_expression_calls | 保存する anatomical_entity_id/name 一緒に一緒に cell_type_id/nameに進んでください。 欠落したセルタイプは nullネガティブな表現呼び出しではありません。 式の状態、質、条件を一緒に保って下さい。 |
| dbSNP 多様体検索 | 各配置の保持 assembly, assembly_full, seq_id, 位置とアレル. 1つのシーケンスは複数のアセンブリと関連付けることができます; これらの団体を倒したり、最初の配置を自動リフターとして使用したりしないでください。 |
これらの修正は、返された証拠が読み込まれる方法を変更します。 古い保存された応答を新しいルックアップと比較する前に、操作の参照を確認してください。
OpenAlex 認証プロンプト
v1.0.2 は、現在のセッションで拒否した OpenAlex 認証情報の要求を記憶し、同じ要求を繰り返しません。後から利用する場合は、次の設定画面で明示的に設定してください: Settings → Connectors → Literature Graph → Manage credentials → OpenAlex 設定後、目的のクエリを再実行します。要求を拒否してもキーは設定されず、アクセスや利用枠も保証されません。
新しいデータソースを接続し、結果を正しく扱う
設定画面 Settings → Connectorsで以下の項目を探し、利用を許可します。対象は Main または利用する Specialist です。HGNC、PubTator 3、DGIdb、RNAcentral は既存項目に含まれるツールです。 Orphadata は独立した項目で、既定では無効です。これらの新規ツールは公開エンドポイントを利用し、専用 API キーを必要としません。同じ項目の他のツールは別の認証要件を持つ場合があります。
| データソース | 設定項目 | 要求内容と確認点 |
|---|---|---|
| HGNC | Genes & Ontologies | 承認済みのヒト遺伝子記号を検索するか、別名を完全一致で解決します。候補が複数ある場合は全件を保持し、承認済み・撤回済みの状態を確認してから遺伝子を選びます。 |
| PubTator 3 | PubMed | PMID から注釈を取得するか、エンティティや関係を検索します。取得対象はタイトルと抄録の注釈です。手元の生テキストを送信する機能ではなく、主張が全文で裏付けられたことも示しません。 |
| DGIdb | Clinical Genomics | 遺伝子名または薬剤名で検索し、出典と文献情報を保持して返されたカーソルをたどります。薬剤と遺伝子の相互作用は、治療の推奨ではありません。 |
| RNAcentral | RNA | URS アクセッションを検索し、専門データベースとの相互参照をページごとに取得します。分類群、配列の MD5、アクセッションのバージョンを保持してください。 |
| Orphadata | Orphadata | まず利用を有効にし、ORPHAcode を指定して遺伝子または HPO 表現型を取得します。関連の種類と頻度区分を保持してください。頻度区分は個々の患者の確率ではありません。 |
呼び出しの詳細: HGNC, PubTator, DGIdb, RNAcentral, Orphadata.
がんメタデータの関連付けとバリアント注釈
- PDC: 公開されている人口統計・診断フィールドを次の操作で取得します:
pdc_list_clinical。最新バージョンにはpdc_study_id、固定バージョンにはstudy_idを使います。欠損・秘匿値と外部参照の所属先を保持してください。PDC と GDC の UUID は互換ではありません。 - GDC: ファイルの絞り込みには
case_ids,sample_typesおよびworkflow_typesを使います。症例単位で全ファイルを混ぜず、各ファイルの検体、分注試料、腫瘍・正常組織のワークフローとの対応を保持してください。同じフィールド内は OR、異なるフィールド間は AND です。メタデータへのアクセスは、制限付きファイルのダウンロード権限を与えません。 - Ensembl VEP: 単独で指定する引数は
hgvs_notationです。併用できない引数はvariant_id,region,alleleまたはallele_orientationです。返されたアセンブリ、転写産物のバージョン、件数の切り詰めフラグを保持してください。入力の参照バージョンはそのまま送信され、検証されません。matchedもバージョンの一致を証明しません。これは影響の注釈であり、臨床的解釈やゲノム座標変換ではありません。 - Clinical Trials: 操作
get_trial_resultsで公開済みの測定値、分母、統計解析、有害事象を取得します。群 ID は同じ結果モジュール・評価項目の中でのみ対応付けます。欠損はゼロ件や治療効果がないことを意味しません。
参照: PDC のフィールド, GDC のフィルター, VEP のモード および 公開済み試験結果.
画像・経路・脂質・がんモデルのデータ
Settings → Connectors で対象を有効にし、Main で利用可能にします。TCIA、KEGG、RxNorm / RxNav、DailyMed、BioSamples、WikiPathways は独立した項目で、既定では無効です。以下の公開サービスには独自 MCP サーバーや API key は不要ですが、有効化してもライセンスや制限付きデータへの権限は付与されません。
| 項目 | 要求できる内容 | 保持すべき情報 |
|---|---|---|
| TCIA | コレクションと既存 DICOM series UID のメタデータ | ライセンス、アクセス・ダウンロード条件。リンクは画像ではなく Data Retriever のマニフェストの場合があります。 |
| KEGG | 経路・KO・化合物・反応の検索、種を指定した遺伝子の対応付け | 学術利用資格、ライセンス、一対多対応、打切り情報。遺伝子セット濃縮解析ではありません。 |
| Chemistry → LIPID MAPS / UniChem | LMID・PubChem CID の完全一致検索、InChIKey・ChEMBL ID の対応付け | 名称は先に PubChem で解決し、異なる一致結果と出典を保持します。類似性検索ではありません。 |
| Structures & Interactions → OmniPath | ヒトの標準 UniProt accession に対する上流・下流調節 | 方向、活性化・阻害の矛盾、複合体 ID。集約関係は組織特異的な因果証拠ではありません。 |
| Structures & Interactions → PDBe / PDB | 実験構造の検証統計、登録済みタンパク質鎖の類似検索 | 実験法と欠測値。著者の鎖 ID ではなく label_asym_id を使います。構造アラインメントや RMSD 計算ではありません。 |
| Cancer Models → DepMap / CCLE | 細胞株を ModelID に解決して遺伝子・化合物プロファイルを取得 | データ版と尺度。Chronos は確率ではなく、PRISM AUC は IC50 ではありません。RNA は log2(TPM+1)、コピー数は倍数性に対する相対値です。 |
| RxNorm / RxNav · DailyMed | 薬剤名を RxCUI に照合、SPL ラベルの識別情報と版の履歴 | 曖昧な一致を保持します。名称一致は臨床的同等性を、DailyMed 掲載は FDA 承認を保証しません。 |
| BioSamples · WikiPathways | サンプルまたは経路のメタデータと改訂情報 | accession、種、日付、証拠リンク。リンク先ファイルや経路グラフは取得しません。 |
入力とページ分割は操作リファレンスを参照してください。空値と打切り情報を保持し、上限付き結果をデータベース全体とみなさないでください。
公式データとファイル一覧を探す
Settings → Connectors で必要な入口だけ有効にします。Europe PMC、Research Datasets、ChEA3、bioDBnet、CTD は API キー必須ではありません。検索語、識別子、遺伝子リストは各サービスへ送信されます。接続設定。
| 目的 | 入口と結果 | 次の操作 |
|---|---|---|
| 生物医学文献を直接検索 | Europe PMC の記録、利用可能な抄録、次ページカーソル | 識別子を保存してページを進める。全文リンクは取得済み全文ではない |
| 調査・臨床デモファイルを探す | Research Datasets の NHANES 周期・説明と、固定版 MIMIC/eICU デモ | 公式ダウンロード前に周期、版、ライセンス、説明を確認 |
| 利用条件を調べる | Research Datasets が NHANES、CHARLS、CHNS、SEER、MIMIC、eICU、FAERS、GBD の入口を案内 | 必要な登録、研修、エクスポートを提供元で行う |
| 公開レポートを探す | Drug Regulatory、CTD、Cellosaurus の公式ファイル位置 | 最新ページ、版、利用条件を確認。自動ダウンロードや取込ではない |
| 遺伝子識別子を整理 | Genes & Ontologies の HGNC フィールド・ファイル、bioDBnet の変換・オルソログ | 対応型を先に確認し、曖昧・未対応・一対多の結果を残す |
| 調節因子候補を順位付け | ChEA3 のライブラリ別順位と GMT リンク | 仮説として扱う。ダウンロード用 GMT とオンライン結果のライブラリは異なる場合がある |
| 細胞株の証拠を確認 | Cellosaurus の RDF、制限付き SPARQL、STR 類似性 | accession とマーカー設定を保持。類似度だけでは試料同一性を認証できない |
一覧は公式 URL とメタデータを返し、ファイルや分析 DB を自動取得しません。NHANES には正しい調査設計と重みが必要です。MIMIC/eICU デモの利用権は全データへの権限ではなく、FAERS 報告は発生率ではありません。詳細は操作リファレンスを参照してください。