Bases de datos científicos
Utilice esta página para elegir una fuente de datos, entender lo que puede devolver, y hacer sus herramientas disponibles en Open-Science. Para ejemplos de investigación paso a paso con capturas de pantalla y archivos de salida, vea Flujos de investigación.
Bases de datos respaldadas
Open-Science v1.0.5 incluye 48 Connectors integrados con 418 operaciones: 47 Connectors de fuentes de datos ofrecen 416 operaciones, y un Connector Molecule sin conexión ofrece dos. Los nombres siguientes corresponden a las entradas de Settings → Connectors. Un Connector puede abarcar varias bases de datos. Incluir una fuente no significa que estén disponibles todas las funciones de su sitio web.
El total incluye todas las entradas integradas, incluso las desactivadas. Los Connectors MCP añadidos por el usuario se cuentan por separado. El número de Connectors, de bases de datos cubiertas y de operaciones disponibles son medidas distintas.
| Conector | Fuentes | Operaciones | Úsalo para |
|---|---|---|---|
Chemistry · chemistry | PubChem, ChEBI, Rhea, BindingDB, LIPID MAPS, UniChem | 14 | Química de moléculas pequeñas a través de PubChem, ChEBI, Rhea y BindingDB. |
Literature Graph · literature | OpenAlex, arXiv, Crossref, DataCite | 13 | Documentos, autores, citas, actualizaciones de DOI y registros de dataset/software. |
PubMed · pubmed | PubMed, PMC, Europe PMC, PubTator 3 | 9 | Bibliografía biomédica a través de NCBI E-utilities, el PMC ID Converter y Europa PMC — búsqueda, metadatos, artículos relacionados, búsqueda de citas, conversión de ID, texto completo y copyright. |
Genes & Ontologies · genes | HGNC, MyGene, UniProt, OLS, QuickGO, Reactome, g:Profiler, Enrichr | 20 | Identificadores genéticos/proteínas, descubrimiento de secuencia UniProt, Anotaciones GO y Reactome, y g:Enriquecimiento de genes de Profiler y Enrichr. |
Genomes · genomes | NCBI Datasets, NCBI BLAST, EMBL-EBI Job Dispatcher, Ensembl, UCSC | 22 | Anotación genoma, homología y secuencia; NCBI taxon/assembly/sequence identity; BLAST búsqueda y alineación de secuencia múltiple de Clustal Omega; LD específico de la población y variantes proxy. |
Variantes · variants | gnomAD, ClinVar, dbSNP, MaveDB | 22 | Frecuencias demográficas, registros clínicos y puntajes funcionales específicos para ensayos, cartografías y experimentos. |
Clinical Trials · clinical-trials | ClinicalTrials.gov | 7 | Búsqueda de pruebas, protocolos y mediciones de resultados publicadas, denominadores de grupos, estadísticas y eventos adversos. |
Clinical Genomics · clinical-genomics | ClinGen, CIViC, Open Targets, ClinPGx, DGIdb | 32 | Bases de conocimiento de la genómica clínica: curaciones ClinGen, evidencia clínica CIViC y Plataforma de objetivos abiertos, además de registros farmaceuticos ClinPGx. |
Estructuras & Interacciones · structures | PDB, PDBe, AlphaFold, EMDB, Complex Portal, IntAct, OmniPath | 20 | Estructuras e interacciones moleculares — estructuras PDB, predicciones AlphaFold, entradas EMDB cryo-EM, complejos complejos Portales Complejos, redes de interacción IntAct. |
ChEMBL · chembl | ChEMBL | 7 | Compuestos bioactivos, fármacos, objetivos, bioactividad y mecanismos a través del ChEMBL REST API. |
bioRxiv · biorxiv | bioRxiv, medRxiv, ROR | 7 | preimpresión bioRxiv/medRxiv — búsqueda por fecha/categoría, metadatos por DOI, enlaces de publicación de revistas, listados de fondos y estadísticas de plataforma. |
Regulación de drogas · drug-regulatory | openFDA | 11 | Drug@FDA, etiquetas, informes de eventos adversos de FAERS y memorias de drogas. |
Genética humana · human-genetics | GWAS Catalog, eQTL Catalogue, PheWeb | 15 | Pruebas de asociación genética humana — GWAS Catalog, eQTL Catalogue, y portales PheWeb PheWAS (FinnGen, BioBank Japan). |
Expresión · expression | GTEx, Bgee | 16 | Expresión de tejido GTEx humano y eQTLs; Bgee expresión de referencia de especies cruzadas. |
Anotación de proteínas · protein-annotation | InterPro, Pfam, Human Protein Atlas, STRING | 14 | Arquitectura de dominio Protein, membresía familiar/clan, atlas de expresión y redes de interacción a través de InterPro/Pfam, el Atlas de Proteína Humana y STRING, incluyendo enriquecimiento de interacción de red. |
Modelos de cáncer · cancer-models | cBioPortal, DepMap / CCLE | 15 | Estudios, mutaciones, número de copia, muestras, pacientes, atributos clínicos y expresión de perfil molecular. |
RNA · rna | Rfam, RNAcentral | 11 | Datos familiares de ARN no codificación (metadatos, alineamientos, modelos, estructuras) a través de Rfam. |
Archivos de Omics · omics-archives | ArrayExpress, GEO, ENA, MetaboLights, Metabolomics Workbench, MGnify, PRIDE | 28 | Omics study/run metadata and file inventories; muestras metabolomicas, factores, análisis y registros compuestos. |
CellGuide · cellguide | CELLxGENE | 5 | Identidad de tipo celular, genes marcadores, conjuntos de datos fuente y tejidos a través de CELLxGENE CellGuide. |
Regulation · regulation | ENCODE, JASPAR, UniBind | 16 | Genética-regulación de la genómica funcional — experimentos ENCODE/biosamples/files, perfiles de unión JASPAR TF y TFBS UniBind ChIP-seq. |
Research Resources · research-resources | Grants.gov, Antibody Registry | 5 | Búsqueda de financiación-oportunidad (Grants.gov) y búsquedas de catálogo de anticuerpos (Registro Anticuerpo). |
BioMart · biomart | Ensembl BioMart | 8 | Ensembl BioMart atributo consultas y traducción de identificador. |
ZINC · zinc | ZINC | 5 | ZINC22 espacio químico depurable (CartBlanche22) — búsqueda compuesta por ZINC id, búsqueda exacta/similaridad de SMILES, resolución de código de proveedor, muestreo aleatorio, ubicaciones de estructura 3D para acoplamiento. |
GDC · gdc | Genomic Data Commons (GDC) | 5 | Proyectos de cáncer, casos, metadatos de archivos, etiquetas abiertas/controladas y manifiestos de transferencia; no descarga ni acceso. |
Zenodo · zenodo | Zenodo | 2 | Conjunto de datos públicos, software y descubrimiento de publicaciones, metadatos e inventarios de archivos específicos de la versión; no subir ni descargar. |
HMMER · hmmer | HMMER3, EMBL-EBI | 3 | Búsqueda de proteínas/profile/alineación específica del programa, estado de trabajo y resultados. |
InterProScan · interproscan | InterProScan, EMBL-EBI | 3 | Presentar secuencias de proteínas, comprobar el estado de anotación-job y recuperar los informes TSV. |
Pathway Commons · pathway-commons | Pathway Commons, Reactome | 4 | Caminos de búsqueda, rutas de arriba, consultas gráficas y exportaciones de submodelo BioPAX. |
Alliance Genome Resources · alliance | Alliance of Genome Resources | 8 | genes humanos y modelo-organismo, ortologs, modelos de enfermedades, fenotipos, alelos y expresión. |
CELLxGENE Discover · cellxgene-discover | CELLxGENE Discover | 9 | Colecciones de células individuales y conjuntos de datos, versiones publicadas, formatos de archivo, tamaños y URLs de descarga. |
Cellosaurus · cellosaurus | Cellosaurus | 6 | Encontrar nombres de línea celular y sinónimos, luego inspeccionar identidad de adhesión y anotaciones de calidad. |
Monarch Initiative · monarch | Monarch Initiative | 2 | Asociaciones de enfermedad/gene a fenotipo con organismo y evidencia de apoyo. |
IEDB · iedb | IEDB | 8 | Epitopes, antígenos, T-cell, B-cell y MHC, evidencia TCR/BCR y publicaciones de origen. |
PDC · pdc | PDC | 5 | Versiones de estudio proteomics del cáncer, especímenes, metadatos clínicos de caso público e inventarios de archivos; sin descarga. |
ENCORI · encori | ENCORI | 10 | miRNA/RBP objetivos, interacciones RNA, ceRNA, motivos, sitios vinculantes, tablas de referencia y archivos a granel. |
Orphadata · orphadata | Orphadata, Orphanet | 2 | Rare-disease gene associations and HPO phenotype frequencies; disabled by default. |
TCIA · tcia | TCIA, NBIA | 3 | Colecciones de imágenes, condiciones de acceso y metadatos de series. |
KEGG · kegg | KEGG | 3 | Rutas, compuestos y mapeos de genes; se aplican restricciones de licencia. |
RxNorm / RxNav · rxnorm | RxNorm, RxNav | 2 | Resolución de nombres de fármacos y propiedades de conceptos activos. |
DailyMed · dailymed | DailyMed | 2 | Identidades de etiquetas de medicamentos e historial de versiones. |
BioSamples · biosamples | EMBL-EBI BioSamples | 2 | Metadatos públicos de muestras y referencias cruzadas. |
WikiPathways · wikipathways | WikiPathways | 2 | Metadatos de rutas, especies y revisiones. |
Europe PMC · europepmc | Europe PMC | 1 | Búsqueda bibliográfica directa, resúmenes y paginación. |
Research Datasets · research-datasets | NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, GBD | 3 | Requisitos de acceso y descubrimiento de archivos públicos. |
ChEA3 · chea3 | ChEA3 | 2 | Clasificaciones de factores de transcripción y enlaces GMT. |
bioDBnet · biodbnet | bioDBnet | 6 | Conversión de identificadores, ortólogos y rutas. |
CTD · ctd | CTD | 1 | Acceso a informes públicos oficiales y condiciones. |
Las herramientas Molecule offline están cubiertas en Visores científicos. Para las operaciones exactas expuestas por cada fuente de datos, utilice el Referencia de operación Connector.
¿Qué puedes hacer?
| Tareas de investigación | Comience con | Producción típica |
|---|---|---|
| Encontrar documentos, localizar citas y comprobar las relaciones DOI | Gráfico de literatura, PubMed, bioRxiv | Registros de literatura, identificadores, enlaces de citas y disponibilidad de texto completo |
| Encontrar genes o proteínas y comparar secuencias | Genes & Ontologies, Genomes | Cartografías identificativas, registros de proteínas, informes de FASTA y BLAST |
| Descubra los datos omics públicos e inspeccione los archivos disponibles | Omics Archives | Metadatos de estudio y funcionamiento e inventarios de archivos con ubicaciones de fuentes, tamaños y comprobaciones disponibles |
| Interpretar una lista de genes o inspeccionar una red de interacción | Genes & Ontologies, Anotación de Proteína | Tablas de enriquecimiento, anotaciones de ontología y registros de red |
| Verificar variantes, expresión y evidencia regulatoria | Variantes, Genómica Clínica, Genética Humana, Expresión, Regulación | Registros de fuentes con organismos, tejidos, construcción de referencia y campos de evidencia relevantes |
| Recuperar los registros de compuestos, estructuras o estudios clínicos | Química, ChEMBL, Estructuras " Interacciones, Ensayos Clínicos | Identificadores/propiedades químicas, registros de la estructura y metadatos de ensayo |
Para la conversión de identificador de lotes, Genes & Ontologies añade submit_uniprot_id_mapping, get_uniprot_id_mapping_status y get_uniprot_id_mapping_results. Guardar el ID de trabajo, encuestar por lo menos tres segundos aparte, y luego recuperar cada página de resultado. Preserve one-to-many mappings and explicit failed_ids; faltar de una página no significa inigualable. El servicio acepta identificadores de hasta 100,000 y expira los resultados después de hasta siete días. Ver campos de mapeo exactos.
Zenodo expone metadatos de registro público sin autenticación. Mantenga el ID de registro específico de la versión y campos de acceso/license con el inventario de archivos. GDC expone metadatos públicos; a manifiesto no es autorización de descarga, y los archivos controlados requieren permiso GDC. Operaciones de los PMA · Operaciones de Zenodo.
Una respuesta de una base de datos puede apoyar un paso de investigación; no descarga automáticamente los datos, agrega cada papel a la biblioteca de literatura o ejecuta un análisis completo. Especifique qué registros y archivos desea guardar.
Pruebas regulatorias del ARN con ENCORI
Encontrar ENCORI en Settings → Connectors, activarlo y ponerlo a disposición de Agente principal. Esta fuente incorporada no necesita ninguna URL personalizada de MCP o clave API. Con un modelo Main de trabajo seleccionado, especifique el organismo/asambly, ARN o gen objetivo, tipo celular y umbrales de evidencia en la conversación.
| Tarea | Resultado y límite |
|---|---|
| consultas de miRNA, RNA-RNA, RBP-target y ceRNA | Retener las pruebas CLIP aplicables, degrado, pronóstico, valor p y FDR; vinculante o asociación no establece la regulación causal. |
| Pruebas de enfermedad de RBP, motivos y sitios de unión | ensamblaje, contexto de tejido/celular, orden de corriente y coordenadas originales; no mezclar especies ni coordinar sistemas. |
| Tablas de referencia y datos a granel | Enumere las rutas de tabla exactas o nombres de archivo primero. La descarga a granel es separada: especificar el archivo, el destino y el almacenamiento requerido antes de solicitarlo. |
Ejemplo práctico Consultar pruebas de miRNA para PDCD4 en HeLa
Use ENCORI to find human miRNA interactions targeting PDCD4 in HeLa cells,
using hg38, mRNA targets, at least one CLIP experiment and TargetScan support.
Show at most two rows. Preserve the exact filters, total count and full raw
response in the session data folder. Explain the evidence limits in English.
Do not download bulk datasets.
Esta consulta devolvió los registros 19; los dos primeros fueron hsa-miR-23a-3p y hsa-miR-181a-5p. La captura de pantalla muestra la respuesta cruda completa guardada y los límites de evidencia. Estos son resultados específicos de ejemplo y pueden cambiar como actualizaciones de la base de datos.
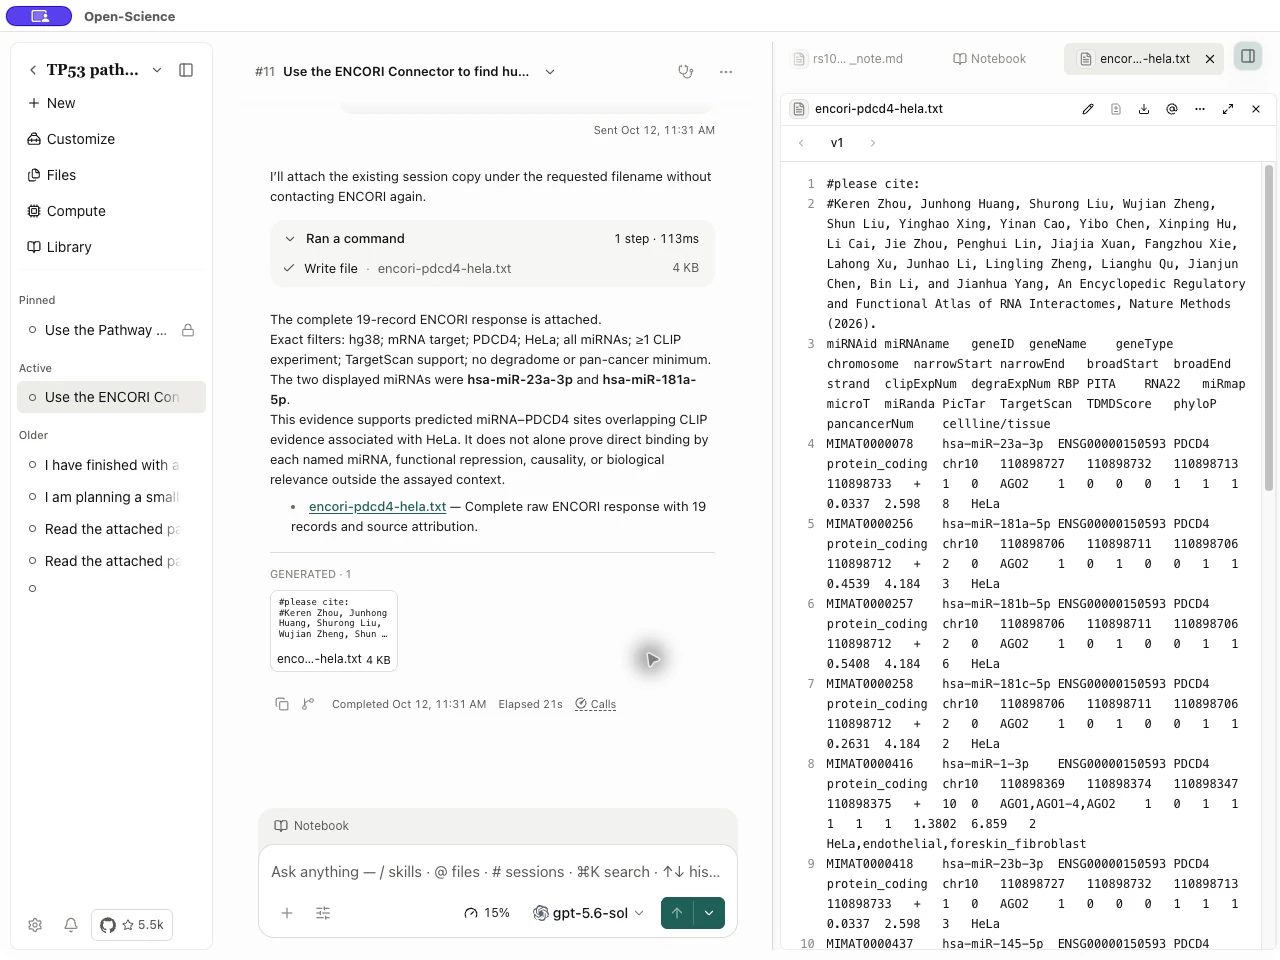
Distinguir total_records de returned_records, e inspeccionar is_complete, result_scope y completeness_note. Una vista previa no es una distribución completa del objetivo. raw_response_path de la respuesta completa es una ruta de archivo local, no automáticamente un artefacto de sesión descargable. Para compartirlo, pídale al agente que lo guarde en un directorio de datos de sesión accesible y adjunte el archivo; abrir el accesorio para comprobar su contenido.
Una consulta puede devolver un resultado vacío genuino o ok:false; no amplíe silenciosamente los filtros para obtener un éxito. Después de una descarga a granel, compruebe el camino real, tamaño y verified_gzip. La lectura de tablas de referencia o conjuntos de datos no descarga los archivos de volumen. Vea Operaciones ENCORI para parámetros exactos.
Contexto de ensayo y presentaciones individuales
| Entrada | Procedimiento | Límite de interpretación |
|---|---|---|
| ChEMBL | Habilitar el Connector; no se necesita llave API. Toma. assay_chembl_id de un registro de bioactividad, método de inspección, organismo, célula/tissue y objetivo con get_assay, luego recuperar get_bioactivity para la misma identificación de ensayo. | La confianza en la asignación de objetivos no es la calidad de medición. Compare las condiciones, unidades y operadores de relación antes de combinar los valores IC50/Ki. |
| Variants → ClinVar | Configurar un correo electrónico de contacto NCBI real en el Connector; la tecla API es opcional. Call clinvar_get_submissions con una adhesión VCV o ID de Variación positiva, luego siga la versión-pintada next_page argumentos. | Preserve SCV, remitente, condición, fecha de evaluación, método y citas. Compare por separado el germline, el impacto clínico somático y la oncogenidad. |
Las páginas ChEMBL son ordenadas por activity_id. Mantenga los filtros sin cambios y pasar next_offset como el siguiente offset hasta has_more:false; esto puede recuperar más de los registros 1,000. El summary sólo cubre la página actual, por lo que su actividad más fuerte no es necesariamente la más fuerte en la consulta completa. Después de que ClinVar resuelva una primera página de última versión, retenga la versión devuelta VCV para continuación; no sustituya una entrada RCV, SCV o rsID.
Campos de ensayo ChEMBL · Página de la bioactividad · Campos de presentación ClinVar.
Datos monocelulares, modelo-organismo y efectos de variante
Busque las entradas de abajo en Settings → Connectors, active la disponibilidad para Agente principal, luego describa el organismo, la pregunta de investigación y los registros para retener en su conversación. Estas nuevas operaciones leen datos públicos sin un servidor MCP personalizado, tecla API o correo electrónico de contacto NCBI. Otros servicios en el mismo Connector pueden tener diferentes requisitos.
| Entrada | ¿Qué puede hacer? | Cómo utilizar los resultados |
|---|---|---|
| CELLxGENE Discover | Encontrar conjuntos de datos de células individuales por organismo, tejido, enfermedad, ensayo o tipo celular; inspeccionar versiones e inventarios de archivos | Los filtros de ontología usan etiquetas exactas o IDs y se combinan con AND. Retener dataset_version_id para una publicación fija; dataset_id se resuelve a la versión actual. Devoluciones disponibles descarga URLs, sin descargar archivos o consultar matrices de expresión Census. Utilice el CellGuide separado para descripciones y marcadores de tipo celular. |
| Alliance Genome Resources | Query human, mouse, rat, fly, gusano, cebrafish, levadura y genes de rana, ortologs, modelos de enfermedades, fenotipos y expresión | Busque y confirme el organismo antes de seguir los identificadores de genes devueltos. Retener evidencia y rigor ortológico; un fenotipo de organización modelo no es una conclusión de la enfermedad humana. |
| Variantes → MaveDB | Encontrar conjuntos de puntuación de efectos de la variante, métodos de ensayo, páginas de puntuación CSV y mapas VRS existentes | Mantenga el URN, licencia, métodos de ensayo y calibración de puntuación. Las puntuaciones funcionales no son clasificaciones de patogenicidad clínica. CSV utiliza la paginación de inicio/limit y el texto devuelto todavía necesita guardar a un archivo. Mapping retrieval no realiza el levantamiento. |
| Archivos de Omics → Metabolomics Workbench | Estudios de búsqueda; inspeccionar muestras, factores, análisis y metabolitos mediante la adhesión al ST; buscar estructuras compuestas y referencias cruzadas | Seleccione resumen, factores, análisis o metabolitos con sección. Resolver nombres compuestos a través de PubChem en identificadores compatibles primero. Estas operaciones no descargan matrices de medición crudas. |
Filtro CELLxGENE y paginación se ejecutan localmente sobre el catálogo aguas arriba trazado para cada solicitud; el catálogo puede cambiar entre solicitudes. Use IDs de la versión para retener una publicación. Un tamaño de archivo no reportado es -1, no cero bytes. Preserve valores perdidos y definiciones de ensayo en MaveDB y resultados Workbench también.
Vea las entradas exactas para CELLxGENE Discover, Alliance, MaveDB y Metabolomics Workbench.
Líneas celulares, fenotipos y evidencia inmune
Habilitar Cellosaurus, Monarch Initiative o IEDB en Settings → Connectors y hacerlo disponible a Agente principal. Estas operaciones consultan registros públicos sin un servidor personalizado o una tecla API.
| Entrada | Qué pedir | Qué preservar |
|---|---|---|
| Cellosaurus | Buscar un nombre de línea celular/sinónimo, luego recuperar la adhesión CVCL devuelto o RRID | Especies, identidad, sinónimos y anotaciones de contaminación/identificación. La búsqueda toma una frase literal, no una consulta de Solr cruda. Las anotaciones de calidad perdidas no certifican la línea celular. |
| Monarch Initiative | Asociaciones de fenotipo de enfermedad o gen que utilizan RIEs canónico, como MONDO:0007254 o HGNC:11998 | Organismo, fenotipo, fuente y evidencia. Las alisas no se convierten automáticamente; resolver los identificadores primero. Un partido directo se refiere a identificador que coincide, no confirmación experimental. |
| IEDB | Epitopes o antígenos, o un ensayo específico de células T, células B o MHC | Se requiere al menos un filtro biológico/evidencia; La paginación por sí sola es insuficiente. Usar antigen_iri o uniprot_accession, no ambos. Método de ensayo, resultado, unidades y publicación; una observación de elución MHC no es una medición de afinidad. |
Un registro de epitope/antigeno agregado puede combinar las observaciones de diferentes experimentos. Cuando los filtros deben estar satisfechos por el mismo experimento, consulta la operación correspondiente de ensayo. Cero coincidencias no establecen un hallazgo biológico negativo. Parámetros Cellosaurus · Parámetros de monarca · Parámetros IEDB.
Encuentra matrices GEO y estructuras de secuencia
Omics Archives → geo_get_matrix_files descubre los archivos oficiales de la serie GEO Matrix y cuenta generados por NCBI/FPKM/TPM/annotation. Devuelve las ubicaciones de archivos; no descarga sus bytes. geo_get_series sigue siendo una búsqueda de metadatos.
Después de obtener una matriz, geo_preflight_matrix comprueba el texto ya leído, descomprimido hasta 8 MiB. No tiene acceso a la red ni al sistema de archivos. Mantenga los identificadores GSM y metadatos de plataforma para que las muestras puedan ser mapeados por ID en lugar de posición de columna. Establecer completo: falso para una vista previa; sólo pasar completo: verdadero para todo el archivo. Una vista previa no puede establecer dimensiones enteras. No alimentar un archivo comprimido, matriz escasa o archivo HDF5 en el comprobador de texto. Ver matriz de descubrimiento y texto anterior.
Structures & Interactions → pdb_search_sequence acepta una secuencia de proteínas de residuos 25–10,000, como secuencia cruda o un registro FASTA. Los umbrales de identidad y cobertura de consultas son fracciones de 0 a 1. La cobertura de consulta devuelta describe la alineación a la consulta; no es cobertura de estructura experimental. El total aguas arriba precede al filtrado de cobertura local, y un escaneo atado puede omitir los partidos posteriores. La operación encuentra registros de la estructura sin descargar coordenadas. Ver entradas exactas y límites de escaneo.
Conectar y comenzar a usar una base de datos
1. Habilitar el Connector incorporado
- Abrir Settings → Connectors y buscar la familia que se encuentra en la lista anterior, como Omics Archives.
- Abre su detalle y expande Tools. Lea las entradas de la operación elegida, los límites de resultados y los requisitos de terceros.
- Habilitar la disponibilidad para Agente principal y comprobar Used by. Utilice Manage access en el recurso para ajustar las asociaciones Main Agent y Specialist. Las políticas de aprobación de disponibilidad y de per-herramienta son controles separados.
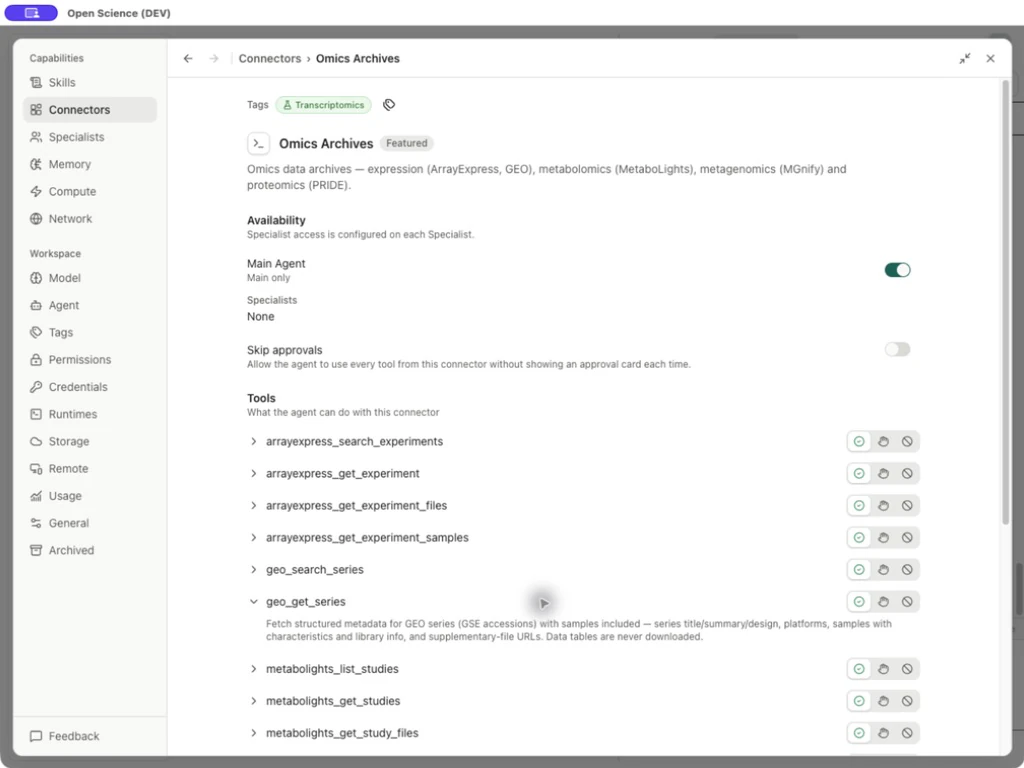
Estos conectores se construyen en; no necesita añadir un servidor personalizado para ellos. Para un servicio externo usted opera a sí mismo, vea configuración personalizada Connector. Un Connector listado o habilitado no es prueba de que la autenticación o una consulta tuvo éxito.
2. Agregar credenciales cuando la operación los requiera
| Servicio o condición | Dónde configurarlo |
|---|---|
| OpenAlex | La clave opcional. Para configurar uno, abra Settings → Connectors → Literature Graph → Manage credentials → OpenAlex, validarlo, entonces guardar. |
| Consultas directas de la variante NCBI que requieren información de contacto | Settings → Connectors → Manage credentials → Literature access. Rellene Contact email y seleccionar Save. Una llave NCBI API es opcional. |
| Otra operación con un requisito credencial | Siga los requisitos de esa herramienta y los Guía de credenciales. Ata la credencial al servicio previsto. |
Introduzca las teclas en la forma credencial, no en un aviso de investigación o un archivo de salida compartido. Configurar los requisitos para la operación seleccionada; el requisito de contacto-email arriba no significa que cada herramienta NCBI tiene el mismo requisito.
El Gráfico de Literatura también ofrece crossref_get_work, crossref_get_updates, datacite_search_records y datacite_get_record. Estos cuatro métodos públicos no requieren la clave OpenAlex. Para las direcciones de citación OpenAlex, openalex_citations encuentra obras citando un trabajo, mientras que openalex_references encuentra las obras que cita. Parámetros de Gráfico de Literatura.
3. Confirme el acceso con una pequeña consulta
Habilitar Genes & Ontologies, abrir una conversación con un modelo conectado, y enviar:
Ejemplo Revisa un identificador de genes humanos conocido
Use Genes & Ontologies query_genes to resolve TP53 with scopes="symbol",
species="human" and fields="symbol,name,entrezgene". Return the input query,
matched records and any unmatched identifiers. Keep the response in English.
Inspeccione el resultado real de la herramienta. Para el TP53 humano, consulte query, symbol, Entrez Gene 7157 y el nombre proteína tumoral p53. Retener múltiples coincidencias hasta que haya confirmado el organismo y grabar. Una consulta exitosa confirma esta operación en particular; no establece el acceso a todas las fuentes. Campos de acción.
Seguir un flujo de trabajo de investigación
Cada artículo a continuación incluye las entradas, pasos, capturas de pantalla de interfaz en inglés y salidas de ejemplo descargables.
Encontrar datos de omics públicos
Encuentre datos de omics públicos y construya un inventario de archivos: empezar con una carrera conocida o un tema, inspeccionar los registros ENA y PRIDE, y guardar los lugares de origen y los cheques. La descarga de los datos sigue siendo un paso separado.
Compare una secuencia de proteínas
Encuentra una secuencia de proteínas y completa una búsqueda BLAST: recuperar UniProt FASTA, conservar el ID de trabajo BLAST, luego inspeccionar las alineaciones completadas, la cobertura de identidad y consulta.
Analizar un gen candidato conjunto
Ejecutar el enriquecimiento funcional para un conjunto de genes candidato: elegir el organismo, identificadores y fondo, ejecutar g:Profiler, e interpretar probabilidades corregidas con versiones de origen.
Confirme un genoma de referencia
Especies de verificación, genoma de referencia e identificadores cromosomas: resolver el taxón, el montaje versionado y los alias cromosomas antes de unirse a los registros.
Inspeccione una red de vías
Inspeccione una vía y su red de interacción: encontrar una vía Reactome humana a través de Pathway Commons, preservar su URI devuelto, exportar las interacciones y distinguir una red seleccionada de evidencia de actividad de la vía.
Para otras tareas, siga registros de PubChem estructurados, comprobando los registros científicos o descubrimiento de literatura para una reunión de grupo.
Utilice correctamente los datos devueltos
- Retener las versiones de consulta, fuente, organismo, tejido, unidades y adhesión. Los registros de bases de datos, las predicciones y los resúmenes generados son diferentes tipos de pruebas.
- Cheque conteos devueltos, banderas de paginación y truncación antes de tratar una respuesta como completa. Cero coincidencias, una respuesta parcial y un error de solicitud necesitan diferentes acciones de seguimiento.
- Un inventario de archivos proporciona ubicaciones y metadatos. Descarga de bytes, cheques y análisis de los datos son operaciones separadas.
- Si una solicitud necesita credenciales, complete el formulario pertinente antes de volver a iniciar sesión. Para los límites de tarifas, siga el retraso del servicio; para los plazos, reducir el tamaño de la solicitud. Ver Solución de problemas.
Frecuencias de población y redes de interacción
Para get_variant, establece include_populations: true sólo cuando se necesitan detalles de la población. Retener el conjunto de datos y la compilación de referencia. Las observaciones de exoma y genoma siguen siendo separadas. Un valor no disponible es null, no cero; no se debe resumir la población o los estratos sexuales. Estas son frecuencias observadas, no filtrando frecuencias de alelo. gnomAD parámetros
Desde v0.31.0, get_string_network.nodes incluye vecinos devueltos y entradas aisladas de mapeado. Una única entrada mapeada solicita a los vecinos; múltiples entradas mapeadas no se expanden. Filtrar is_query para recuperar nodos de entrada, y utilizar queries para todos los alias mapeados. n_nodes cuenta el gráfico; n_mapped cuenta las asignaciones de entrada. Actualizar scripts que equipararon a los dos antes de reutilizarlos. Parámetros de STRING
Encontrar parámetros de operación
Las listas Referencia de operación Connector requieren entradas, valores permitidos y llamadas exactas. Utilice esta página para elegir una fuente y conectarla; utilizar la referencia para los campos de una herramienta en particular.
Fuente del catálogo: catalog.ts, registry.ts.
Búsquedas de secuencia y alineación
HMMER proporciona la secuencia de proteínas específicas para el programa, perfil-HMM y búsquedas de alineación. Elija el programa y la base de datos juntos, retenga el ID de trabajo y recupere los resultados sólo después de SUCCESS. Operaciones de HMMER.
InterProScan es compatible con la presentación de proteínas, el estado de trabajo y la recuperación de anotación TSV de v0.35.1. Siga Sumisión InterProScan para la configuración y los pasos.
Genomes → Clustal Omega alinea al menos tres registros de proteínas, ADN o RNA FASTA. Configure el correo electrónico de contacto solicitado por el servicio, envíe una vez, retenga el ID de trabajo, luego revise el estado y ahorre la alineación devuelta. Flujo de trabajo de alineación de secuencia múltiple.
Enrichr, STRING y ClinPGx
- Genes & Ontologies → Enrichr: lista las bibliotecas actuales, luego consulta el enriquecimiento de conjunto de genes para funciones, factores de transcripción, perturbaciones, drogas, enfermedades, tejidos o tipos de células. Seleccione una biblioteca apropiada para el organismo y la pregunta, y retenga su nombre, fondo y valores P ajustados.
- Protein Annotation → STRING: prueba si una red de proteínas tiene más interacciones de lo esperado desde su fondo. Esto hace una pregunta diferente del camino de la sobrerepresentación; su valor de red P no es una prueba de ruta. Siga el flujo de trabajo de enriquecimiento.
- Clinical Genomics → ClinPGx: recuperar anotaciones de drogas, genes o variantes, pautas, etiquetas regulatorias y frecuencias poblacionales. Resuelva primero los identificadores, provea los campos requeridos por la operación, y conserva fuentes originales y niveles de evidencia. Esto recupera registros de investigación; no produce automáticamente un plan de tratamiento individual.
Habilitar el Connector relevante para el agente activo en Settings → Connectors. Estas entradas incorporadas no requieren un servidor MCP personalizado. Vea el referencia a la operación para campos exactos y requisitos condicionales.
Caminos, expresión y datos clínicos
Permite a la familia correspondiente en Settings → Connectors, luego dígale al agente el organismo, fuente, identificadores y alcance previsto. Estas adiciones utilizan conectores incorporados; no se requiere un servidor MCP personalizado.
| Entrada | ¿Qué puede hacer? | Conexión e interpretación |
|---|---|---|
| Pathway Commons | Caminos de búsqueda, lista de caminos superiores, rutas de consulta entre genes o exportar un submodel | - Servicio público; retener la URI devuelta, organismo y fuente. Las consultas de Gráficos difieren de las pruebas de enriquecimiento. Sigue a la flujo de trabajo de interacción de caminos. |
| Expresión → Bgee | Transspecies presentes/absente llamadas, puntajes normalizados, consultas SPARQL atada y enlaces de descarga | Descubre primero las especies y conserva el ID de taxonomía NCBI. SPARQL requiere gen, especies y tejido. Las llamadas de base saludables de tipo salvaje no son expresiones diferenciales; Los enlaces de descarga no se descargan archivos. |
| Modelos de cáncer → cBioPortal | Lista muestras/pacientes y atributos clínicos de consulta o expresión mRNA/proteína | Seleccione un estudio, descubra sus perfiles y elija la medición/normalización. Identificación de suministro que coincida con el nivel de muestra/paciente clínico; Los datos moleculares necesitan genes explícitos y exactamente uno de sample_ids o sample_list_id. Las filas perdidas no son ceros. |
| Regulador de drogas → openFDA | Informes de búsqueda/cuenta de los FAERS y memorias de los medicamentos de búsqueda | Fechas y productos de labranza y conservar la información de la truncación. Los recuentos de los informes no son incidencia o evidencia causal. Los cubos multivalorados pueden superponerse; su suma no es un informe único total. |
| Archivos de Omics → MGnify | Lista de resultados de la adhesión al análisis MGYA | Devoluciones tipo, categoría, URL y tamaño de arriba cuando se reporta. No se descargan bytes de archivos; tamaños o URLs perdidos permanecen nulos. |
Vea el Referencia de operación Connector para campos, condiciones y ejemplos requeridos.
Interpretar disponibilidad de especies Bgee
Comience con bgee_species para identificar la especie. Su taxon_id es el ID de taxonomía NCBI del organismo, no la especie que suministra su genoma de referencia. En una respuesta de la lista, has_expression_data: null significa que la disponibilidad no se determinó. Consultar de nuevo utilizando el taxon_id devuelto como species_id para cargar los metadatos de fuente de datos de esa especie. Mantener null como desconocido cuando los metadatos están ausentes; sólo un false explícito es un resultado negativo de disponibilidad. Estos campos describen la cobertura del atlas, no si un gen en particular se expresa en un tejido.
Encontrar archivos de la estadística de sumario GWAS
Activar Genética Humana para Main en Settings → Connectors. Pida el descubrimiento de la estadística sumaria con el Adhesión de GCST del estudio, y retenga las URL de archivo original/armonizado, metadatos y genoma de referencia declarado. La búsqueda pública no requiere una llave API.
gwas_get_summary_statistics lista archivos de estudio y lee metadatos YAML disponibles; no descarga grandes mesas de asociación. Sus definiciones de columna GWAS-SSF describen el estándar, no un encabezado de archivo inspeccionado. Descargue el archivo deseado por separado y compruebe sus columnas reales, genoma de construcción, efecto de alelos y unidades antes del análisis. Los éxitos significativos de las asociaciones no son un sustituto de las estadísticas completas de resumen. Parámetros y salida.
Presentar una secuencia de proteínas a InterProScan
- Activar InterProScan para Main en Settings → Connectors. En Settings → Credentials → Literature access, guarde el correo electrónico de contacto válido utilizado para trabajos EMBL-EBI; no se requiere llave API.
- Proporcione una secuencia de proteínas o registros de proteína FASTA únicos y solicite sumisión una vez. La secuencia y el correo electrónico de contacto se envían a EMBL-EBI. Una solicitud acepta hasta registros 1,000, residuos 10,000 por secuencia y un cuerpo de solicitud codificado 4 MiB.
- Retenga el job_id devuelto. SUBMITTED con ready: false es un recibo, no un resultado de anotación. Revise estado de la situación al menos diez segundos de distancia; la encuesta no es automática.
- Después de FINISHED, solicite resultados y guarde el TSV completo antes de que el resultado remoto expire. Una respuesta sobre el límite de recuperación de 2 MiB falla en lugar de devolver silenciosamente un informe truncado.
- Revise los identificadores de proteínas, aplicaciones de origen y coordenadas inclusivas basadas en 1. No se intercambian los puntos de las diferentes aplicaciones de los miembros; ningún golpe no prueba que una proteína carece de una función.
Evite la presentación duplicada después de un tiempo: recuperar un ID de trabajo conocido primero. Cancelar una solicitud local no cancela un trabajo remoto enviado. Ver parámetros de presentación, estado y resultados.
Encontrar TCR y BCR evidencia en IEDB
Habilitar IEDB para Main y solicitar search_tcrs o search_bcrs con al menos un filtro biológico o de evidencia. La pagación por sí sola es insuficiente. Use sequence para la secuencia epitope; Secuencias chain1_cdr3 y chain2_cdr3 del receptor del filtro CDR3. Estas búsquedas públicas no necesitan llave API.
Mantenga el ID del grupo receptor, cadenas, identificados de ensayo y publicaciones de origen. Los filtros de host y de resultado se aplican a grupos agregados y pueden ser satisfechos por diferentes experimentos. Para establecer que las condiciones ocurren en el mismo ensayo, siga los identificados de ensayo reportados en la operación de ensayo correspondiente y aplique los filtros necesarios allí. La paginación cubre los grupos de receptores, no la integridad de cada exportación incrustada. Estos registros son la recuperación de evidencias, no una predicción de la unión del receptor. Parámetros IEDB.
Descubre proteómica del cáncer con PDC
Activar PDC en Settings → Connectors. Su metadata pública API no necesita llave API. Utilízalo para encontrar estudios y versiones, inspeccionar los recuentos de ensayo y especímenes, map case–sample–aliquot asociaciones, y lista de archivos cuantitativos como los informes de Asamblea de Protein. No devuelve los datos de tratamiento / salida o descarga archivos.
Comience con una adhesión de estudio como PDC000127, o identificadores de estudio de búsqueda y nombres de versiones. La combinación de palabras clave PDC no es un filtro de enfermedad clínica. Retrieve the study, then use its returned study_id UUID to pin subsequent calls; pdc_study_id selecciona la última versión. Proporcione exactamente uno de estos selectores.
Para listas de especímenes, la paginación aguas arriba cuenta casos; La expansión de muestras y coartadas puede producir más filas que el límite de caso. Las páginas de modo local predeterminadas recibieron asociaciones y tiene una tapa de asociación 1,000-. Una página local final no prueba la integridad cuando se llega a esa tapa. Mantenga IDs PDC y las referencias GDC externas nombradas separadas. Los listados de archivos incluyen nombres, tamaños de byte, valores de MD5 y rutas de almacenamiento; una ruta listada no es una URL de descarga autorizada.
Ver Operaciones PDC y paginación. Antes de combinar fuentes, compruebe la versión de estudio, ensayo, identidad de especímenes y los requisitos de acceso y cita de cada fuente.
Chequee LD específico de la población
Activar Genomes en Settings → Connectors. Sus herramientas Ensembl LD utilizan el API público sin una llave. Proveer dos IDs variantes para ensembl_ld_pairwise, o uno para ensembl_ld_proxies, junto con el nombre completo de la población, como 1000GENOMES:phase_3:KHV. Las herramientas no descubren la población o la ascendencia infernal; elegir una población de referencia apropiada para el estudio.
Informe de resultados pares r2 y D′. Consultas indirectas predeterminadas a r2 ≥ 0.8 y 500 kb ventana total, aproximadamente 250 kb en ambos lados. max_records capta la lista devuelta después de ordenar, no el trabajo de arriba. Mantener la población y los metadatos de recuperación con el resultado; este punto final no reporta la asamblea de referencia o la liberación Ensembl. Los resultados vacíos significan que no se devuelven los datos de calificación, no cero LD. El LD alto no establece ninguna causalidad ni equivalencia funcional. Ver campos pares y campos proxy.
Ejemplo, expresión y contexto de montaje
| Query | Interpretación en v1.0.2 |
|---|---|
arrayexpress_get_experiment_samples | samples contiene filas de relación del primer archivo SDRF ordenados por ruta. n_rows_total / n_rows_returned contar filas; n_samples / n_samples_returned contar identificadores distintos, preferir Nombre de la muestraEntonces, Nombre de la fuente. No son réplicas biológicas independientes cuenta. Los identificadores perdidos pueden hacer conteos de muestras null. Un archivo vacío o no_sdrf la respuesta no establece que el experimento no tiene muestras. |
metabolights_get_studies con include_samples | Usar el devuelto headers orden al exportar sample_table. Nombres de columna repetidos tienen únicos #2, #3, ... sufijos sin sobrescribir nombres originales. Retener todas las columnas; una cuerda vacía en una fila corta falta metadatos. Check rows_truncated. |
bgee_expression_calls | Manténganse. anatomical_entity_id/name junto con cell_type_id/name. Un tipo de célula desaparecido null, no una llamada de expresión negativa. Mantenga la expresión estado, calidad y condición juntos. |
| dbSNP variantes de búsquedas | Retener cada colocación assembly, assembly_full, seq_id, posición y alelos. Una secuencia se puede asociar con más de una asamblea; no derrumben esas asociaciones ni utilizan la primera colocación como relevo automático. |
Estas correcciones cambian la forma en que deben leerse las pruebas devueltas. Revise el referencia a la operación antes de comparar una respuesta ahorrada más antigua con una nueva búsqueda.
OpenAlex credential prompts
v1.0.2 recuerda un impulso decreciente OpenAlex para la sesión actual, evitando repetidos impulsos allí. Si más tarde necesita esa fuente, configure explícitamente en Settings → Connectors → Literature Graph → Manage credentials → OpenAlex y retratar la consulta prevista. Declining the prompt neither supplies a key nor guarantees access or quota.
Conectar las nuevas fuentes y preservar su significado
En Settings → Connectors, encontrar la entrada abajo y permitir que Main o el Especialista previsto. HGNC, PubTator 3, DGIdb y RNAcentral son herramientas dentro de las entradas existentes. Orphadata es una entrada separada y se apaga por defecto. Estas nuevas herramientas utilizan puntos finales públicos sin su propia clave de API; otras herramientas en la misma entrada pueden tener diferentes requisitos credenciales.
| Fuente | Entrada de configuración | Solicitud y comprobación |
|---|---|---|
| HGNC | Genes & Ontologies | Consultar un símbolo humano aprobado o resolver un alias exacto. Mantenga cada partido ambiguo y el estado aprobado/retraído antes de seleccionar un gen. |
| PubTator 3 | PubMed | Recuperar anotaciones por PMID o entidades de búsqueda/relaciones. La recuperación de la anotación cubre los títulos/abstractos; no presenta su texto crudo o prueba el soporte de texto completo para una reclamación. |
| DGIdb | Clinical Genomics | Query a gene or drug name, preserve las fuentes y publicaciones, y siga el cursor devuelto. Una interacción entre fármacos y genes no es una recomendación de tratamiento. |
| RNAcentral | RNA | Busque una adhesión a los URS, luego haga una página a través de referencias cruzadas entre expertos y bases de datos. Preserve taxonomía, secuencia MD5 y versiones de adhesión. |
| Orphadata | Orphadata | Permitir acceso primero, luego suministrar un código ORPHA para genes o fenotipos HPO. Mantener tipos de asociación y categorías de frecuencia; no son probabilidades específicas para el paciente. |
Llamadas exactas: HGNC, PubTator, DGIdb, RNAcentral, Orphadata.
Vincular metadatos de cáncer e interpretar una variante
- PDC: solicitar demografía pública y campos de diagnóstico con
pdc_list_clinical. Usarpdc_study_idpara la última versión ostudy_idpara una versión fija. Retener valores perdidos/obfuscados y referencias externas nombradas; PDC y GDC UUIDs no son intercambiables. - GDC: filtrar archivos por
case_ids,sample_typesyworkflow_types. Mantenga las asociaciones de muestras, aliciones y flujos de trabajo normales de cada archivo en lugar de fusionar todos los archivos en un caso. Los filtros son O dentro de un campo y Y a través de campos. El acceso a los metadatos no autoriza las descargas de archivos controlados. - Ensembl VEP: paso
hgvs_notationpor sí solo, sinvariant_id,region,alleleoallele_orientation. Mantenga las versiones de montaje, transcripción y banderas de truncación reportadas. Las versiones de referencia de entrada son pasadas, no validadas;matchedno establece un partido de versión. Esto es consecuencia anotación, no interpretación clínica o relevo. - Clinical Trials: uso
get_trial_resultspara mediciones de resultados publicadas, denominadores, análisis estadísticos y eventos adversos. ID de grupo de coincidencias sólo dentro del mismo módulo de resultado / salida. Los resultados perdidos no son cero eventos o prueba de ningún efecto.
Véase PDC, Filtros GDC, Modos VEP y Resultados del juicio publicados.
Imágenes, vías, lípidos y modelos de cáncer
En Settings → Connectors, habilitar la fuente prevista y ponerla a disposición Main. TCIA, KEGG, RxNorm / RxNav, DailyMed, BioSamples y WikiPathways son entradas separadas, deshabilitadas por defecto. Las operaciones a continuación utilizan servicios públicos sin un servidor MCP personalizado o clave API. El acceso a un conector no otorga una licencia de datos ni acceso a datos restringidos.
| Entrada | Solicitud | Mantener con el resultado |
|---|---|---|
| TCIA | Buscar colecciones; inspeccionar una colección o una serie DICOM existente UID | Licencia, condiciones de acceso y requisitos de descarga. Los enlaces devueltos pueden ser manifiestos Data Retriever, no archivos de imagen. |
| KEGG | Buscar entradas de vías, KO, compuestos o reacciones; mapear un gen identificado junto con su organismo | Elegibilidad de uso académico y términos de licencia; mapeos de uno a varios y truncación. Esto no es el enriquecimiento de los genes. |
| Química → LIPID MAPS / UniChem | Buscar un LMID exacto o PubChem CID; mapear un ID InChIKey o ChEMBL | Resolver nombres primero con PubChem. Conserve las coincidencias distintas y atribución fuente; estos no son búsquedas de similitud. |
| Estructuras e interacciones → OmniPath | Consultar la regulación anterior o posterior de un identificador UniProt humano canónico | Dirección, pruebas contradictorias de estimulación/inhibición e identificadores complejos. Las relaciones agregadas no son una prueba causal específica del tejido. |
| Estructuras e interacciones → PDBe / PDB | Inspeccione la validación de la estructura experimental o encuentre cadenas de proteínas depositadas similares | Método y métricas faltantes; use label_asym_id, no un ID de cadena de autor. Las puntuaciones de similitud no son una alineación estructural computada o RMSD. |
| Modelos de cáncer → DepMap / CCLE | Resolver una línea celular a ModelID, después consultar un gen o perfil compuesto | Versión y escala de los datos: Chronos no es una probabilidad; PRISM AUC no es IC50; el ARN se expresa como log2(TPM+1); el número de copias es relativo a la ploidía. |
| RxNorm / RxNav · DailyMed | Resolver los nombres de las drogas a RxCUIs; inspeccionar las identidades de las etiquetas SPL y la historia de la versión | Mantener identidades ambiguas. Los nombres de coincidencia no establecen equivalencia clínica; un listado DailyMed no establece la aprobación de la FDA. |
| BioSamples · WikiPathways | Encontrar metadatos de muestra o metadatos de vías y revisiones | Identificador, especie, fechas de origen y evidencia vinculada. Estas búsquedas no descargan archivos de muestras enlazados o gráficos de ruta. |
Usar el referencia a la operación para entradas exactas y paginación. Conserve los valores null y las marcas de resultados truncados; un resultado limitado no representa toda la base de datos.
Descubra datos oficiales de investigación y listas de archivos
In Settings → Connectors, habilitar sólo las entradas necesarias para su pregunta. Las nuevas entradas de Europa PMC, Datasets de Investigación, ChEA3, bioDBnet y CTD utilizan servicios públicos sin necesidad de clave API. Las solicitudes todavía envían los términos de búsqueda suministrados, identificadores o listas de genes a esos servicios. Controles de conexión.
| Necesidad | Entrada y resultado | Siguiente paso |
|---|---|---|
| Buscar documentos biomédicos directamente | Europe PMC devuelve los registros básicos, los resúmenes disponibles y un cursor de próxima página | Guardar identificadores y continuar la paginación; una URL de texto completo no se recupera texto completo |
| Encontrar encuesta o archivos de demostración clínicos | Research Datasets lista archivos NHANES con enlaces de ciclo/documentación y demós públicos MIMIC/EICU | Ciclo de comprobación, versión, licencia y documentación antes de descargar de la fuente oficial |
| Comprender el acceso a los datasets | Research Datasets explica puntos de entrada para NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, FAERS y GBD | Complete el propio proceso de registro, entrenamiento o exportación de la fuente cuando sea necesario |
| Descubra los informes públicos | Drug Regulatory, CTD y Cellosaurus lista de lugares de archivos oficiales | Compruebe la página de origen actual, la versión y los términos; el descubrimiento no descarga o importa archivos |
| Normalizar identificadores de genes | Genes & Ontologies agrega campos de servicio HGNC, consultas de campo y listas de archivos; bioDBnet añade conversión y cartografía ortolog | Descubre primero los campos/tipos soportados; conserva los resultados ambiguos, inéditos y únicos. |
| Reguladores candidatos Rank | ChEA3 devuelve el ranking del factor de transcripción por biblioteca y los enlaces de biblioteca GMT | Treat rankings como hipótesis; una biblioteca GMT descargada puede diferir de la biblioteca detrás de un resultado en línea |
| Inspeccionar evidencia de línea celular | Cellosaurus añade RDF, SPARQL consolidado y similitud de STR | Adhesión y configuración de marcadores; la similitud por sí sola no certifica la identidad de muestra |
Los listados de archivos devuelven URLs oficiales y metadatos fuente, no archivos descargados o una base de datos de análisis lista. El análisis de NHANES todavía requiere el diseño correcto de la encuesta y pesos. El acceso demo MIMIC/eICU no otorga acceso a sus conjuntos de datos completos. Los informes de los FAERS no pueden interpretarse como tasas de incidencia. Para campos y ejemplos exactos, utilice el referencia a la operación.