과학 데이터베이스
이 페이지를 사용하여 데이터 소스를 선택하여 반품 할 수있는 것을 이해하고 Open-Science에서 사용할 수있는 도구를 만듭니다. 스크린 샷 및 출력 파일이있는 단계별 연구 예제를 위해 연구 워크플로을 참조하십시오.
지원된 데이터베이스
Open-Science v1.0.5는 내장 Connector 48개와 작업 418개를 제공합니다. 데이터 소스 Connector 47개가 작업 416개를, 오프라인 Molecule Connector 1개가 작업 2개를 제공합니다. 아래 이름은 Settings → Connectors의 항목과 일치합니다. 하나의 Connector가 여러 데이터베이스를 다룰 수 있지만, 해당 웹사이트의 모든 기능을 지원한다는 뜻은 아닙니다.
이 수에는 비활성화된 항목을 포함한 모든 내장 항목이 포함됩니다. 사용자가 추가한 MCP Connector는 별도입니다. Connector 수, 연결된 데이터베이스 수, 호출 가능한 작업 수는 서로 다른 기준입니다.
| 커넥터 | 출처 | 작업 | 사용하기 |
|---|---|---|---|
Chemistry · chemistry | PubChem, ChEBI, Rhea, BindingDB, LIPID MAPS, UniChem | 14 | PubChem, ChEBI, Rhea 및 BindingDB를 통해 소형 molecule 화학. |
Literature Graph · literature | OpenAlex, arXiv, Crossref, DataCite | 13 | 용지, 저자, 인용, DOI 업데이트 및 데이터 세트 / 소프트웨어 레코드. |
PubMed · pubmed | PubMed, PMC, Europe PMC, PubTator 3 | 9 | NCBI E-utilities, PMC ID Converter, Europe PMC를 통한 생의학 문헌 검색, 메타데이터, 관련 논문, 인용 조회, ID 변환, 전문 및 저작권 정보. |
Genes & Ontologies · genes | HGNC, MyGene, UniProt, OLS, QuickGO, Reactome, g:Profiler, Enrichr | 20 | 유전자·단백질 식별자, UniProt 서열 검색, GO·Reactome 주석, g:Profiler·Enrichr 유전자 집합 풍부도 분석. |
게놈 · genomes | NCBI Datasets, NCBI BLAST, EMBL-EBI Job Dispatcher, Ensembl, UCSC | 22 | Genome 주석, 균질 및 순서; NCBI taxon/assembly/sequence 정체성; BLAST 검색 및 클러스터 오메가 다중 시퀀스 정렬; 인구 별 LD 및 프록시 변형. |
Variants · variants | gnomAD, ClinVar, dbSNP, MaveDB | 22 | 인구 빈도, 임상 기록 및 분석실험 특정한 기능적인 점수, 매핑 및 실험. |
Clinical Trials · clinical-trials | ClinicalTrials.gov | 7 | 임상시험 검색, 프로토콜, 공개된 결과 측정값, 군별 분모, 통계 분석 및 이상반응. |
Clinical Genomics · clinical-genomics | ClinGen, CIViC, Open Targets, ClinPGx, DGIdb | 32 | ClinGen 큐레이션, CIViC 임상 근거, Open Targets Platform 및 ClinPGx 약물유전체 기록. |
구조 및 상호 작용 · structures | PDB, PDBe, AlphaFold, EMDB, Complex Portal, IntAct, OmniPath | 20 | 구조 및 분자 상호 작용 — PDB 구조, AlphaFold 예측, EMDB cryo-EM 항목, Complex Portal complexes, IntAct 상호 작용 네트워크. |
· · chembl | ChEMBL | 7 | 비활성 화합물, 약물, 표적, 생물 활성성, 그리고 메커니즘을 통해 ChEMBL REST API. |
bioRxiv · biorxiv | bioRxiv, medRxiv, ROR | 7 | bioRxiv/medRxiv preprints — 날짜/category, DOI, 저널-publication 링크, 펀더 목록 및 플랫폼 통계에 의해 검색. |
의약품 규제 · drug-regulatory | openFDA | 11 | Drugs@FDA, 상표, FAERS 불리 배출 보고와 약은 회귀합니다. |
인간 유전학 · human-genetics | GWAS Catalog, eQTL Catalogue, PheWeb | 15 | 인간 유전학 협회 증거 - GWAS 카탈로그, eQTL 카탈로그, PheWeb PheWAS 포털 (FinnGen, BioBank Japan). |
· · expression | GTEx, Bgee | 16 | 인간적인 GTEx 조직 표식 및 eQTLs; Bgee 크로스 사양 기본 표현. |
단백질 표기 · protein-annotation | InterPro, Pfam, Human Protein Atlas, STRING | 14 | Protein Domain Architecture, 가족/실란 회원, 인터프로/Pfam, Human Protein Atlas 및 STRING을 통한 식각 atlas 및 상호 작용 네트워크. |
암 모델 · cancer-models | cBioPortal, DepMap / CCLE | 15 | 연구, mutations, 복사 번호, 샘플, 환자, 임상 특성 및 분자 프로파일 표현. |
RNA · rna | Rfam, RNAcentral | 11 | Rfam의 비암호화 RNA 계열 메타데이터, 정렬, 모델 및 구조. |
Omics Archives · omics-archives | ArrayExpress, GEO, ENA, MetaboLights, Metabolomics Workbench, MGnify, PRIDE | 28 | Omics 연구 / 실행 메타 데이터 및 파일 재고; metabolomics 표본, 요인, 분석 및 화합물 기록. |
CellGuide · cellguide | CELLxGENE | 5 | Cell-type identity, 마커 유전자, 소스 데이터 세트, 그리고 CELLxGENEGuide Cell을 통해 조직. |
Regulation · regulation | ENCODE, JASPAR, UniBind | 16 | 유전자 조절 기능 genomics - ENCODE 실험 / 생물 샘플 / 파일, JASPAR TF 바인딩 프로파일 및 UniBind ChIP-seq TFBS. |
Research Resources · research-resources | Grants.gov, Antibody Registry | 5 | Funding-opportunity search (Grants.gov) 및 항체 카탈로그 조회 (Antibody Registry). |
BioMart · biomart | Ensembl BioMart | 8 | Ensembl BioMart 속성 쿼리 및 식별자 번역. |
ZINC · zinc | ZINC | 5 | ZINC22 purchasable 화학 공간 (CartBlanche22) - ZINC id, SMILES에 의해 합성 보기 정확하고/similarity 수색, 공급자 부호 해결책, 무작위 표본 추출, 선창을 위한 3D 구조 위치. |
GDC · gdc | Genomic Data Commons (GDC) | 5 | 암 프로젝트, 케이스, 파일 메타 데이터, 오픈 / 제어 라벨 및 전송 표시; 다운로드 또는 액세스 권한을 부여하지 않습니다. |
Zenodo · zenodo | Zenodo | 2 | 공공 데이터 세트, 소프트웨어 및 출판 발견, 버전 별 메타 데이터 및 파일 재고; 업로드 또는 다운로드. |
· · hmmer | HMMER3, EMBL-EBI | 3 | 프로그램별 단백질/프로필/분리 검색, 작업 상태 및 결과. |
InterProScan · interproscan | InterProScan, EMBL-EBI | 3 | 단백질 시퀀스 제출, annotation-job 상태를 확인하고 TSV 보고서를 검색하십시오. |
Pathway Commons · pathway-commons | Pathway Commons, Reactome | 4 | Pathway 검색, 최고 통로, 그래프 쿼리 및 BioPAX 서브모델 수출. |
Alliance Genome Resources · alliance | Alliance of Genome Resources | 8 | 인간 및 모델 조직 유전자, 정형화, 질병 모델, 페형화, 알레르기 및 표현. |
CELLxGENE Discover · cellxgene-discover | CELLxGENE Discover | 9 | Single-cell 컬렉션 및 데이터 세트, 출판된 버전, 파일 형식, 크기 및 다운로드 URL. |
Cellosaurus · cellosaurus | Cellosaurus | 6 | 셀 라인 이름과 동의를 찾기, 다음 액세스 정체성 및 품질 annotations를 검사. |
Monarch Initiative · monarch | Monarch Initiative | 2 | 질병/진-to-phenotype 협회는 생물과 지원 증거를 가진다. |
IEDB · iedb | IEDB | 8 | Epitopes, 항원, T 세포, B 세포 및 MHC 분석실험, TCR/BCR 증거 및 근원 간행물. |
PDC · pdc | PDC | 5 | 암 단백질체 연구 버전, 검체 연결, 공개 증례 임상 메타데이터 및 파일 목록. 파일 다운로드는 제공하지 않습니다. |
ENCORI · encori | ENCORI | 10 | miRNA/RBP 표적, RNA 상호 작용, ceRNA, motifs, 바인딩 위치, 참고 테이블 및 대량 파일. |
Orphadata · orphadata | Orphadata, Orphanet | 2 | 희귀질환 유전자 연관성과 HPO 표현형 빈도. 기본적으로 꺼져 있습니다. |
TCIA · tcia | TCIA, NBIA | 3 | 공개 영상 컬렉션, 접근 조건 및 시리즈 메타데이터. |
KEGG · kegg | KEGG | 3 | 경로·화합물 항목 및 유전자 매핑. 라이선스 조건 준수. |
RxNorm / RxNav · rxnorm | RxNorm, RxNav | 2 | 약물명 확인 및 유효한 개념의 속성. |
DailyMed · dailymed | DailyMed | 2 | 의약품 라벨 식별 정보 및 버전 이력. |
BioSamples · biosamples | EMBL-EBI BioSamples | 2 | 공개 시료 메타데이터 및 교차 참조. |
WikiPathways · wikipathways | WikiPathways | 2 | 경로 메타데이터, 종 및 개정 정보. |
Europe PMC · europepmc | Europe PMC | 1 | 문헌 직접 검색, 초록 및 페이지 탐색. |
Research Datasets · research-datasets | NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, GBD | 3 | 데이터 접근 조건 및 공개 파일 검색. |
ChEA3 · chea3 | ChEA3 | 2 | 전사인자 농축 순위 및 GMT 링크. |
bioDBnet · biodbnet | bioDBnet | 6 | 식별자 변환, 상동 유전자 매핑 및 경로. |
CTD · ctd | CTD | 1 | 공식 공개 보고서 접근 경로 및 이용 조건. |
오프라인 Molecule 도구는 사이트맵에 덮여 있습니다. 각 데이터 소스에 노출된 정확한 작업을 위해 Connector 가동 참고을 사용합니다.
당신이 할 수있는 것
| 연구 업무 | 계정 만들기 | 출력 전압 |
|---|---|---|
| 종이 찾기, 추적 인용 및 DOI 관계 확인 | 문학 그래프, PubMed, bioRxiv | 문학 기록, 식별자, 인용 링크 및 전체 텍스트 가용성 |
| 유전자 또는 단백질을 찾아서 시퀀스 비교 | 유전자 및 종양학, 게놈 | Identifier 매핑, 단백질 기록, FASTA 및 BLAST 보고서 |
| 공공 omics 데이터를 발견하고 사용할 수 있는 파일을 검사 | Omics Archives - 오믹스 | Study/run metadata 및 file inventories with source 위치, 크기 및 사용 가능한 체크섬 |
| Interpret 유전자 목록 또는 상호 작용 네트워크를 검사 | 유전자 및 종양학, 단백질 Annotation | Enrichment 테이블, 투과학 주석 및 네트워크 기록 |
| 변형, 표식 및 규제 증거 확인 | Variants, 임상 Genomics, 인간 유전학, 표현, 규정 | 생물, 조직, 참고 구조 및 관련 증거 분야를 가진 근원 기록 |
| 화합물, 구조 또는 임상 연구 기록 | 화학, ChEMBL, 구조 및 상호 작용, 임상 시험 | 화학 식별자 / properties, 구조 기록 및 재판 metadata |
일괄 식별자 변환의 경우 유전자 및 종양학은 submit_uniprot_id_mapping, get_uniprot_id_mapping_status 및 get_uniprot_id_mapping_results을 추가합니다. 작업 ID를 저장, 적어도 세 초 떨어져 설문 조사, 다음 각 결과 페이지를 검색. 1-to-many 매핑 및 명시된 failed_ids 보존; 한 페이지의 누락은 일치하지 않습니다. 서비스는 100,000 식별자에게 최대 7 일 후에 결과를 만료합니다. 정확한 매핑 필드 참조.
젠도는 인증 없이 공개 레코드 메타데이터를 노출합니다. 파일 재고가있는 버전 별 레코드 ID 및 액세스 / 라이센스 필드를 유지하십시오. GDC 소개 공개 메타데이터 노출; 정의는 권한 부여를 다운로드하지 않으며, 제어 된 파일은 GDC 권한이 필요합니다. GDC 운영 · Zenodo 운영.
데이터베이스 응답은 연구 단계를 지원할 수 있습니다; 그것은 자동으로 데이터를 다운로드하지 않습니다, 문학 라이브러리에 모든 종이를 추가하거나 완전한 분석을 실행. 저장하고 싶은 기록과 파일을 지정합니다.
ENCORI과 RNA 규제 증거
Settings → Connectors에서 ENCORI 찾기, 활성화하고 메인 에이전트를 사용할 수 있습니다. 이 내장 소스는 사용자 정의 MCP URL 또는 API 키를 필요로하지 않습니다. 선택된 Main 모델과 함께, 유기체/조립, RNA 또는 대상 유전자, 세포 유형 및 증거 임계 값을 대화에 지정합니다.
| 작업 | 결과 및 경계 |
|---|---|
| miRNA, RNA–RNA, RBP-target 및 ceRNA 쿼리 | 적용 가능한 CLIP, degradome, 예측 프로그램, p-value 및 FDR 증거를 포함합니다; 바인딩 또는 협회는 카우편 규정을 수립하지 않습니다. |
| RBP 질병 증거, motifs 및 의무적인 위치 | 보존 집합, 티슈/셀 컨텍스트, 업스트림 순서 및 원래 좌표; 종 또는 협조 체계를 섞지 마십시오. |
| 참조표 및 대량 데이터 | 정확한 테이블 경로 또는 filenames를 먼저 나열합니다. 대량 다운로드는 별도입니다: 요청하기 전에 파일, 목적지 및 필요한 저장을 지정합니다. |
실습 예제 HeLa의 PDCD4에 대한 쿼리 miRNA 증거
Use ENCORI to find human miRNA interactions targeting PDCD4 in HeLa cells,
using hg38, mRNA targets, at least one CLIP experiment and TargetScan support.
Show at most two rows. Preserve the exact filters, total count and full raw
response in the session data folder. Explain the evidence limits in English.
Do not download bulk datasets.
이 쿼리는 19 레코드를 반환; 첫 번째 두는 hsa-miR-23a-3p 및 hsa-miR-181a-5p이었다. 스크린 샷은 저장된 완전한 원시 응답과 증거 제한을 보여줍니다. 이 예제 별 결과이며 데이터베이스 업데이트로 변경할 수 있습니다.
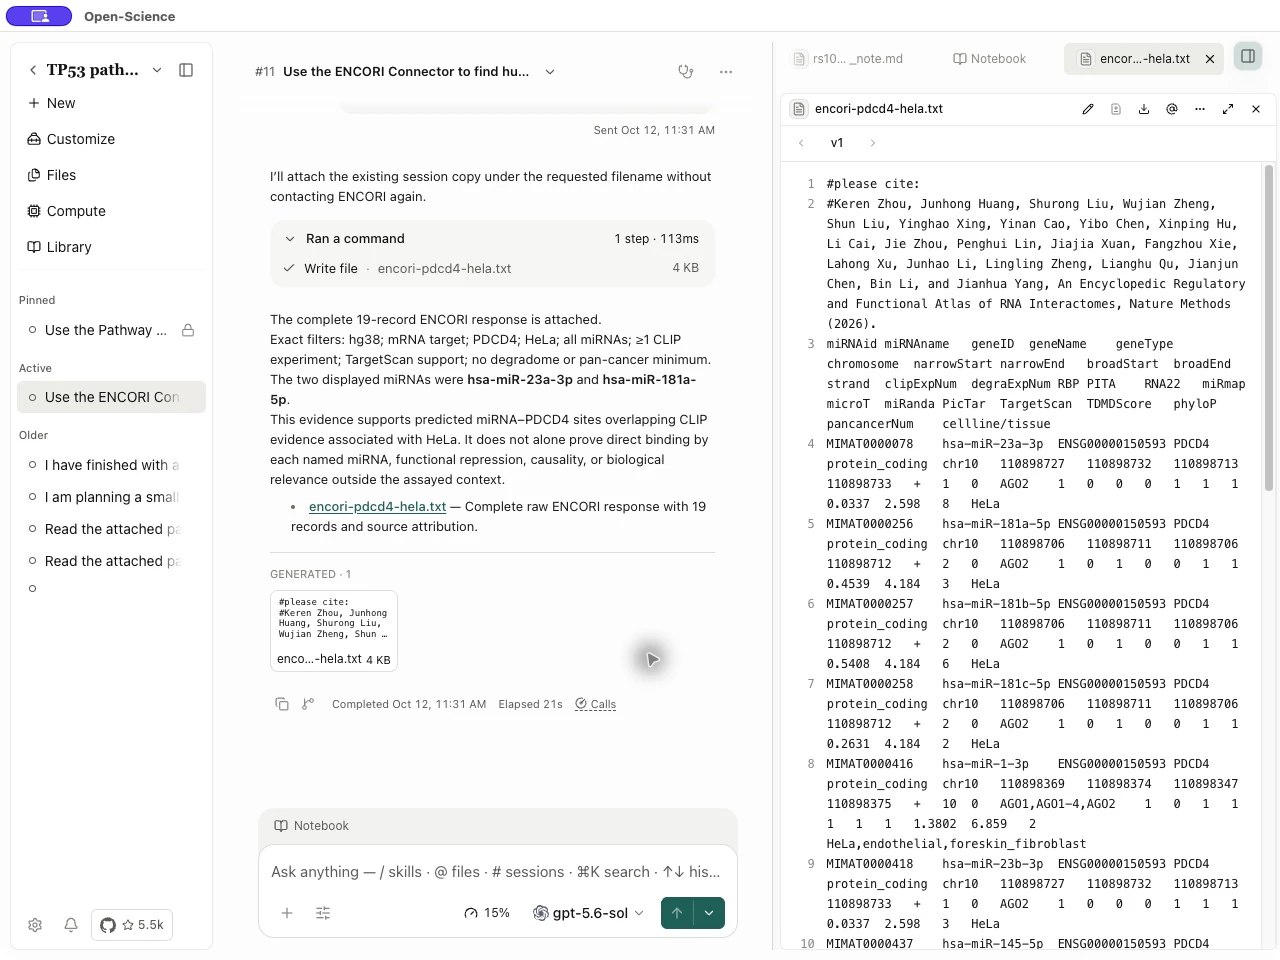
returned_records에서 total_records을 분산시키고 is_complete, result_scope 및 completeness_note를 검사합니다. 미리보기는 완전한 대상 배포가 아닙니다. 전체 응답의 raw_response_path은 로컬 파일 경로이며, 자동으로 다운로드 세션 아트팩트입니다. 이를 공유하려면 해당 세션 데이터 디렉토리에 저장하고 파일을 첨부하는 에이전트를 요청하십시오. 첨부파일을 열고 내용을 확인한다.
쿼리는 정품 빈 결과 또는 ok:false을 반환 할 수 있습니다; 히어로즈를 얻으려면 조용히 넓은 필터가 없습니다. 대량 다운로드 후 실제 경로, 크기 및 verified_gzip을 확인하십시오. 참고 표 또는 listing datasets는 대량 파일을 다운로드하지 않습니다. 정확한 매개 변수에 대한 ENCORI 운영을 참조하십시오.
분석 컨텍스트 및 개별 제출
| 이름 * | - 연혁 | 인턴십 |
|---|---|---|
| 담당자: Mr. wang | Connector를 활성화; API 키가 필요하지 않습니다. 뚱 베어 assay_chembl_id 생물성 기록에서, 방법, 생물, 세포/조직 및 표적을 검열하십시오 get_assay, 다음 검색 get_bioactivity 동일한 assay ID를 위해. | Target-assignment 신뢰는 측정 품질이 아닙니다. IC50/Ki 값을 결합하기 전에 조건, 단위 및 관계 통신수를 비교하십시오. |
| Variants → ClinVar | Connector의 실제 NCBI 접촉 이메일 구성; API 열쇠는 선택적입니다. . . .. clinvar_get_submissions VCV 접근 또는 긍정적인 변리법 ID로, 그 후에 버전 핀으로 꼿습니다 next_page 인수. | 보존 SCV, 제출자, 조건, 평가일, 방법 및 인용. germline, somatic 임상 충격 및 oncogenicity를 별도로 비교하십시오. |
ChEMBL 페이지는 activity_id에 의해 주문됩니다. has_more:false까지 다음 offset로 next_offset 필터를 변경하고 전달하십시오. 이것은 1,000 레코드보다 더 많은 것을 검색 할 수 있습니다. summary는 현재 페이지만 다루고 있으므로 가장 강한 활동은 반드시 전체 쿼리에서 가장 강한 것 입니다. ClinVar이 최신 버전의 첫 번째 페이지를 해결 한 후, 지속적인 VCV을 반환 버전으로 유지; RCV, SCV 또는 rsID 입력을 대체하지 마십시오.
ChEMBL 분석실험 분야 · Bioactivity 질화 · ClinVar 제출 필드.
단일 셀, 모델 조직 및 변형 효과 데이터
아래 항목 검색 Settings → Connectors, 메인 에이전트에 대한 가용성을 활성화, 다음 생물을 설명, 연구 질문 및 기록 당신의 대화에 유지. 이 새로운 작업은 사용자 정의 MCP 서버, API 키 또는 NCBI 연락처 이메일없이 공공 데이터를 읽습니다. 동일한 Connector에 있는 다른 서비스는 다른 필요조건이 있을 수 있습니다.
| 이름 * | 할 수 있는 것 | 결과를 사용하는 방법 |
|---|---|---|
| CELLxGENE Discover | 생물, 조직, 질병, 분석실험 또는 세포 유형에 의하여 단세포 datasets를 찾아내십시오; 버전 및 파일 inventories 검사 | Ontology 필터는 정확한 라벨 또는 ID를 사용하며 AND와 결합됩니다. 고정 된 출판물에 대한 dataset_version_id 유지; dataset_id는 현재 버전에 해결합니다. 파일 다운로드 또는 Census expression matrices를 쿼리하지 않고 가능한 다운로드 URL을 반환합니다. 셀 타입 설명 및 마커에 대한 별도의 CellGuide을 사용하십시오. |
| Alliance Genome Resources | Query 인간, 마우스, 쥐, 플라이, 웜, zebrafish, 효모 및 서리 유전자, 정형화, 질병 모델, 페인 유형 및 표현 | 검색 및 다음 반환된 유전자 ID 전에 유기체를 확인합니다. 증거와 정형성 끈전류를 포함합니다; 모델-편리 현상은 인간의 질병 결론이 아닙니다. |
| 잔류물 → MaveDB | 변형 효과 점수 세트, 분석실험 방법, CSV 점수 페이지 및 기존 VRS 매핑 찾기 | URN, 라이센스, 분석실험 방법 및 점수 교정을 유지하십시오. 기능적인 점수는 임상 적인 경로를 분류하지 않습니다. CSV은 start/limit pagination을 사용하고 텍스트가 여전히 파일에 저장해야합니다. Mapping retrieval은 liftover를 수행하지 않습니다. |
| Omics Archives → Metabolomics Workbench | 검색 연구; 샘플, 요소, 분석 및 ST 액세스에 의해 대사를 검사; 화합물 구조와 교차 환경 보기 | 요약, 요소, 분석 또는 metabolites를 선택하여 섹션으로 선택하십시오. PubChem을 통한 화합물의 이름을 지원되는 식별자로 먼저 해결합니다. 이 작업은 원시 측정 매트릭스를 다운로드하지 않습니다. |
CELLxGENE 필터링 및 pagination은 각 요청에 대한 업스트림 카탈로그에 로컬로 실행됩니다. 카탈로그는 요청을 변경할 수 있습니다. 출판물을 보관하는 버전 ID를 사용합니다. 허용되지 않은 파일 크기는 -1, 0 바이트입니다. MaveDB 및 Workbench 결과의 누락된 값과 assay 정의를 보존합니다.
CELLxGENE Discover, (주), MaveDB 및 Metabolomics Workbench에 대한 정확한 입력을 참조하십시오.
세포 선, 페인팅 및 면역 증거
지원하다 Cellosaurus· Monarch Initiative 또는 IEDB 으로 Settings → Connectors 그리고 그것을 사용할 수 있습니다 메인 에이전트... 이 작업 쿼리는 사용자 정의 서버 또는 API 키없이 공개 레코드.
| 이름 * | 자주 묻는 질문 | 관광 명소 |
|---|---|---|
| Cellosaurus | 셀 라인 이름 / 합성을 검색 한 다음 반환된 CVCL 액세스 또는 RRID를 검색 | Species, 정체성, 동의 및 오염/misidentification annotations. 검색은 문학 구문, 아니 raw Solr 쿼리. 품질 표기는 셀 라인의 certify하지 않습니다. |
| Monarch Initiative | Canonical CURIEs를 사용하는 질병 또는 유전자 페형 협회는 MONDO와 같은: 0007254 또는 HGNC: 11998 | 기관, 페니 타입, 소스 및 증거. Aliases는 자동으로 변환되지 않습니다; 식별자를 먼저 해결합니다. 직접적인 일치 관심사 식별자 일치, 실험적인 확인. |
| IEDB | Epitopes 또는 항원, 또는 특정 T 세포, B 세포 또는 MHC 분석실험 | 적어도 1개의 생물학/유효한 여과기는 요구됩니다; 혼자 질은 충분합니다. antigen_iri 또는 uniprot_accession을 모두 사용하세요. 보존 assay 방법, 결과, 단위 및 출판; MHC 유출 관측은 비례적인 측정이 아닙니다. |
집계된 epitope/antigen 기록은 다른 실험에서 관측을 결합할 수 있습니다. 필터는 동일한 실험에 의해 만족해야 할 때, 대응 assay 가동을 쿼리합니다. Zero match는 부정적인 생물학적 발견을 수립하지 않습니다. Cellosaurus 모수 · Monarch 매개 변수 · IEDB 모수.
GEO 매트릭스 및 시퀀스 일치 구조 찾기
Omics Archives → geo_get_matrix_files는 공식 GEO 시리즈 모체와 NCBI 생성된 count/FPKM/TPM/annotation 파일을 발견합니다. 그것은 파일 위치를 반환; 그것은 자신의 바이트를 다운로드하지 않습니다. geo_get_series은 메타데이터 조회를 유지한다.
matrix를 얻기 후에, geo_preflight_matrix는 이미 읽고, 8 MiB까지 압축한 원본을 검사합니다. 그것은 네트워크 또는 파일 시스템 액세스가 없습니다. GSM 식별자 및 플랫폼 메타데이터를 유지하므로 샘플은 컬럼 포지션보다 ID로 매핑될 수 있습니다. 미리보기에 완료: 거짓 설정; 전체 파일에 완료: 진실만 전달합니다. 미리보기는 전체 파일 크기를 설정할 수 없습니다. 압축된 아카이브, sparse matrix 또는 HDF5 파일을 텍스트 검사기에 공급하지 마십시오. matrix 발견 및 텍스트 preflight을 참조하십시오.
Structures & Interactions → pdb_search_sequence는 원시 시퀀스 또는 원시 FASTA 기록으로 25-10,000 잔류물의 한 단백질 시퀀스를 허용합니다. 식별 및 쿼리 처리 임계 값은 0에서 1에 분수입니다. 반환된 쿼리 적용은 쿼리에 정렬을 설명합니다; 그것은 실험적인 구조 적용이 아닙니다. 업스트림 총은 지역 적용 필터링을 전진하고, 경계 스캔은 나중에 일치 할 수 있습니다. 작업은 좌표를 다운로드하지 않고 구조 레코드를 찾습니다. 정확한 입력 및 스캔 제한 참조.
데이터베이스를 사용하여 연결 및 시작
1. 내장 Connector 사용
- Settings → Connectors을 열고 Omics Archives - 오믹스과 같은 위에 나열된 가족을 검색합니다.
- 자세한 내용을 열고 Tools을 확장하십시오. 선택된 작업의 입력, 결과 제한 및 제 3 자 요구 사항을 읽어보십시오.
- 메인 에이전트 및 Used by을 위한 사용 가능한 가용성. Main 에이전트와 Specialist 협회를 조정하는 자원에 Manage access을 사용합니다. 가용성 및 per-tool 승인 정책은 별도의 통제입니다.
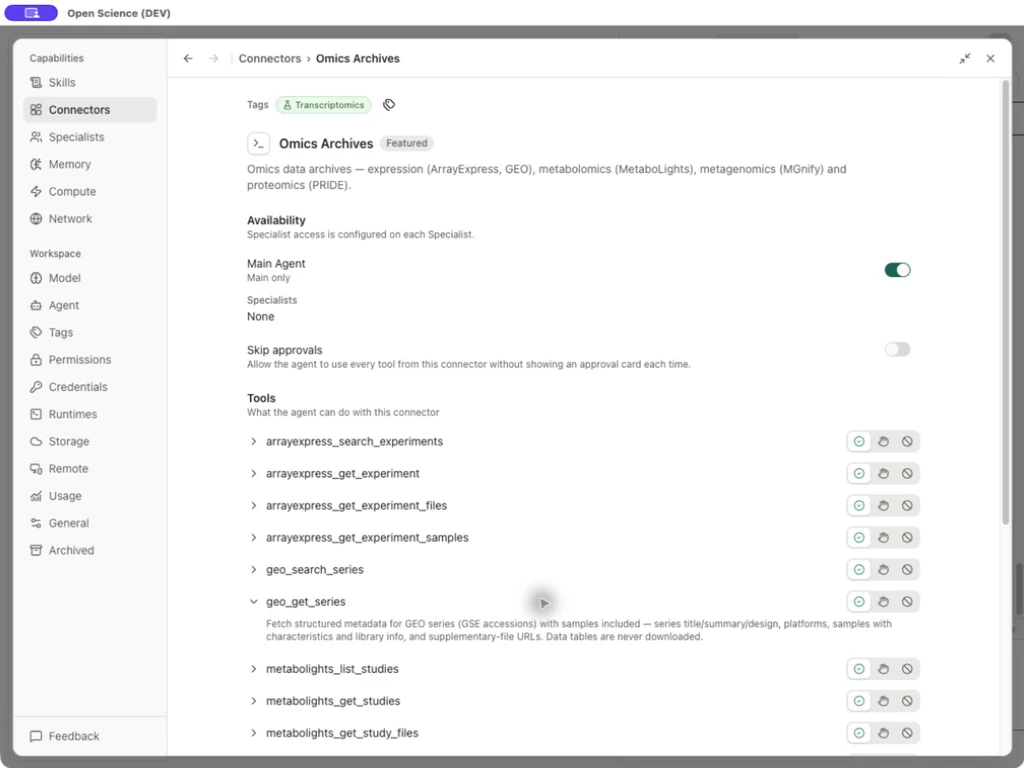
이 연결관은 안으로 건축됩니다; 사용자 정의 서버를 추가 할 필요가 없습니다. 외부 서비스를 위해 사용자 정의 Connector 설정을 참조하십시오. 목록으로 또는 활성화 Connector는 인증 또는 쿼리가 성공하는 증거가 아닙니다.
2. 작업이 필요할 때 credentials 추가
| 서비스 또는 조건 | 설정할 곳 |
|---|---|
| OpenAlex | 옵션 키. 하나 구성, 열기 Settings → Connectors → Literature Graph → Manage credentials → OpenAlex, 그것을 유효하게 하고, 그 후에 저장하십시오. |
| 연락처 정보를 요구하는 NCBI 변형 쿼리 | Settings → Connectors → Manage credentials → Literature access을 진행하세요. 제품정보 Contact email 을 선택해 주세요 Save을 진행하세요. NCBI API 열쇠는 선택적입니다. |
| credential 필요조건을 가진 또 다른 가동 | 그 도구의 요구 사항 및 자격 시험을 진행하세요. 의도한 서비스에 대한 자격 증명을 브랜딩합니다. |
credential 형태로 키 입력, 연구 프롬프트 또는 공유된 출력 파일에 아닙니다. 선택된 가동을 위한 필요조건을 형성하십시오; 위의 연락처 - 이메일 요구 사항은 모든 NCBI 도구가 동일한 요구 사항을 가지고 있음을 의미하지 않습니다.
문학 그래프는 또한 crossref_get_work, crossref_get_updates, datacite_search_records 및 datacite_get_record를 제공합니다. 이 4개의 공공 방법은 OpenAlex 열쇠를 요구하지 않습니다. OpenAlex 인용 방향을 위해, openalex_citations는 작동을 인용하는 것을, openalex_references는 작동을 cites 찾아내습니다. 문학 도표 모수.
3. 작은 쿼리에 대한 액세스 확인
유전자 및 종양학을 활성화하고, 연결된 모델과 대화를 열고, 다음을 보냅니다.
예시 알려진 인간 유전자 식별자를 확인
Use Genes & Ontologies query_genes to resolve TP53 with scopes="symbol",
species="human" and fields="symbol,name,entrezgene". Return the input query,
matched records and any unmatched identifiers. Keep the response in English.
실제 도구 결과 검사. 인간 TP53를 위해, query, symbol의 Entrez 유전자 7157 및 이름 종양 단백질 p53를 검사하십시오. 생물과 기록을 확인 할 때까지 여러 경기를 유지하십시오. 성공적인 질문은 이 특정한 가동을 확인합니다; 모든 소스에 액세스 할 수 없습니다. Exact 필드.
연구 워크플로우를 따르십시오
아래 각 문서에는 입력, 단계, 실제 영어 인터페이스 스크린 샷 및 다운로드 가능한 예 출력이 포함됩니다.
공공 omics 데이터 찾기
공공 omics 데이터를 찾아 파일 재고를 구축: 알려진 실행 또는 주제로 시작, ENA 및 PRIDE 레코드를 검사하고 소스 위치 및 체크섬을 저장합니다. 데이터 다운로드는 별도의 단계로 유지됩니다.
단백질 시퀀스 비교
단백질 시퀀스를 찾아 BLAST 검색 완료: UniProt FASTA를 검색하고, BLAST 작업 ID를 유지하고, 완성된 정렬, 정체성 및 쿼리 범위를 검사합니다.
후보 유전자 집합 분석
후보 유전자 세트에 대한 기능적 enrichment 실행: 생물, 식별자 및 배경을 선택하여 g:Profiler를 실행하고, 소스 버전으로 정확한 확률을 해석합니다.
참고 genome 확인
종, 참조 genome 및 크롬 식별자 확인: 부과, 버전 조립 및 크로노섬 별명을 수정합니다.
경로 네트워크 검사
경로 및 상호 작용 네트워크 검사: Pathway Commons를 통해 인간의 Reactome 통로를 찾아, 반환 URI를 보존하고, 상호 작용을 수출하고 경로 활동의 증거로부터 선택한 네트워크를 구별합니다.
다른 작업을 위해 Structured PubChem 레코드, Cross-checking 과학 기록 또는 그룹 회의에 대한 문학 발견를 따르십시오.
반환된 데이터를 올바르게 사용하십시오
- 쿼리, 소스, 생물, 조직, 단위 및 접근 버전을 포함합니다. 데이터베이스 기록, 예측 및 생성 된 요약은 다른 종류의 증거입니다.
- 응답을 완료하기 전에 반환된 수, pagination 및 truncation 플래그를 확인합니다. Zero 경기, 부분 응답 및 요청 오류가 다른 후속 조치가 필요합니다.
- 파일 재고는 위치와 메타데이터를 제공합니다. 다운로드 바이트, 체크섬 확인 및 데이터를 분석하는 것은 별도의 작업입니다.
- 요청이 credentials를 필요로 하는 경우, retrying 전에 관련 양식을 완료하십시오. 비율 한계를 위해, 서비스 지연을 따르십시오; timeouts를 위해, 요구 크기를 감소시키십시오. 문제 해결 참조.
인구 빈도 및 상호 작용 네트워크
get_variant의 경우, include_populations: true을 인구 세부 정보를 필요로 할 때 설정하십시오. dataset 및 참고 빌드를 유지하십시오. Exome 및 게놈 관측은 분리되어 있습니다. 사용할 수없는 값은 null, 0이 아닙니다. overlapping 인구 또는 성 strata는 정상적이지 않아야 합니다. 이 관찰된 빈도, allele 빈도를 거르지 않는. gnomAD 매개 변수
v0.31.0에서 get_string_network.nodes은 이웃과 고립 된 맵핑 입력을 반환합니다. 단일 맵 입력 요청 이웃; 여러 맵핑 입력이 확장되지 않습니다. 입력 노드를 복구하는 is_query 필터를 필터링하고, 모든 mapped aliases에 queries을 사용합니다. n_nodes는 그래프를 계산합니다; n_mapped는 입력 매핑을 계산합니다. 두 가지를 재사용하기 전에 업데이트 스크립트를 업데이트합니다. STRING 모수
작동 모수를 찾아내십시오
Connector 가동 참고 목록은 입력, 허용된 값 및 정확한 통화를 나열합니다. 이 페이지를 사용하여 소스를 선택하고 연결; 특정 도구의 필드에 대한 참조를 사용합니다.
카탈로그 출처: catalog.ts, registry.ts.
Sequence 검색 및 정렬
HMMER의 장점은 프로그램별 단백질, 프로파일-HMM 및 정렬 검색을 제공합니다. 함께 프로그램 및 데이터베이스를 선택하고 작업 ID를 유지하고 회사 소개 후 결과를 검색하십시오. HMMER 운영.
InterProScan의 장점은 v0.35.1에서 단백질-sequence 제출, 작업 상태 및 TSV annotation retrieval을 지원합니다. 설정 및 단계에 대한 InterProScan 제출을 따르십시오.
Genomes → Clustal Omega는 단백질, DNA 또는 RNA FASTA 레코드를 고유하게 지명한 적어도 3개의 종류를 맞추습니다. 서비스에 의해 요청된 연락처 이메일 구성, 한 번 제출, 작업 ID를 유지, 다음 상태를 확인하고 반환 정렬을 저장. 다중 상태 정렬 워크플로.
Enrichr, STRING 및 ClinPGx
- Genes & Ontologies → Enrichr: 현재 도서관 목록, 그 후에 기능, transcription 요인, perturbations, 약, 질병, 조직 또는 세포 유형을 위한 유전자 세트 enrichment를 질문하십시오. 생물과 질문에 적합한 라이브러리를 선택하고 이름을 유지하고 배경과 조정 된 P 값.
- Protein Annotation → STRING : 단백질 네트워크가 배경에서 예상보다 더 많은 상호 작용을 가지고 있는지 테스트합니다. 이것은 통로의 대표로부터 다른 질문을; 네트워크 P 값은 통로 테스트가 아닙니다. Gen-set enrichment 워크플로우을 따르십시오.
- Clinical Genomics → ClinPGx : 약물, 유전자 또는 변형 표기, 지침, 규제 라벨 및 인구 주파수. 식별자를 먼저 해결하고, 작업에 의해 필요한 필드를 공급하고 원본 소스와 증거 수준을 유지합니다. 이 연구 기록; 그것은 자동으로 개별 치료 계획을 생산하지 않습니다.
Settings → Connectors의 활성 에이전트에 대한 관련 Connector을 활성화합니다. 이 내장 항목은 사용자 정의 MCP 서버가 필요하지 않습니다. 정확한 필드 및 조건 요구 사항에 대한 및 다운로드 가능한 레지스트리는 이제 v0.31.1 :을 참조하십시오.
Pathways, 표현 및 임상 데이터
Settings → Connectors의 대응 가족을 활성화하고, 그 다음 유기체, 소스, 식별자 및 대상 범위를 알려줍니다. 이 추가 사용 내장 커넥터; MCP 서버가 필요하지 않습니다.
| 이름 * | 할 수 있는 것 | 연결 및 해석 |
|---|---|---|
| Pathway Commons | pathways, list top pathways, Genes 간 쿼리 경로 또는 submodel을 내보내기 | 공공 서비스; 반환된 URI, 생물 및 근원을 유지합니다. 그래프 쿼리는 enrichment 테스트와 다릅니다. 자주 묻는 질문 pathway 상호 작용 워크플로우. |
| 표현 → Bgee | Cross-species 선물/부정 통화, 정상화 된 점수, 경계 SPARQL 쿼리 및 다운로드 링크 | NCBI 세법 ID를 처음 발견하고 유지하십시오. SPARQL는 유전자, 종 및 조직을 요구합니다. 건강한 야생 유형 기본 전화는 차별 표식이 아닙니다; 다운로드 링크가 다운로드되지 않았습니다. |
| 암 모델 → cBioPortal | 샘플/패드 및 쿼리 임상 속성 또는 mRNA/단백 표현 | 연구 선택, 프로필을 발견하고 측정/정상화를 선택하십시오. 공급 IDs 일치 임상 샘플 / 일시적 수준; 분자 데이터는 명시된 유전자와 sample_ids 또는 sample_list_id의 정확히 하나가 필요합니다. 미스링 행은 제로가 아닙니다. |
| 약물 규제 → openFDA | Search/count FAERS 보고서 및 검색 약물 회신 | 경계 날짜 및 제품 및 유지 truncation 정보. 보고서 조사는 비공식적 또는 카우스알 증거가 아닙니다. 다 가치있는 물통은 overlap 할지도 모릅니다; 그들의 합계는 유일한 보고 아닙니다. |
| Omics Archives → MGnify | MGYA 분석 액세스에 의한 결과 파일 목록 | 반환 유형, 카테고리, 업스트림 URL 및 크기 때 보고. 파일 바이트가 다운로드되지 않습니다; 누락된 크기 또는 URL은 null을 유지합니다. |
정확한 필수 필드, 조건 및 예에 대한 Connector 가동 참고 참조.
Interpret Bgee 종 가용성
bgee_species로 시작하여 종을 식별합니다. taxon_id은 생물의 NCBI 세무성 ID이며, 종은 참조 genome을 공급하지 않습니다. 목록 응답에서 has_expression_data: null은 가용성이 결정되지 않았습니다. 반환된 taxon_id을 species_id로 사용하여 다시 쿼리는 종의 데이터 소스 메타데이터를 로드합니다. metadata가 absent 때 알 수없는 null을 유지하십시오. 명시된 false은 부정적인 가용성 결과입니다. 이 필드는 특정 유전자가 조직에서 표현되는지 여부에 atlas 적용을 설명합니다.
GWAS 요약 통계 파일 찾기
Settings → Connectors에서 Main에 대한 인간 유전학 활성화. 연구의 GCST 액세스에 대한 요약 통계 조사에 대한 질문, 그리고 반환된 원본/출시된 파일 URL, 메타데이터 및 선언된 참조 게놈을 유지. 공개 조회는 API 키가 필요하지 않습니다.
gwas_get_summary_statistics 목록 연구 파일 및 사용 가능한 YAML 메타 데이터 읽기; 그것은 큰 협회 테이블을 다운로드하지 않습니다. 그것의 GWAS-SSF 란 정의는 검열된 파일 우두머리가 아닌 표준을 설명합니다. genome build, effect allele and units를 별도로 지정하고 실제 열을 확인하여 분석하기 전에 대상 파일을 다운로드하십시오. Significant 협회는 완전한 요약 통계에 대 한 대체 되지 않습니다.. 모수와 산출.
InterProScan에 단백질 시퀀스 제출
- Settings → Connectors에서 Main에 대한 InterProScan의 장점 활성화. Settings → Credentials → Literature access에서 EMBL-EBI 작업에 사용되는 유효한 연락처 이메일을 저장하십시오; API 키가 필요하지 않습니다.
- 단백질 순서 또는 독특하게 지명된 단백질 FASTA 기록 및 요구 제출을 한 번 공급하십시오. 순서와 접촉 이메일은 EMBL-EBI에 보내집니다. 1개의 요청은 순서 당 1,000 기록, 10,000 잔류물 및 4 MiB에 의하여 인코딩된 요구 몸까지 받아들입니다.
- 반환된 job_id을 유지합니다. SUBMITTED 와 ready: false 은 영수증, 아니 annotation 결과입니다. (주) 적어도 10 초 떨어져 검사하십시오; 오염은 자동이 아닙니다.
- FINISHED 후, 제품정보을 요청하고 원격 결과가 만료되기 전에 완전한 TSV를 절약하십시오. 2 MiB 리트리발 한계에 대한 응답은 truncated 보고서를 침묵적으로 돌려보다는 실패합니다.
- 단백질 식별자, 소스 응용 프로그램 및 1 기반 포괄적 인 좌표를 확인하십시오. 다른 회원 응용 프로그램에서 점수는 교환할 수 없습니다; hit은 단백질이 기능 부족한다는 것을 증명하지 않습니다.
timeout 후 중복 제출을 피하십시오. 알려진 작업 ID를 먼저 복구하십시오. 현지 요청에 대한 취소는 제출 된 원격 작업을 취소하지 않습니다. 제출, 상태 및 결과 매개 변수 참조.
TCR 및 BCR 증거 찾기 IEDB
Main에 대한 IEDB 및 search_tcrs 또는 search_bcrs를 적어도 하나의 생물학적 또는 증거 필터를 요청할 수 있습니다. 혼자서 질은 충분합니다. 팟캐스트 순서;에 대 한 sequence 사용 chain1_cdr3와 chain2_cdr3 필터 수용체 CDR3 순서. 이 공개 검색은 API 키가 필요하지 않습니다.
receptor-group ID, 체인을 유지, assay ID 및 소스 출판보고. 호스트 및 outcome 필터는 집단 그룹에 적용되며 다른 실험에 의해 만족할 수 있습니다. 해당 조건은 동일한 분석실험에서 발생하기 위하여, 해당 분석실험 가동으로 보고된 assay ID를 따르고 필요한 필터를 적용하십시오. Pagination 덮개 수용체 그룹은, 각 끼워넣어진 수출의 완전성 아닙니다. 이 기록은 수용체 바인딩의 예측이 아닌, 증거 retrieval입니다. IEDB 모수.
PDC과 함께 암 유전체학 발견
Settings → Connectors에서 PDC을 활성화하십시오. 대중적인 메타데이터 API는 API 열쇠를 필요로 합니다. 연구 및 버전을 찾기 위해 사용, assay와 견본 조사, 지도 상자 표본 aliquot 협회를 검사하고 단백질 회의 보고서와 같은 quantitative 파일을 목록으로 만드십시오. 처리/outcome 자료 또는 다운로드 파일을 반환하지 않습니다.
PDC000127과 같은 연구 접근을 시작하거나 연구 식별자 및 버전 이름을 검색하십시오. PDC 키워드 매칭은 임상 질병 필터가 아닙니다. 연구를 검색한 다음 study_id UUID를 사용하여 후속 통화를 핀으로 변환하십시오. pdc_study_id 최신 버전을 선택합니다. 이러한 선택자 중 하나를 정확히 제공합니다.
견본 명부를 위해, 업스트림 pagination는 케이스를 조사합니다; 표본과 aliquots를 확장하는 것은 케이스 한계 보다는 더 줄을 생성할 수 있습니다. 기본 - 한국어 모드 페이지는 협회를 받고 1,000-association 업스트림 캡을 가지고 있습니다. 마지막 로컬 페이지는 해당 캡이 도달했을 때 완성도를 증명하지 않습니다. PDC ID를 유지하고 외부 GDC 참조를 별도로 지명하십시오. 파일 목록에는 이름, 바이트 크기, MD5 값 및 저장 경로가 포함됩니다. 등록된 경로는 공인된 다운로드 URL이 아닙니다.
PDC 작업 및 질 참조. 소스를 결합하기 전에, 연구 버전, 분석실험, 견본 정체성 및 각 근원의 접근 및 인용 필요조건을 검사하십시오.
인구 별 LD 확인
Settings → Connectors에서 **한국어 (Korean)**을 활성화하십시오. Ensembl LD 도구는 키가없는 공공 API를 사용합니다. ensembl_ld_pairwise에 대한 두 가지 변형 ID를 공급, 또는 ensembl_ld_proxies에 대한 하나, 1000GENOMES:phase_3:KHV와 같은 전체 인구 이름과 함께. 도구는 인구 또는 인퍼 ancestry를 발견하지 않습니다; 연구에 적합한 참조 인구를 선택하십시오.
쌍방향 결과 보고서 r2 및 D′. r2 ≥ 0.8 및 500 kb 총 창에 프록시 쿼리 기본, 어느 쪽에 250 kb. max_records는 정렬 후 반환된 목록을 캡, 업스트림 작업이 아닙니다. 결과를 가진 인구와 retrieval metadata 유지; 이 엔드포인트는 참고 집합 또는 Ensembl 방출을 보고하지 않습니다. 빈 결과가 반환되지 않는 자격이 없는 데이터, 제로 LD. 높은 LD는 카시니즘과 기능적인 평등도 설치하지 않습니다. 쌍방향 필드 및 프록시 필드을 참조하십시오.
표본, 표정 및 집합 상황에 보존하십시오
| 조회 | v1.0.2에서의 해석 |
|---|---|
arrayexpress_get_experiment_samples | samples 경로에 의해 분류 된 최초의 SDRF 파일에서 관계 행을 포함합니다. n_rows_total / n_rows_returned 줄을 곱합니다; n_samples / n_samples_returned 구별 식별자, 선호 표본 이름, 다음 근원 이름을 진행하세요. 그들은 독립적 인 생물학 복제 수 없습니다. 식별자는 샘플 수를 만들 수 있습니다. null을 진행하세요. 빈 파일 또는 no_sdrf 응답은 실험이 샘플이 없다는 것을 설정하지 않습니다. |
metabolights_get_studies 으로 include_samples | 반환된 사용 headers 수출할 때 순서 sample_table을 진행하세요. 반복된 열 이름은 독특합니다 #2, #3, ... 본래의 이름을 과잉하지 않고 suffixes. 모든 열을 유지; 짧은 행의 빈 문자열은 메타데이터가 누락됩니다. 【특전】 rows_truncated. |
bgee_expression_calls | 뚱 베어 anatomical_entity_id/name 함께하기 cell_type_id/name을 진행하세요. 누락된 세포 유형은 입니다 null, 부정적인 표식이 아닌. 표현 상태, 품질 및 상태를 함께 유지하십시오. |
| dbSNP 변형 조회 | 각 배치의 유지 assembly, assembly_full, seq_id, 위치 및 alleles. 1개의 순서는 1개의 집합과 관련될 수 있습니다; 그 협회를 붕괴하거나 자동 Liftover로 첫 번째 배치를 사용하지 마십시오. |
이 수정은 반환된 증거가 읽을 수 있는 방법을 변경합니다. 및 다운로드 가능한 레지스트리는 이제 v0.31.1 :을 체크 아웃하여 이전의 저장된 응답을 새로운 모습으로 비교하십시오.
OpenAlex 자격 증명
v1.0.2는 현재 세션에서 거절한 OpenAlex 인증 정보 요청을 기억하여 반복하지 않습니다. 나중에 이 소스가 필요하면 다음 설정에서 직접 구성하세요: Settings → Connectors → Literature Graph → Manage credentials → OpenAlex 그런 다음 원하는 조회를 다시 실행합니다. 요청을 거절해도 키가 등록되거나 접근 권한·사용량이 보장되지는 않습니다.
새 데이터 소스를 연결하고 결과의 의미 확인하기
설정 Settings → Connectors에서 아래 항목을 찾아 사용을 허용하세요. 대상은 Main 또는 사용할 Specialist입니다. HGNC, PubTator 3, DGIdb, RNAcentral은 기존 항목 안의 도구입니다. Orphadata 는 별도 항목이며 기본적으로 꺼져 있습니다. 이 새 도구들은 별도 API 키 없이 공개 엔드포인트를 이용합니다. 같은 항목의 다른 도구에는 별도의 인증 요건이 있을 수 있습니다.
| 데이터 소스 | 설정 항목 | 요청 및 확인 사항 |
|---|---|---|
| HGNC | Genes & Ontologies | 승인된 인간 유전자 기호를 조회하거나 정확히 일치하는 별칭을 찾습니다. 후보가 여러 개면 모두 유지하고 승인·철회 상태를 확인한 뒤 유전자를 선택하세요. |
| PubTator 3 | PubMed | PMID로 주석을 가져오거나 개체·관계를 검색합니다. 주석 조회는 제목과 초록을 대상으로 하며, 원시 텍스트를 제출하는 기능이 아닙니다. 주장이 전문에서 뒷받침된다는 증거도 아닙니다. |
| DGIdb | Clinical Genomics | 유전자명이나 약물명으로 조회하고 출처와 문헌을 보존하며 반환된 커서를 따라가세요. 약물·유전자 상호작용은 치료 권고가 아닙니다. |
| RNAcentral | RNA | URS 등록번호를 조회한 뒤 전문 데이터베이스의 교차 참조를 페이지별로 확인합니다. 분류군, 서열 MD5, 등록번호 버전을 보존하세요. |
| Orphadata | Orphadata | 먼저 접근을 켠 뒤 ORPHAcode로 유전자 또는 HPO 표현형을 조회하세요. 연관 유형과 빈도 범주를 보존해야 하며, 이를 개별 환자의 확률로 해석하면 안 됩니다. |
정확한 호출: HGNC, PubTator, DGIdb, RNAcentral, Orphadata.
암 메타데이터 연결과 변이 주석
- PDC: 다음 작업으로 공개 인구통계·진단 필드를 요청합니다:
pdc_list_clinical. 최신 버전에는pdc_study_id, 고정된 버전에는study_id를 사용합니다. 누락·비식별 처리 값과 외부 참조의 출처를 유지하세요. PDC와 GDC UUID는 서로 바꿔 쓸 수 없습니다. - GDC: 파일 필터:
case_ids,sample_types및workflow_types. 증례 하나로 모든 파일을 합치지 말고 파일별 검체, 분주 검체, 종양·정상 워크플로의 연결을 보존하세요. 같은 필드 안은 OR, 필드 사이는 AND입니다. 메타데이터 접근은 제한 파일의 다운로드 권한을 부여하지 않습니다. - Ensembl VEP: 단독으로 지정할 인수:
hgvs_notation. 함께 사용할 수 없는 인수:variant_id,region,allele또는allele_orientation. 반환된 어셈블리, 전사체 버전, 결과 잘림 표시를 보존하세요. 입력 참조 버전은 그대로 전달되며 검증되지 않습니다.matched도 버전 일치를 증명하지 않습니다. 이는 변이 영향 주석이며 임상 해석이나 게놈 좌표 변환이 아닙니다. - Clinical Trials: 작업
get_trial_results로 공개된 측정값, 분모, 통계 분석, 이상반응을 조회합니다. 군 ID는 동일한 결과 모듈·평가변수 안에서만 연결하세요. 결과 누락은 사건 0건이나 치료 효과가 없다는 뜻이 아닙니다.
참고: PDC 필드, GDC 필터, VEP 모드 및 공개된 임상시험 결과.
영상·경로·지질·암 모델 데이터
Settings → Connectors에서 대상을 켜고 Main에 제공하세요. TCIA, KEGG, RxNorm / RxNav, DailyMed, BioSamples, WikiPathways는 독립 항목이며 기본적으로 꺼져 있습니다. 아래 공개 서비스에는 별도 MCP 서버나 API key가 필요 없지만, 활성화가 데이터 라이선스나 제한 데이터 접근 권한을 부여하지는 않습니다.
| 항목 | 요청할 내용 | 보존할 정보 |
|---|---|---|
| TCIA | 컬렉션 및 기존 DICOM series UID 메타데이터 | 라이선스, 접근·다운로드 조건. 링크는 영상 파일이 아닌 Data Retriever 매니페스트일 수 있습니다. |
| KEGG | 경로·KO·화합물·반응 검색 및 종을 지정한 유전자 매핑 | 학술 이용 자격, 라이선스, 일대다 대응, 잘림 정보. 유전자 집합 풍부도 분석이 아닙니다. |
| Chemistry → LIPID MAPS / UniChem | 정확한 LMID·PubChem CID 조회 및 InChIKey·ChEMBL ID 매핑 | 이름은 먼저 PubChem으로 확인하고 서로 다른 결과와 출처를 보존합니다. 유사성 검색이 아닙니다. |
| Structures & Interactions → OmniPath | 인간의 표준 UniProt accession으로 상류·하류 조절 조회 | 방향, 활성화·억제의 상충 증거, 복합체 ID. 집계된 관계는 조직 특이적 인과 증거가 아닙니다. |
| Structures & Interactions → PDBe / PDB | 실험 구조 검증 통계 또는 등록된 단백질 사슬 유사성 조회 | 실험 방법과 결측값. 저자 사슬 ID가 아닌 label_asym_id를 사용합니다. 실제 구조 정렬이나 RMSD 계산이 아닙니다. |
| Cancer Models → DepMap / CCLE | 세포주를 ModelID로 확인한 후 유전자·화합물 프로파일 조회 | 데이터 버전과 척도. Chronos는 확률이 아니고 PRISM AUC는 IC50가 아닙니다. RNA는 log2(TPM+1), 복제수는 배수성 대비 상대값입니다. |
| RxNorm / RxNav · DailyMed | 약물명을 RxCUI로 확인하고 SPL 라벨 식별 정보와 이력 조회 | 모호한 일치를 보존합니다. 이름 일치는 임상적 동등성을, DailyMed 수록은 FDA 승인을 뜻하지 않습니다. |
| BioSamples · WikiPathways | 시료 또는 경로 메타데이터와 개정 정보 | accession, 종, 날짜, 증거 링크. 연결된 시료 파일이나 경로 그래프를 다운로드하지 않습니다. |
정확한 입력과 페이지 처리는 작업 참조를 확인하세요. 빈 값과 잘림 표시를 보존하고 제한된 결과를 전체 데이터베이스로 간주하지 마세요.
공식 연구 데이터와 파일 목록 검색
Settings → Connectors에서 필요한 항목만 활성화합니다. Europe PMC, Research Datasets, ChEA3, bioDBnet, CTD는 API 키가 필수가 아닙니다. 검색어, 식별자 또는 유전자 목록은 각 서비스로 전송됩니다. 연결 설정.
| 목적 | 항목과 결과 | 다음 단계 |
|---|---|---|
| 생물의학 문헌 직접 검색 | Europe PMC의 기록, 사용 가능한 초록 및 다음 페이지 커서 | 식별자를 보존하고 다음 페이지 조회. 전문 링크는 취득한 전문이 아님 |
| 조사 또는 임상 데모 파일 검색 | Research Datasets의 NHANES 주기·설명과 고정 버전 MIMIC/eICU 데모 | 공식 다운로드 전 주기, 버전, 라이선스, 설명 확인 |
| 데이터 접근 조건 확인 | Research Datasets의 NHANES, CHARLS, CHNS, SEER, MIMIC, eICU, FAERS, GBD 안내 | 필요한 등록, 교육 또는 내보내기를 제공자에서 진행 |
| 공개 보고서 검색 | Drug Regulatory, CTD, Cellosaurus의 공식 파일 위치 | 현재 페이지, 버전, 조건 확인. 자동 다운로드나 가져오기가 아님 |
| 유전자 식별자 정리 | Genes & Ontologies의 HGNC 필드·파일 및 bioDBnet의 변환·상동 매핑 | 지원 형식을 먼저 확인하고 모호함, 미매핑, 일대다 결과 보존 |
| 후보 조절인자 순위 | ChEA3의 라이브러리별 순위와 GMT 링크 | 가설로 해석. 다운로드 GMT와 온라인 결과의 라이브러리가 다를 수 있음 |
| 세포주 근거 확인 | Cellosaurus의 RDF, 제한된 SPARQL 및 STR 유사도 | accession과 마커 설정 보존. 유사도만으로 시료 정체성을 인증하지 못함 |
목록은 공식 URL과 메타데이터를 반환하며 파일이나 분석 DB를 자동으로 만들지 않습니다. NHANES에는 올바른 조사 설계와 가중치가 필요합니다. MIMIC/eICU 데모 권한은 전체 데이터 권한이 아니며 FAERS 보고서는 발생률이 아닙니다. 세부 필드는 작업 참조를 확인하세요.