Trouver des données omiques publiques et construire un inventaire de fichiers
Commencez par une adhésion connue ou un sujet de recherche, inspectez les métadonnées publiques et enregistrez un inventaire de fichiers avec l'emplacement des sources et les comptes de vérification disponibles. Les exemples ci-dessous produisent des inventaires; télécharger et analyser les données sont des tâches distinctes.
Avant de commencer, suivez Bases de données scientifiques pour activer les connecteurs requis. Utilisez un modèle connecté et un Environnement d'exécution Notebook disponible.
1. Résoudre une course connue et inspecter ses fichiers
- Activez Omics Archives sous Settings → Connectors. Fournir une adhésion publique ENA/INSDC à
ena_search_runs, comme une étude PRJ ou une RRS. Un identifiant GEOGSEdoit d'abord être lié à son étude INSDC; Les mots clés ne sont pas acceptés. - Inspecter
run_accession, organisme, stratégie/mise en page de la bibliothèque ettruncated. Le maximum est de 1,000. Il n'y a pas de jeton de compensation ou de continuation; limiter l'adhésion si la réponse est tronquée. - Pass one renvoyé run à
ena_get_run_files. Vérifiezfound,fastq_availableet chaque entrée dansfastq_files. L'inventaire fournit URL, taille de fichier compressé et en amont MD5; il ne télécharge pas les fichiers ou ne vérifie pas leur contenu. - Avant un téléchargement séparé, vérifiez le stockage et conservez le manifeste. Vérifier les octets téléchargés par rapport au total de contrôle indiqué. Une bibliothèque jumelée n'a pas besoin d'avoir exactement deux fichiers; ne pas déduire l'identité de son compagnon de lecture à partir de
file_index.
Exemple pratique Construire un manifeste de fichiers pour SRR037073
Cet exemple v0.31.1 utilise Codex subscription et Omics Archives Connector activés. Ouvrez une session avec un exécut temps Notebook disponible, puis envoyez :
Use Omics Archives through Session Notebook. Load its connector instructions.
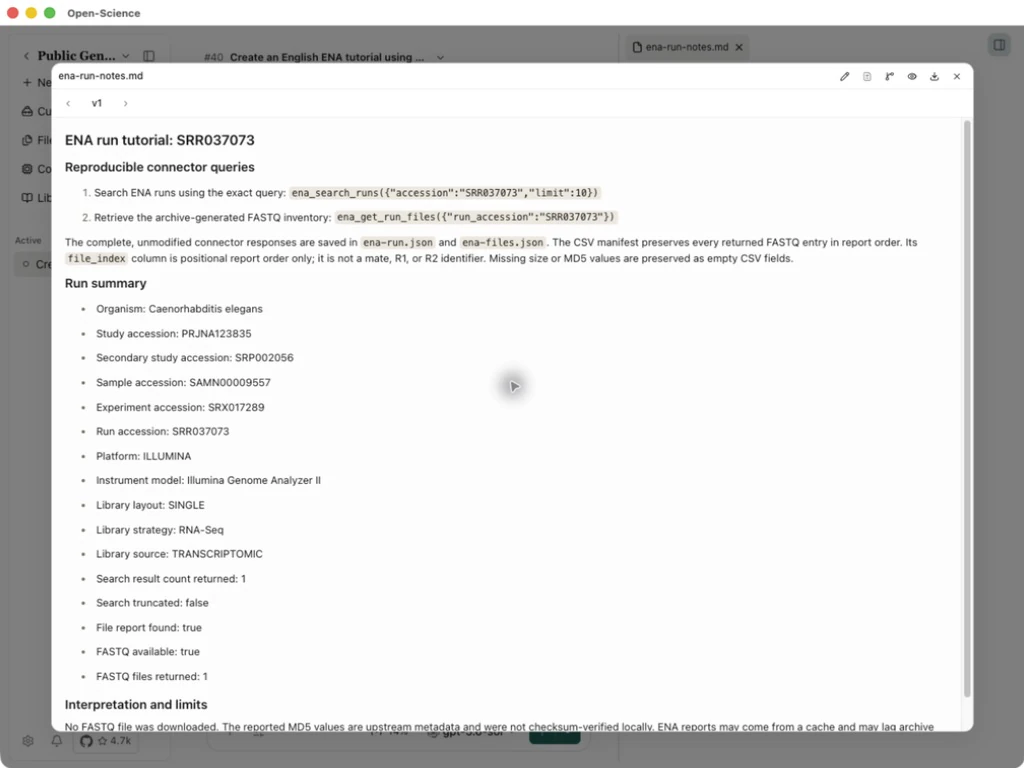
Call ena_search_runs with accession SRR037073 and limit 10, then
ena_get_run_files with run_accession SRR037073. Do not download FASTQ files.
Save the complete responses as ena-run.json and ena-files.json.
Save every returned file entry as ena-fastq-manifest.csv with columns
file_index,url,size_bytes,md5. Save ena-run-notes.md with the exact inputs,
run identity, completeness flags and download limits. Keep everything in
English. Report actual errors or empty results; do not invent data.
Ouvrez les notes générées. La recherche réelle a renvoyé Exécution de 1, Caenorhabditis elegans, étude PRJNA123835, RNA-Seq, SINGLE, avec truncated: false. Confirmez l'organisme et la mise en page avant d'utiliser ses fichiers.
Ouvrez le CSV et comparez-le avec ena-files.json. Cette exécution a found: true, fastq_available: true et Fichier 1, taille octets 25,154,397. Le manifeste conserve son URL FTP et en amont MD5. Copier la valeur complète du fichier téléchargeable si une colonne de prévisualisation est coupée.
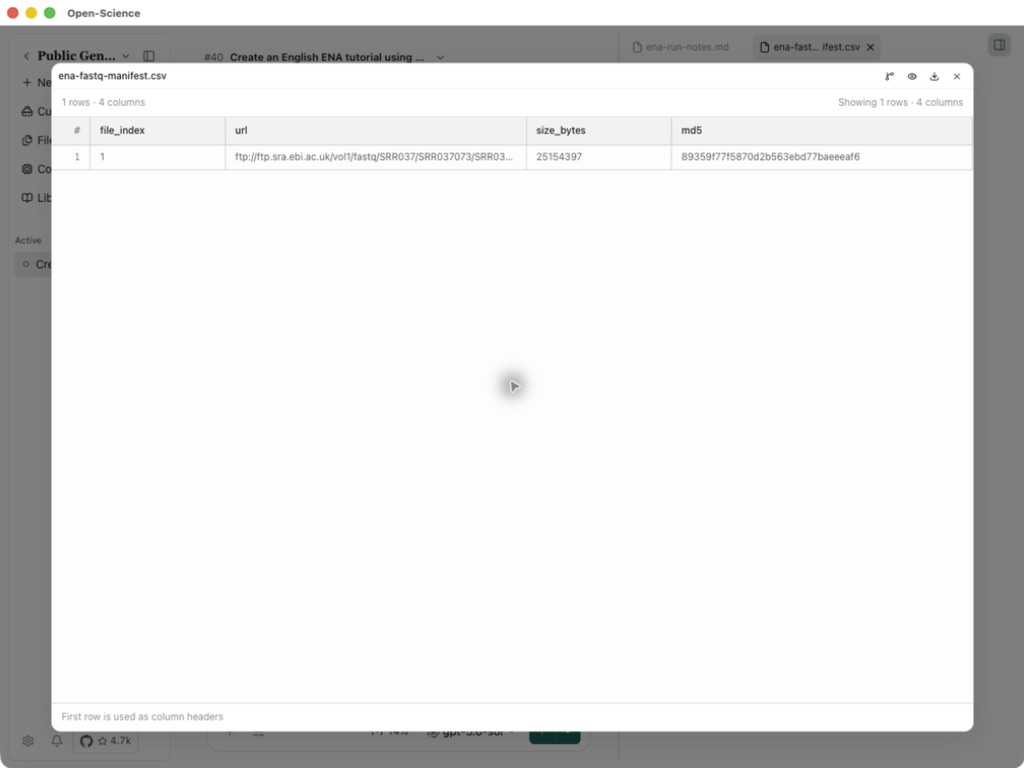
Demandes de renseignements · manifeste FASTQ · Exécuter la réponse · Réponse du fichier
Les deux requêtes et la génération du manifeste ont abouti. Aucun fichier FASTQ n’a été téléchargé ni vérifié par somme de contrôle dans cet exemple. Le téléchargement constitue une étape distincte. Paramètres exacts
2. Découvrez les runs par sujet et inspectez les fichiers de projet
Utilisez ena_query_runs lorsque vous avez un sujet de recherche mais pas d'adhésion. Il combine organismes, stratégie de bibliothèque et filtres à mots clés avec ET. Au moins un filtre est requis; tax_id comprend les taxons descendants. La limite par défaut est 100 et le maximum est 1,000. Une réponse tronquée n'a pas de curseur de suite : rétrécir la requête au lieu de traiter le nombre retourné comme le total de données.
Exemple pratique Découvrez cinq RNA-Seq humains et inspectez un inventaire de fichiers ENA et PRIDE
- Activez Omics Archives dans Settings → Connectors, puis ouvrez une session avec un modèle connecté et un exécuteur Notebook disponible. Cet exemple utilise Codex subscription.
- Utilisez l'invite ci-dessous pour demander des métadonnées seulement. La requête ENA et le projet PRIDE sont des exemples distincts; ils ne sont pas des échantillons appariés d'une étude.
- Ouvrez
ena-discovery.jsonet inspectez la requête, l'organisme, lancez des accessions ettruncatedavant de sélectionner les fichiers.
Use Omics Archives through Session Notebook. Query ena_query_runs with
tax_id 9606, library_strategy "RNA-Seq", keyword "breast" and limit 5.
For the first returned run, call both ena_get_run_files and
ena_get_submitted_files. Separately call pride_get_project_files for
PXD000001, page 0, page_size 5; fetch its next_page once if present.
Save the exact requests and responses as ena-discovery.json,
ena-file-inventory.json and pride-file-pages.json. Save a combined
omics-file-inventory.csv and omics-discovery-notes.md. Keep generated
FASTQ, original submitted files and PRIDE records distinct. Preserve
every supplied location, size and checksum; do not infer missing values
or checksum algorithms. State query limits and pagination. Do not download
data files. Keep everything in English and report actual empty results.
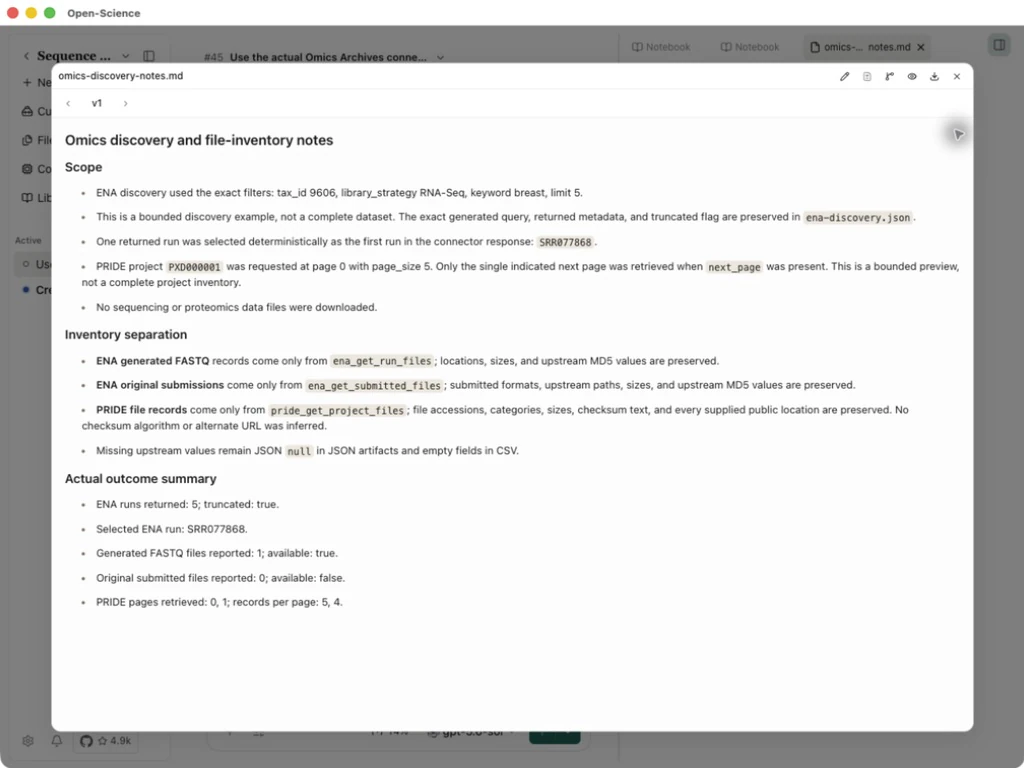
- Comparez les deux inventaires pour l'exécution ENA sélectionnée. Dans cet exemple, la requête renvoie 5 tourne avec
truncated: true. La première sortie, SRR077868, a Archives 1 FASTQ, taille octets 462,508,712 et un MD5 en amont. Son inventaire de présentation originale afound: truemaissubmitted_available: falseet Fichiers 0. Il n'est donc pas nécessaire de fournir les deux inventaires. - Inspectez les pages PRIDE. PXD000001 retourne Enregistrements 5 à la page 0 et 4 à la page 1, avec
api_total: 9etnext_page: nullfinal. Le CSV combiné a Lignes 19 parce que chacun des neuf fichiers PRIDE fournit deux emplacements, à côté de la ligne ENA FASTQ. Compter les adhésions de fichiers séparément des lieux de téléchargement.
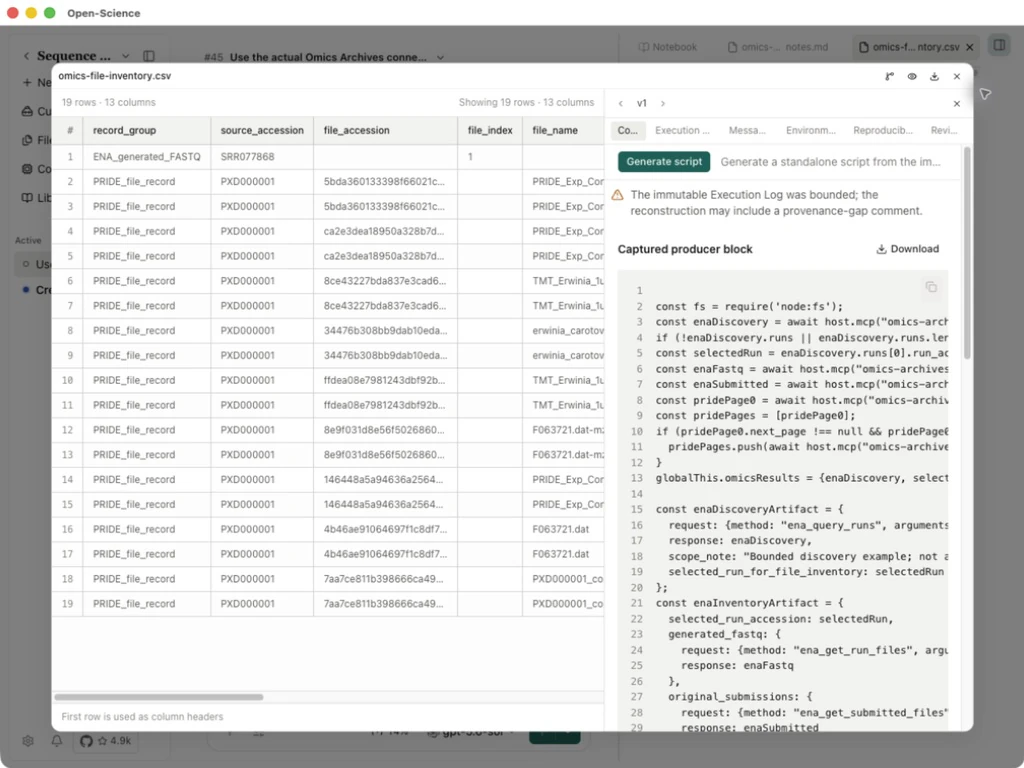
Demandes de renseignements · Inventaire combiné · Découverte de l'ENA · Inventaires des fichiers ENA · Pages PRIDE
La sortie est un inventaire de fichiers, non téléchargé séquençage ou données protéomiques. Archive FASTQ et les soumissions originales telles que BAM/CRAM sont des produits différents. Gardez le chemin FTP original d'ENA littéralement, y compris tout caractère #. Pour PRIDE, utilisez next_page et les métadonnées retournées; api_total peut être absent pour d'autres projets, et le texte de checksum n'identifie pas toujours son algorithme. Avant un téléchargement séparé, sélectionnez le format requis, vérifiez le stockage et vérifiez les octets lorsqu'un somme de contrôle en amont est disponible. Voir le Référence de l'opération pour les entrées exactes.