Encuentre datos de omics públicos y construya un inventario de archivos
Comience con una adhesión conocida o un tema de investigación, inspeccione metadatos de ejecución pública y guarde un inventario de archivos con las ubicaciones de fuentes y los cheques disponibles. Los ejemplos que figuran a continuación producen inventarios; descargar y analizar los datos son tareas separadas.
Antes de comenzar, siga Bases de datos científicos para habilitar los conectores necesarios. Utilice un modelo conectado y un Entorno de ejecución de Notebook disponible.
1. Resolver una ejecución conocida e inspeccionar sus archivos
- Activar Omics Archives bajo Settings → Connectors. Suministrar una adhesión pública a
ena_search_runsen el ENA/INSDC, como un estudio de PRJ o una carrera de SRR. Un identificador GEOGSEdebe vincularse primero a su estudio INSDC; Las palabras clave no son aceptadas. - Inspeccione
run_accession, organismo, estrategia de biblioteca/función ytruncated. El máximo es que 1,000 corre. No hay señal de compensación o continuación; estrechar la adhesión si la respuesta es truncada. - Pase una vuelta a
ena_get_run_files. Compruebefound,fastq_availabley cada entrada enfastq_files. El inventario proporciona URL, tamaño de archivo comprimido y MD5 de corriente avanzada; no descarga archivos ni verifica su contenido. - Antes de una descarga separada, verifique el almacenamiento y mantenga el manifiesto. Verifique los bytes descargados contra la suma de comprobación lista. Una biblioteca pareada no necesita tener exactamente dos archivos; no inferir la identidad de los compañeros de lectura de
file_index.
Ejemplo práctico Construir un manifiesto de archivo para SRR037073
Este ejemplo v0.31.1 utiliza Codex subscription y el Omics Archives Connector habilitado. Abra una sesión con un tiempo de ejecución Notebook disponible, y luego envíe:
Use Omics Archives through Session Notebook. Load its connector instructions.
Call ena_search_runs with accession SRR037073 and limit 10, then
ena_get_run_files with run_accession SRR037073. Do not download FASTQ files.
Save the complete responses as ena-run.json and ena-files.json.
Save every returned file entry as ena-fastq-manifest.csv with columns
file_index,url,size_bytes,md5. Save ena-run-notes.md with the exact inputs,
run identity, completeness flags and download limits. Keep everything in
English. Report actual errors or empty results; do not invent data.
Abra las notas generadas. La búsqueda real devolvió 1 run, Caenorhabditis elegans, estudio PRJNA123835, RNA-Seq, SINGLE, con truncated: false. Confirme el organismo y el diseño antes de usar sus archivos.
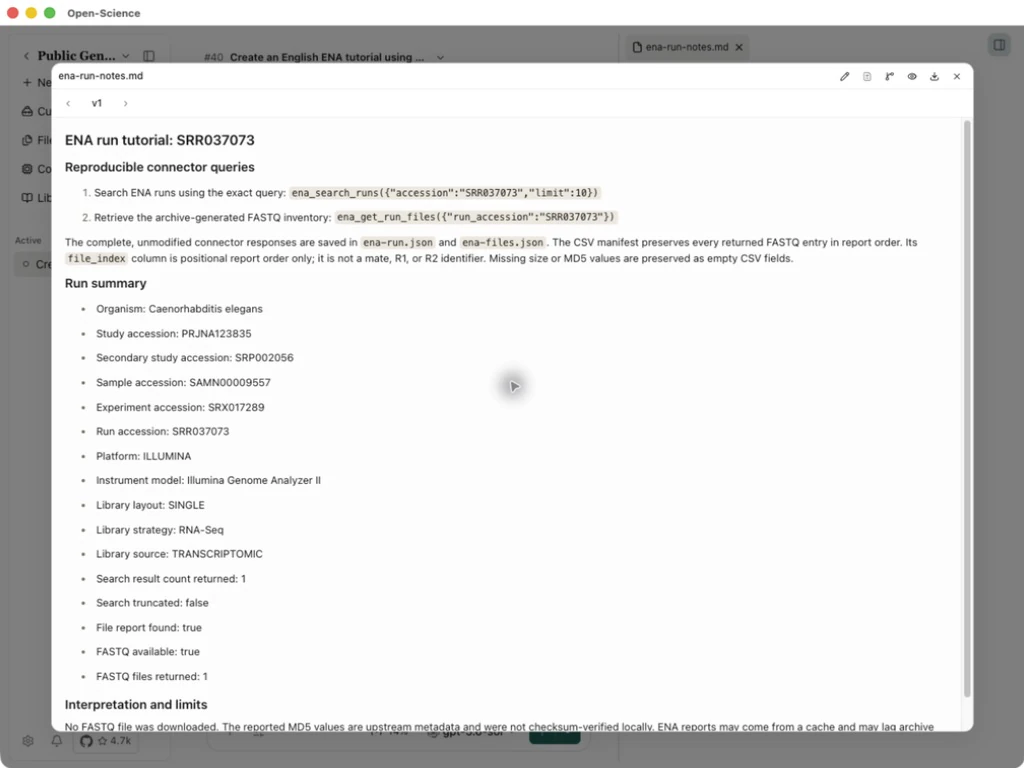
Abra el CSV y compare con ena-files.json. Esta carrera tiene found: true, fastq_available: true y Archivo 1, tamaño bytes 25,154,397. El manifiesto conserva su URL FTP y MD5 de corriente. Copie el valor completo del archivo descargable si se corta una columna de vista previa.
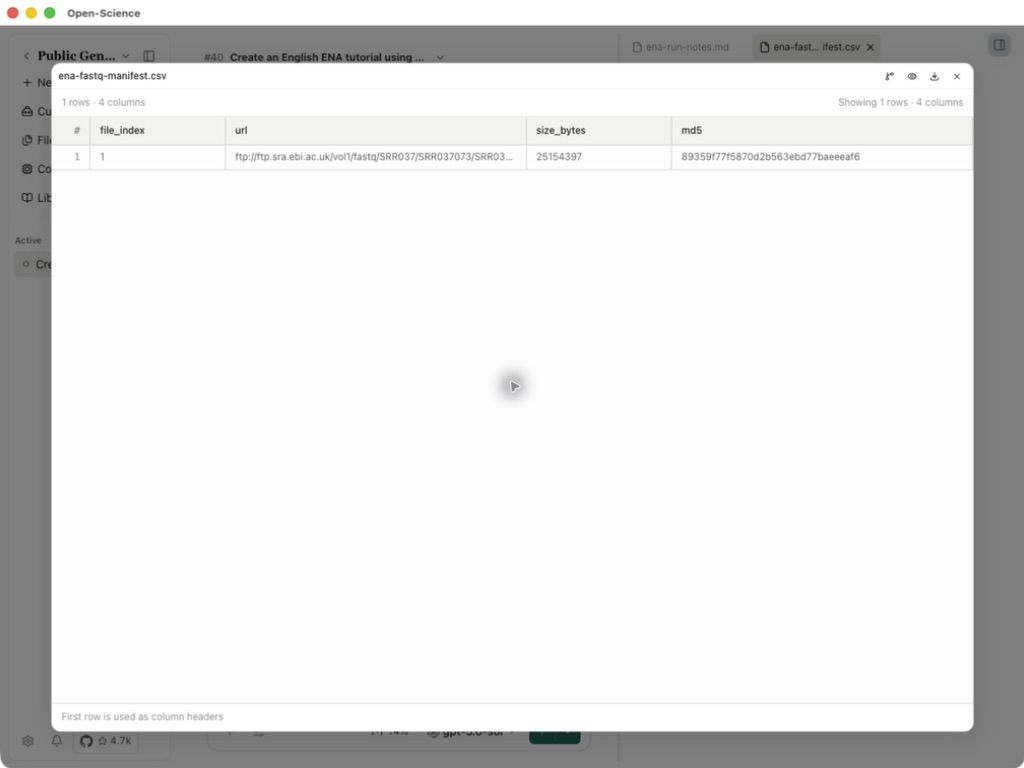
Notas de consulta · FASTQ manifest · Respuesta de ejecución · Respuesta del archivo
Las dos consultas y la generación del manifiesto se completaron. En este ejemplo no se descargó ningún archivo FASTQ ni se verificó su suma de comprobación. La descarga es un paso independiente. Parámetros exactos
2. Descubra las carreras por tema e inspeccionar los archivos de proyecto
Use ena_query_runs cuando tenga un tema de investigación pero no se adhiera. Combina organismos, estrategia de biblioteca y filtros de palabras clave con AND. Se requiere al menos un filtro; tax_id incluye taxa descendente. El límite predeterminado es 100 y el máximo es 1,000. Una respuesta truncada no tiene cursor de continuación: estrechar la consulta en lugar de tratar el recuento devuelto como el total de conjunto de datos.
Ejemplo práctico Descubra cinco carreras de ARN-Seq humano e inspeccione un inventario de archivos ENA y PRIDE
- Habilitar Omics Archives en Settings → Connectors, luego abrir una sesión con un modelo conectado y un tiempo de ejecución Notebook. Este ejemplo utiliza Codex subscription.
- Utilice el siguiente mensaje para solicitar metadatos solamente. El proyecto ENA query y PRIDE son ejemplos separados; no son muestras de un estudio.
- Abrir
ena-discovery.jsone inspeccionar la consulta, organismo, ejecutar adhesiones ytruncatedantes de seleccionar archivos.
Use Omics Archives through Session Notebook. Query ena_query_runs with
tax_id 9606, library_strategy "RNA-Seq", keyword "breast" and limit 5.
For the first returned run, call both ena_get_run_files and
ena_get_submitted_files. Separately call pride_get_project_files for
PXD000001, page 0, page_size 5; fetch its next_page once if present.
Save the exact requests and responses as ena-discovery.json,
ena-file-inventory.json and pride-file-pages.json. Save a combined
omics-file-inventory.csv and omics-discovery-notes.md. Keep generated
FASTQ, original submitted files and PRIDE records distinct. Preserve
every supplied location, size and checksum; do not infer missing values
or checksum algorithms. State query limits and pagination. Do not download
data files. Keep everything in English and report actual empty results.
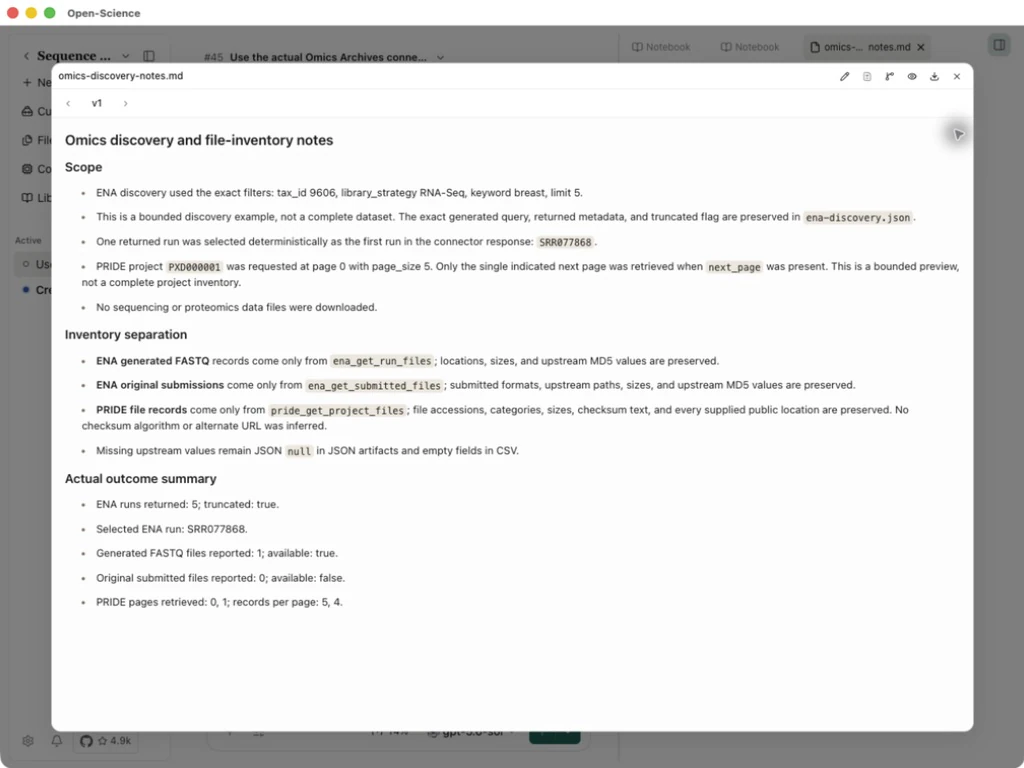
- Compare ambos inventarios para la carrera de ENA seleccionada. En este ejemplo, la consulta devuelve 5 corre con
truncated: true. La primera carrera, SRR077868, tiene Archivo 1 FASTQ, tamaño bytes 462,508,712, y un MD5 upstream. Su inventario original tienefound: trueperosubmitted_available: falsey Archivo 0. Por lo tanto, un funcionamiento existente no necesita proporcionar ambos inventarios. - Inspeccione las páginas del PRIDE. PXD000001 devuelve Registros 5 en la página 0 y 4 en la página 1, con
api_total: 9y elnext_page: nullfinal. El CSV combinado tiene Renglones 19 porque cada uno de los nueve archivos PRIDE suministra dos ubicaciones, junto con la única fila ENA FASTQ. Cuenta las adhesiones de archivos separadamente de las ubicaciones de descarga.
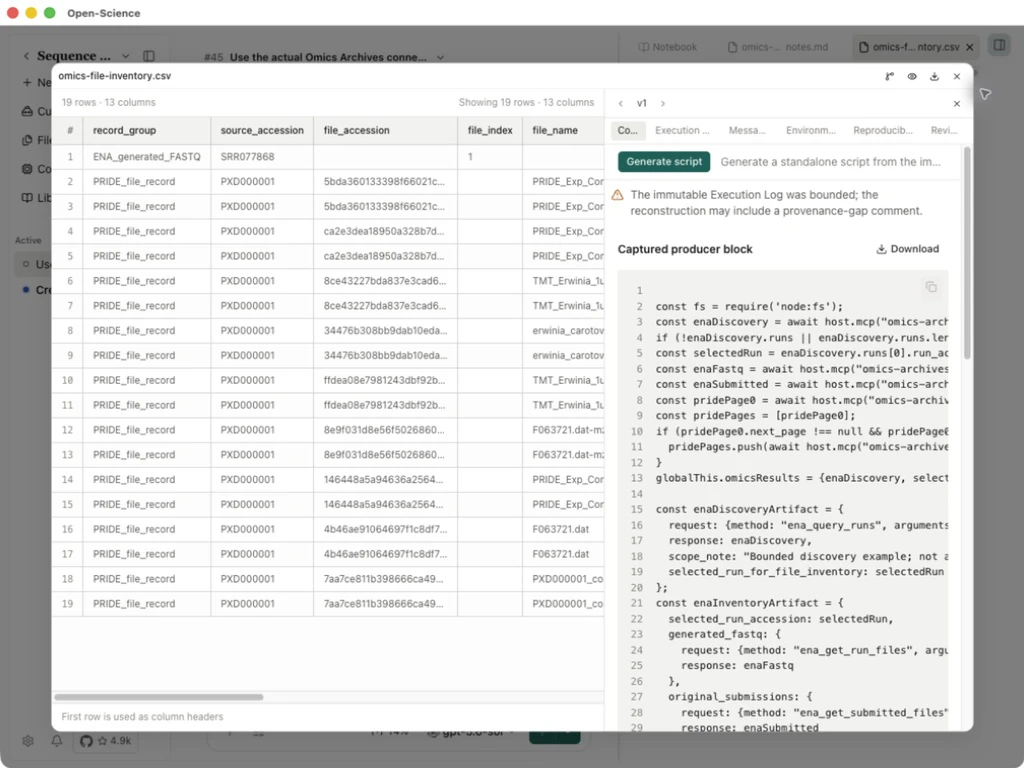
Notas de consulta · Inventario combinado · ENA discovery · Inventarios de archivos ENA · Páginas primitivas
La salida es un inventario de archivos, no se descargan datos de secuenciación o proteómica. Archivos FASTQ y presentaciones originales como BAM/CRAM son diferentes productos. Mantenga la ruta FTP original de ENA literalmente, incluyendo cualquier personaje #. Para PRIDE, use next_page y los metadatos devueltos; api_total puede estar ausente para otros proyectos, y el texto de checksum no siempre identifica su algoritmo. Antes de una descarga separada, seleccione el formato necesario, verifique el almacenamiento y verifique bytes cuando esté disponible una suma de verificación de corriente. Vea el referencia a la operación para entradas exactas.