查找公共组学数据并整理文件清单
从已知登录号或研究主题出发,检查公开测序运行的元数据,保存包含来源地址及可用校验值的文件清单。下面的案例产出文件清单,下载数据和分析数据是后续独立任务。
开始前,按科学数据库启用所需 Connector,选择已连接的模型,并确保 Notebook 运行环境可用。
1. 从已知运行编号获取文件清单
- 在 Settings → Connectors 中启用 Omics Archives。向
ena_search_runs提供公开的 ENA/INSDC 登录号,如 PRJ 项目或 SRR 运行。GEO 的GSE标识需要先找到关联的 INSDC 项目;本工具不接受关键词搜索。 - 检查
run_accession、物种、文库策略与布局,以及truncated。最多返回 1,000 个运行,没有偏移量或续页标记;结果截断时应缩小登录号范围。 - 将返回的某个运行传给
ena_get_run_files,检查found、fastq_available和全部fastq_files条目。清单提供地址、压缩文件大小和上游 MD5,本身不会下载或校验文件。 - 单独下载前检查存储空间并保存清单,下载后按列出的校验值核对文件。双端文库未必恰有两个文件,不能把
file_index当作 R1/R2 标记。
案例演示 生成 SRR037073 的文件清单
本例在 v0.31.1 使用 Codex subscription 和已启用的 Omics Archives Connector。打开 Notebook 运行环境可用的会话,发送:
Use Omics Archives through Session Notebook. Load its connector instructions.
Call ena_search_runs with accession SRR037073 and limit 10, then
ena_get_run_files with run_accession SRR037073. Do not download FASTQ files.
Save the complete responses as ena-run.json and ena-files.json.
Save every returned file entry as ena-fastq-manifest.csv with columns
file_index,url,size_bytes,md5. Save ena-run-notes.md with the exact inputs,
run identity, completeness flags and download limits. Keep everything in
English. Report actual errors or empty results; do not invent data.
打开生成的说明。本次实际返回 1 个运行,物种为 Caenorhabditis elegans,项目为 PRJNA123835,文库为 RNA-Seq、SINGLE,且 truncated: false。使用文件前,先核对物种和文库布局。
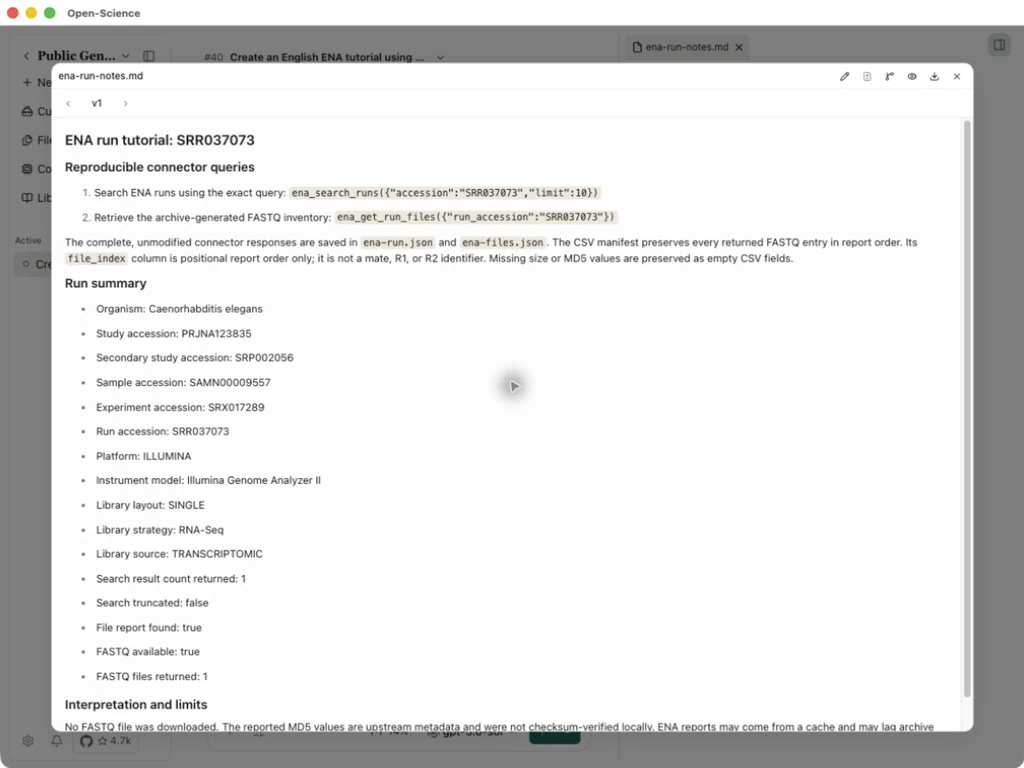
打开 CSV 并与 ena-files.json 对照。本次 found: true、fastq_available: true,返回 1 个文件,大小为 25,154,397 字节。清单保留 FTP 地址和上游 MD5;预览列显示不全时,从下载文件中复制完整值。
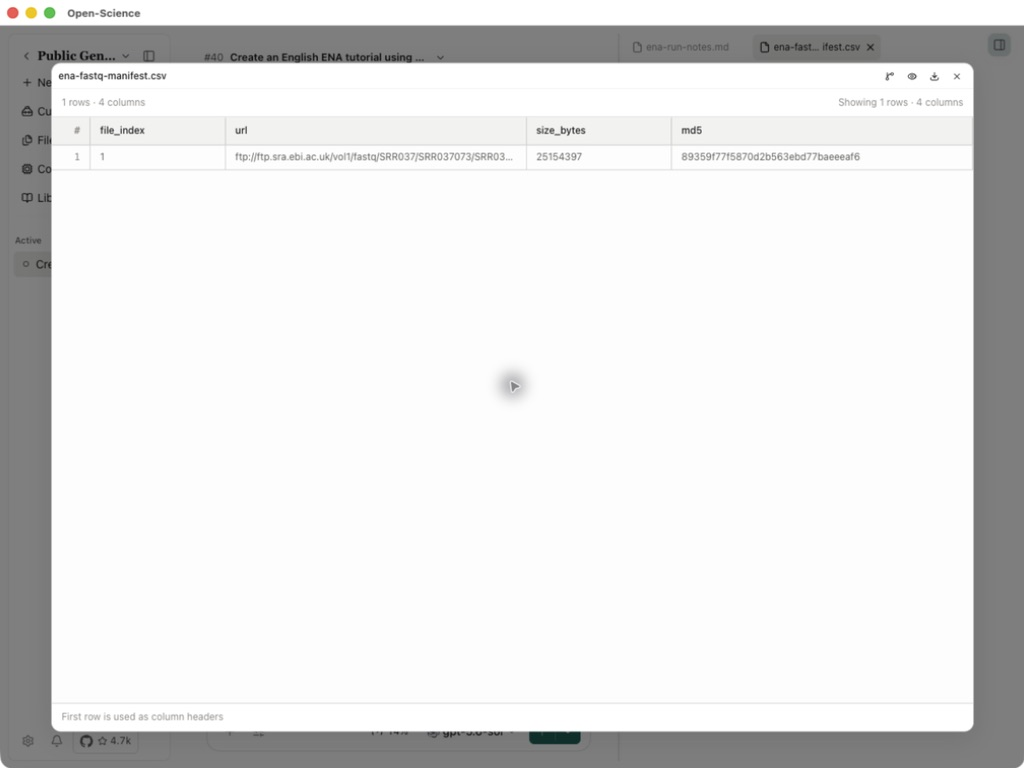
两次查询和清单生成均已完成。本例没有下载 FASTQ 或校验文件内容,后续下载是独立步骤。具体参数
2. 按主题发现运行并检查项目文件
有研究主题、还没有登录号时,使用 ena_query_runs。它按 AND 组合物种、文库策略和关键词条件,至少提供一个条件;tax_id 包含下级分类。默认返回上限为 100,最多 1,000。截断结果没有续页标记,应缩小查询范围,不能把返回数量当成数据集总数。
案例演示 查找五个人类 RNA-Seq 运行,检查 ENA 与 PRIDE 文件清单
- 在 Settings → Connectors 中启用 Omics Archives,打开已连接模型且 Notebook 运行环境可用的会话。本例使用 Codex subscription。
- 发送下方提示词,仅查询元数据。ENA 查询与 PRIDE 项目是两个独立示例,不是同一研究的配对样本。
- 打开
ena-discovery.json,先核对查询条件、物种、运行登录号和truncated,再选择文件。
Use Omics Archives through Session Notebook. Query ena_query_runs with
tax_id 9606, library_strategy "RNA-Seq", keyword "breast" and limit 5.
For the first returned run, call both ena_get_run_files and
ena_get_submitted_files. Separately call pride_get_project_files for
PXD000001, page 0, page_size 5; fetch its next_page once if present.
Save the exact requests and responses as ena-discovery.json,
ena-file-inventory.json and pride-file-pages.json. Save a combined
omics-file-inventory.csv and omics-discovery-notes.md. Keep generated
FASTQ, original submitted files and PRIDE records distinct. Preserve
every supplied location, size and checksum; do not infer missing values
or checksum algorithms. State query limits and pagination. Do not download
data files. Keep everything in English and report actual empty results.
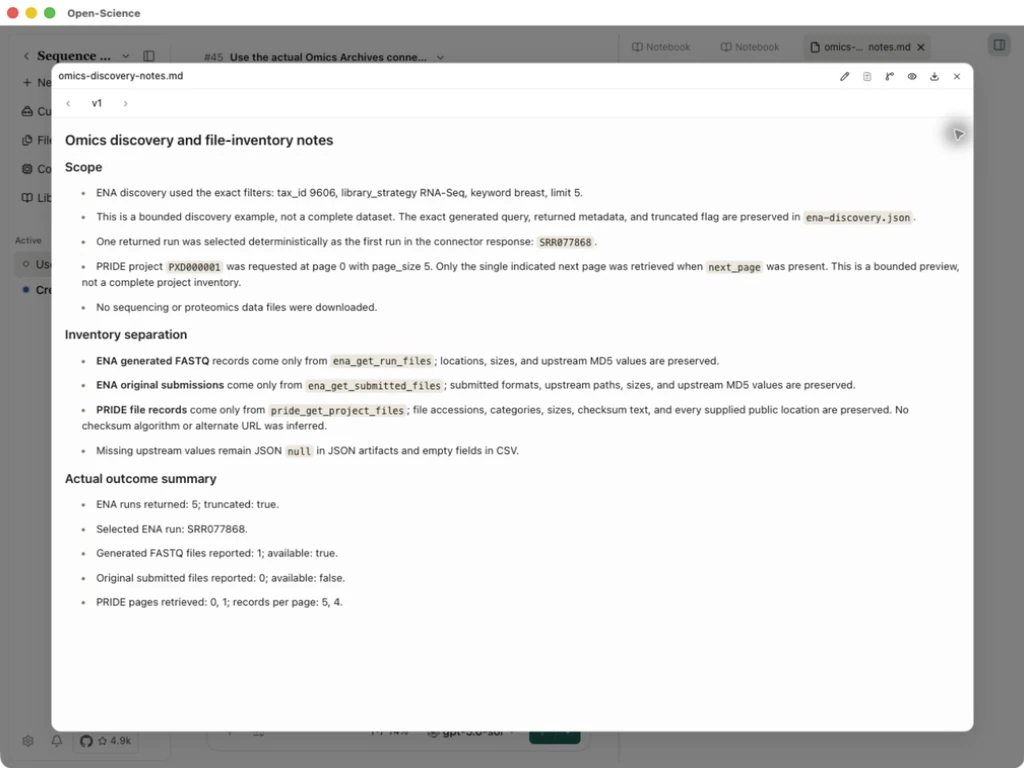
- 对照选中 ENA 运行的两种文件清单。本例返回 5 个运行,
truncated: true。首个运行 SRR077868 有 1 个归档 FASTQ,大小为 462,508,712 字节,并提供上游 MD5。原始提交清单则为found: true、submitted_available: false,返回 0 个文件。运行记录存在,并不代表两种清单都有文件。 - 检查 PRIDE 分页。PXD000001 第 0 页返回 5 条文件记录,第 1 页返回 4 条,
api_total: 9,最后的next_page: null。合并 CSV 有 19 行:九个 PRIDE 文件各提供两个位置,再加一行 ENA FASTQ。统计文件数量时按文件登录号计数,不要把不同下载位置算成不同文件。
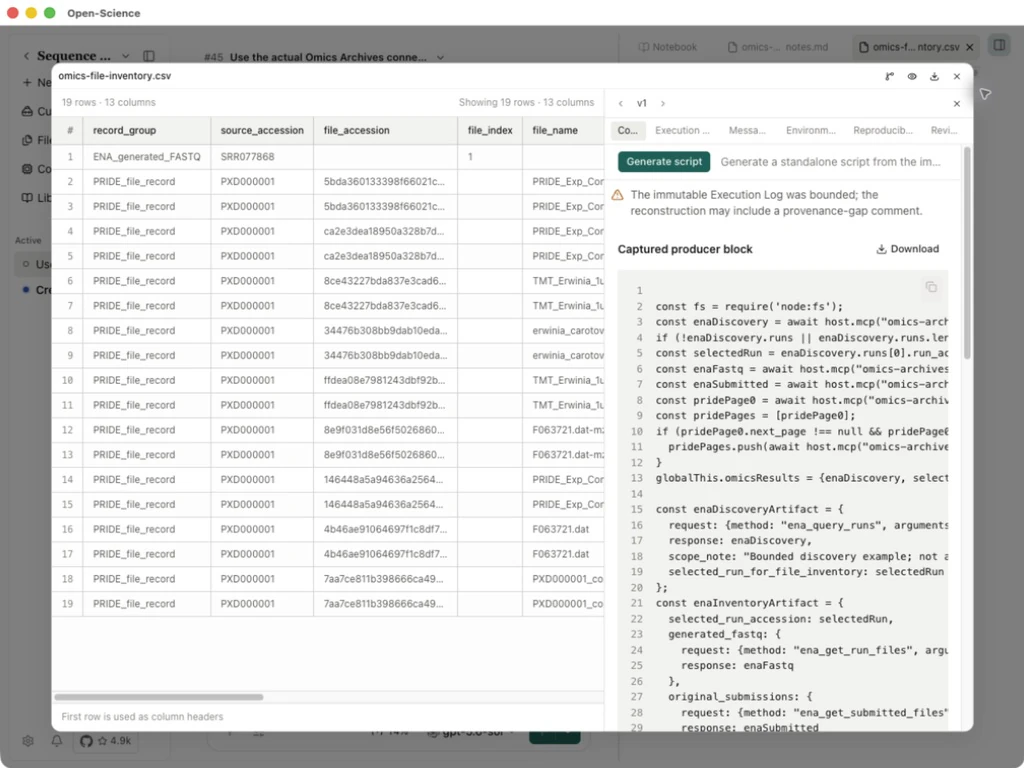
查询说明 · 合并清单 · ENA 检索结果 · ENA 文件清单 · PRIDE 分页结果
这里得到的是文件清单,还没有下载测序或蛋白质组数据。归档 FASTQ 与 BAM/CRAM 等原始提交文件用途不同。ENA 原始 FTP 路径应逐字保留,包括可能出现的 #。PRIDE 应按 next_page 和返回元数据判断分页;其他项目的 api_total 可能缺失,校验和文本也未必说明算法。单独下载前选择所需格式、检查存储空间,有上游校验值时再核对下载字节。具体输入见操作参考。