Cuadros y conjuntos de datos
Utilice la vista previa para entender la estructura de una tabla, luego utilice Python o R para validar y transformar el archivo completo. Los controles comunes de visualización y descarga pertenecen a Abrir y previsualizar archivos; Los límites y extensiones de renderizado se enumeran en Formatos de archivo.
Para una tabla incrustada en una literatura PDF, utilice Extracción PDF, luego vuelva a abrir la tabla exportada y compruebe sus encabezados, valores y notas contra la fuente.
Identificar lo que una fila representa
Ejemplo práctico Lea identificadores de muestra y métricas en una tabla QC
- Abra el ejemplo de la tabla QC de un resultado guardado, archivos o un adjunto.
- Lea los nombres de las columnas y decida si las filas representan muestras, genes u otra unidad. En esta salida, cada fila es una muestra; en su matriz fuente, cada fila es un gen.
- Localice la columna de identificador completo. Mantenga etiquetas de trama cortas mapeadas a esos identificadores.
- Lea el rango mostrado antes de estimar el tamaño del conjunto de datos. Utilice un cálculo de archivo completo cuando la vista previa está atada.
- Compare los valores de la muestra con el base de referencia de QC.
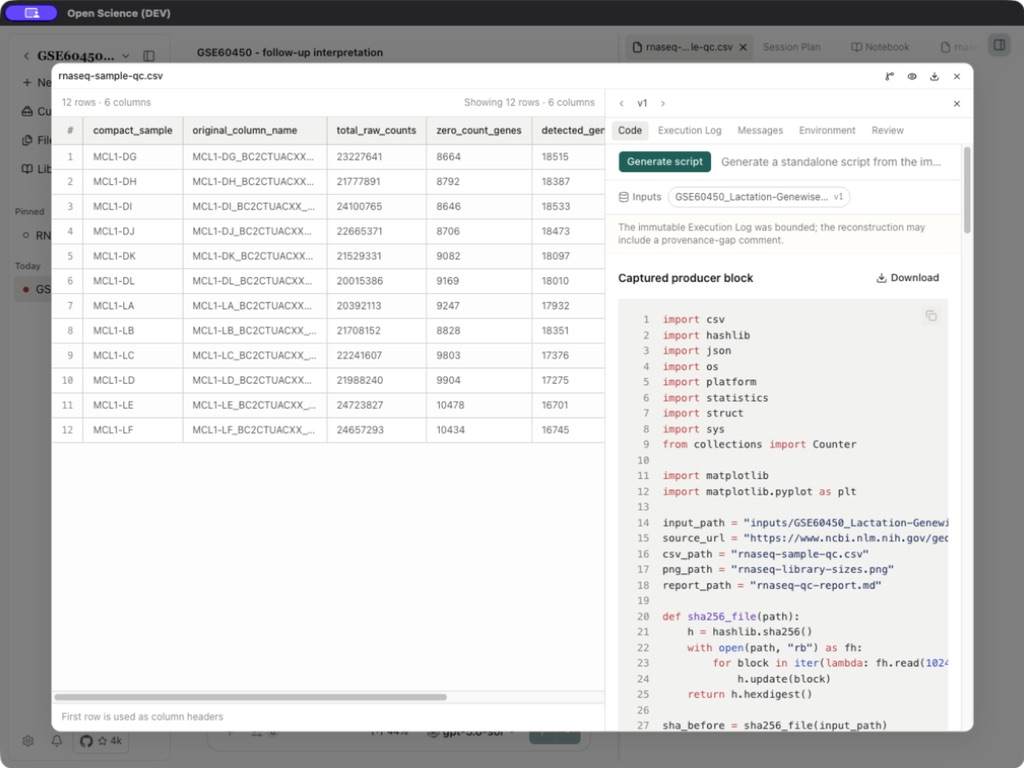
Tabla QC: significados de columna
| Columna | Interpretación | Compruebe antes de utilizarlo |
|---|---|---|
| compact_sample | Etiqueta de figura corta | Retener su asignación al identificador original |
| original_column_name | Identificador de muestra original | Compruebe los nombres perdidos y duplicados |
| total_raw_counts | Suma de conteos de muestras | Preserve raw-count units; no llamar a esta expresión normalizada |
| zero_count_genes | Número de genes con cero cuenta | Junto con genes detectados, debe cubrir todas las filas de genes de entrada |
| detected_genes_count_gt_0 | Número de genes con recuentos positivos | Este es un recuento de genes, no de magnitud de expresión |
| median_count_among_detected_genes | Mediana sobre cuentas positivas | Estado que se excluyen los genes de cuenta cero |
Compruebe el conjunto de datos completo
Identificadores separados y metadatos de columnas de medición antes de seleccionar operaciones numéricas. Preserve gene IDs as identifiers and keep gene length out of sample-count calculations. Compruebe los valores perdidos, los identificadores duplicados y los rangos de valor permitidos en la entrada completa.
Un recuento de fila visible puede describir sólo la vista previa. Lea el archivo completo en Notebook para establecer dimensiones. El renderizador CSV es sólo de lectura; los clics de encabezado no son un sustituto para una operación de clasificación o filtrado.
Guardar transformaciones como nuevos resultados
Establezca la clave de la unión, regla de filtro, política de valor perdido y columnas de salida esperadas en su solicitud. Pida un archivo derivado separado para que la entrada original permanezca disponible. Reabrir la salida, comparar su recuento de filas e identificadores con la entrada, e inspeccionar el código ejecutado antes de interpretar los cambios.
Las variables Notebook son el estado temporal del núcleo hasta que se guardan. Una variable visible y una versión de archivo gestionada tienen diferentes ciclos de vida; use Archivos y versiones para retener y comparar resultados guardados.
Elija un lector para otros formatos
Para .xls/.xlsx, utilice los controles de vista previa y hoja de trabajo de Office descritos en Avances. Los contenedores binarios como .h5ad o .h5 requieren una biblioteca de análisis compatible. Una matriz .txt separada puede abrirse como texto. Renombrar una extensión no convierte datos ni hace un formato no compatible legible.