Ejecutar el enriquecimiento funcional para un conjunto de genes candidato
Ejemplo práctico Una lista de genes de ADN-daño humano seleccionada intencionalmente
Convierta una lista de genes definida en una tabla de procesos biológicos enriquecidos y caminos, conservando mapas de identificadores, antecedentes estadísticos y versiones de origen.
Antes de comenzar, siga Bases de datos científicos para habilitar los conectores necesarios. Utilice un modelo conectado y un Entorno de ejecución de Notebook disponible.
El primer ejemplo utiliza g:Profiler; el Comparación de Enrichr y STRING utiliza los mismos símbolos del gen público 11 en v0.33.3. Fueron elegidos por sus funciones biológicas conocidas, por lo que se espera el enriquecimiento. No son resultados diferenciales-expresión del proyecto GSE60450 o evidencia de un descubrimiento imparcial.
1. Define la lista de genes y los ajustes de análisis
- En Settings → Connectors, haga que Genes & Ontologies esté disponible para el agente. Abra una sesión con un modelo conectado y un tiempo de ejecución Notebook disponible.
- Especifique el organismo, identificadores de genes, fuentes de datos y antecedentes estadísticos. Para datos experimentales reales, justifique el fondo usando genes que podrían haber sido seleccionados por el experimento. Este tutorial utiliza explícitamente todos los genes anotados, no un universo personalizado de genes medidos.
- Envíe el siguiente aviso. Mantenga la llamada de búsqueda y enriquecimiento de la fuente en el mismo período de sesiones y ahorre sus resultados reales.
Use Genes & Ontologies through Session Notebook for an English g:Profiler
tutorial. The deliberately selected gene list is TP53, ATM, ATR, CHEK1,
CHEK2, BRCA1, BRCA2, RAD51, CDKN1A, GADD45A, MDM2.
First call list_enrichment_sources with organism hsapiens.
Then call enrich_gene_set with these genes, organism hsapiens,
sources GO:BP and REAC, domain_scope annotated,
correction_method fdr, and user_threshold 0.05.
Save the full response as dna-damage-enrichment.json, all returned terms
as dna-damage-enrichment.csv, and query, source versions, mappings,
background and limitations as dna-damage-enrichment-notes.md.
Retain unmapped, ambiguous and duplicate identifiers. Treat mapped_genes
as the returned mapping object. Report errors instead of inventing results.
This is not differential-expression evidence or evidence of regulation direction.
2. Verificar identificadores y versiones de origen
Abra las notas generadas y compruebe los recuentos de consulta y cartografía. Esta ejecución mapeó identificadores 11/11, con identificadores 0 no marcados, ambiguos o duplicados. Grabó GRCh38.p14, g:Profiler e114_eg62_p19_27110d83, GO clases 2026-01-23 y Reactome clases 2026-03-20. Una versión posterior del servicio puede devolver diferentes términos.
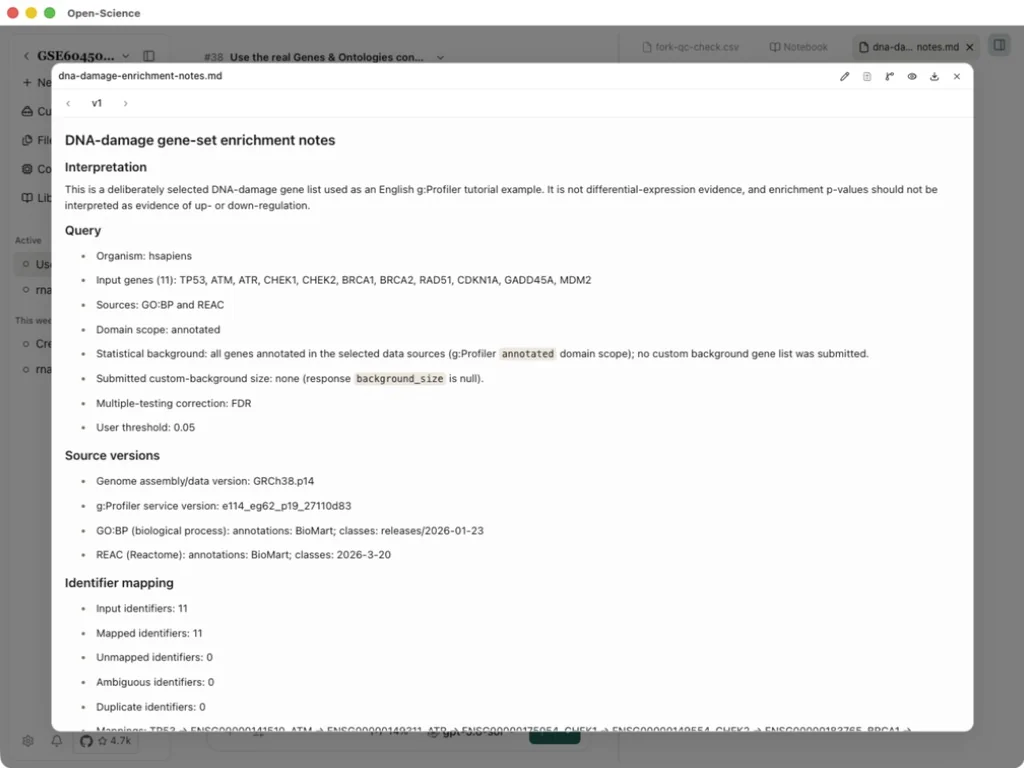
3. Inspeccionar la tabla de enriquecimiento
Abra el CSV y compare con el JSON. Esta carrera devolvió 891 términos en FDR 0.05. La vista previa muestra sólo sus primeras filas 100; ese límite de visualización no es el recuento total de resultados. Retain source, native, corregió p_value, intersection_size, query_size y effective_domain_size al interpretar un término.
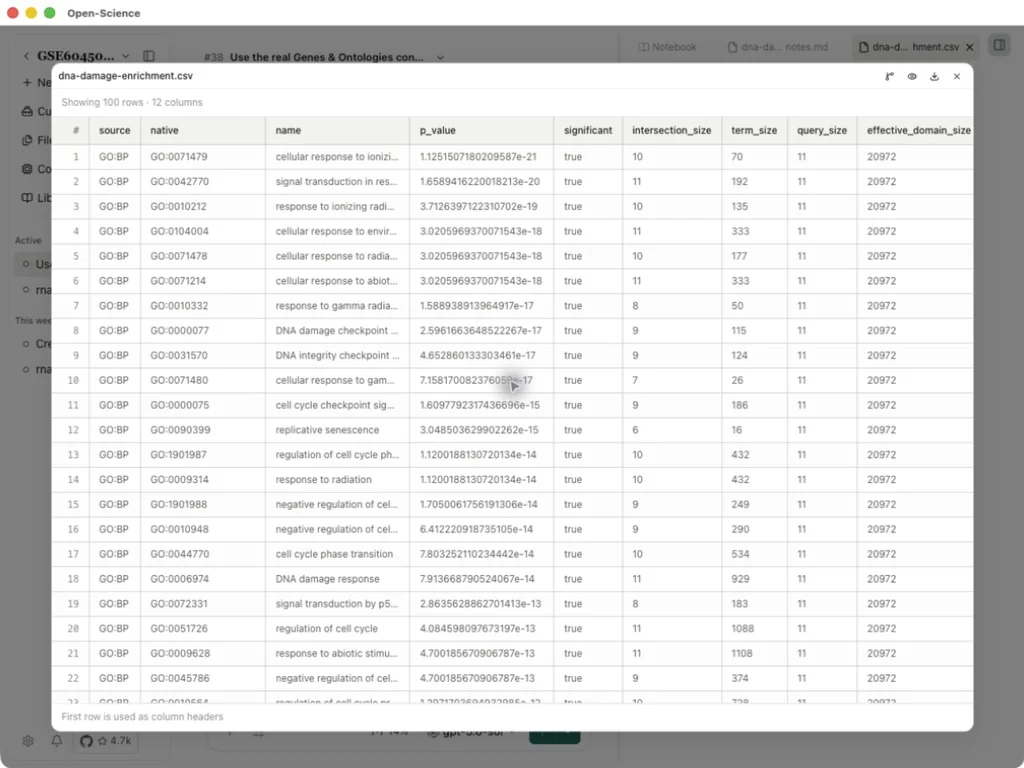
Notas de análisis · Todas las filas de resultado 891 · Respuesta completa
background_size: null significa que no se presentó una lista de antecedentes personalizada; no significa un universo estadístico de genes cero. Utilice el tamaño de dominio efectivo por término. El enriquecimiento no establece la implicación causal, la expresión diferencial o la regulación de arriba/abajo. Ver parámetros de operación.
4. Compare Enrichr con el enriquecimiento de la red STRING
Enrichr pregunta qué conjuntos de anotación están sobrerepresentados en los genes presentados. El enriquecimiento PPI STRING pregunta si las proteínas tienen más interacciones de red de lo esperado. Estas son diferentes pruebas; el acuerdo no es una réplica independiente de un resultado biológico.
- En Settings → Connectors, active Genes & Ontologies y Anotación de proteínas para el agente.
- Crear un proyecto llamado DNA Damage Gene Set y abrir una nueva sesión. Este ejemplo utiliza Codex y Session Notebook.
- Lista las bibliotecas Enrichr disponibles antes de elegir una. Para esta comparación, utilice la biblioteca fija GO_Biological_Process_2025 para que los resultados guardados tengan una versión de anotación identificable. Una biblioteca más nueva puede producir diferentes resultados.
- Envíe este aviso y abra las notas generadas después de que la carrera termine:
Compare Enrichr functional enrichment with STRING PPI enrichment for
TP53, ATM, ATR, CHEK1, CHEK2, BRCA1, BRCA2, RAD51, CDKN1A, GADD45A, MDM2.
Use the built-in Genes & Ontologies and Protein Annotation connectors
through Session Notebook. List the current human Enrichr libraries;
use GO_Biological_Process_2025 with max_results 500 if available.
Run STRING PPI enrichment with species 9606 and required_score 700.
Save raw_connector_responses.json, enrichment_comparison_results.csv
and analysis_notes.md in English. Retain the query, source versions,
identifier mappings, reported background, n_total_results, n_results
and truncated flag, plus raw and adjusted P values where provided.
These genes were deliberately selected for known DNA-damage roles.
Do not infer unbiased discovery, causal regulation or expression direction.
Distinguish annotation enrichment from excess network interactions.
If STRING returns a P value of 0, preserve it as returned without claiming
an exact zero probability or inventing a numerical precision threshold.
Compruebe los insumos y la respuesta completa
Abrir analysis_notes.md y compararlo con raw_connector_responses.json. El 28 de septiembre se encuentra en la lista de las bibliotecas 228 y volvió los términos 305/305 para la biblioteca seleccionada, con truncated: false. El max_results predeterminado es 100; una respuesta 100-row puede ser incompleta. Revise las banderas de respuesta y solicite un límite mayor, hasta 500, cuando sea necesario.
STRING mapeó todos los genes 11, sin identificadores no marcados, y la versión registrada 12.0, el organismo 9606 y el umbral de puntuación 700. Enrichr informa mapping_status: not_reported_by_enrichr; no copie el resultado de la asignación de STRING en el registro Enrichr. No se proporcionó ningún fondo personalizado. La cobertura gen de la biblioteca de Enrichr de 14,674 es metadatos, no un tamaño de fondo estadístico exacto reportado.
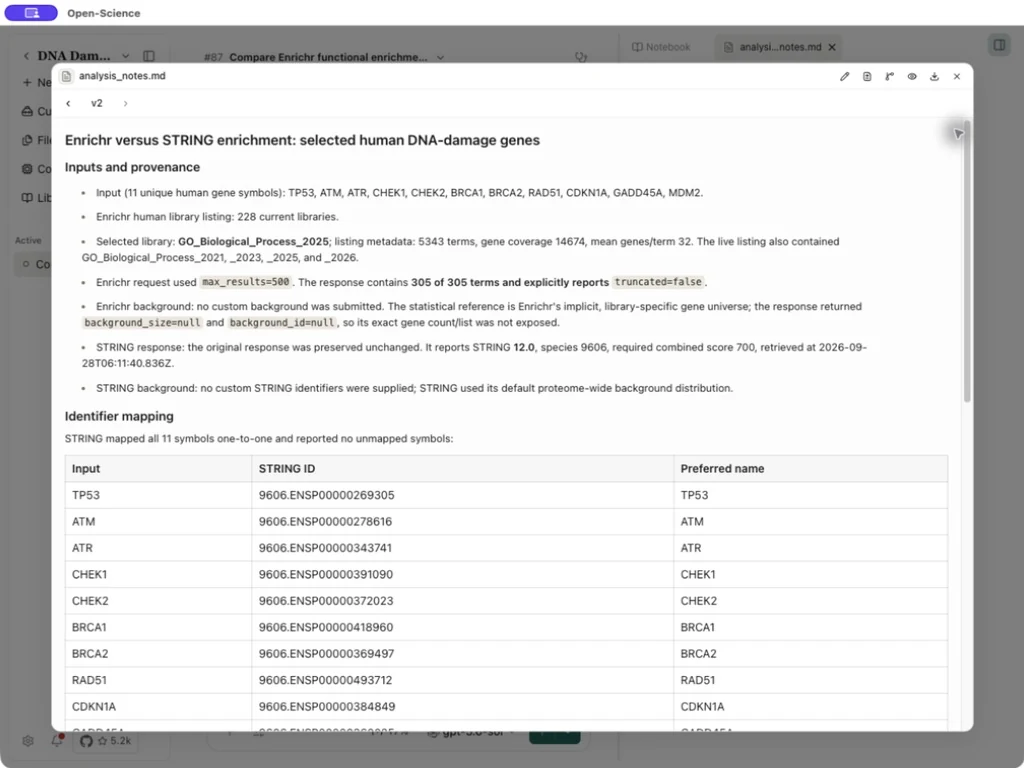
Lea los dos resultados por separado
Abra la sección de resultados de las notas y utilice el CSV o JSON crudo para la lista completa. El primer término Enrichr fue Respuesta celular a la radiación ionizante (GO:0071479), con P ajustado aproximadamente 3.60 × 10⁻¹¹. STRING regresó 44 observa los bordes entre Nodos 11, contra 6 bordes esperados. Su valor P notificado era 0; esta es la salida numérica del servicio, no prueba de probabilidad cero.
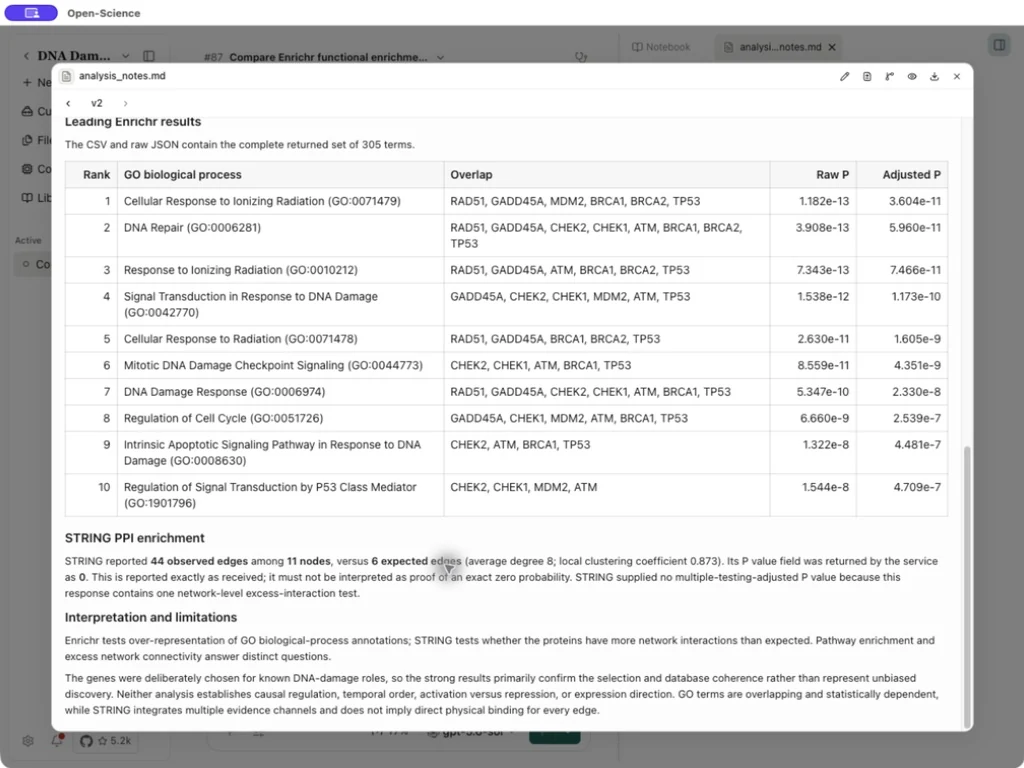
El CSV tiene filas 305 Enrichr más filas sumarias 6 STRING. Estos últimos son estadísticas de red, no términos enriquecidos adicionales. Enrichr GO términos solap, y STRING combina varios canales de evidencia; un borde STRING no significa necesariamente unión física directa. La entrada seleccionada intencionadamente demuestra principalmente las herramientas y sus registros.
Notas de comparación · Tabla de comparación completa · Respuestas originales del conector
Referencias de parámetros: Bibliotecas Enrichr, Enriquecimiento Enrichr, Enriquecimiento de PPI STRING. Para mantener juntos la sesión y las pruebas, exportar un paquete .science.