테이블 및 데이터 세트
테이블의 구조를 이해하기 위해 미리보기를 사용하여 Python 또는 R을 사용하여 전체 파일을 검증하고 변환합니다. 일반적인 보고 및 다운로드 제어는 파일 열기 및 미리보기에 속합니다; 렌더링 경계와 확장은 파일 형식에 나열되어 있습니다.
문학 PDF에 내장 된 테이블을 위해 PDF 추출을 사용하여 수출 된 테이블을 다시 열고 소스에 대한 헤더, 값 및 노트를 확인하십시오.
한 줄을 나타내는 것을 식별합니다.
실습 예제 QC 테이블에서 샘플 식별자 및 메트릭 읽기
- 저장된 결과, 파일 또는 첨부 파일에서 예를들면 QC 테이블을 엽니다.
- 열명을 읽고 줄이 샘플, 유전자 또는 다른 단위를 나타내는지 결정하십시오. 이 산출에서, 각 줄은 표본입니다; 그것의 근원 matrix에서, 각 줄은 유전자입니다.
- 전체 식별자 열을 찾습니다. 이 식별자에 맵핑 된 짧은 도형 라벨을 유지하십시오.
- dataset 크기를 평가하기 전에 표시된 범위를 읽으십시오. 미리보기가 경계될 때 전체 파일 계산을 사용합니다.
- 공유된 QC 기준 샘플 값 비교.
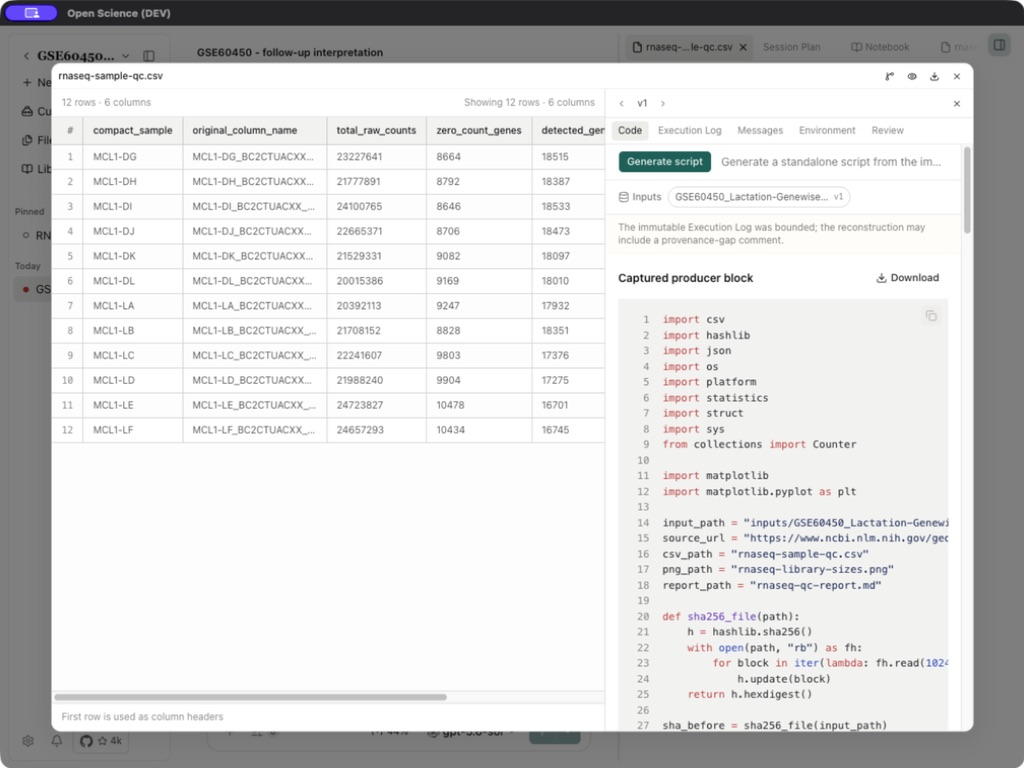
QC 테이블: 란 의미
| 열 | 회사연혁 | 자주 묻는 질문 |
|---|---|---|
| compact_sample | 짧은 그림 상표 | 원래 식별자에 맵핑을 유지 |
| original_column_name | 본래 표본 식별자 | 누락 및 중복된 이름 확인 |
| total_raw_counts | 표본 조사의 합계 | Preserve 익지않는 표 단위; 이 정상화 된 표현을 호출하지 마십시오 |
| zero_count_genes | 제로 카운트와 유전자의 수 | 검출된 유전자와 함께, 모든 입력 유전자 줄을 커버해야 합니다. |
| detected_genes_count_gt_0 | 긍정적 인 수를 가진 유전자의 수 | 이것은 유전자의 개수이며, 표적으로 돋보기 |
| median_count_among_detected_genes | 긍정 조사에 Median | Zero-count 유전자가 제외되는 상태 |
완전한 dataset 확인
측정 열에서 별도 식별자 및 메타데이터를 선택하기 전에 숫자 작업. 식별자로 유전자 ID를 보존하고 샘플 카운트 계산에서 유전자 길이를 유지합니다. 누락된 값, 중복 식별자 및 완전한 입력에서 허용된 값 범위를 확인합니다.
눈에 보이는 행 카운트는 미리보기만 설명할 수 있습니다. Notebook의 전체 파일을 읽어 치수를 설정하십시오. CSV 렌더는 읽기 전용입니다; header clicks는 정렬 또는 필터링 작업을 대체하지 않습니다.
새로운 결과로 변환하기
상태 가입 키, 필터 규칙, 누락된 가치 정책 및 예상 출력 열 귀하의 요청에. 별도의 파생된 파일에 대한 문의는 원본 입력이 유효하다. 출력을 다시 열고, 입력을 가진 행 수와 식별자를 비교하고, 변경을 해석하기 전에 실행 코드를 검사합니다.
Notebook 변수는 저장 될 때까지 임시 커널 상태입니다. 눈에 보이는 변수 및 관리 파일 버전에는 다른 lifecycles가 있습니다. 파일 및 버전을 사용하여 저장 된 결과를 유지하고 비교합니다.
다른 형식의 리더를 선택하십시오.
.xls/.xlsx의 경우, 뉴스 레터에 설명된 Office 미리보기 및 워크시트 컨트롤을 사용하십시오. .h5ad 또는 .h5과 같은 바이너리 컨테이너는 호환 분석 라이브러리를 요구합니다. 텍스트로 탭 변환 .txt 매트릭스가 열 수 있습니다. 확장을 바꾸거나 데이터를 변환하지 않거나 지원되지 않은 형식을 읽을 수 없습니다.