科學工具的執行與驗收
先明確實際輸入和執行環境,再執行計算。本例使用真實 GSE60450 計數及已有包,可在本地復現。
選擇執行位置
| 路徑 | 適用工作 | 就緒檢查 |
|---|---|---|
| Python Session Notebook | 資料解析、數值彙總、繪圖 | 當前繫結 Python 與已安裝包 |
| R Session Notebook | R 分析及包 | 已啟用並繫結到會話的 R |
| 內建 Connector | 資料檢索或受支援確定性操作 | Agent 可訪問,具備憑據/網路 |
| Remote Compute | 主機軟體、GPU、批處理 | 已啟用主機、環境、排程器 |
Shell 與 Session Notebook 的環境、輸入掛載和溯源不同,應明確要求執行路徑。
包與依賴
| 步驟 | 操作 | 成功標準 |
|---|---|---|
| 檢查 | 在正確語言/環境使用 inspect_packages | 實際安裝狀態和版本 |
| 安裝 | 使用當前環境支援的 manage_packages | 安裝完成輸出,不只是已開始 |
| 重啟 | 應用要求時重啟或重新繫結核心 | 下一單元使用更新環境 |
| 驗證 | 在同一 Notebook 匯入 | 真實版本和小範圍操作成功 |
安裝軟體包返回 HTTP CONNECT 403 時,先檢查受影響域名及網路設定,再重試。只有已有軟體包能夠完成所需方法時才使用它;計算成功不代表失敗的包安裝已經修復。
執行並核驗本地 RNA-seq
案例演示 檢查 GSE60450 矩陣的樣本計數
- 附加 GSE60450 輸入。
- 選擇 Python 或 R Notebook,安裝前檢查版本。
- 檢查完整矩陣維度與計數完整性,將
EntrezGeneID、Length從樣本列中排除。 - 按完整樣本 ID 計算總計數、零計數基因、檢出基因、檢出基因中位數。
- 儲存新 CSV、圖和方法報告,比較原始檔前後 SHA-256。
- 重開全部輸出檢查樣本數、標籤、指標,並閱讀 Notebook 程式碼及日誌。
將輸出標識與指標和示例基準比較,保留原始輸入不變。描述性計數不能證明歸一化表達、差異表達或臨床結論。
Python QC CSV · R/Python 對照 · Skill 校驗。
在 CPU 上設計一個小型蛋白序列
案例演示 為 1UBQ 骨架設計候選序列
本路線透過官方 ProteinMPNN CLI,以人泛素 PDB 1UBQ 的 A 鏈為輸入,分別使用 vanilla 和 soluble 權重生成一個候選。這是依賴已有骨架的逆折疊計算。
準備程式和權重
需要帶可用 venv、pip 的受支援 Python、Git、網路和可寫資料夾。以下為 macOS/Linux shell 命令;Windows 使用相應的 .venv\Scripts\python.exe,並按所用 shell 語法設定 CUDA_VISIBLE_DEVICES。
mkdir protein-design
cd protein-design
git clone https://github.com/dauparas/ProteinMPNN.git
git -C ProteinMPNN checkout 8907e6671bfbfc92303b5f79c4b5e6ce47cdef57
python3 -m venv .venv
.venv/bin/python -m pip install torch numpy
.venv/bin/python -c "import sys, torch, numpy; print(sys.version); print(torch.__version__, numpy.__version__)"
.venv/bin/python -m pip freeze > environment.txt
固定提交中包含 vanilla_model_weights/v_48_020.pt 和 soluble_model_weights/v_48_020.pt,請確認兩者存在。將 1UBQ 輸入 下載到 protein-design,命名為 1UBQ.pdb,與輸出資料夾分開保留。
這一步在外部虛擬環境中安裝依賴。若 pip 提示沒有相容發行包,先選擇可用 PyTorch wheel 支援的 Python 版本。儲存 environment.txt;更換 Python、PyTorch 或 NumPy 可能改變數值結果。系統更新後,舊虛擬環境若找不到原始直譯器,應使用當前相容 Python 重建。
執行兩個模型並儲存結果
在 protein-design 中執行:
CUDA_VISIBLE_DEVICES="" .venv/bin/python ProteinMPNN/protein_mpnn_run.py \
  --pdb_path 1UBQ.pdb --pdb_path_chains A --model_name v_48_020 \
  --num_seq_per_target 1 --batch_size 1 --sampling_temp 0.1 --seed 42 \
  --out_folder outputs/vanilla
CUDA_VISIBLE_DEVICES="" .venv/bin/python ProteinMPNN/protein_mpnn_run.py \
  --pdb_path 1UBQ.pdb --pdb_path_chains A --model_name v_48_020 \
  --use_soluble_model --num_seq_per_target 1 --batch_size 1 \
  --sampling_temp 0.1 --seed 42 --out_folder outputs/soluble
兩條命令均使用 A 鏈、一個候選、溫度 0.1、種子 42。清空 CUDA 裝置可見性使該程式使用 CPU。預期檔案為 outputs/vanilla/seqs/1UBQ.fa 和 outputs/soluble/seqs/1UBQ.fa;匯入或釋出時應保留各自模型身份。
在 Open-Science 中執行時,先透過 Your files → Grant folder… 授權準備好的資料夾,再要求 Agent 使用該環境的 Python 絕對路徑和上述工作目錄執行。審批時檢查命令與範圍。要求將兩個 FASTA 和比較報告發布為產物,再從 Files 開啟三個檔案。只在工作目錄中存在的檔案仍需釋出。
:::caution[Skill 包載入] 若內建模型 Skill 因包路徑驗證失敗而無法載入,請按故障排查反饋。上述 CLI 是獨立路線;CLI 成功不代表原生 Skill 載入已恢復。 :::
檢查設計序列
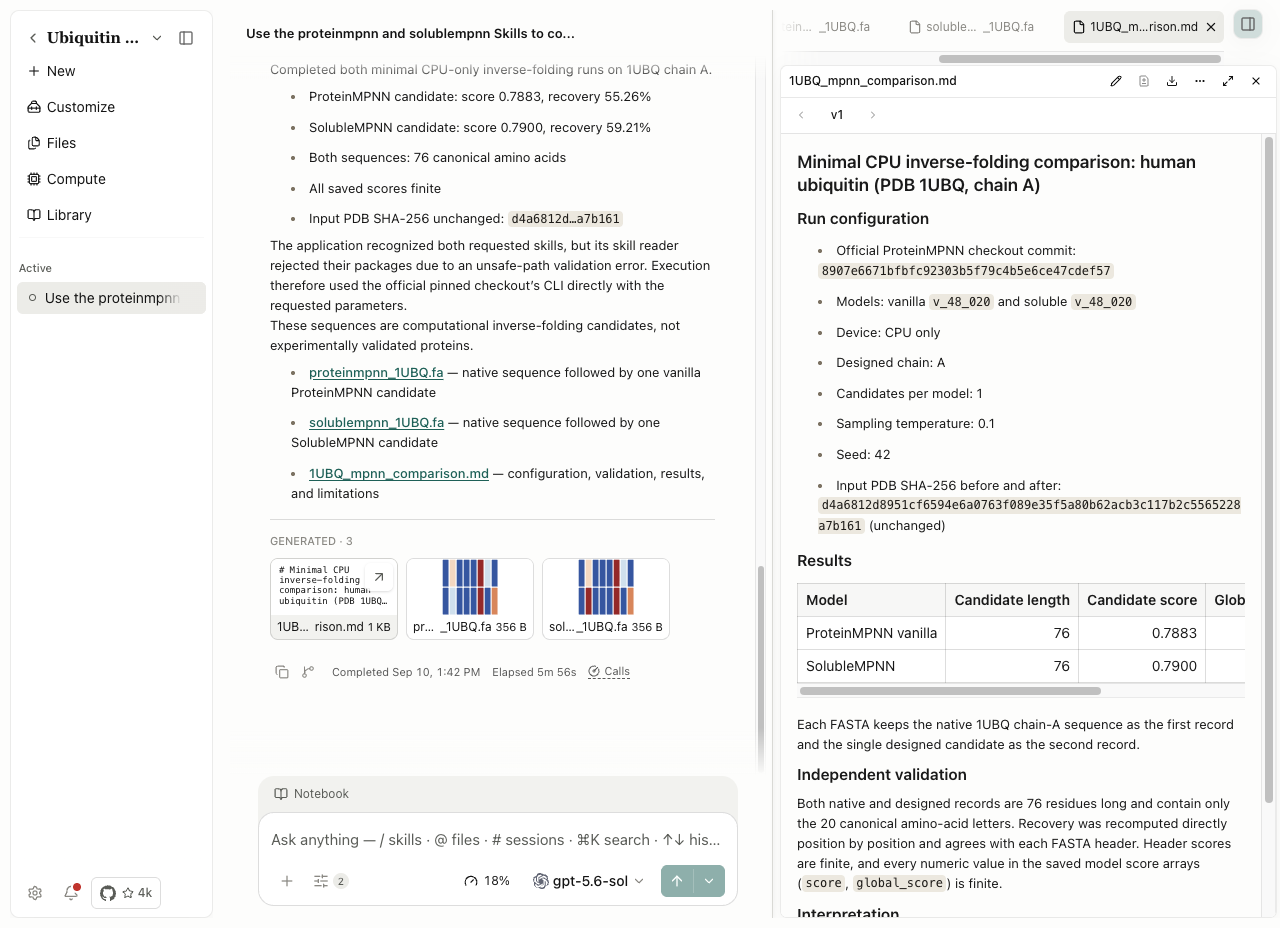
本例儲存的輸出結果如下:
| 輸出 | 候選殘基數 | 分數 | 相對原生序列的恢復率 |
|---|---|---|---|
| ProteinMPNN FASTA | 76 | 0.7883 | 55.26% |
| SolubleMPNN FASTA | 76 | 0.7900 | 59.21% |
每個 FASTA 有兩條記錄,第一條是原生序列,第二條才是單個設計候選。獨立核對確認每條 76 個標準氨基酸、分數有限、逐位重算恢復率一致、PDB 輸入 SHA-256 不變,託管產出與程式輸出位元組一致。對比報告保留引數和限制。一次、每模型一個候選的分數不能證明哪個模型的摺疊、溶解性或功能更好。
按失敗階段排錯
| 現象 | 下一步 |
|---|---|
| 無執行環境 / R 不可用 | 在執行環境安裝或啟用後繫結 |
| ImportError / ModuleNotFoundError / no package called | 核對環境並使用託管包管理 |
| Unknown Skill / 核心輔助函式無效 | 區分方法指令和真正可呼叫的 Notebook 函式 |
| 輸入版本不可用 / 檔案不存在 | 透過應用解析當前準確輸入,不猜路徑 |
| 網路或 HTTP 錯誤 | 保留主機、操作與狀態,參見網路控制和錯誤說明 |
| 輸出只在工作目錄 | 使用支援的結果釋出,再重開儲存版本 |
| 無生產程式碼 / 環境部分記錄 | 保留限制,不編造證據 |
遠端任務應分別驗證主機、提交、狀態和結果收集。Direct SSH RNA-seq 示例已完成並獨立核對結果。Slurm 終態監控需要可讀取的記賬查詢,遠端計算還記錄了使用獨立 CUDA 環境在 A100 上完成的 ProteinMPNN 推理及輸出核對。支援 CPU 的方法需單獨評估。
實現依據: notebook.ts, SKILL.md, SKILL.md。
適用的長時間執行操作見後臺任務與結果送達。結果送達後檢查實際執行和儲存輸出。Environment & Packages、Compute Environment Setup、Remote Compute (SSH) 保持啟用,但執行時、網路和主機要求仍然有效。