SSH 主機與 Slurm 配置
:::info[提交作業前] 提交遠端作業前,先配置 SSH 主機並選擇 Direct SSH 或 Slurm。儲存主機配置不代表認證或任務執行成功。 :::
透過 Settings → Compute 註冊伺服器或叢集。新增主機、允許會話使用主機、成功完成作業是三個不同階段。請將登入節點規則和排程要求寫入主機說明。
選擇作業執行位置
| 執行模式 | 作業執行 | 命令呼叫 | 適用環境 |
|---|---|---|---|
| Direct SSH | 直接在 SSH 登入主機執行 | 在 SSH 登入主機執行 | 允許直接執行負載的機器 |
| Slurm | 透過 Slurm 提交和管理 | 仍在 SSH 登入主機執行 | 要求排程分配的叢集 |
選擇 Slurm 不會把所有命令轉移到計算節點。登入主機的 CPU、記憶體、GPU 資訊不能當作未來作業獲配的資源。應檢查作業實際分配。
新增連線
選擇 Add SSH host,選擇已有別名或輸入主機標識。表單預設使用 SSH configuration 認證和 Direct SSH 執行。
| 欄位或控制元件 | 輸入及作用 |
|---|---|
| From ~/.ssh/config | 選擇發現的別名;沒有別名時禁用 |
| Or type a host alias | 必填,去除首尾空格後 1–255 字元;不允許 NUL 或換行 |
| 可選主機說明 | 排程規則、分割槽/賬號、模組、包安裝規則和環境位置;最多 32,768 字元 |
| Execution mode | Direct SSH 或 Slurm,按主機儲存 |
| SSH configuration | 透過 ssh -G 解析連線,使用現有 SSH 配置、金鑰或 ssh-agent |
| Advanced settings → User | 可選覆蓋;留空使用 SSH 解析結果 |
| Port | SSH 配置模式下可選;填寫時必須是 1–65535 的整數 |
| Identity file | 可選金鑰檔案覆蓋;留空使用配置/agent 行為 |
| Username and password | 必填 User、Port、Password,不使用金鑰或 ssh-agent |
| Cancel | 離開,不登錄檔單中的主機 |
| Add | 提交有效連線;密碼模式必須透過連線測試才新增主機 |
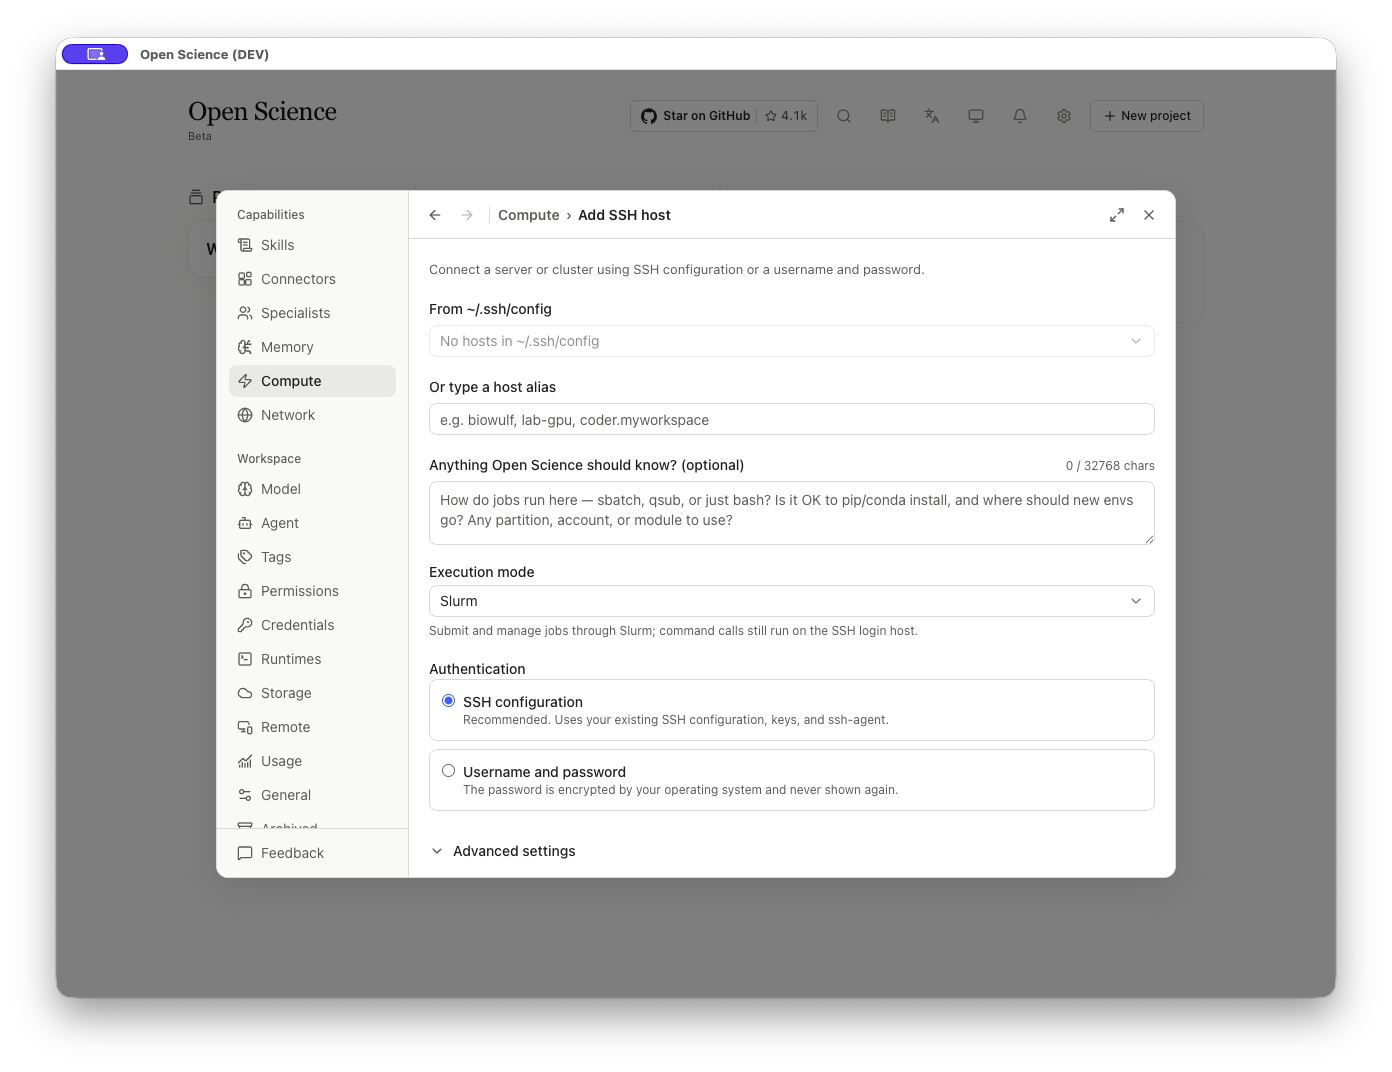
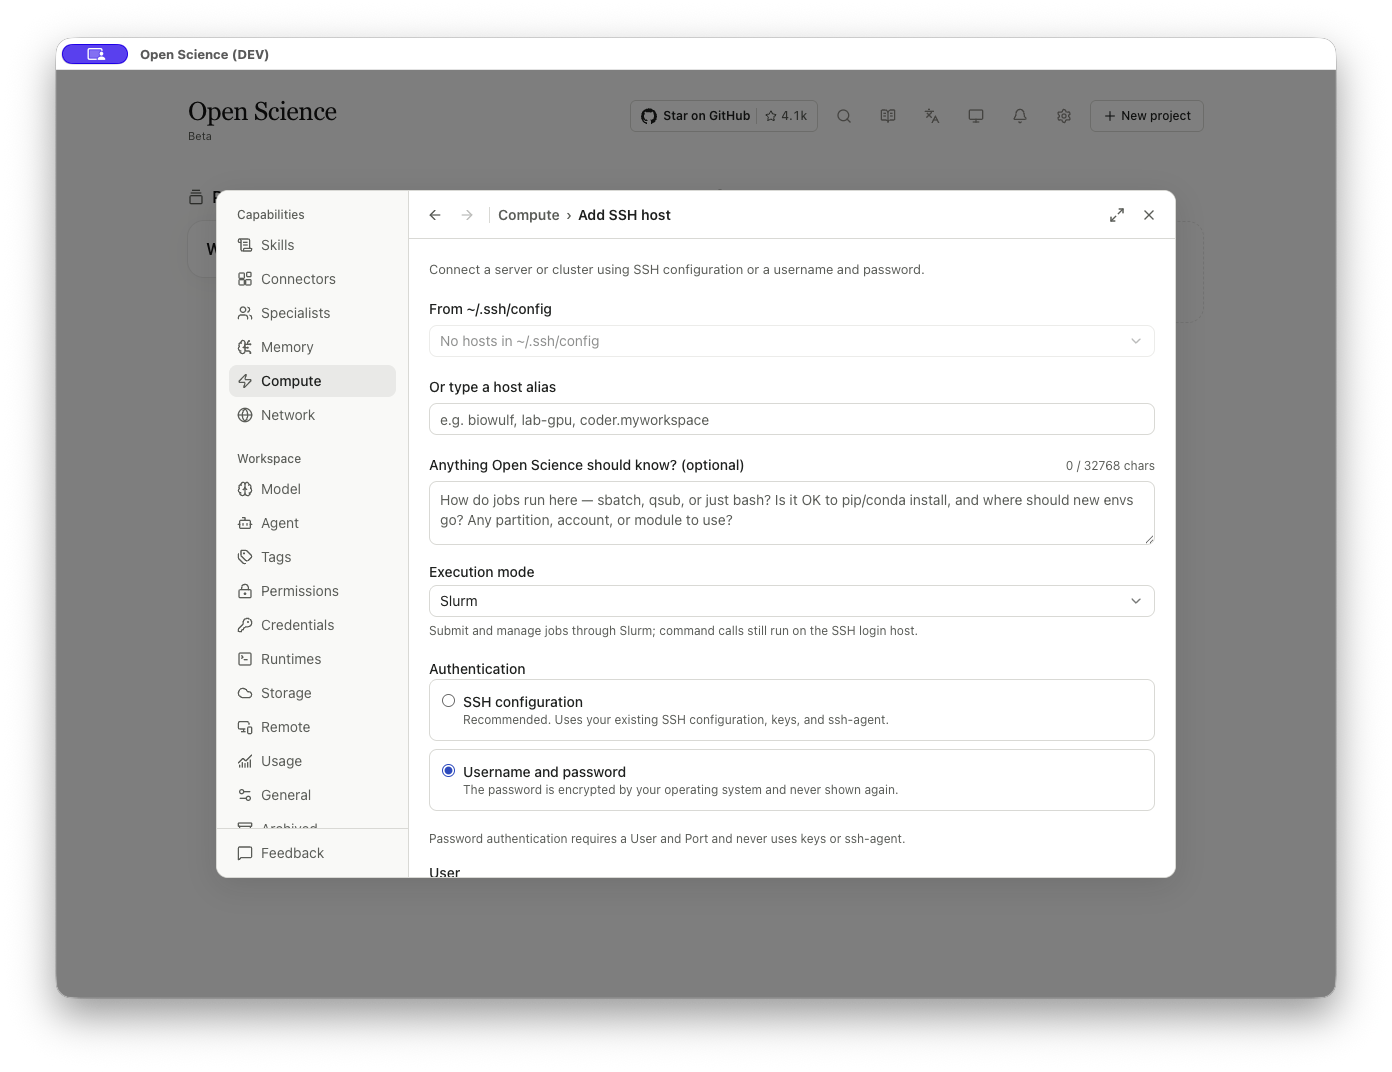
密碼模式依賴應用的密碼認證和安全儲存能力。不可用時,請檢視錶單顯示的原因。憑據只填入對應欄位,不要寫進主機說明或代理請求。
SSH 配置模式會先建立記錄、開啟詳情,再在後臺探測。因此列表裡出現主機不能證明認證成功或計算已就緒。應先檢視探測結果,再讓任務使用該主機。
連線使用密碼的科研伺服器
- 開啟 Settings → Compute → Add SSH host,輸入伺服器地址或別名。
- 選擇 Username and password,填寫 User、Port 和 Password,點選 Add。埠以管理員提供的資訊為準,本例使用 22。
- 如果提示 The SSH host key is unknown. Verify it in a terminal before connecting.,需要先建立主機信任。使用系統 SSH 客戶端連線同一主機和埠,將顯示的指紋與管理員提供的指紋核對,一致後再接受。返回應用重新點選 Add,不要透過關閉主機金鑰檢查消除提示。
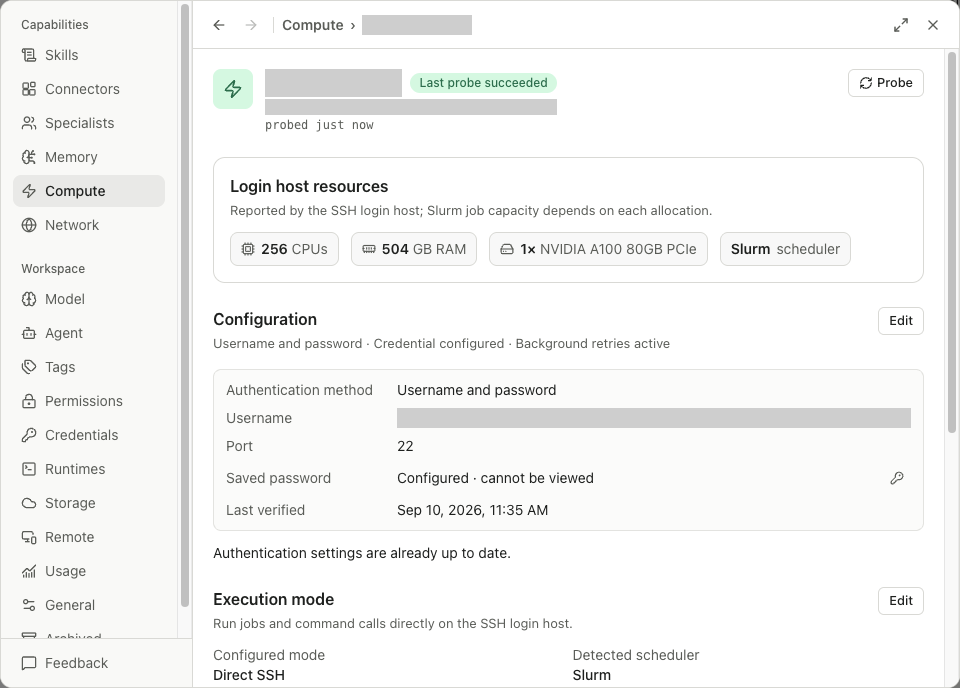
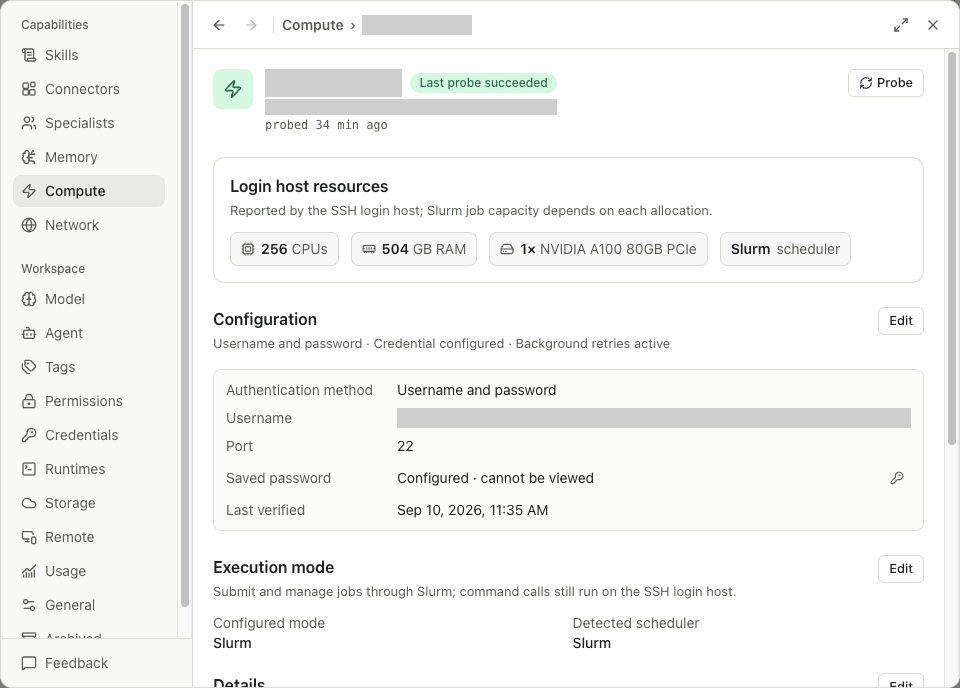
- 等待 Last probe succeeded。在 Configuration 中核對 Credential configured、認證方式與最後驗證時間。已儲存密碼顯示 Configured · cannot be viewed,不能重新檢視。
- 檢查或修改已有連線時,開啟 Configuration → Edit,使用 Test and save。更改認證前閱讀提示:新配置提交後,會清除會話啟用狀態與權限授權,需要在目標會話中重新啟用主機。
英文截圖顯示密碼認證與探測成功:256 個 CPU、504 GB 記憶體、一張 NVIDIA A100 80GB PCIe,並檢測到 Slurm 排程器。Configured mode 仍是 Direct SSH,需要手動更改才會使用 Slurm。這些是示例伺服器的登入主機資源,不是最低要求,也不代表作業已獲排程分配。截圖已遮蓋主機和賬號標識。
檢查和維護主機詳情
| 區域或按鈕 | 檢查內容 |
|---|---|
| Probe / Retry probe | 重新整理連線/資源探測;區分 Not probed、Probing、Last probe succeeded、Probe failed |
| Resources / Login host resources | 檢測到的 CPU、記憶體、GPU 和排程器;排程分配另有資源容量 |
| Configuration → Edit | 檢查認證設定及憑據狀態 |
| Test and save | 先測試候選認證配置,再儲存;更改配置會清除會話啟用狀態與 Permission Grants。配置未變化時,提示設定已是最新狀態 |
| Execution mode → Edit → Save | 修改配置模式,並與 Detected scheduler 對照 |
| Details → Edit | 更新主機說明;Save 提交,Cancel 放棄 |
| Show more / Show less | 展開或收起長說明 |
| Scratch root → Edit | 將遠端臨時工作路徑儲存為固定值 |
| Restore auto-detection | 移除固定覆蓋,允許後續探測提供路徑 |
| Concurrent job limit → Edit | 設定 1–500 的整數,顯示的預設值為 10 |
| 移除主機 | 確認前閱讀應用刪除對話方塊和活動作業限制 |
Scratch root 是遠端主機路徑,不是膝上型電腦上的產物目錄。請確認賬號可寫,並且站點清理規則給收集結果留出足夠時間。併發上限不能替代排程器自身的配額或資源限制。
給驗證任務單獨設定 scratch 目錄
開啟 Scratch root → Edit,填寫伺服器規則允許且可寫的絕對路徑,點選 Save。PINNED 表示後續 Probe 保留該選擇。透過首個作業的工作目錄和輸出確認寫入權限。
首次執行可開啟 Concurrent job limit → Edit,填寫 1 並儲存,使應用在該主機上一次只執行一個託管作業。它不預留 CPU、不限制記憶體,也不會阻止其他使用者執行任務;降低上限不會停止已有作業。需要恢復由探測結果決定 scratch 路徑時,再使用 Restore auto-detection。
區分主機說明與探測資源
已儲存主機說明獨立於 Resources。探測成功不會自動生成環境配置說明,說明為空也不表示探測失敗。排程策略、環境啟用和可復現的配置步驟放在 Details,CPU/RAM/GPU 探測結果在 Resources 檢視。
由 Agent 更新說明時,需要先讀取已儲存文件,再針對該份當前內容精確替換。如果期間發生其他編輯,應重新讀取、比較後再試,不要把資源探測摘要當成待替換的說明文件。主機說明約定。
允許任務使用主機
在會話 Agent controls 中檢查 Compute Host 的可用狀態和選擇。被選中的主機必須同時處於啟用狀態。對於既可本地執行又可遠端執行的任務,明確指定主機和執行模式。第一次請求應足夠小,便於檢查回執、日誌和輸出,再提交科學計算負載。
Slurm 場景需要向叢集負責人確認賬號/分割槽、資源申請、時限、模組/環境設定及臨時目錄規則。sbatch、squeue、sacct、scancel 可用於排程操作,但命令存在不等於賬號有提交權限。
在科研任務前檢查主機
| 階段 | 繼續前檢查 |
|---|---|
| 連線 | 主機探測成功,認證連線有效 |
| Direct 作業 | 小型已批准任務、退出狀態、可讀日誌與取回輸出 |
| Slurm 作業 | 排程回執/job ID、實際分配資源、最終狀態與取回輸出 |
| 重新連線後恢復 | 應用對應同一個遠端作業,沒有重複提交 |
| 取消 | 排程器或程序確認停止,清理前檢查保留輸出 |
| GPU 負載 | 除 SSH 外,還要檢查所需環境、權重、視訊記憶體及科學輸出 |
原始碼核對: 新增主機、認證欄位、主機詳情、連線校驗、會話主機選擇。
在遠端伺服器檢查 RNA-seq 資料質量
在遠端伺服器檢查 RNA-seq 資料質量
案例演示 透過 Direct SSH 完成 RNA-seq 質控
將分析從本機移到伺服器時,可以使用同一份公開的 GSE60450 計數矩陣。與已知結果對照,有助於區分計算環境問題和科學方法變化。
- 在研究專案中新建會話,附加原始計數矩陣。
- 開啟 Agent controls → Compute,先啟用主機,再將其加入 run targets。啟用與選擇是兩個獨立控制元件;只在 Settings 中註冊主機,不會自動為當前會話選擇它。
- 明確要求使用 Direct SSH,指定輸入、輸出和限制。本例使用一個 CPU 執行緒、1 GiB 記憶體上限、120 秒執行時限,使用伺服器預設 Python,無需安裝軟體包。
- 出現 Allow remote job submission? 時,檢查 Host、Intent、Inputs、Execution mode、Timeout 和 Remote workdir。展開 Show full command 閱讀完整指令碼。Once 只批准這次提交,更大的授權範圍會影響後續操作,請按實際需要選擇。
- 保留返回的 Job ID。點選作業標籤或 Background tasks 檢視該任務。執行期間可以離開會話;不能因為回覆結束就再次提交相同任務。
- 完成後開啟 Remote job details,核對 Status、Runtime、Job ID 和 Remote workdir。Refresh 重新整理當前檢視,stdout 和 stderr 分別檢視日誌;點選遠端工作目錄按鈕可以開啟該任務的遠端目錄。
- 等待結果回收與後續回覆,再開啟已釋出的 CSV 和報告。計算完成、檔案回收、產物釋出是三個階段,作業完成本身不能證明兩份預期檔案都已釋出。
可直接使用這樣的請求:
使用選中的 Direct SSH 主機,對附加的 GSE60450 計數矩陣進行描述性質控,保持輸入不變。逐樣本計算總計數、零計數基因數、檢出基因數和正計數中位數,儲存 CSV 及簡短方法報告,記錄矩陣維度和處理前後的 SHA-256。使用一個 CPU 執行緒,不安裝軟體包,執行時限為 120 秒。提交後返回作業 ID,完成後回收併發布結果。不要歸一化計數,也不要得出生物學結論。
出現 success 和退出碼 0 後,確認應用回收兩個輸出,且儲存表格與報告可以重開。按完整樣本標識與公共基準比較指標,並核對遠端計算前後的輸入校驗值。該 Direct SSH 示例已透過這些檢查。
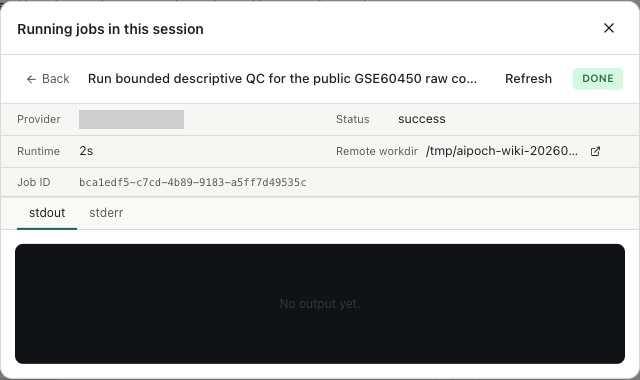
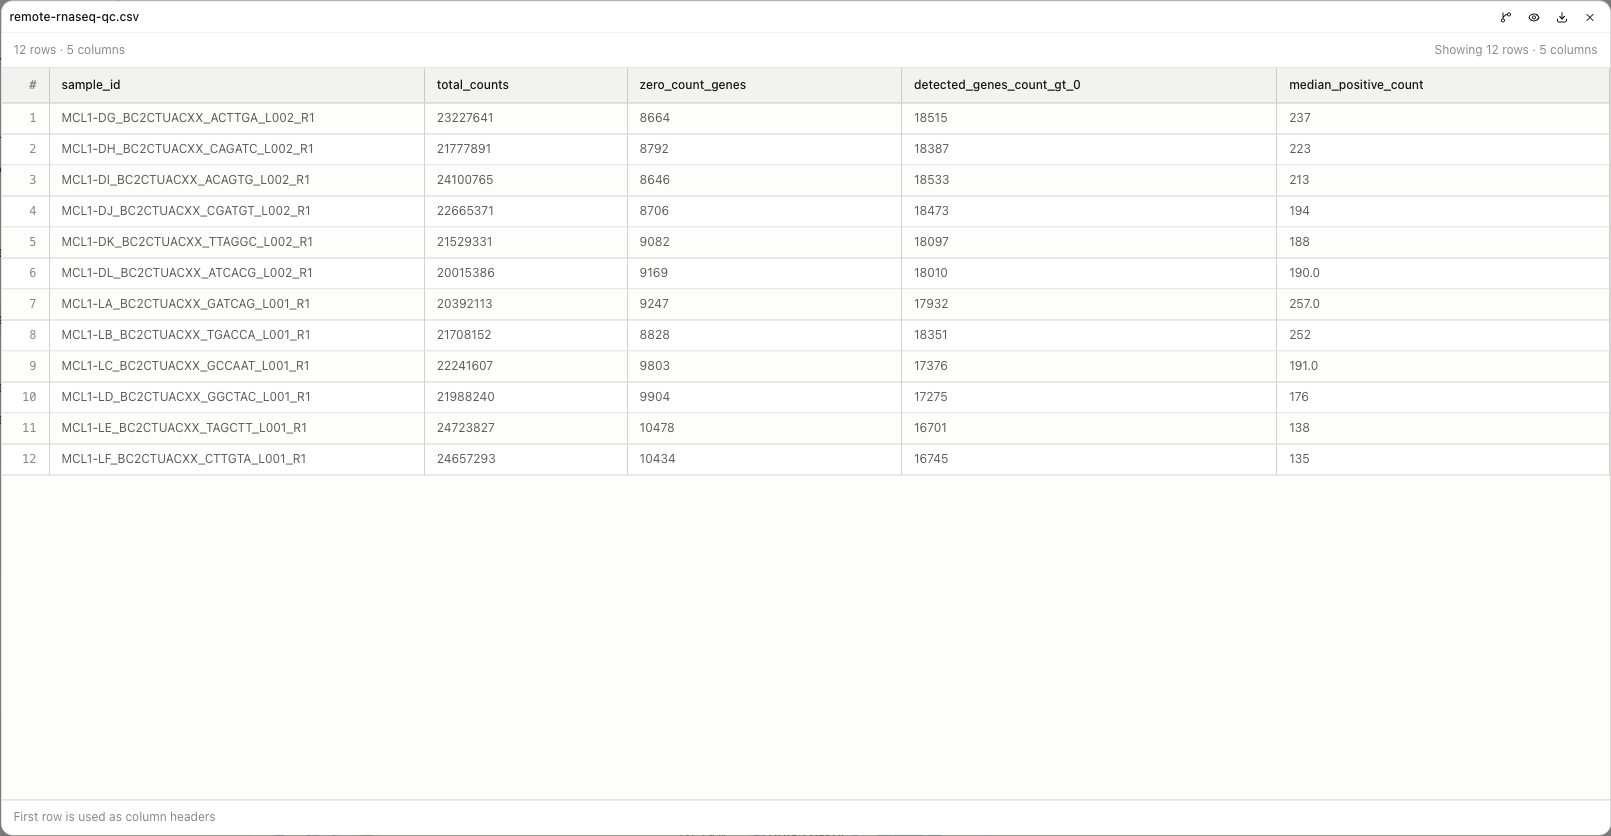
下載示例質控表和方法報告。這些原始計數檢查不替代歸一化、實驗設計審查或差異表達分析;正計數中位數不包括零值。
重啟應用後返回原作業
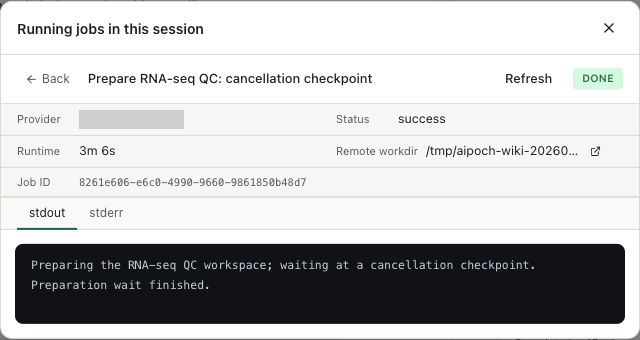
開啟同一專案和會話,透過 Compute 或 Background tasks 找到作業。操作前將 Job ID 與原始回執對照。恢復的是已存在的遠端任務,新建會話或重發請求不能代替恢復。
下圖的獨立準備檢查點在本地應用重啟時仍在執行。應用恢復了同一作業 ID,隨後收集到完成日誌。等待過程正常結束;這張截圖驗證恢復能力,不表示取消成功,也不表示完成了科學計算。
取消指定的遠端任務
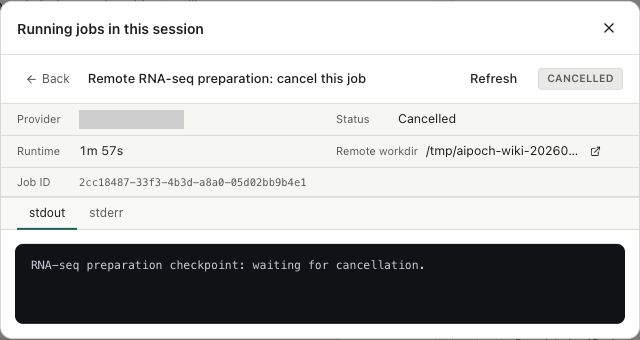
開啟 Background tasks,選擇目標任務,將 Job ID 與提交回執對照。Back 返回當前會話的作業列表。進入詳情後點選 Cancel,等待按鈕顯示 Cancelling,再透過 Refresh 確認狀態變為 Cancelled。關閉詳情視窗或結束會話回覆,都不等於取消遠端負載。
下圖的準備檢查點透過此控制元件取消,之後獨立確認遠端程序已不存在,已有日誌仍可讀取。取消成功不表示該分析已產生完整結果,使用保留檔案前應檢查內容。
透過 Slurm 提交併核對資源分配
- 在 Settings → Compute 開啟主機,選擇 Execution mode → Edit → Slurm → Save,重新開啟設定確認。只有 Detected scheduler 顯示 Slurm,不會自動切換執行模式。
- 在目標會話中啟用並選中主機。長任務執行前,確認站點允許的分割槽/賬號,以及可讀取的排程記賬資訊。
- 使用一行一個
#SBATCH --option=value指令申請資源,本例為:
#SBATCH --partition=local
#SBATCH --cpus-per-task=1
#SBATCH --mem=1G
#SBATCH --time=00:03:00
分割槽應以自己的站點為準,不要直接套用 local。作業的 120 秒負載執行時限與排程器的三分鐘資源分配時限是兩個設定,都不決定排隊任務何時開始。作業名稱、工作目錄、stdout 和 stderr 路徑由應用管理。
- 同時保留應用 Job ID 和 scheduler_job_id。排程器 ID 可能晚於首次提交回執出現,可讓 Agent 讀取已儲存作業的狀態;不要因首條回執缺少排程器 ID 就重複提交。
- 對照申請資源與實際分配。本例每任務申請一個 CPU 和 1 GiB,Slurm 記錄一個任務、實際分配兩個邏輯 CPU。解釋資源使用時,應以實際分配記錄為準。
- 確認終態並完成檔案回收後,再發布結果。伺服器上出現輸出檔案,不代表應用已經回收該檔案。
伺服器已完成,但應用仍在等待
如果應用狀態快照包含 last_poll_error,保留原作業 ID,並要求顯示完整錯誤。本例遇到的記賬錯誤為:
slurm_poll_failed: Slurm accounting storage is disabled
排程器顯示 COMPLETED / ExitCode 0:0,但應用仍為 submitted、result_final false 或沒有已回收檔案時,保留兩個作業 ID 並檢查輪詢錯誤。排程器完成和應用結果回收是兩個階段。
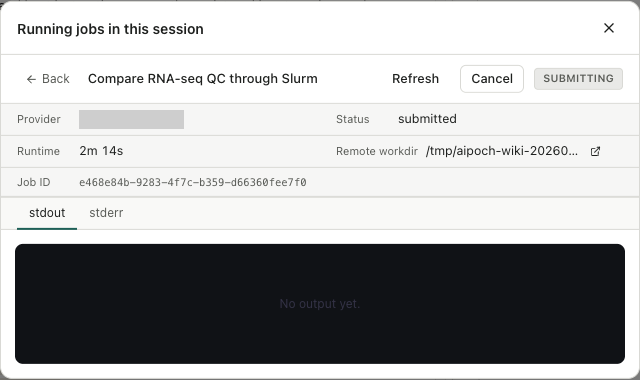
請叢集管理員提供該賬號與作業可用的 sacct 記賬查詢。squeue 不再列出任務,並不足以證明成功。修復期間保留原工作目錄與作業 ID,恢復後檢查同一個任務;不要為了清除監控錯誤而重跑已經完成的分析。Slurm 取消、恢復和應用結果回收,仍需在這一環境條件解決後驗證。
在 GPU 上執行小型蛋白序列設計
在 GPU 上執行小型蛋白序列設計
案例演示 在 GPU 上用 ProteinMPNN 設計一個泛素候選序列
使用公開的 1UBQ 泛素結構,讓 ProteinMPNN 為鏈 A 生成一個候選序列。這個例子驗證遠端 GPU 執行與輸出檢查;它不會預測新結構,也不會證明候選序列具有泛素功能。
- 在 Compute 選擇已連線主機。檢查空閒視訊記憶體與當前負載,並確認該主機允許直接執行小型任務;需要排程器的叢集應使用已授權的佇列和 account。
- 要求代理在獨立目錄準備環境,保留 Python、PyTorch/CUDA 和依賴清單。示例使用 Python 3.10、PyTorch 2.5.1+cu124、NumPy 1.26.4;預設 Python 原先只有 CPU 版 PyTorch,僅探測到 GPU 不足以執行模型。
- 使用 ProteinMPNN 官方倉庫的固定提交和自帶
v_48_020權重。下載 1UBQ 後記錄結構與權重的 SHA-256。 - 明確引數:鏈 A、候選數 1、batch size 1、temperature 0.1、seed 42,執行上限 180 秒。檢查應用顯示的遠端命令,再批准該次操作。
- 要求記錄模型引數所在裝置及 stdout/stderr、退出碼。只有
CUDA available=True不能證明該次推理實際用了 GPU;示例記錄到parameter_device=cuda:0與parameter_is_cuda=True。 - 檢查生成的 FASTA,並用獨立程式碼核對序列長度、氨基酸字元、與原鏈一致的位點數和分數。計算完成後再次檢查輸入雜湊。
| 檢查項 | 本例結果 |
|---|---|
| 裝置 | NVIDIA A100 80GB PCIe;模型實際位於 CUDA |
| 輸入與輸出長度 | 鏈 A 與候選均為 76 位 |
| 字元與分數 | 20 種標準氨基酸字元;score / global score 均為有限值 0.8568 |
| 原序列一致位點 | 42/76,獨立計算 recovery 為 0.5526316 |
| 執行狀態 | 模型和獨立驗證均返回退出碼 0;模型報告生成時間 0.1949 秒,不包含安裝和完整任務耗時 |
| 輸入完整性 | 結構檔案前後 SHA-256 一致 |
下載本次 GPU 驗證記錄。80 GB 是測試裝置容量,不是這個小任務的最低視訊記憶體要求;未測量峰值視訊記憶體。遠端日誌與輸出也不會自動補齊本地 Notebook 的所有證據欄位。
本例透過已批准的直接 SSH 命令完成。此前 Slurm 提交返回 InvalidAccount,不能將這次成功寫成 Slurm GPU 作業透過。遇到該錯誤,應核對佇列和 account 權限;不要擅自更改排程服務,也不要在要求排程器的叢集繞過佇列。
處理 SSH 與作業錯誤
同時閱讀錯誤碼及附帶訊息。連線失敗、排程器拒絕和程式執行失敗,需要分別處理。下列識別符號對應連線分類和計算任務狀態,介面可能顯示對應描述,而非原始程式碼。
連線與遠端檔案
| 訊息或識別符號 | 含義 | 操作與成功檢查 |
|---|---|---|
The SSH host key is unknown. Verify it in a terminal before connecting. | 系統 SSH 客戶端尚未信任該主機和埠的金鑰 | 與管理員核對指紋,在系統 SSH 客戶端中建立主機信任,再重試 Add 或 Test and save,不要關閉主機金鑰檢查 |
Permission denied (publickey) | SSH 金鑰認證失敗,遠端檔案分類將其歸為 connection | 檢查 User、Identity file、主機別名和 ssh-agent;請管理員確認該金鑰有權登入。執行 Test and save,再 Retry probe |
Connection refused / No route to host / 連線 timeout | SSH 無法到達主機或建立連線 | 檢查主機、埠、網路/VPN 及服務可用性,修正原因後重新測試連線 |
ENOENT / not_found | 遠端路徑不存在 | 檢查遠端主機上的路徑,而非本機路徑,再開啟正確目錄或檔案 |
EACCES / EPERM / permission | 已登入賬號沒有對應檔案操作權限 | 請主機管理員確認權限,或選擇已授權的 scratch 目錄,再重試同一操作 |
outside_roots | 遠端檔案路徑不是絕對路徑,或含控制字元,未透過校驗 | 提供無換行和控制字元的遠端絕對路徑;其他層級拒絕時,繼續閱讀完整報錯 |
作業記錄
| 錯誤碼 | 含義 | 接下來怎麼做 |
|---|---|---|
approval_denied | 操作未獲得批准 | 檢查原命令和範圍;確定希望授權該工作時,再提出新請求 |
host_unreachable | 應用無法到達主機或確認主機操作 | 恢復連線並重新探測。可能已提交任務時,先檢查遠端是否已有作業 |
invalid_resources | 資源引數或 Slurm 指令未透過校驗 | 按報錯指出的欄位檢查格式、叢集限制及應用管理的指令限制,修正後再試 |
dispatch_failed | 啟動或排程提交失敗 | 閱讀 stderr 和 sbatch 提示,檢查 partition/account、環境與命令;再次提交前核對有無排程回執 |
job_failed | 作業未成功完成 | 檢查退出碼和 stdout/stderr,修正程式或環境後先執行小任務 |
timeout | 連線、命令或作業超過限制;無效 timeout_seconds 也可能返回此碼 | 根據附帶訊息區分引數錯誤與真正超時。先核對已有作業狀態,再調整時限或重跑 |
process_vanished | 跟蹤或恢復時找不到預期程序 | 檢查遠端工作目錄、日誌和排程歷史,確認工作停止還是完成後再建立替代作業 |
last_poll_error 表示監測失敗,不能單獨據此判定作業最終狀態。harvest_error 則表示結果收集遇到問題,計算可能已經完成。保留 job ID,恢復連線並檢查原作業,再決定是否重跑。
恢復後應能看到目標作業的最終狀態、可解釋的退出狀態和可訪問輸出。Slurm 同時檢查排程器 job ID 與應用 job ID。仍無法解決時,按提交問題或向社群求助反饋,附執行模式、可用的兩類 ID、完整錯誤及去除敏感內容的日誌片段。
使用 SSH 金鑰/配置認證時,提供可用金鑰或主機別名,先驗證連線再提交。Slurm 結果回收需要所選賬號具備可用記賬查詢;應用無法確認作業終態時,按上方步驟檢查。