テーブルとデータセット
プレビューを使用してテーブルの構造を理解し、Python または R を使用して、完全なファイルを検証および変換します。 一般的な視聴とダウンロード制御は、ファイルの開きとプレビューに属しています。 レンダーバインドとエクステンションはファイルフォーマットにリストされています。
文学PDFに埋め込まれたテーブルでは、PDF抽出物を使用し、エクスポートされたテーブルを再オープンし、そのヘッダー、値、およびソースに対するメモを確認します。
1列が何を表すかを識別します。
実践例 QCテーブルのサンプル識別子とメトリックを読みます
- 保存された結果、ファイル、または添付ファイルから QCのテーブルの例 を開きます。
- 列名を読んで、行がサンプル、遺伝子、または別の単位を表すかどうかを決定します。 この出力では、各行はサンプルです。 ソースの行列では、各行は遺伝子です。
- 完全な識別子の列を探します。 これらの識別子にマッピングされたラベルを短時間にプロットしてください。
- データセットのサイズを推定する前に表示される範囲を読んで下さい。 プレビューがバインドされたときにフルファイル計算を使用します。
- 共有QCのベースライン でサンプル値を比較します。
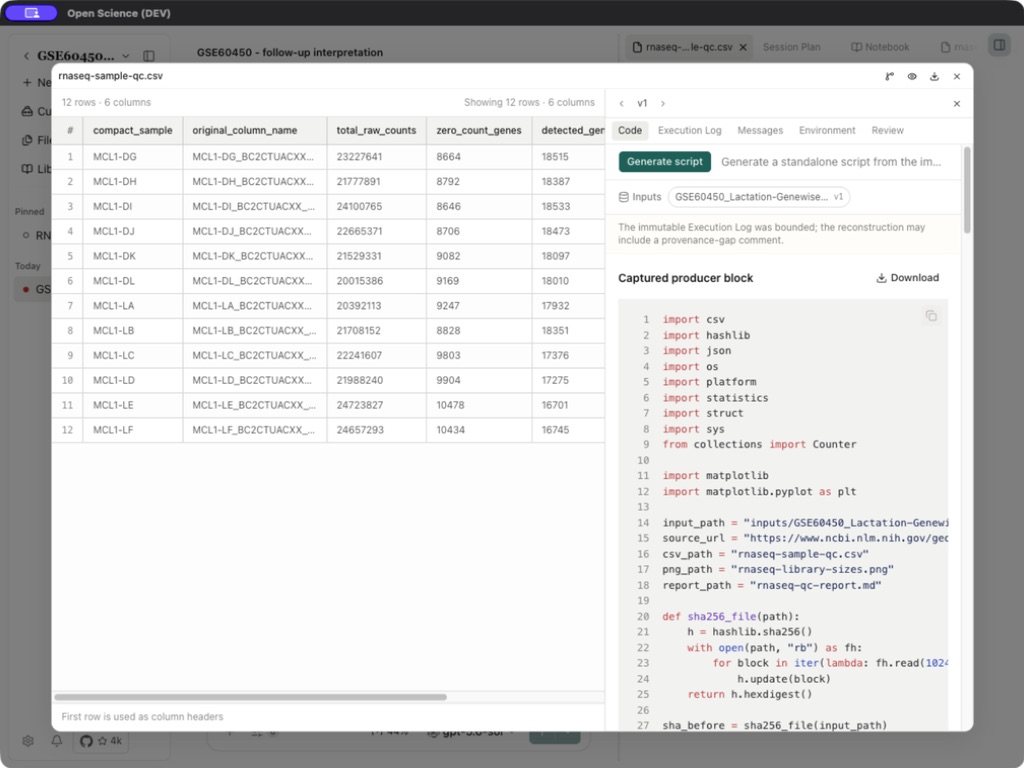
QCのテーブル:コラムの意味
| 列 | 通訳・通訳 | ご使用前にチェック |
|---|---|---|
| compact_sample | ショートフィギュアラベル | 元の識別子へのマッピングを保持する |
| original_column_name | 元のサンプル識別子 | 欠落と重複した名前をチェックする |
| total_raw_counts | サンプルカウントのSum | 生計単位を節約して下さい; この正規表現を呼びません |
| zero_count_genes | ゼロカウントの遺伝子数 | 検出された遺伝子と一緒に、すべての入力遺伝子列をカバーしなければなりません |
| detected_genes_count_gt_0 | 正のカウントで遺伝子の数 | これは遺伝子の数で、発現の大きさではなく |
| median_count_among_detected_genes | 正のカウントを上回る媒体 | ゼロカウント遺伝子が除外される状態 |
完全なデータセットをチェックする
数値操作を選択する前に、測定列から識別子とメタデータを分離します。 遺伝子のIDを識別子として保存し、遺伝子の数値をサンプル計算から保持します。 不足している値をチェックし、識別子を複製し、完全な入力で値範囲を許容します。
可視列カウントはプレビューのみを記述できます。 Notebook で完全なファイルを読み、寸法を確立します。 CSVレンダラーは読み取り専用です。 ヘッダ クリックは、ソートまたはフィルタリング操作の代替ではありません。
変換を新しい結果として保存
参加キー、フィルタルール、欠落値ポリシー、および希望する出力カラムをリクエストに指定します。 元の入力が残っているように別の派生したファイルを求める。 出力を再開し、行数と識別子を入力と比較し、変更を解釈する前に実行されたコードを検査します。
Notebook 変数は保存されるまで一時的なカーネルの状態です。 可視変数および管理されたファイル版に異なったlifecyclesがあります; ファイルとバージョン を使用して保存された結果を保持し、比較します。
他のフォーマットの読者を選んで下さい
.xls/.xlsx では、プレビュー で説明されている Office プレビューとワークシート コントロールを使用します。 .h5adや.h5などのバイナリコンテナは、互換性のある解析ライブラリが必要です。 タブ区切りの.txt行列はテキストとして開くことができます。 拡張機能の変更は、データを変換したり、サポートされていないフォーマットを読み取り可能にしたりしません。