Tableaux et ensembles de données
Utilisez l'aperçu pour comprendre la structure d'une table, puis utilisez Python ou R pour valider et transformer le fichier complet. Les contrôles courants de visualisation et de téléchargement appartiennent à Ouverture et prévisualisation des fichiers; les limites et extensions de rendu sont listées dans Formats de fichiers.
Pour une table intégrée dans une littérature PDF, utilisez Extraction de PDF, puis rouvrez la table exportée et vérifiez ses en-têtes, valeurs et notes par rapport à la source.
Identifier ce qu'une ligne représente
Exemple pratique Lire les identificateurs d'échantillon et les mesures dans un tableau QC
- Ouvrez le tableau de l'exemple de QC à partir d'un résultat enregistré, de fichiers ou d'une pièce jointe.
- Lisez les noms des colonnes et décidez si les lignes représentent des échantillons, des gènes ou une autre unité. Dans cette sortie, chaque ligne est un échantillon; dans sa matrice source, chaque rangée est un gène.
- Localiser la colonne d'identification complète. Gardez de courtes étiquettes de tracé cartographiées sur ces identificateurs.
- Lire la plage affichée avant d'estimer la taille des ensembles de données. Utilisez un calcul de fichier complet lorsque l'aperçu est limité.
- Comparer les valeurs de l'échantillon avec la base de référence de QC partagée.
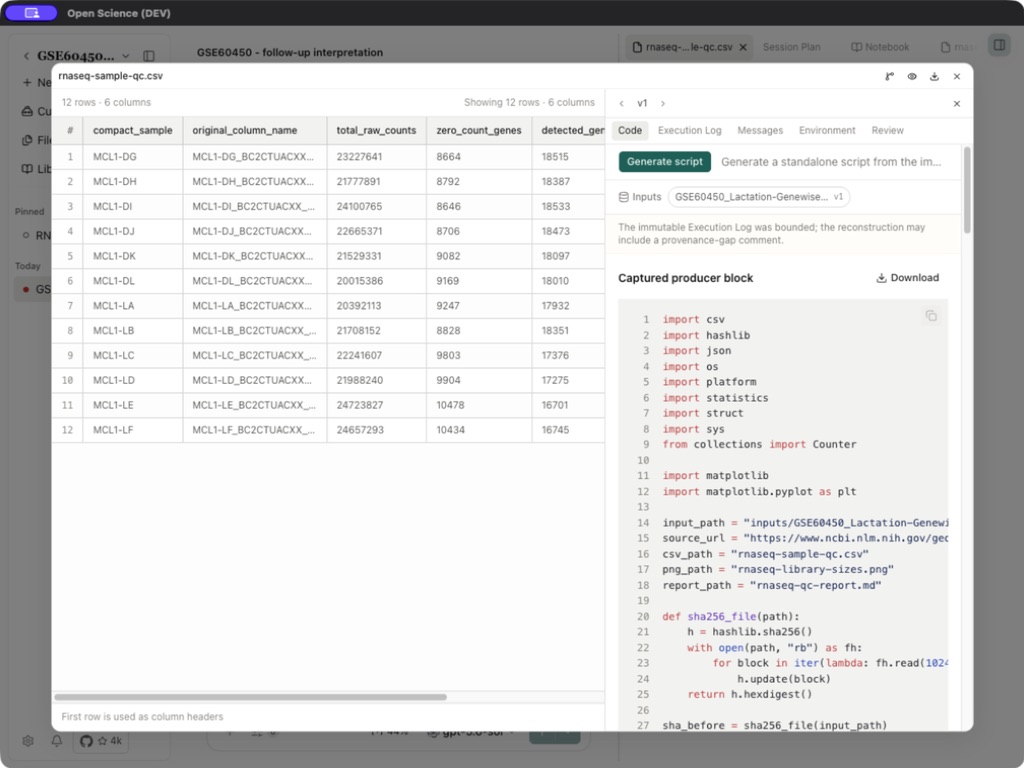
Tableau QC : significations des colonnes
| Colonne | Interprétation | Vérifier avant de l'utiliser |
|---|---|---|
| compact_sample | Étiquette à figure courte | Conserver sa cartographie à l'identificateur original |
| original_column_name | Identificateur original de l'échantillon | Vérifier les noms manquants et dupliqués |
| total_raw_counts | Somme des nombres d'échantillons | Préserver les unités de compte brutes; ne pas appeler cette expression normalisée |
| zero_count_genes | Nombre de gènes dont les nombres sont nuls | Avec les gènes détectés, doivent couvrir toutes les lignes de gènes d'entrée |
| detected_genes_count_gt_0 | Nombre de gènes dont le nombre est positif | C'est un compte de gènes, pas de magnitude d'expression |
| median_count_among_detected_genes | Médian sur les comptes positifs | Indiquer que les gènes à nombre zéro sont exclus |
Vérifiez l'ensemble de données complet
Séparer les identifiants et les métadonnées des colonnes de mesure avant de sélectionner les opérations numériques. Préserver les ID des gènes en tant qu'identificateurs et garder la longueur des gènes hors des calculs du nombre d'échantillons. Vérifier les valeurs manquantes, les identifiants dupliqués et les plages de valeurs autorisées dans l'entrée complète.
Un nombre de lignes visibles ne peut décrire que l'aperçu. Lire le fichier complet dans Notebook pour établir les dimensions. Le rendu CSV est en lecture seule; les clics d'en-tête ne remplacent pas une opération de tri ou de filtrage.
Enregistrer les transformations en tant que nouveaux résultats
Indiquez la clé de jointure, la règle de filtre, la politique de valeur manquante et les colonnes de sortie attendues dans votre demande. Demandez un fichier dérivé séparé afin que l'entrée originale reste disponible. Réouvrir la sortie, comparer le nombre de lignes et les identifiants avec l'entrée, et inspecter le code exécuté avant d'interpréter les changements.
Les variables Notebook sont des états du noyau temporaires jusqu'à leur enregistrement. Une variable visible et une version de fichier gérée ont différents cycles de vie; Utilisez Fichiers et versions pour conserver et comparer les résultats enregistrés.
Choisissez un lecteur pour d'autres formats
Pour .xls/.xlsx, utilisez l'aperçu Office et les contrôles des feuilles de travail décrits dans Aperçus. Les conteneurs binaires tels que .h5ad ou .h5 nécessitent une bibliothèque d'analyse compatible. Une matrice .txt séparée par des onglets peut s'ouvrir sous forme de texte. Renaming d'une extension ne convertit pas les données ou rend un format non pris en charge lisible.