후보 유전자 세트에 대한 기능적 enrichment 실행
실습 예제 의도적으로 선택된 인간 DNA-damage 유전자 목록
정의 된 유전자 목록을 농축 생물학 과정과 통로의 테이블에 켭니다. 식별자 매핑, 통계 배경 및 소스 버전 유지.
시작하기 전에 필요한 커넥터를 활성화하려면 과학 데이터베이스을 따르십시오. 연결된 모델과 사용 가능한 Notebook 런타임을 사용합니다.
첫 번째 예제는 g를 사용합니다 : Profiler; Enrichr 및 STRING 비교은 v0.33.3의 11 공개 유전자 기호를 사용합니다. 그들은 그들의 알려진 생물학적 역할을 선택했다, 그래서 풍성한 예상된다. 그들은 GSE60450 프로젝트 또는 비난 발견의 증거에서 차별 압축 결과가 아닙니다.
1. 유전자 목록 및 분석 설정 정의
- Settings → Connectors에서 에이전트에 유전자 및 종양학을 사용. 연결된 모델과 사용할 수 있는 Notebook 실행 시간으로 세션을 엽니다.
- 생물, 유전자 식별자, 데이터 소스 및 통계 배경을 지정합니다. 실제 실험 데이터의 경우 실험에 의해 선택된 유전자를 사용하여 배경을 단화합니다. 이 튜토리얼은 명시적으로 모든 annotated 유전자를 사용하여 사용자 정의 측정 된 유전자 우주가 아닙니다.
- 다음 프롬프트를 보냅니다. 같은 세션에서 소스 버전 쿼리 및 enrichment 호출을 유지하고 실제 결과를 저장하십시오.
Use Genes & Ontologies through Session Notebook for an English g:Profiler
tutorial. The deliberately selected gene list is TP53, ATM, ATR, CHEK1,
CHEK2, BRCA1, BRCA2, RAD51, CDKN1A, GADD45A, MDM2.
First call list_enrichment_sources with organism hsapiens.
Then call enrich_gene_set with these genes, organism hsapiens,
sources GO:BP and REAC, domain_scope annotated,
correction_method fdr, and user_threshold 0.05.
Save the full response as dna-damage-enrichment.json, all returned terms
as dna-damage-enrichment.csv, and query, source versions, mappings,
background and limitations as dna-damage-enrichment-notes.md.
Retain unmapped, ambiguous and duplicate identifiers. Treat mapped_genes
as the returned mapping object. Report errors instead of inventing results.
This is not differential-expression evidence or evidence of regulation direction.
2. 식별자 및 소스 버전 확인
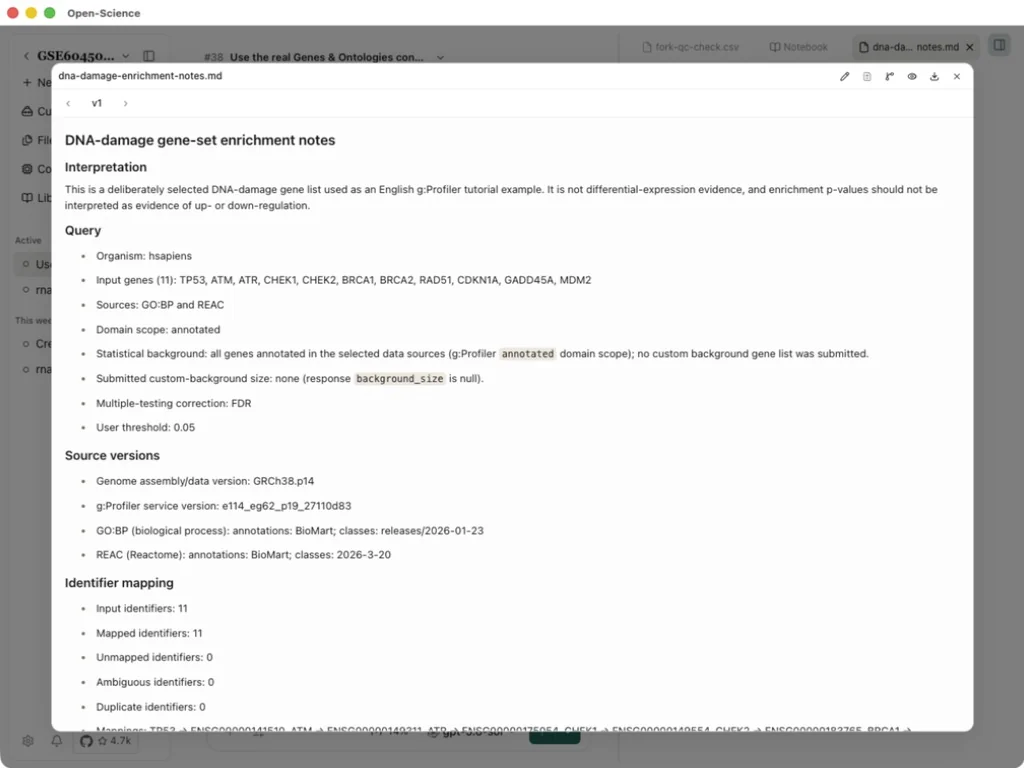
생성된 노트를 열고 쿼리 및 매핑 카운트를 확인합니다. 11/11 unmapped, ambiguous 또는 중복 식별자와 함께 맵핑 된 0 식별자를 실행합니다. 모델: GRCh38.p14, g:Profiler e114_eg62_p19_27110d83, GO 클래스 2026-01-23 및 Reactome 클래스 2026-03-20를 기록했습니다. 나중에 서비스 버전은 다른 용어를 반환 할 수 있습니다.
3. 풍성한 테이블 검사
CSV을 열고 전체 JSON과 비교하십시오. 이 런은 FDR 0.05에서 891 기간을 반환합니다. 미리보기는 첫 번째 100 행만 보여줍니다. 그 표시 제한은 총 결과 수 없습니다. source, native, p_value, intersection_size, query_size 및 effective_domain_size를 제한하여 용어를 해석 할 때.
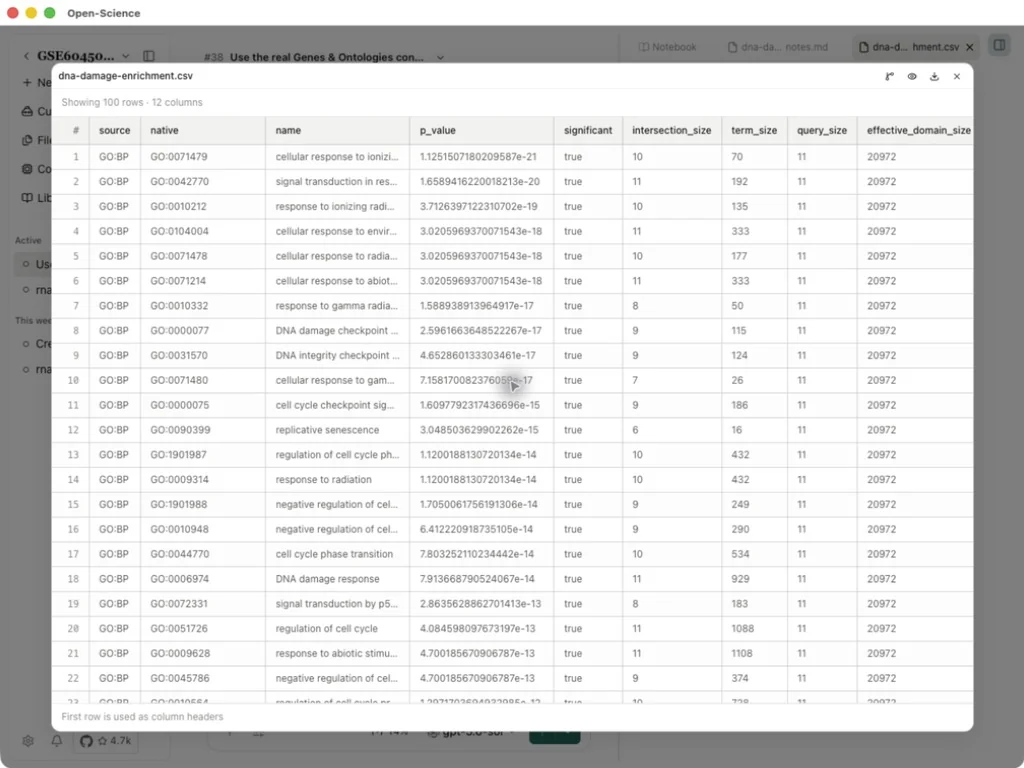
분석 노트 · 모든 891 결과 행 · 전체 응답
background_size: null은 사용자 정의 배경 목록이 제출되지 않습니다. 그것은 0 유전자의 통계 우주를 의미하지 않습니다. per-term 효과적인 도메인 크기를 사용하십시오. Enrichment는 causal involvement, 차별 표식, 또는 up/down 규칙을 설치하지 않습니다. 작업 매개 변수 참조.
4. Enrichr과 STRING 네트워크 enrichment 비교
Enrichr은 할당된 유전자에 존재한다는 것을 묻습니다. STRING PPI enrichment는 단백질이 예상보다 더 많은 네트워크 상호 작용이 있는지 묻습니다. 이들은 다른 시험입니다; 계약은 생물학적 결과의 독립적 인 복제가 아닙니다.
- Settings → Connectors에서 에이전트 유전자 및 종양학 및 단백질 표기를 활성화합니다.
- DNA 손상 유전자 세트라는 프로젝트를 만들고 새로운 세션을 엽니다. 이 예제는 Codex 및 세션 Notebook을 사용합니다.
- 선택하기 전에 사용할 수있는 Enrichr 라이브러리를 나열하십시오. 이 비교를 위해, 고정 된 GO_Biological_Process_2025 라이브러리를 사용하므로 저장된 결과에는 identifiable annotation 버전이 있습니다. 더 새로운 라이브러리는 다른 결과를 생성할 수 있습니다.
- 이 프롬프트를 보내고 실행 완료 후 생성 된 노트를 엽니 다 :
Compare Enrichr functional enrichment with STRING PPI enrichment for
TP53, ATM, ATR, CHEK1, CHEK2, BRCA1, BRCA2, RAD51, CDKN1A, GADD45A, MDM2.
Use the built-in Genes & Ontologies and Protein Annotation connectors
through Session Notebook. List the current human Enrichr libraries;
use GO_Biological_Process_2025 with max_results 500 if available.
Run STRING PPI enrichment with species 9606 and required_score 700.
Save raw_connector_responses.json, enrichment_comparison_results.csv
and analysis_notes.md in English. Retain the query, source versions,
identifier mappings, reported background, n_total_results, n_results
and truncated flag, plus raw and adjusted P values where provided.
These genes were deliberately selected for known DNA-damage roles.
Do not infer unbiased discovery, causal regulation or expression direction.
Distinguish annotation enrichment from excess network interactions.
If STRING returns a P value of 0, preserve it as returned without claiming
an exact zero probability or inventing a numerical precision threshold.
입력 및 완전 응답 확인
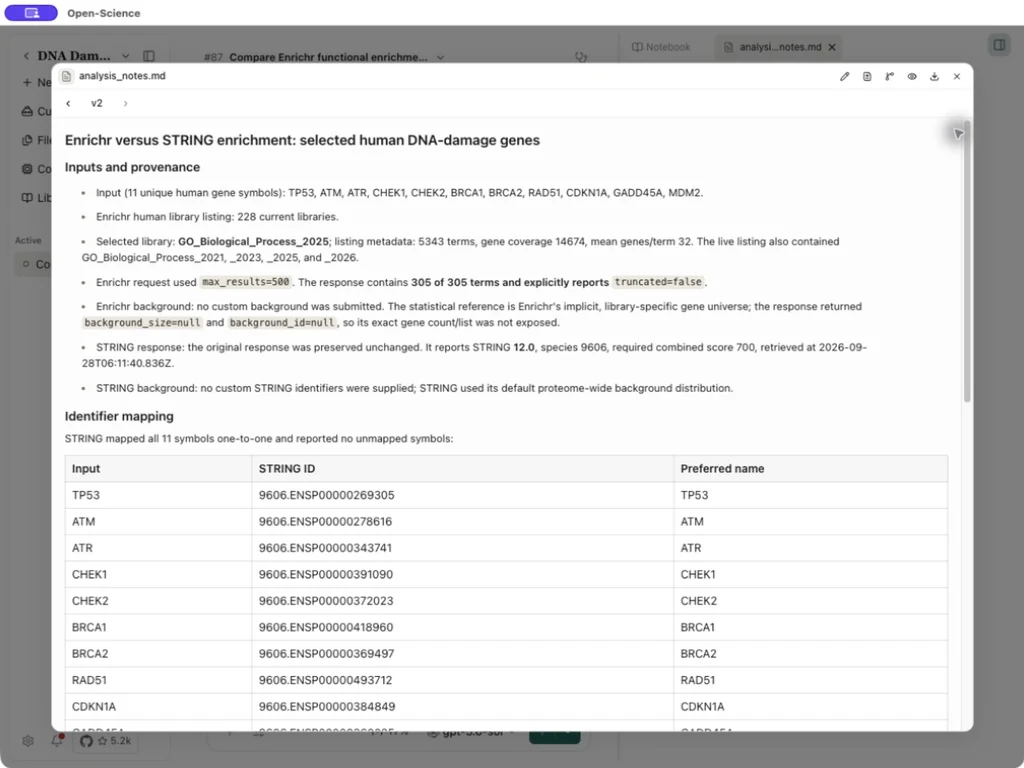
analysis_notes.md을 열고 raw_connector_responses.json과 비교하십시오. 9 월 28 관련 기사 228 도서관 및 반환 305/305 선택한 라이브러리의 용어, 와 truncated: false... 기본 max_results은 100입니다. 100-row 응답은 불완전할 수 있습니다. 응답 플래그를 확인하고 필요한 경우 500까지 더 큰 한계를 요청하십시오.
STRING은 모든 11 유전자를 매핑하고, unmapped 식별자없이, 기록 된 버전 12.0, 유기 9606 및 점수 임계값 700. Enrichr는 mapping_status: not_reported_by_enrichr를 보고합니다; STRING의 매핑 결과를 Enrichr 레코드로 복사하지 마십시오. 사용자 정의 배경이 공급되지 않았습니다. Enrichr의 14,674의 라이브러리 유전자 적용은 metadata이며, 정확한 통계적 배경 크기가 아닙니다.
2개의 결과를 별도로 읽으십시오
노트의 결과 섹션을 열고 CSV 또는 JSON을 전체 목록에서 사용하십시오. 첫 번째 Enrichr 용어는 이온화 방사선에 세포질 응답 (GO: 0071479), 조정 P 약 3.60 × 10⁻¹¹. STRING는 11 노드 중 44에 의하여 관찰되는 가장자리을 반환, 6 예상된 가장자리를 versus. P 값은 0이었다; 이것은 서비스의 숫자 산출, 0 확률의 증거입니다.
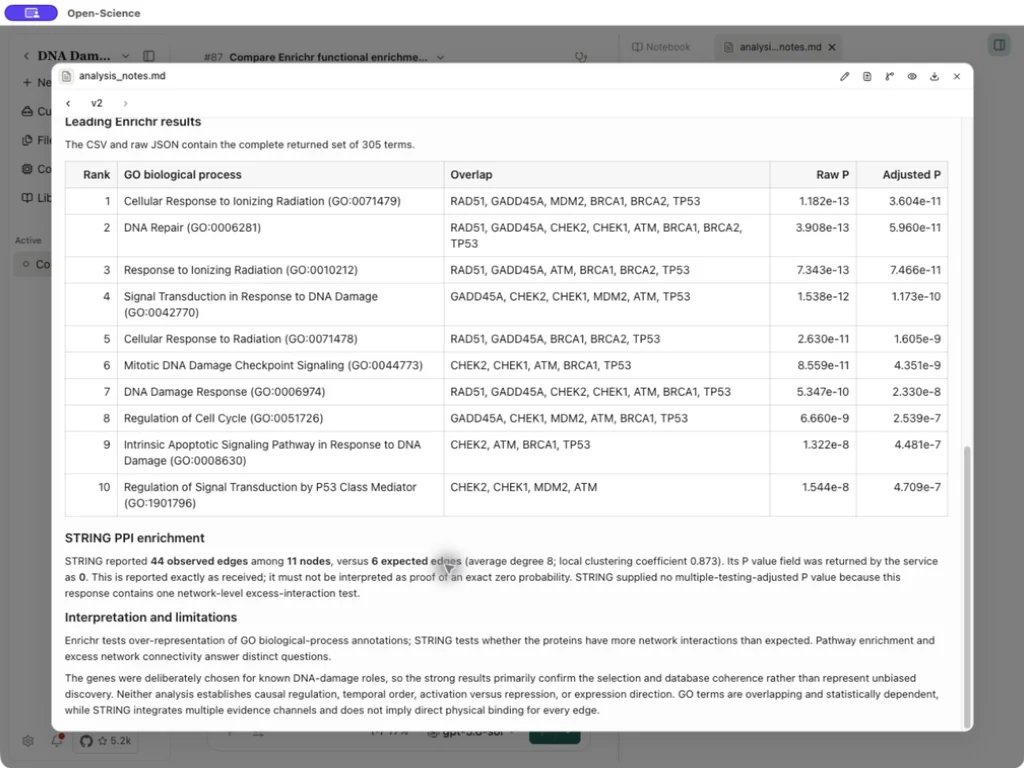
CSV에는 305 Enrichr 행 플러스 6 STRING 요약 행이 있습니다. 후자는 네트워크 통계, 추가 enriched 용어입니다. Enrichr GO 용어 오버랩, 그리고 STRING는 여러 증거 채널을 결합; STRING 가장자리는 반드시 직접적인 물리적 바인딩을 의미하지 않습니다. 의도적으로 선택한 입력은 주로 도구와 레코드를 보여줍니다.
모수 참고: Enrichr 라이브러리, Enrichr 농축물, STRING PPI 농축물. 세션과 증거를 함께 유지하려면 .science 패키지 수출.