Exécuter l'enrichissement fonctionnel d'un ensemble de gènes candidats
Exemple pratique Liste de gènes de dommages à l'ADN humain choisi intentionnellement
Transformer une liste de gènes définie en une table de processus et de voies biologiques enrichis, en conservant des cartes d'identification, des données statistiques de base et des versions sources.
Avant de commencer, suivez Bases de données scientifiques pour activer les connecteurs requis. Utilisez un modèle connecté et un Environnement d'exécution Notebook disponible.
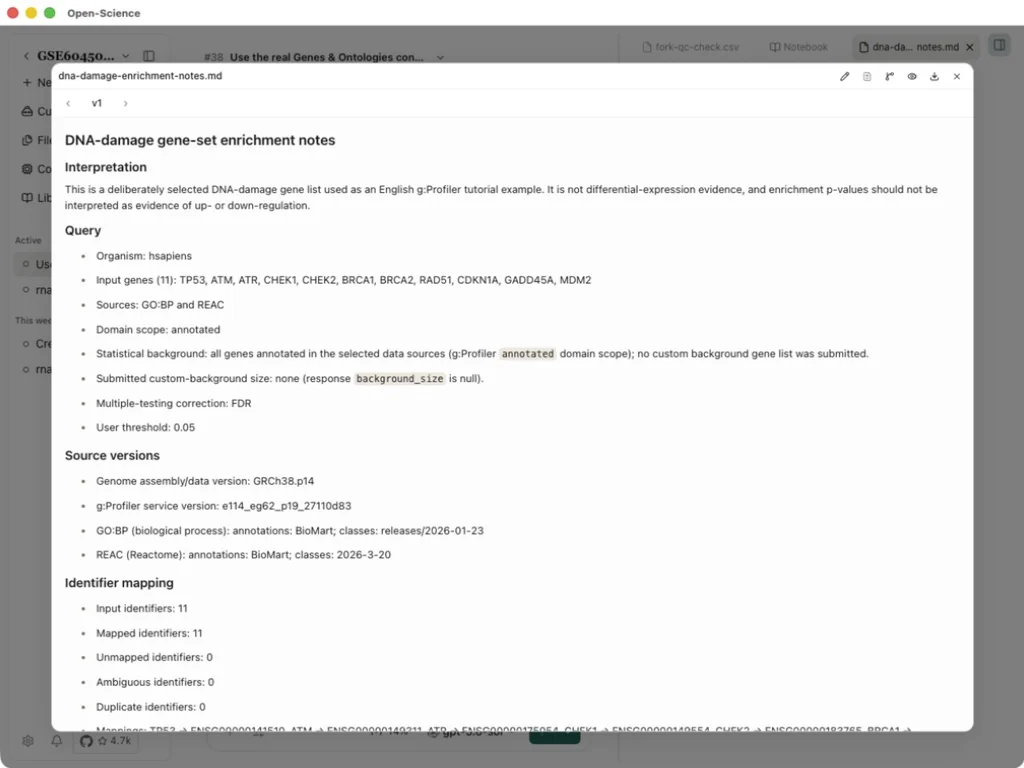
Cet exemple de v0.31.1 utilise des symboles de gènes publics 11 pour démontrer g:Profiler. Ils ont été choisis pour leurs rôles biologiques connus, donc l'enrichissement est attendu. Ce ne sont pas des résultats d'expression différentielle du projet GSE60450 ou des preuves d'une découverte impartiale.
1. Définir la liste des gènes et les paramètres d'analyse
- Dans Settings → Connectors, rendre Genes & Ontologies disponible à l'agent. Ouvrez une session avec un modèle connecté et un exécut temps Notebook disponible.
- Préciser l'organisme, les identificateurs de gènes, les sources de données et le contexte statistique. Pour de vraies données expérimentales, justifier le contexte à l'aide de gènes qui auraient pu être sélectionnés par l'expérience. Ce tutoriel utilise explicitement tous les gènes annotés, et non un univers personnalisé de gènes mesurés.
- Envoyez l'invite suivante. Gardez la requête source-version et l'appel d'enrichissement dans la même session et enregistrez leurs résultats réels.
Use Genes & Ontologies through Session Notebook for an English g:Profiler
tutorial. The deliberately selected gene list is TP53, ATM, ATR, CHEK1,
CHEK2, BRCA1, BRCA2, RAD51, CDKN1A, GADD45A, MDM2.
First call list_enrichment_sources with organism hsapiens.
Then call enrich_gene_set with these genes, organism hsapiens,
sources GO:BP and REAC, domain_scope annotated,
correction_method fdr, and user_threshold 0.05.
Save the full response as dna-damage-enrichment.json, all returned terms
as dna-damage-enrichment.csv, and query, source versions, mappings,
background and limitations as dna-damage-enrichment-notes.md.
Retain unmapped, ambiguous and duplicate identifiers. Treat mapped_genes
as the returned mapping object. Report errors instead of inventing results.
This is not differential-expression evidence or evidence of regulation direction.
2. Vérifier les identifiants et les versions sources
Ouvrez les notes générées et vérifiez les nombres de requêtes et de mappages. Cette opération a permis de cartographier les identifiants 11/11, avec des identifiants 0 non maquillés, ambigus ou dupliqués. Il a enregistré GRCh38.p14, g:Profiler e114_eg62_p19_27110d83, classes GO 2026-01-23 et classes Reactome 2026-03-20. Une version de service ultérieure peut renvoyer des termes différents.
3. Inspecter le tableau d'enrichissement
Ouvrez le CSV et comparez-le avec le JSON complet. Cette exécution a retourné Termes de 891 à FDR 0.05. L'aperçu ne montre que ses premières lignes 100; que la limite d'affichage n'est pas le nombre total de résultats. Conserver source, native, corrigé p_value, intersection_size, query_size et effective_domain_size lors de l'interprétation d'un terme.
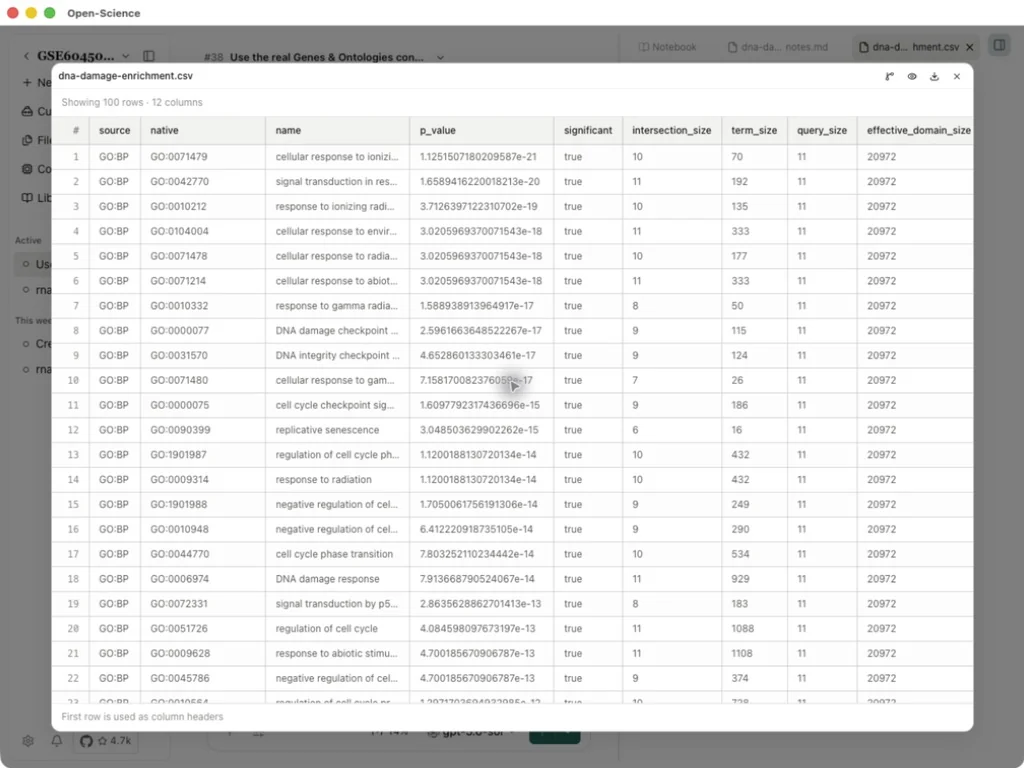
Notes d'analyse · Toutes les lignes de résultats 891 · Réponse complète
background_size: null signifie qu'aucune liste d'arrière-plan personnalisée n'a été soumise; cela ne signifie pas un univers statistique de zéro gène. Utilisez la taille de domaine efficace par terme. L'enrichissement n'établit pas d'implication causale, d'expression différentielle ou de régulation ascendante ou descendante. Voir paramètres de fonctionnement.