SSH 主机与 Slurm 配置
提交远程作业前,先配置 SSH 主机并选择 Direct SSH 或 Slurm。保存主机配置不代表认证或任务执行成功。
通过 Settings → Compute 注册服务器或集群。添加主机、允许会话使用主机、成功完成作业是三个不同阶段。请将登录节点规则和调度要求写入主机说明。
选择作业执行位置
| 执行模式 | 作业执行 | 命令调用 | 适用环境 |
|---|---|---|---|
| Direct SSH | 直接在 SSH 登录主机运行 | 在 SSH 登录主机运行 | 允许直接运行负载的机器 |
| Slurm | 通过 Slurm 提交和管理 | 仍在 SSH 登录主机运行 | 要求调度分配的集群 |
选择 Slurm 不会把所有命令转移到计算节点。登录主机的 CPU、内存、GPU 信息不能当作未来作业获配的资源。应检查作业实际分配。
添加连接
选择 Add SSH host,选择已有别名或输入主机标识。表单默认使用 SSH configuration 认证和 Direct SSH 执行。
| 字段或控件 | 输入及作用 |
|---|---|
| From ~/.ssh/config | 选择发现的别名;没有别名时禁用 |
| Or type a host alias | 必填,去除首尾空格后 1–255 字符;不允许 NUL 或换行 |
| 可选主机说明 | 调度规则、分区/账号、模块、包安装规则和环境位置;最多 32,768 字符 |
| Execution mode | Direct SSH 或 Slurm,按主机保存 |
| SSH configuration | 通过 ssh -G 解析连接,使用现有 SSH 配置、密钥或 ssh-agent |
| Advanced settings → User | 可选覆盖;留空使用 SSH 解析结果 |
| Port | SSH 配置模式下可选;填写时必须是 1–65535 的整数 |
| Identity file | 可选密钥文件覆盖;留空使用配置/agent 行为 |
| Username and password | 必填 User、Port、Password,不使用密钥或 ssh-agent |
| Cancel | 离开,不注册表单中的主机 |
| Add | 提交有效连接;密码模式必须通过连接测试才添加主机 |
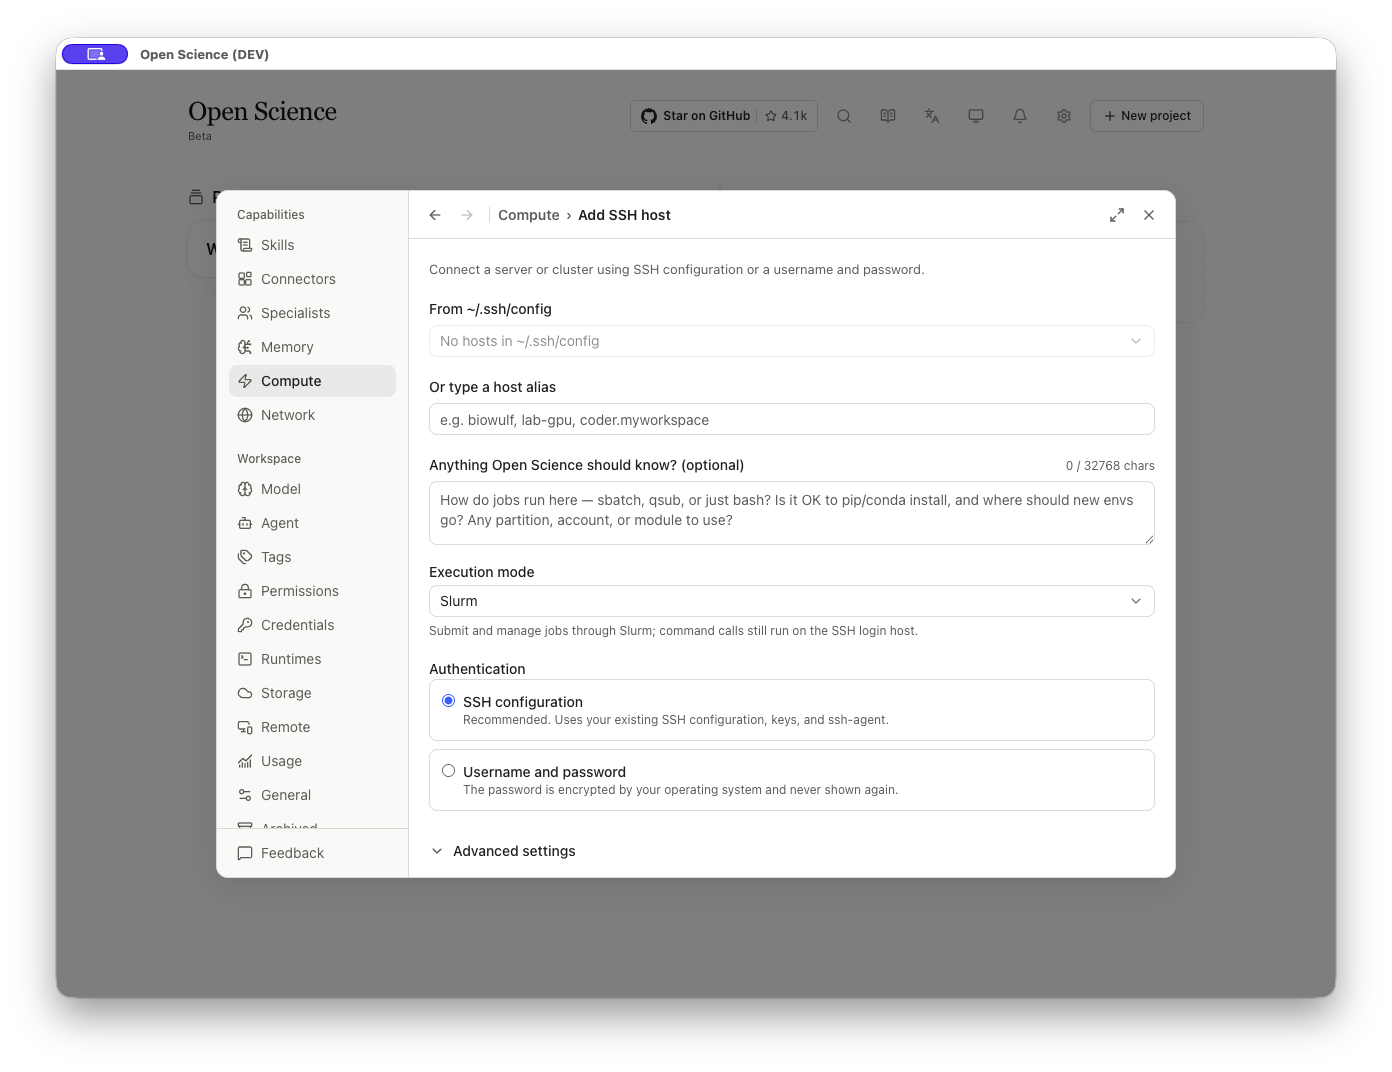
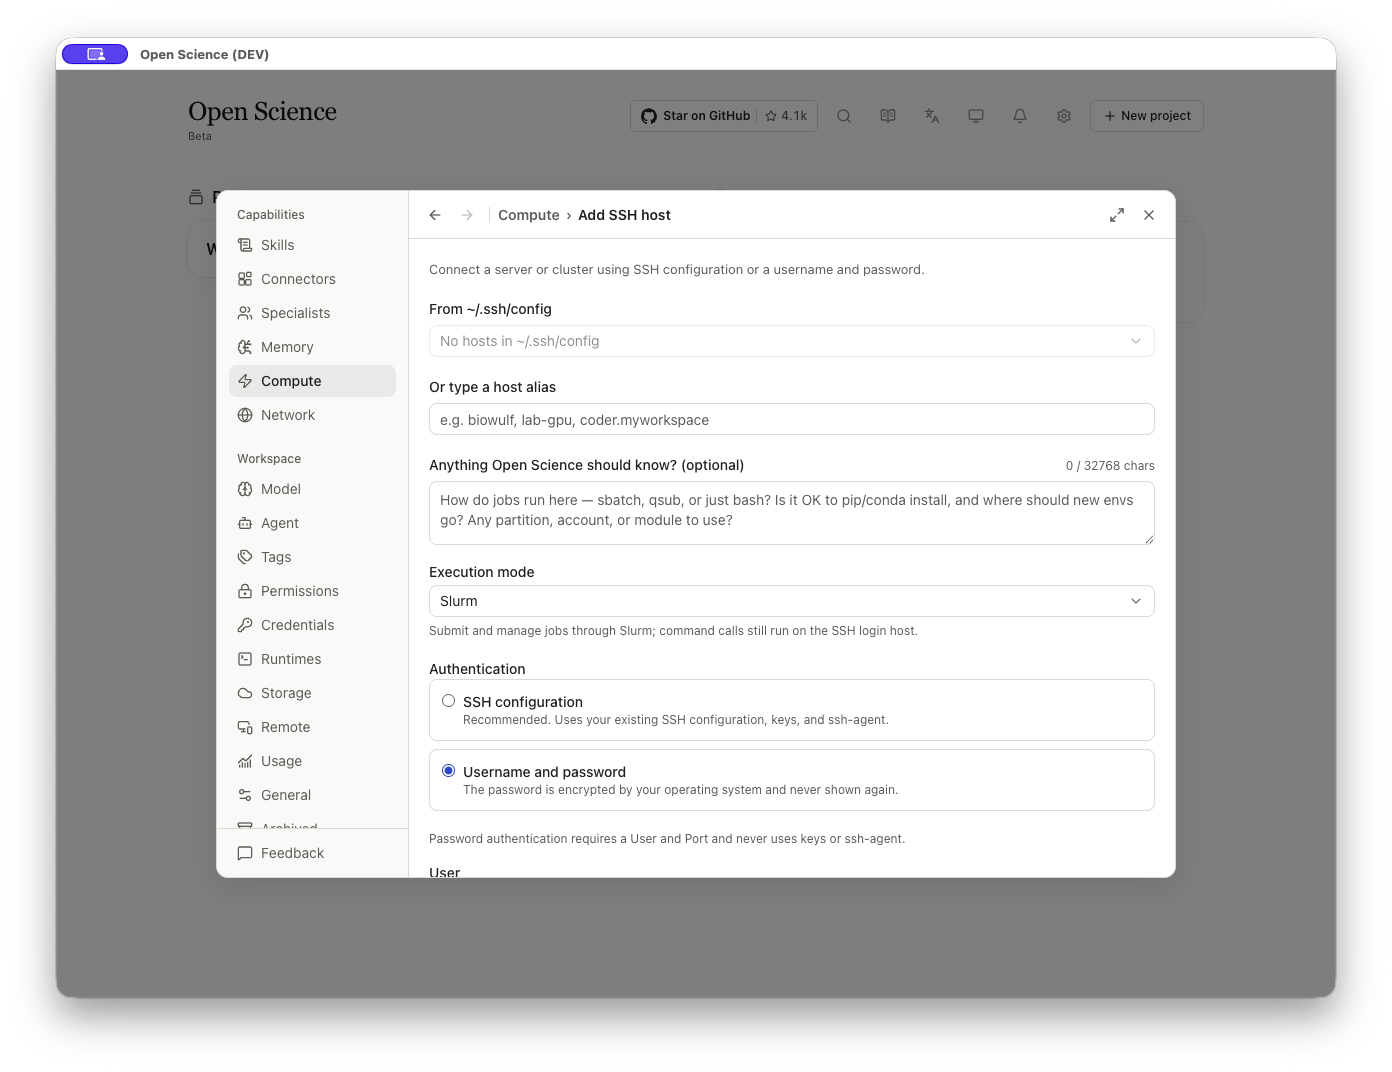
密码模式依赖应用的密码认证和安全存储能力。不可用时,请查看表单显示的原因。凭据只填入对应字段,不要写进主机说明或代理请求。
SSH 配置模式会先创建记录、打开详情,再在后台探测。因此列表里出现主机不能证明认证成功或计算已就绪。应先查看探测结果,再让任务使用该主机。
连接使用密码的科研服务器
- 打开 Settings → Compute → Add SSH host,输入服务器地址或别名。
- 选择 Username and password,填写 User、Port 和 Password,点击 Add。端口以管理员提供的信息为准,本例使用 22。
- 如果提示 The SSH host key is unknown. Verify it in a terminal before connecting.,需要先建立主机信任。使用系统 SSH 客户端连接同一主机和端口,将显示的指纹与管理员提供的指纹核对,一致后再接受。返回应用重新点击 Add,不要通过关闭主机密钥检查消除提示。
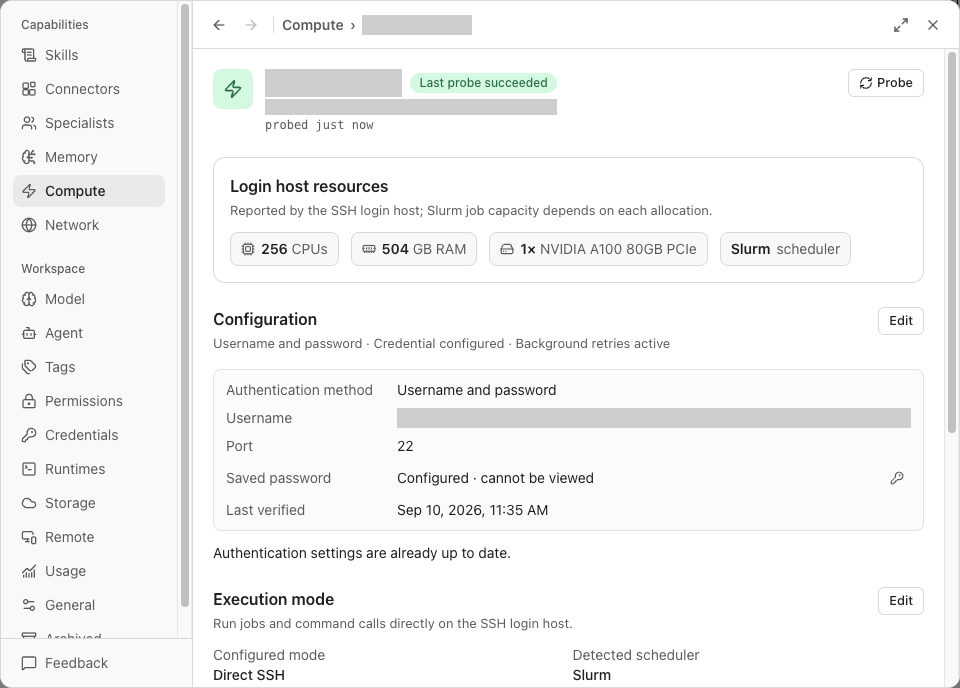
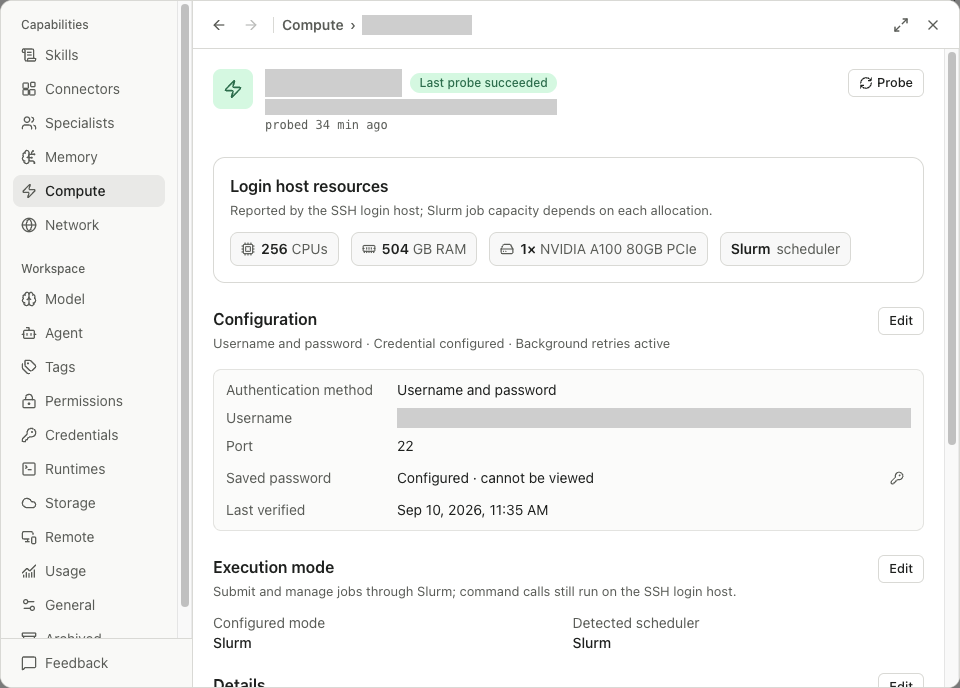
- 等待 Last probe succeeded。在 Configuration 中核对 Credential configured、认证方式与最后验证时间。已保存密码显示 Configured · cannot be viewed,不能重新查看。
- 检查或修改已有连接时,打开 Configuration → Edit,使用 Test and save。更改认证前阅读提示:新配置提交后,会清除会话启用状态与权限授权,需要在目标会话中重新启用主机。
英文截图显示密码认证与探测成功:256 个 CPU、504 GB 内存、一张 NVIDIA A100 80GB PCIe,并检测到 Slurm 调度器。Configured mode 仍是 Direct SSH,需要手动更改才会使用 Slurm。这些是示例服务器的登录主机资源,不是最低要求,也不代表作业已获调度分配。截图已遮盖主机和账号标识。
检查和维护主机详情
| 区域或按钮 | 检查内容 |
|---|---|
| Probe / Retry probe | 刷新连接/资源探测;区分 Not probed、Probing、Last probe succeeded、Probe failed |
| Resources / Login host resources | 检测到的 CPU、内存、GPU 和调度器;调度分配另有资源容量 |
| Configuration → Edit | 检查认证设置及凭据状态 |
| Test and save | 先测试候选认证配置,再保存;更改配置会清除会话启用状态与 Permission Grants。配置未变化时,提示设置已是最新状态 |
| Execution mode → Edit → Save | 修改配置模式,并与 Detected scheduler 对照 |
| Details → Edit | 更新主机说明;Save 提交,Cancel 放弃 |
| Show more / Show less | 展开或收起长说明 |
| Scratch root → Edit | 将远程临时工作路径保存为固定值 |
| Restore auto-detection | 移除固定覆盖,允许后续探测提供路径 |
| Concurrent job limit → Edit | 设置 1–500 的整数,显示的默认值为 10 |
| 移除主机 | 确认前阅读应用删除对话框和活动作业限制 |
Scratch root 是远程主机路径,不是笔记本电脑上的产物目录。请确认账号可写,并且站点清理规则给收集结果留出足够时间。并发上限不能替代调度器自身的配额或资源限制。
给验证任务单独设置 scratch 目录
打开 Scratch root → Edit,填写服务器规则允许且可写的绝对路径,点击 Save。PINNED 表示后续 Probe 保留该选择。通过首个作业的工作目录和输出确认写入权限。
首次运行可打开 Concurrent job limit → Edit,填写 1 并保存,使应用在该主机上一次只运行一个托管作业。它不预留 CPU、不限制内存,也不会阻止其他用户运行任务;降低上限不会停止已有作业。需要恢复由探测结果决定 scratch 路径时,再使用 Restore auto-detection。
区分主机说明与探测资源
已保存主机说明独立于 Resources。探测成功不会自动生成环境配置说明,说明为空也不表示探测失败。调度策略、环境激活和可复现的配置步骤放在 Details,CPU/RAM/GPU 探测结果在 Resources 查看。
由 Agent 更新说明时,需要先读取已保存文档,再针对该份当前内容精确替换。如果期间发生其他编辑,应重新读取、比较后再试,不要把资源探测摘要当成待替换的说明文档。主机说明约定。
允许任务使用主机
在会话 Agent controls 中检查 Compute Host 的可用状态和选择。被选中的主机必须同时处于启用状态。对于既可本地运行又可远程运行的任务,明确指定主机和执行模式。第一次请求应足够小,便于检查回执、日志和输出,再提交科学计算负载。
Slurm 场景需要向集群负责人确认账号/分区、资源申请、时限、模块/环境设置及临时目录规则。sbatch、squeue、sacct、scancel 可用于调度操作,但命令存在不等于账号有提交权限。
在科研任务前检查主机
| 阶段 | 继续前检查 |
|---|---|
| 连接 | 主机探测成功,认证连接有效 |
| Direct 作业 | 小型已批准任务、退出状态、可读日志与取回输出 |
| Slurm 作业 | 调度回执/job ID、实际分配资源、最终状态与取回输出 |
| 重新连接后恢复 | 应用对应同一个远程作业,没有重复提交 |
| 取消 | 调度器或进程确认停止,清理前检查保留输出 |
| GPU 负载 | 除 SSH 外,还要检查所需环境、权重、显存及科学输出 |
源码核对: 添加主机、认证字段、主机详情、连接校验、会话主机选择。
在远程服务器检查 RNA-seq 数据质量
在远程服务器检查 RNA-seq 数据质量
案例演示 通过 Direct SSH 完成 RNA-seq 质控
将分析从本机移到服务器时,可以使用同一份公开的 GSE60450 计数矩阵。与已知结果对照,有助于区分计算环境问题和科学方法变化。
- 在研究项目中新建会话,附加原始计数矩阵。
- 打开 Agent controls → Compute,先启用主机,再将其加入 run targets。启用与选择是两个独立控件;只在 Settings 中注册主机,不会自动为当前会话选择它。
- 明确要求使用 Direct SSH,指定输入、输出和限制。本例使用一个 CPU 线程、1 GiB 内存上限、120 秒运行时限,使用服务器默认 Python,无需安装软件包。
- 出现 Allow remote job submission? 时,检查 Host、Intent、Inputs、Execution mode、Timeout 和 Remote workdir。展开 Show full command 阅读完整脚本。Once 只批准这次提交,更大的授权范围会影响后续操作,请按实际需要选择。
- 保留返回的 Job ID。点击作业标签或 Background tasks 查看该任务。运行期间可以离开会话;不能因为回复结束就再次提交相同任务。
- 完成后打开 Remote job details,核对 Status、Runtime、Job ID 和 Remote workdir。Refresh 刷新当前视图,stdout 和 stderr 分别查看日志;点击远程工作目录按钮可以打开该任务的远程目录。
- 等待结果回收与后续回复,再打开已发布的 CSV 和报告。计算完成、文件回收、产物发布是三个阶段,作业完成本身不能证明两份预期文件都已发布。
可直接使用这样的请求:
使用选中的 Direct SSH 主机,对附加的 GSE60450 计数矩阵进行描述性质控,保持输入不变。逐样本计算总计数、零计数基因数、检出基因数和正计数中位数,保存 CSV 及简短方法报告,记录矩阵维度和处理前后的 SHA-256。使用一个 CPU 线程,不安装软件包,运行时限为 120 秒。提交后返回作业 ID,完成后回收并发布结果。不要归一化计数,也不要得出生物学结论。
出现 success 和退出码 0 后,确认应用回收两个输出,且保存表格与报告可以重开。按完整样本标识与公共基准比较指标,并核对远程计算前后的输入校验值。该 Direct SSH 示例已通过这些检查。
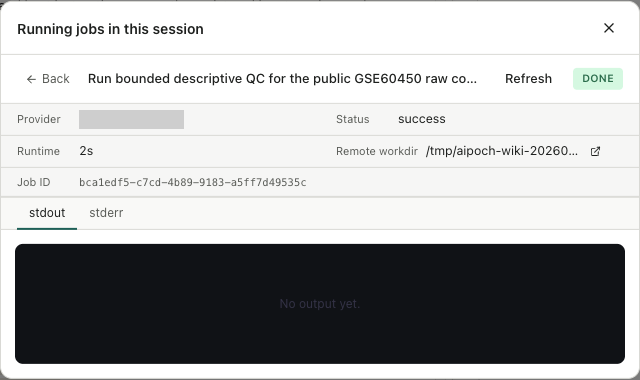
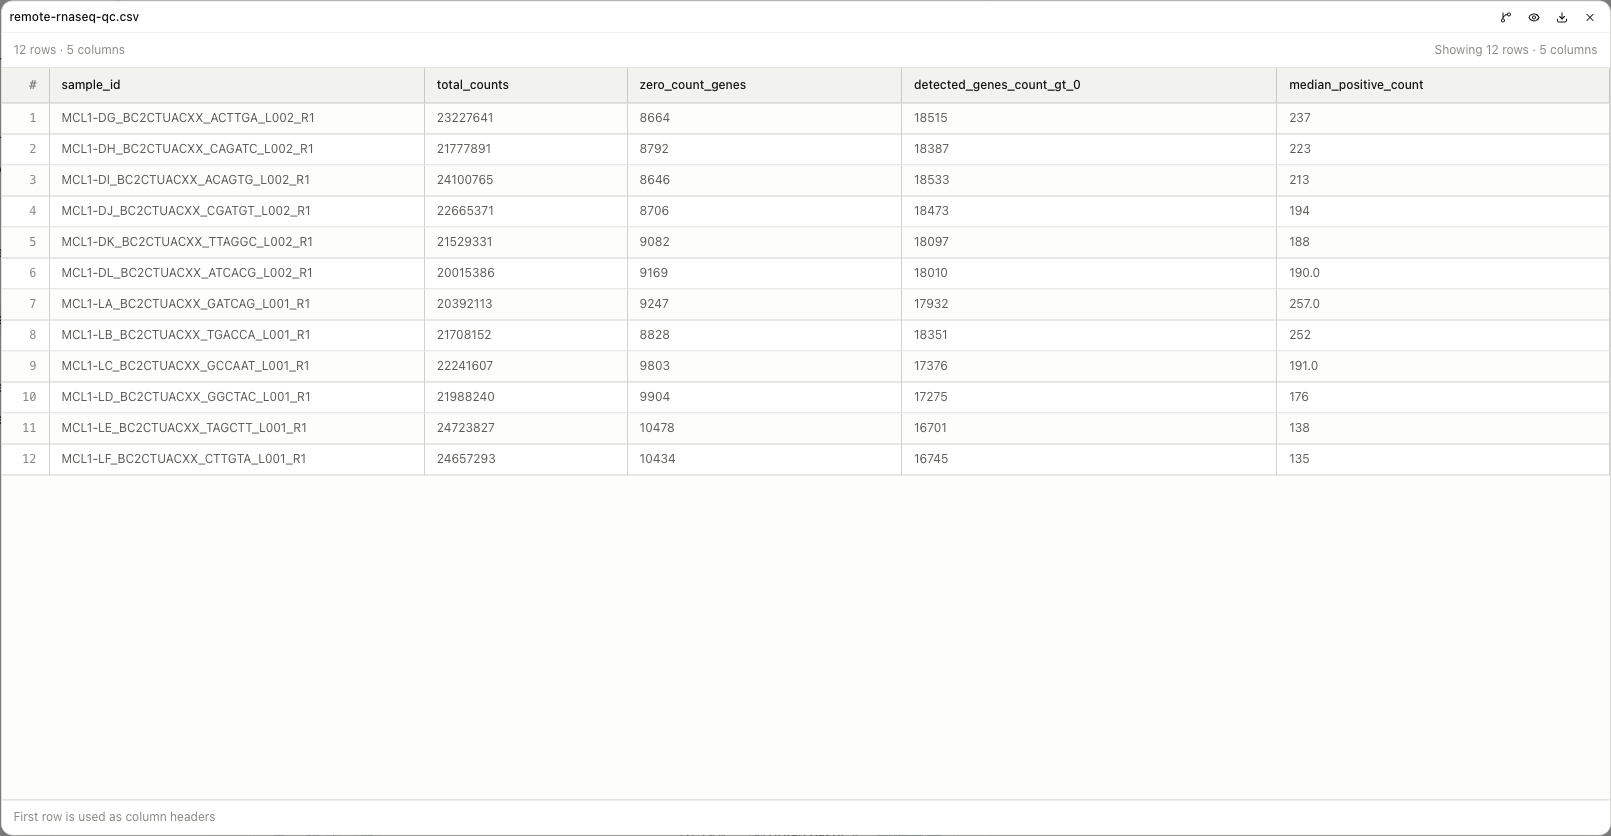
下载示例质控表和方法报告。这些原始计数检查不替代归一化、实验设计审查或差异表达分析;正计数中位数不包括零值。
重启应用后返回原作业
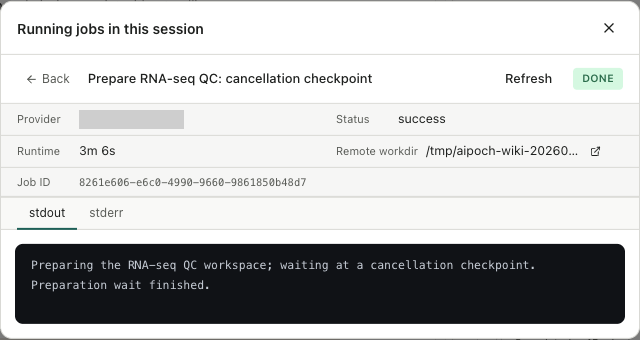
打开同一项目和会话,通过 Compute 或 Background tasks 找到作业。操作前将 Job ID 与原始回执对照。恢复的是已存在的远程任务,新建会话或重发请求不能代替恢复。
下图的独立准备检查点在本地应用重启时仍在运行。应用恢复了同一作业 ID,随后收集到完成日志。等待过程正常结束;这张截图验证恢复能力,不表示取消成功,也不表示完成了科学计算。
取消指定的远程任务
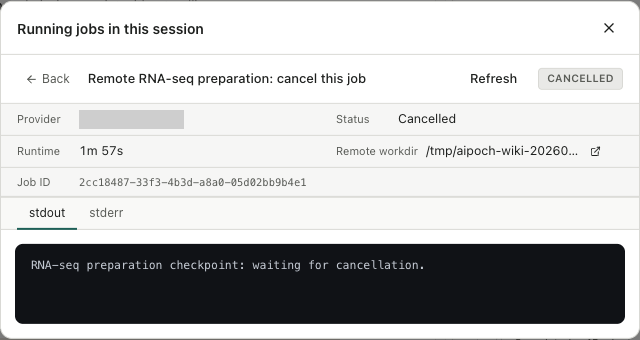
打开 Background tasks,选择目标任务,将 Job ID 与提交回执对照。Back 返回当前会话的作业列表。进入详情后点击 Cancel,等待按钮显示 Cancelling,再通过 Refresh 确认状态变为 Cancelled。关闭详情窗口或结束会话回复,都不等于取消远程负载。
下图的准备检查点通过此控件取消,之后独立确认远程进程已不存在,已有日志仍可读取。取消成功不表示该分析已产生完整结果,使用保留文件前应检查内容。
通过 Slurm 提交并核对资源分配
- 在 Settings → Compute 打开主机,选择 Execution mode → Edit → Slurm → Save,重新打开设置确认。只有 Detected scheduler 显示 Slurm,不会自动切换执行模式。
- 在目标会话中启用并选中主机。长任务运行前,确认站点允许的分区/账号,以及可读取的调度记账信息。
- 使用一行一个
#SBATCH --option=value指令申请资源,本例为:
#SBATCH --partition=local
#SBATCH --cpus-per-task=1
#SBATCH --mem=1G
#SBATCH --time=00:03:00
分区应以自己的站点为准,不要直接套用 local。作业的 120 秒负载运行时限与调度器的三分钟资源分配时限是两个设置,都不决定排队任务何时开始。作业名称、工作目录、stdout 和 stderr 路径由应用管理。
- 同时保留应用 Job ID 和 scheduler_job_id。调度器 ID 可能晚于首次提交回执出现,可让 Agent 读取已保存作业的状态;不要因首条回执缺少调度器 ID 就重复提交。
- 对照申请资源与实际分配。本例每任务申请一个 CPU 和 1 GiB,Slurm 记录一个任务、实际分配两个逻辑 CPU。解释资源使用时,应以实际分配记录为准。
- 确认终态并完成文件回收后,再发布结果。服务器上出现输出文件,不代表应用已经回收该文件。
服务器已完成,但应用仍在等待
如果应用状态快照包含 last_poll_error,保留原作业 ID,并要求显示完整错误。本例遇到的记账错误为:
slurm_poll_failed: Slurm accounting storage is disabled
调度器显示 COMPLETED / ExitCode 0:0,但应用仍为 submitted、result_final false 或没有已回收文件时,保留两个作业 ID 并检查轮询错误。调度器完成和应用结果回收是两个阶段。
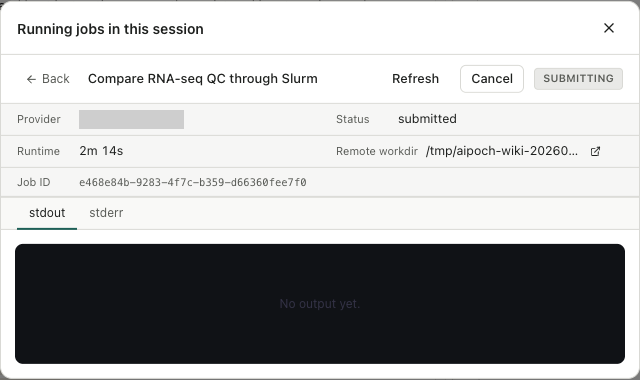
请集群管理员提供该账号与作业可用的 sacct 记账查询。squeue 不再列出任务,并不足以证明成功。修复期间保留原工作目录与作业 ID,恢复后检查同一个任务;不要为了清除监控错误而重跑已经完成的分析。Slurm 取消、恢复和应用结果回收,仍需在这一环境条件解决后验证。
在 GPU 上运行小型蛋白序列设计
在 GPU 上运行小型蛋白序列设计
案例演示 在 GPU 上用 ProteinMPNN 设计一个泛素候选序列
使用公开的 1UBQ 泛素结构,让 ProteinMPNN 为链 A 生成一个候选序列。这个例子验证远程 GPU 执行与输出检查;它不会预测新结构,也不会证明候选序列具有泛素功能。
- 在 Compute 选择已连接主机。检查空闲显存与当前负载,并确认该主机允许直接运行小型任务;需要调度器的集群应使用已授权的队列和 account。
- 要求代理在独立目录准备环境,保留 Python、PyTorch/CUDA 和依赖清单。示例使用 Python 3.10、PyTorch 2.5.1+cu124、NumPy 1.26.4;默认 Python 原先只有 CPU 版 PyTorch,仅探测到 GPU 不足以运行模型。
- 使用 ProteinMPNN 官方仓库的固定提交和自带
v_48_020权重。下载 1UBQ 后记录结构与权重的 SHA-256。 - 明确参数:链 A、候选数 1、batch size 1、temperature 0.1、seed 42,运行上限 180 秒。检查应用显示的远程命令,再批准该次操作。
- 要求记录模型参数所在设备及 stdout/stderr、退出码。只有
CUDA available=True不能证明该次推理实际用了 GPU;示例记录到parameter_device=cuda:0与parameter_is_cuda=True。 - 检查生成的 FASTA,并用独立代码核对序列长度、氨基酸字符、与原链一致的位点数和分数。计算完成后再次检查输入哈希。
| 检查项 | 本例结果 |
|---|---|
| 设备 | NVIDIA A100 80GB PCIe;模型实际位于 CUDA |
| 输入与输出长度 | 链 A 与候选均为 76 位 |
| 字符与分数 | 20 种标准氨基酸字符;score / global score 均为有限值 0.8568 |
| 原序列一致位点 | 42/76,独立计算 recovery 为 0.5526316 |
| 执行状态 | 模型和独立验证均返回退出码 0;模型报告生成时间 0.1949 秒,不包含安装和完整任务耗时 |
| 输入完整性 | 结构文件前后 SHA-256 一致 |
下载本次 GPU 验证记录。80 GB 是测试设备容量,不是这个小任务的最低显存要求;未测量峰值显存。远程日志与输出也不会自动补齐本地 Notebook 的所有证据字段。
本例通过已批准的直接 SSH 命令完成。此前 Slurm 提交返回 InvalidAccount,不能将这次成功写成 Slurm GPU 作业通过。遇到该错误,应核对队列和 account 权限;不要擅自更改调度服务,也不要在要求调度器的集群绕过队列。
处理 SSH 与作业错误
同时阅读错误码及附带消息。连接失败、调度器拒绝和程序执行失败,需要分别处理。下列标识符对应连接分类和计算任务状态,界面可能显示对应描述,而非原始代码。
连接与远程文件
| 消息或标识符 | 含义 | 操作与成功检查 |
|---|---|---|
The SSH host key is unknown. Verify it in a terminal before connecting. | 系统 SSH 客户端尚未信任该主机和端口的密钥 | 与管理员核对指纹,在系统 SSH 客户端中建立主机信任,再重试 Add 或 Test and save,不要关闭主机密钥检查 |
Permission denied (publickey) | SSH 密钥认证失败,远程文件分类将其归为 connection | 检查 User、Identity file、主机别名和 ssh-agent;请管理员确认该密钥有权登录。执行 Test and save,再 Retry probe |
Connection refused / No route to host / 连接 timeout | SSH 无法到达主机或建立连接 | 检查主机、端口、网络/VPN 及服务可用性,修正原因后重新测试连接 |
ENOENT / not_found | 远程路径不存在 | 检查远程主机上的路径,而非本机路径,再打开正确目录或文件 |
EACCES / EPERM / permission | 已登录账号没有对应文件操作权限 | 请主机管理员确认权限,或选择已授权的 scratch 目录,再重试同一操作 |
outside_roots | 远程文件路径不是绝对路径,或含控制字符,未通过校验 | 提供无换行和控制字符的远程绝对路径;其他层级拒绝时,继续阅读完整报错 |
作业记录
| 错误码 | 含义 | 接下来怎么做 |
|---|---|---|
approval_denied | 操作未获得批准 | 检查原命令和范围;确定希望授权该工作时,再提出新请求 |
host_unreachable | 应用无法到达主机或确认主机操作 | 恢复连接并重新探测。可能已提交任务时,先检查远程是否已有作业 |
invalid_resources | 资源参数或 Slurm 指令未通过校验 | 按报错指出的字段检查格式、集群限制及应用管理的指令限制,修正后再试 |
dispatch_failed | 启动或调度提交失败 | 阅读 stderr 和 sbatch 提示,检查 partition/account、环境与命令;再次提交前核对有无调度回执 |
job_failed | 作业未成功完成 | 检查退出码和 stdout/stderr,修正程序或环境后先运行小任务 |
timeout | 连接、命令或作业超过限制;无效 timeout_seconds 也可能返回此码 | 根据附带消息区分参数错误与真正超时。先核对已有作业状态,再调整时限或重跑 |
process_vanished | 跟踪或恢复时找不到预期进程 | 检查远程工作目录、日志和调度历史,确认工作停止还是完成后再创建替代作业 |
last_poll_error 表示监测失败,不能单独据此判定作业最终状态。harvest_error 则表示结果收集遇到问题,计算可能已经完成。保留 job ID,恢复连接并检查原作业,再决定是否重跑。
恢复后应能看到目标作业的最终状态、可解释的退出状态和可访问输出。Slurm 同时检查调度器 job ID 与应用 job ID。仍无法解决时,按提交问题或向社区求助反馈,附执行模式、可用的两类 ID、完整错误及去除敏感内容的日志片段。
使用 SSH 密钥/配置认证时,提供可用密钥或主机别名,先验证连接再提交。Slurm 结果回收需要所选账号具备可用记账查询;应用无法确认作业终态时,按上方步骤检查。